

Enhver stor projekt startede med et par servere. Først var der én DB-server, og så blev der tilføjet slaver for at skalere læsningen. Og her stopper det! Der er én master og mange slaver; hvis en af slaverne går ned, er alt fint, men hvis masteren går ned — så bliver det problematisk: nedetid, administratorer, der sveder for at få serveren op at køre. Hvad skal man gøre? Reservér masteren. Min kollega Pavel har allerede skrevet om dette, , så jeg vil ikke gentage det. I stedet vil jeg fortælle, hvorfor du absolut har brug for en Orchestrator til MySQL!
Lad os starte med det vigtigste spørgsmål: "Hvordan skifter vi koden til den nye maskine, hvis masteren går ned?".
- Skemaet med VIP (Virtual IP) kan jeg bedst lide, og det vil vi tale om nedenfor. Det er det enkleste og mest oplagte, selvom det har en klar begrænsning: den master, vi vil reservere, skal være i L2-segmentet med den nye maskine, så man kan glemme den anden datacenter. Og rent ud sagt, hvis man følger reglen om, at en stor L2 er en skidt idé, fordi L2 kun er pristrygt, mens der er L3 mellem reolerne, så har et sådant skema endnu flere begrænsninger.
- Man kan skrive DNS-navnet ind i koden og opløse det via /etc/hosts. I virkeligheden vil opløsningen ikke finde sted. Fordelen ved skemaet: der er ingen af de begrænsninger, der kendetegner den første metode, så man kan også organisere cross-datacenter. Men så opstår det åbenlyse spørgsmål, hvor hurtigt vi via Puppet-Ansible kan overføre ændringen til /etc/hosts.
- Den anden metode kan ændres en smule: på alle webserverne installerer vi en caching DNS, som koden vil bruge til at kommunikerede med master-databasen. Man kan sætte TTL til 60 for denne post i DNS. Det virker som en god metode, hvis det implementeres korrekt.
- Skemaet med service discovery, som involverer anvendelse af Consul og etcd.
- En interessant mulighed med . Al trafik til MySQL skal gå gennem ProxySQL, som selv kan bestemme, hvem der er master lige nu. Forresten kan man læse om en af anvendelserne af dette produkt i min .
Forfatteren af Orchestrator, der arbejdede i Github, implementerede først det første skema med VIP og derefter ændrede det til skemaet med Consul.
Typisk infrastruktur skema:
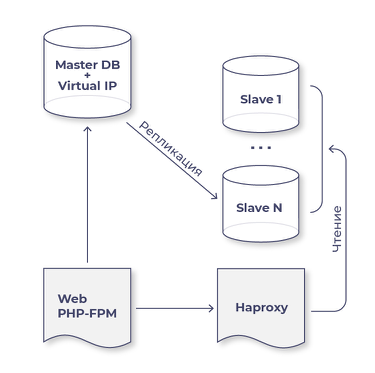
Lad mig straks beskrive de åbenlyse situationer, der skal overvejes:
- VIP-adressen må ikke være opført i konfigurationen på nogen af serverne. Lad os forestille os en situation: masteren genstarter, og mens den boot'er op, går Orchestrator over i failover-tilstand og gør en af slaverne til master; derefter starter den gamle master op igen, og nu er VIP aktiv på to maskiner. Det er skidt.
- For the orchestrator, you will need to write a script that interacts with the old master and the new master. On the old one, you should execute ifdown, and on the new master — ifup vip. It would also be good to include in this script that in the case of failover, the port on the switch of the old master is simply turned off to avoid any split brain.
- After the Orchestrator has invoked your script to first remove the VIP and/or turn off the port on the switch, and then on the new master called the script to bring up the VIP, do not forget to use the arping command to notify everyone that the new VIP is now here.
- All slaves must have read_only=1, and as soon as you promote a slave to a master, it should switch to read_only=0.
- Remember that any slave we choose can become a master (the Orchestrator has a whole mechanism for preference, which slave to consider a candidate for the new master first, which second, and which slave should definitely not be chosen as a master under any circumstances). If a slave becomes a master, its load will remain as a slave's load and the master's load will be added, which needs to be considered.
Why do you absolutely need an Orchestrator if you don't have one?
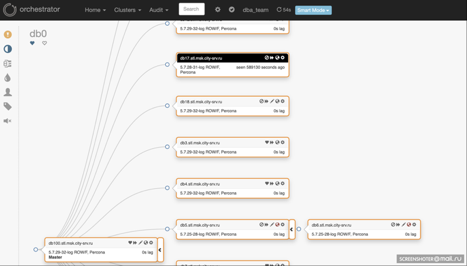
- The Orchestrator has a very convenient graphical interface displaying the entire topology (see the screenshot below).
- Orchestrator can monitor which slaves are lagging behind and where replication has actually failed (we have scripts attached to Orchestrator for sending SMS).
- Orchestrator tells you which slaves have a GTID errant error.
Orchestrator Interface:
What is GTID errant?
There are two main requirements for the Orchestrator to work:
- It is necessary that pseudo GTID is enabled on all MySQL cluster machines; we have GTID enabled.
- It is required that there is a single type of binary logs everywhere, statement can be used. We had a configuration where the master and most slaves were using Row, while two historically remained in Mixed mode. As a result, these slaves were simply not accepted by the Orchestrator into the new master.
Remember that the most important aspect of a production slave is its consistency with the master! If both the master and the slave have Global Transaction ID (GTID) enabled, then through the gtid_subset function, you can find out if the same data modification queries have indeed been executed on these machines. More details can be read about this. .
Således viser Orchestrator dig gennem GTID-fejlen, at der er transaktioner på slaven, som ikke findes på masteren. Hvordan kan dette ske?
- Read_only=1 er ikke aktiveret på slaven, så en bruger har tilsluttet sig og udført en ændringsanmodning.
- Super_read_only=1 er ikke aktiveret på slaven, derfor er admin, forvekslende serverne, gået ind og udført en anmodning der.
- Hvis du har taget begge de foregående punkter i betragtning, er der endnu en finurlighed: i MySQL registreres anmodningen om at flush binlogs også i binloggen, så ved den første flush på masteren og på alle slaver vil der opstå en GTID-fejl. Hvordan undgår man dette? I versionen perona-5.7.25-28 er der en indstilling, binlog_skip_flush_commands=1, som forbyder at skrive flush til binloggerne. Der findes mere information på mysql.com. .
For at opsummere alt det ovenstående. Hvis du endnu ikke ønsker at bruge Orchestrator i failover-tilstand, så sæt det i overvågningsmodus. Så vil du altid have et overblik over interaktionerne mellem MySQL-maskinerne og visuel information om, hvilken type replikation der er på hver maskine, om slaver er forsinkede, og vigtigst af alt — hvor konsistente de er med masteren!
Et åbenlyst spørgsmål: „Hvordan skal Orchestrator fungere?“. Den skal vælge en ny master blandt de nuværende slaver, og derefter genforbinde alle slaver til den (det er netop derfor GTID er nødvendigt; hvis man bruger den gamle mekanisme med binlog_name og binlog_pos, så er det simpelthen umuligt at skifte en slave fra den nuværende master til den nye!). Før vi fik Orchestrator, måtte jeg en gang gøre alt dette manuelt. Den gamle master frøs på grund af en defekt Adaptec-controller, og der var omkring 10 slaver. Jeg måtte flytte VIP fra masteren til en af slaverne og genforbinde alle de øvrige slaver til den. Hvor mange konsoller måtte jeg åbne, hvor mange samtidige kommandoer skulle jeg indtaste ... Jeg måtte vente indtil klokken 3 om natten, lette belastningen på alle slaver, undtagen to, gøre den første maskine til master, straks tilslutte den anden maskine, så tilslutte alle andre slaver til den nye master og genoprette belastningen. Alt i alt, et mareridt ...
Hvordan fungerer Orchestrator, når den skifter til failover-tilstand? Det er nemmest at vise ved at tage udgangspunkt i en situation, hvor vi ønsker at gøre en mere kraftfuld og moderne maskine til master i stedet for den nuværende.
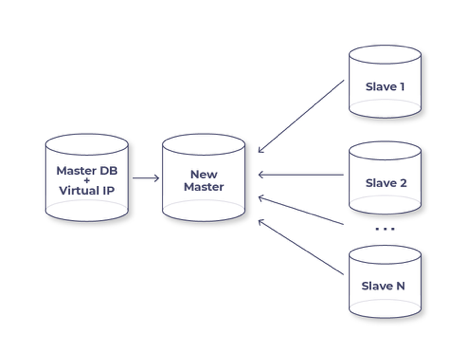
Illustrationen viser midten af processen. Hvad er allerede blevet gjort på dette tidspunkt? Vi sagde, at vi ønskede at gøre en slave til en ny master, Orchestrator begyndte bare at genkoble alle andre slaver til den, mens den nye master fungerer som en transitmaskine. I et sådant setup opstår der ikke fejl, alle slaver fungerer, Orchestrator tager VIP fra den gamle master, flytter det til den nye, sætter read_only=0 og glemmer den gamle master. Sådan! Nedetiden for vores service er tiden til at flytte VIP, det tager 2-3 sekunder.
Det var alt for i dag, tak allesammen. Snart kommer den anden artikel om Orchestrator. I den velkendte sovjetiske film "Garagen" sagde en karakter: "Jeg ville ikke gå i rekognoscering med ham!" Så ja, Orchestrator, jeg ville gå i rekognoscering med dig!
Kilde: habr.com
