

Jeg vil gerne præsentere transkripsjonen af foredraget af Alexey Lesovsky fra Data Egret "Grundlæggende overvågning af PostgreSQL"
I dette foredrag vil Alexey Lesovsky diskutere de nøglepunkter, der angår PostgreSQL-statistik, hvad de betyder, og hvorfor de skal inkluderes i overvågningen; hvilke grafer der skal være i overvågningen, hvordan man tilføjer dem, og hvordan man fortolker dem. Foredraget vil være nyttigt for databaseadministratorer, systemadministratorer og udviklere, der er interesseret i fejlfinding af Postgres.
Mit navn er Alexey Lesovsky, jeg repræsenterer Data Egret.
Lidt om mig selv. Jeg startede engang for længe siden som systemadministrator.
Jeg administrerede forskellige Linux-systemer og arbejdede med forskellige opgaver relateret til Linux, dvs. virtualisering, overvågning, arbejdede med proxy osv. Men på et tidspunkt begyndte jeg at fokusere mere på databaser, PostgreSQL. Jeg kunne virkelig godt lide det. Og på et tidspunkt begyndte jeg at arbejde med PostgreSQL det meste af min arbejdstid. Så gradvist blev jeg PostgreSQL DBA.
Og gennem hele min karriere har jeg altid været interesseret i emner som statistik, overvågning og indsamling af telemetri. Da jeg var systemadministrator, arbejdede jeg tæt med Zabbix. Jeg skrev et lille sæt scripts som . Det var ret populært på det tidspunkt. Og man kunne overvåge meget vigtige aspekter, ikke kun Linux, men også forskellige komponenter.
I dag arbejder jeg med PostgreSQL. Jeg skriver noget andet, som muliggør arbejde med PostgreSQL-statistik. Det hedder (artikel på Habr — ).
En lille introduktion. Hvilke situationer oplever vores kunder? Der opstår en fejl relateret til databasen. Og når databasen er blevet gendannet, kommer lederen af afdelingen eller udviklingslederen og siger: „Venner, vi bør overvåge databasen, fordi der skete noget dårligt, og vi skal sørge for, at det ikke sker igen i fremtiden.“ Og her begynder den interessante proces med at vælge et overvågningssystem eller tilpasse et eksisterende overvågningssystem, så vi kan overvåge vores database – PostgreSQL, MySQL eller andre. Og kollegerne begynder at foreslå: „Jeg har hørt, at der findes en bestemt database. Lad os bruge den.“ Kollegerne begynder at diskutere indbyrdes. Og i sidste ende vælger vi en bestemt database, men overvågningen af PostgreSQL i den er ret svag, og det er ofte nødvendigt at tilføje noget ekstra. Tage nogle repositories fra GitHub, klone dem, tilpasse scripts, og justere dem på en eller anden måde. Og til sidst resulterer det i noget manuelt arbejde.
Derfor vil jeg i denne præsentation forsøge at give dig nogle indsigter om, hvordan man vælger overvågning ikke kun for PostgreSQL, men også for databaser generelt. Og give den viden, der gør det muligt for dig at forbedre din overvågning, så du kan få noget nytte ud af det, så du kan overvåge din database effektivt og i tide advare om potentielle nødsituationer, som kan opstå.
De idéer, der præsenteres i denne præsentation, kan direkte tilpasses til enhver database, hvad enten det er en SQL-database eller noSQL. Så her handler det ikke kun om PostgreSQL, men der vil være mange opskrifter på, hvordan man gør det i PostgreSQL. Der vil være eksempler på forespørgsler og eksempler på enheder, der findes i PostgreSQL til overvågning. Og hvis din database har de samme funktioner, der gør det muligt at integrere dem i overvågningen, kan du også tilpasse dem, tilføje dem, og det vil fungere godt.
 I præsentationen vil jeg ikke
tale om, hvordan man indsamler og opbevarer målinger. Jeg vil ikke sige noget om efterbehandling af data og om, hvordan man præsenterer dem for brugeren. Og jeg vil ikke tale om alarmering.
Under the narrative, I will share various screenshots of existing monitoring systems and critique them as I go along. However, I will try not to mention brand names in order to avoid creating any advertising or negative advertising for these products. Therefore, any similarities are purely coincidental and left to your imagination.
Let's start by understanding what monitoring is. Monitoring is a very important element that is essential to have. Everyone understands this. However, at the same time, monitoring does not relate to a business product and does not directly affect a company’s profit, which is why monitoring is often given time on a residual basis. If we have time, we deal with monitoring; if there is no time, that's okay, we'll put it on the back burner and come back to these tasks someday.
Therefore, from our experience when we visit clients, monitoring is often underdeveloped and lacks interesting features that could help us work better with the database. Thus, monitoring always requires improvements.
Databases are complex elements that also need to be monitored because databases are stores of information. And information is very important for a company; it cannot be lost under any circumstances. At the same time, databases are very complex pieces of software. They consist of a large number of components, and many of these components need monitoring.
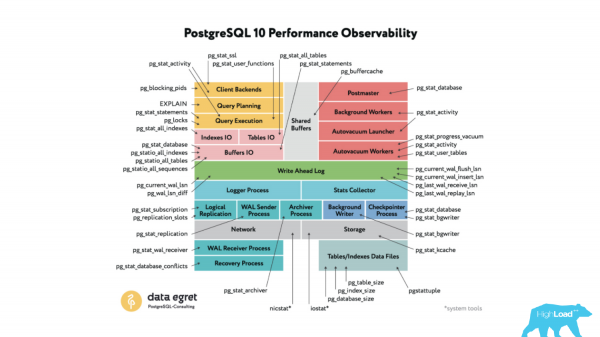 When we talk specifically about PostgreSQL, it can be envisioned as a diagram consisting of many components. These components interact with each other. Meanwhile, PostgreSQL has a so-called Stats Collector subsystem that allows gathering statistics about the operation of these subsystems and provides an interface for the administrator or user to view this statistics.
This statistics is presented as a set of functions and views. They can also be referred to as tables. That is, with a standard psql client, you can connect to the database, perform a select query on these functions and views, and obtain specific figures regarding the performance of PostgreSQL subsystems.
You can add these figures to your favorite monitoring system, create graphs, add functions, and obtain long-term analytics.
Men i denne rapport vil jeg ikke gennemgå alle disse funktioner grundigt, fordi det kan tage hele dagen. Jeg vil fokusere på to til fire ting og tale om, hvordan de hjælper med at forbedre overvågningen.
Og når vi taler om overvågning af databasen, hvad skal vi så overvåge? Først og fremmest skal vi overvåge tilgængeligheden, fordi databasen er en tjeneste, der giver adgang til data for kunderne, og vi skal overvåge dens tilgængelighed, samt nogle kvalitets- og kvantitative karakteristika.
Vi skal også overvåge kunderne, der opretter forbindelse til vores database, fordi de kan være både normale kunder og skadelige kunder, der kan skade databasen. Deres aktiviteter skal også overvåges.
Når kunderne opretter forbindelse til databasen, begynder de åbenlyst at arbejde med vores data, så vi skal overvåge, hvordan kunderne arbejder med dataene: hvilke tabeller de bruger og, mindre grad, hvilke indekser. Det vil sige, at vi skal vurdere den arbejdsbyrde (workload), som vores kunder skaber.
Men arbejdsbyrden består selvfølgelig også af forespørgsler. Applikationer opretter forbindelse til databasen og henter data ved hjælp af forespørgsler, så det er vigtigt at vurdere, hvilke forespørgsler vi har i databasen, overvåge deres passendehed, sikre at de ikke er dårligt skrevet, og at nogle indstillinger skal omskrives for at fungere hurtigere og med bedre ydeevne.
Og eftersom vi taler om databasen, er databasen altid forbundet med baggrundsprocesser. Baggrundsprocesserne holder databasen i god stand, så de kræver en vis mængde ressourcer til deres drift. Samtidig kan de overlappe med ressourcerne fra kundernes forespørgsler, så en ressourcekrævende drift af baggrundsprocesserne kan påvirke ydeevnen af kundernes forespørgsler. Derfor skal de også overvåges for at sikre, at der ikke er ubalancer i forhold til baggrundsprocesserne.
Og alt dette i databaseovervågningsplanen forbliver i systemmetrikken. Men i betragtning af at vores infrastruktur stort set flytter til skyen, kommer systemmetrikkerne for en enkelt vært altid i anden række. Men i databaser er de stadig relevante, og det er selvfølgelig også nødvendigt at overvåge systemmetrikker.
Med systemmetrikkerne er alt mere eller mindre i orden, alle moderne overvågningssystemer understøtter allerede disse metrikker, men generelt mangler der stadig nogle komponenter, og der er behov for at tilføje visse ting. Dette vil jeg også berøre, der vil være et par slides om dem.
Det første punkt på planen er tilgængelighed. Hvad er tilgængelighed? Tilgængelighed i min opfattelse er evnen for databasen til at håndtere forbindelser, dvs. databasen er oppe, og som en tjeneste accepterer den forbindelser fra kunder. Og denne tilgængelighed kan vurderes ud fra nogle karakteristika. Disse karakteristika er meget bekvemme at vise på dashboards.
Alle ved, hvad dashboards er. Det er når du kaster et blik på skærmen, hvor den nødvendige information er samlet. Og du kan straks afgøre – er der et problem i databasen eller ej.
Tilsvarende er det altid nødvendigt at vise database-tilgængelighed og andre nøglekarakteristika på dashboards, så denne information er lige ved hånden, altid tæt på dig. Nogle yderligere detaljer, der allerede hjælper ved efterforskning af hændelser eller katastrofesituationer, skal allerede vises på sekundære dashboards eller skjules i drilldown-links, der fører til tredjeparts overvågningssystemer.
Eksempel på et velkendt overvågningssystem. Det er et meget imponerende overvågningssystem. Det indsamler en masse data, men efter min mening har det en mærkelig forståelse af dashboards. Der er et link til at 'oprette dashboard'. Men når du opretter et dashboard, opretter du en slags liste bestående af to kolonner, en slags liste over grafer. Og når du skal se noget, begynder du at klikke med musen, scrolle, lede efter den nødvendige graf. Og det tager tid, dvs. der findes ikke rigtige dashboards. Der er kun lister over grafer.
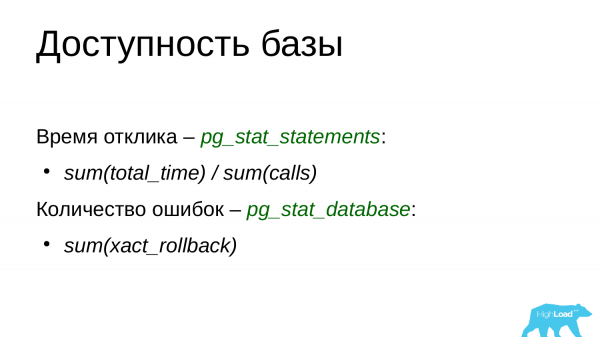
Hvad skal der tilføjes til disse dashboards? Man kan starte med en egenskab som svartid. I PostgreSQL findes der en visning kaldet pg_stat_statements. Som standard er den deaktiveret, men det er en af de vigtige systemvisninger, som altid skal aktiveres og bruges. Den gemmer oplysninger om alle udførte forespørgsler, der er blevet kørt i databasen.
Således kan vi tage udgangspunkt i, at man kan tage den samlede tid for udførelsen af alle forespørgsler og dividere med antallet af forespørgsler ved hjælp af de tidligere nævnte felter. Men det er sådan en gennemsnitlig temperatur på hospitalet. Vi kan tage udgangspunkt i andre felter - den minimale tid for udførelsen af forespørgslerne, den maksimale og medianen. Vi kan endda bygge percentiler, idet PostgreSQL har relevante funktioner til dette. Vi kan få nogle tal, der karakteriserer svartiden for vores database baseret på allerede udførte forespørgsler, dvs. vi udfører ikke en falsk forespørgsel 'select 1' og ser svartiden, men vi analyserer svarene fra allerede udførte forespørgsler og tegner enten et enkelt tal eller bygger et diagram ud fra det.
Det er også vigtigt at holde øje med antallet af fejl, der genereres af systemet i øjeblikket. Og til dette kan man bruge visningen pg_stat_database. Vi orienterer os efter feltet xact_rollback. Dette felt viser ikke kun antallet af rollback, der finder sted i databasen, men tager også højde for antallet af fejl. Man kan sige, at vi kan vise dette tal på vores dashboard og se, hvor mange fejl vi har i øjeblikket. Hvis der er mange fejl, er det en god grund til at kigge i loggene og se, hvad det er for nogle fejl, og hvorfor de opstår, og derefter undersøge og løse dem.
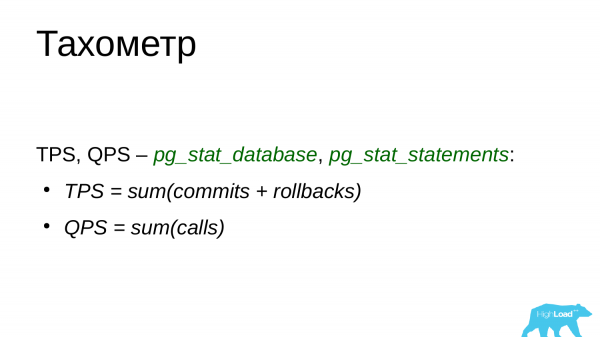
Man kan tilføje noget som en Tachometer. Dette er antallet af transaktioner pr. sekund og antallet af forespørgsler pr. sekund. Man kan sige, at man kan bruge disse tal som den aktuelle ydelse for sin database og overvåge, om der er spidser i forespørgslerne, spidser i transaktionerne, eller om databasen er underbelastet, fordi en eller anden backend er faldet ud. Det er vigtigt altid at holde øje med dette tal og huske, at for vores projekt er sådan en ydelse normal, mens værdier over og under allerede er problematiske og uklare, hvilket betyder, at man skal se på, hvorfor sådanne tal opstår.
For evaluating the number of transactions, we can again refer to the pg_stat_database view. We can sum the number of commits and the number of rollbacks to get the number of transactions per second.
Everyone understands that multiple requests can fit into one transaction, right? Therefore, TPS and QPS are slightly different.
The number of requests per second can be obtained from pg_stat_statements by simply calculating the total of all executed requests. It’s clear that we compare the current value with the previous one, subtract, obtain the delta, and get the amount.
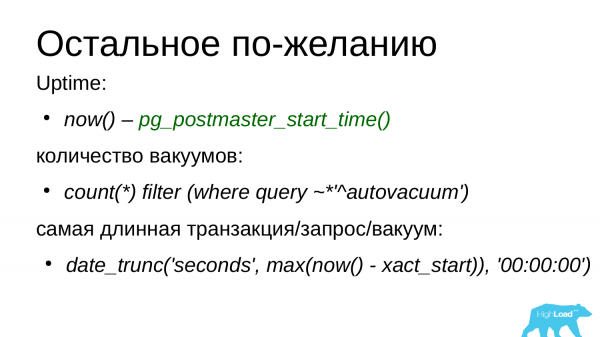
Additional metrics can be added as desired, which also help to evaluate the availability of our database and track whether there were any downtimes.
One of these metrics is uptime. However, uptime in PostgreSQL is a somewhat tricky thing. Let me explain why. When PostgreSQL starts up, it begins to count uptime. But if at some point, for example at night, a task was executed and the OOM-killer forcefully terminated the PostgreSQL child process, in this case PostgreSQL will disconnect all clients, reset the shared memory area, and begin recovery from the last checkpoint. While this recovery from the checkpoint is ongoing, the database does not accept connections, i.e., this situation can be assessed as downtime. However, the uptime counter will not reset because it tracks the time since the postmaster was first started. Therefore, such situations may be overlooked.
It is also important to monitor the number of vacuum workers. Does everyone know what autovacuum is in PostgreSQL? It is an interesting subsystem in PostgreSQL. Many articles have been written about it, numerous talks have been made. There has been much discussion about vacuum and how it should work. Many consider it an unavoidable evil, and rightly so. It's somewhat akin to a garbage collector that cleans up outdated versions of rows that are needed by none of the transactions and frees up space in tables and indexes for new rows.
Why is it necessary to monitor it? Because vacuum can sometimes cause significant issues. It consumes a large amount of resources, and client requests start to suffer from it.
Og man bør overvåge det via visningen pg_stat_activity, som jeg vil tale om i næste afsnit. Denne visning viser den aktuelle aktivitet i databasen. Gennem denne aktivitet kan vi spore antallet af vacuum-processer, der arbejder lige nu. Vi kan overvåge vacuumene og se, at hvis vi overskrider grænsen, er det en grund til at kigge i PostgreSQL's indstillinger og optimere vacuum-arbejdet.
En anden funktion ved PostgreSQL er, at det virkelig lider under lange transaktioner. Især under transaktioner, der hænger og ikke laver noget. Disse kaldes stat idle-in-transaction. En sådan transaktion holder låse, hvilket forhindrer vacuumet i at arbejde. Som følge heraf svulmer tabellerne op, de øges i størrelse. Og forespørgsler, der arbejder med disse tabeller, begynder at køre langsommere, fordi de skal læse alle de gamle versioner af rækker fra hukommelsen til disken og tilbage. Derfor er det også vigtigt at overvåge tiden, længden af de længste transaktioner og de længste vacuum-forespørgsler. Og hvis vi ser nogen processer, der har kørt meget længe, mere end 10-20-30 minutter for OLTP-belastning, så bør vi allerede være opmærksomme på dem og afslutte dem tvingende, eller optimere applikationen, så de ikke kaldes og hænger så længe. For analytisk belastning er 10-20-30 minutter normalt, der kan endda være endnu længere.
Dernæst har vi muligheden med tilsluttede klienter. Når vi har oprettet et dashboard og vist vigtige tilgængelighedsmetrikker, kan vi også tilføje yderligere information om de tilsluttede klienter.
Information om tilsluttede klienter er vigtig, fordi, set fra PostgreSQL's synspunkt, kan klienter være forskellige. Der er gode klienter, og der er dårlige klienter.
Et simpelt eksempel. Med kunden forstår jeg en applikation. Applikationen har forbindelse til databasen og begynder straks at sende sine forespørgsler, databasen behandler dem og udfører dem, resultaterne returneres til klienten. Det er gode og korrekte klienter.
Der er situationer, hvor klienten opretter forbindelse, holder forbindelsen, men samtidig ikke laver noget. Den er i en tilstand af idle.
Men findes også dårlige kunder. For eksempel har en kunde måske tilsluttet sig, åbnet en transaktion, lavet noget i databasen og derefter gået ind i koden for at henvise til en ekstern kilde eller for at bearbejde de data, han har modtaget. Alligevel har han ikke lukket transaktionen. Så transaktionen hænger i databasen og blokerer en række. Dette er en dårlig tilstand. Hvis applikationen pludselig fejler et sted inde i sig (Exception), kan transaktionen forblive åben i lang tid. Dette påvirker direkte PostgreSQL's ydeevne. PostgreSQL vil arbejde langsommere. Derfor er det vigtigt at overvåge sådanne kunder rettidigt og afslutte deres arbejde tvangsmæssigt. Man skal også optimere sin applikation for at undgå sådanne situationer.
Andre dårlige kunder er ventende kunder. De bliver dårlige på grund af omstændigheder. For eksempel kan en simpel ventende transaktion åbne en transaktion, tage låse på nogle rækker, og hvis den på et tidspunkt fejler i koden, forbliver der en hængende transaktion. En anden kunde ankommer, anmoder om de samme data, men han støder på en blokering, fordi den hængende transaktion allerede holder låse på nogle nødvendige rækker. Den anden transaktion vil så hænge i venten på, at den første transaktion afsluttes eller på at dens administrator tvangsmæssigt lukker den. På den måde kan ventende transaktioner hobe sig op og overskride databasen tilslutningsgrænse. Når grænsen overskrides, kan applikationen ikke længere arbejde med databasen. Dette er en nødsituation for projektet. Derfor er det vigtigt at overvåge dårlige kunder og reagere i tide.
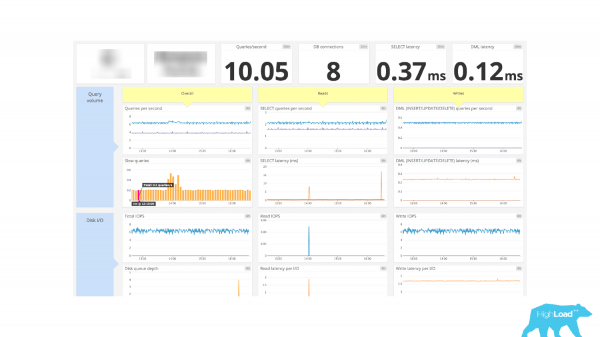
Et andet eksempel på overvågning. Her er allerede et ordentligt dashboard. Der er information om forbindelserne øverst. DB connection – 8 stykker. Og det er alt. Vi har ikke information om, hvilke kunder der er aktive, og hvilke der bare er idle og ikke laver noget. Der er ingen information om hængende transaktioner eller ventende forbindelser, altså er det bare et tal, der viser antallet af forbindelser og intet andet. Og så må man gætte selv.
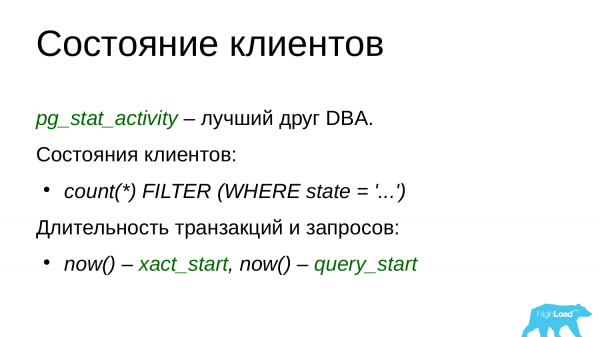
For at tilføje denne information til overvågning, skal man henvise til systemvisningen pg_stat_activity. Hvis du tilbringer meget tid i PostgreSQL, er dette en fremragende visning, der bør blive din ven, da den viser den aktuelle aktivitet i PostgreSQL, dvs. hvad der sker i det. Hver proces har en separat linje, der viser information om denne proces: fra hvilken vært forbindelsen er etableret, under hvilken bruger, med hvilket navn, hvornår transaktionen blev startet, hvilken forespørgsel der udføres nu, og hvilken forespørgsel der blev udført sidst. Og i overensstemmelse hermed kan vi vurdere klientens tilstand ud fra feltet stat. Man kan sige, at vi kan gruppere efter dette felt og få de nuværende stats, der findes i databasen, samt antallet af forbindelser, der har denne stat i databasen. Og de opnåede tal kan vi sende til vores overvågning og tegne grafer baseret på dem.
Det er også vigtigt at vurdere varigheden af transaktionen. Jeg har allerede nævnt, at det er vigtigt at vurdere varigheden af vacuum-processerne, men transaktionerne skal vurderes på samme måde. Der er felterne xact_start og query_start. De viser, når transaktionen og forespørgslen startede. Vi anvender funktionen now(), som viser det nuværende tidsstempel, og trækker tidsstemplet for transaktionen og forespørgslen fra. Og vi får varigheden af transaktionen, varigheden af forespørgslen.
Hvis vi ser lange transaktioner, bør vi afslutte dem. For OLTP-belastning er lange transaktioner mere end 1-2-3 minutter. For OLAP-belastning er lange transaktioner normale, men hvis de varer mere end to timer, er det også et tegn på, at vi har en ubalance et sted.
Når kunderne har oprettet forbindelse til databasen, begynder de at arbejde med vores data. De henvender sig til tabeller, de henvender sig til indekser for at hente data fra tabellen. Og det er vigtigt at vurdere, hvordan kunderne arbejder med disse data.
Dette er nødvendigt for at vurdere vores arbejdsbelastning og få en idé om, hvilke tabeller der er de mest "aktive". Dette er vigtigt i situationer, hvor vi ønsker at placere de "aktive" tabeller på hurtig SSD-lagring. For eksempel kan vi flytte nogle arkivtabeller, som vi ikke længere bruger, til en "kold" arkivplads på SATA-diske, hvor de kan være, og tilgangen til dem vil ske efter behov.
Det er også nyttigt til at opdage anomalier efter forskellige udgivelser og deployment. Antag, at et projekt har lanceret en ny funktion. For eksempel er der blevet tilføjet ny funktionalitet til arbejdet med databasen. Hvis vi opbygger grafer over brugen af tabellerne, vil vi let kunne opdage disse anomalier på graferne. For eksempel kan vi se spidser i opdateringer eller sletninger. Det vil være meget tydeligt.
Vi kan også opdage anomalier i "forstyrret" statistik. Hvad betyder det? PostgreSQL har en stærk og meget god forespørgselsplanlægger. Og udviklerne bruger mange ressourcer på at forbedre den. Hvordan fungerer den? For at kunne opbygge gode planer indsamler PostgreSQL statistik om datafordelingen i tabellerne med et vist tidsinterval og regelmæssighed. Det er de mest hyppige værdier: antal unikke værdier, information om NULL i tabellen, en masse information.
Baseret på denne statistik opbygger planlæggeren flere forespørgsler, vælger den mest optimale og bruger denne forespørgselsplan til at udføre selve forespørgslen og returnere dataene.
Nogle gange kan statistikken være "forstyrret". Kvaliteten og mængden af data kan have ændret sig i tabellen, men statistikken er ikke blevet indsamlet. Og de dannede planer kan vise sig at være suboptimale. Hvis vi har suboptimale planer i henhold til den indsamlede overvågning af tabellerne, kan vi se denne anomalier. For eksempel kan dataene have ændret kvalitet, og i stedet for at bruge indekset er der blevet anvendt en sekventiel gennemgang af tabellen. Det vil sige, hvis forespørgslen kun skal tilbageføre 100 rækker (med begrænsning limit 100), så vil der blive foretaget en fuld gennemgang for denne forespørgsel. Og det påvirker altid ydeevnen negativt.
Og vi kan se dette i overvågningen. Og allerede se denne forespørgsel, udføre en explain for den, samle statistik, bygge et nyt ekstra indeks. Og allerede reagere på dette problem. Derfor er det vigtigt.
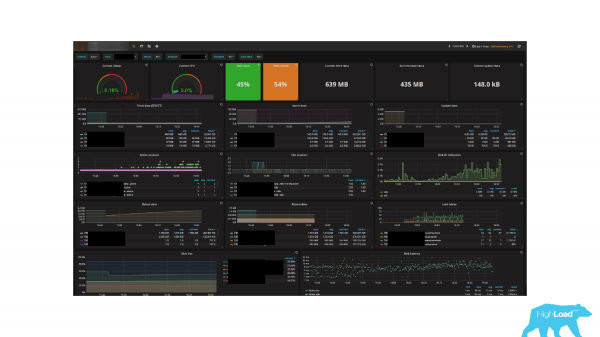
Et andet eksempel på overvågning. Jeg tror, mange kender det, fordi det er meget populært. Hvem bruger det i deres projekter. ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Men der er én dårlig detalje.
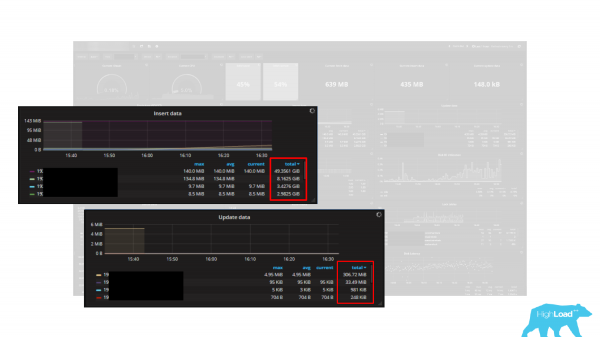
Der er flere grafer. Og som en enhed er der angivet bytes, dvs. der er 5 grafer. Det er Insert data, Update data, Delete data, Fetch data og Return data. Som enhed for måling er der angivet bytes. Men det er sådan, at statistikken i PostgreSQL returnerer data i tuples (rækker). Og derfor er disse grafer en meget god måde at undervurdere din arbejdsbelastning flere gange, ti gange, fordi en tuple ikke er en byte, en tuple er en række, det er mange bytes, og den har altid variabel længde. Det vil sige, at det at beregne arbejdsbelastningen i bytes ved hjælp af tuples er en umulig opgave eller meget vanskelig. Derfor, når du bruger dashboardet eller indbygget overvågning, er det altid vigtigt at forstå, at det fungerer korrekt og returnerer dig korrekt vurderede data.
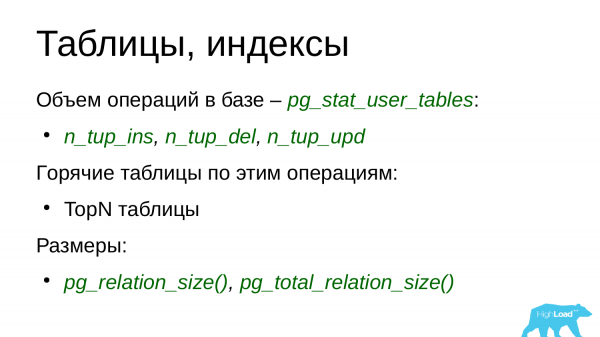
Hvordan får man statistik for disse tabeller? Til dette har PostgreSQL et vist antal visninger. Og den primære visning er . User_tables betyder, at tabellerne er oprettet på brugerens vegne. I modsætning til dette er der systemvisninger, som bruges af PostgreSQL selv. Og der er en opsummeringstabel kaldet Alltables, som inkluderer både system- og brugertabeller. Du kan basere dig på hvilken som helst af dem, som du bedst kan lide.
Efter de angivne felter kan man vurdere antallet af insert, update og delete. Det eksempel dashboard, jeg brugte, bruger netop disse felter til at vurdere egenskaberne ved arbejdsbelastningen. Derfor kan vi også basere os på dem. Men det er værd at huske, at det er tuples og ikke bytes, så vi kan ikke bare tage og gøre det til bytes.
Baseret på disse data kan vi konstruere såkaldte TopN-tabeller. For eksempel, Top-5, Top-10. Og man kan spore de 'varme' tabeller, der anvendes mere end andre. For eksempel de 5 'varme' tabeller på indsættelse. Og ud fra disse TopN-tabeller vurderer vi vores arbejdsbelastning og kan vurdere udsving i arbejdsbelastningen efter forskellige udgivelser, opdateringer og implementeringer.
Det er også vigtigt at vurdere størrelsen på tabellen, da udviklere nogle gange ruller en ny funktion ud, og vores tabeller begynder at vokse i størrelse, fordi de beslutter at tilføje yderligere data, men ikke har forudset, hvordan det vil påvirke størrelsen på databasen. Sådanne tilfælde er også overraskelser for os.
Og nu et lille spørgsmål til dig. Hvilket spørgsmål opstår, når du bemærker belastning på databaserver? Hvilket næste spørgsmål tænker du straks?
Men i virkeligheden opstår det næste spørgsmål. Hvilke forespørgsler forårsager belastningen? Altså, det er ikke interessant at se på processerne, som forårsager belastningen. Det er klart, at hvis der er en host med en database, så kører databasen der, og det er klart, at det kun er databasen, der vil blive udnyttet. Hvis vi åbner Top, vil vi se en liste over processer i PostgreSQL, som laver et eller andet. Fra Top vil det ikke være klart, hvad de laver.
Derfor er det nødvendigt at opdage de forespørgsler, der forårsager den højeste belastning, fordi tuning af forespørgsler som regel giver mere gevinst end tuning af PostgreSQL-konfigurationen eller operativsystemet, eller endda tuning af hardwaren. Efter min vurdering er det cirka 80-85-90 %. Og det kan gøres meget hurtigere. Det er hurtigere at rette en forespørgsel end at ændre konfigurationen, planlægge en genstart, især hvis databasen ikke kan genstartes, eller tilføje hardware. Det er nemmere at omskrive en forespørgsel et sted eller tilføje et indeks for at få et bedre resultat fra denne forespørgsel.
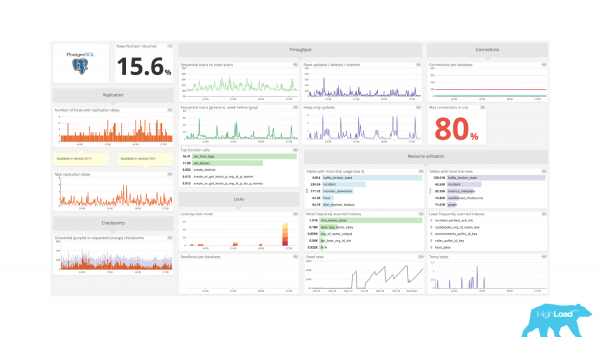
Derfor er det nødvendigt at overvåge forespørgslerne og deres adækvathed. Lad os tage et andet eksempel på overvågning. Og her ser overvågningen også fremragende ud. Der er information om replikation, der er information om båndbredde, låsning, ressourceudnyttelse. Alt ser perfekt ud, men der er ingen information om forespørgsler. Det er uklart, hvilke forespørgsler der udføres i vores database, hvor længe de udføres, og hvor mange af disse forespørgsler er der. Vi skal altid have denne information i overvågningen.
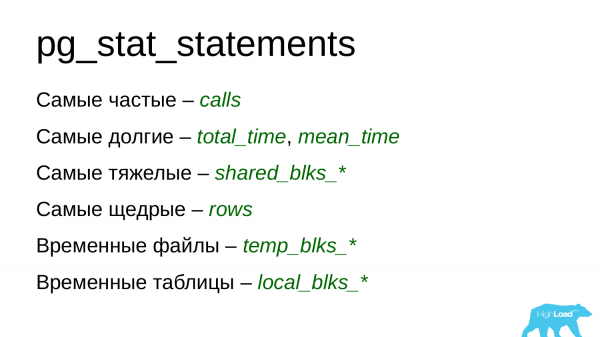
Og for at få disse oplysninger kan vi bruge modulet pg_stat_statements. Baseret på det kan vi opbygge forskellige typer diagrammer. For eksempel kan vi få information om de mest hyppige forespørgsler, det vil sige dem, der udføres oftest. Ja, efter deployment er det også meget nyttigt at se på det og forstå, om der er nogen pludselige stigninger i forespørgslerne.
Vi kan overvåge de længste forespørgsler, det vil sige de forespørgsler, der tager længst tid at udføre. De belaster CPU'en og forbruger I/O. Vi kan også vurdere dette ud fra felterne total_time, mean_time, blk_write_time og blk_read_time.
Vi kan vurdere og overvåge de mest ressourcekrævende forespørgsler, dem der læser fra disken, som arbejder med hukommelsen, eller omvendt, som skaber en skrivebelastning.
Vi kan vurdere de mest generøse forespørgsler. Det er de forespørgsler, der returnerer et stort antal rækker. For eksempel kan det være en forespørgsel, hvor der er glemt at sætte en grænse. Og den returnerer simpelthen alt indholdet i tabellen eller forespørgslen for de anmodede tabeller.
Og vi kan også overvåge forespørgsler, der bruger midlertidige filer eller midlertidige tabeller.
Og vi har baggrundsprocesser. Baggrundsprocesser er primært tjekpunkter, eller hvad de også kaldes, kontrolpunkter, autovacuum og replikation.
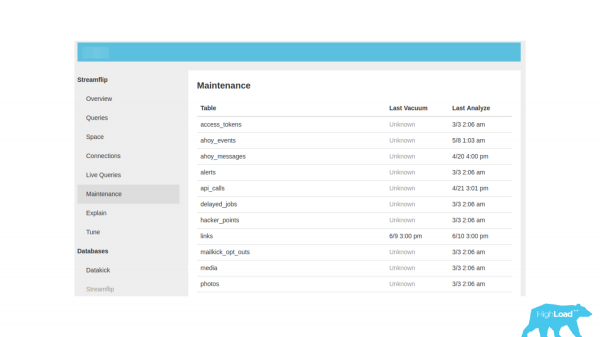
Et andet eksempel på overvågning. Der er en fane til venstre kaldet Maintenance, vi går ind på den og håber at se noget nyttigt. Men her er der kun information om tiden for vakuum og statistikindsamling, ikke mere. Det er meget fattige oplysninger, så vi skal altid have information om, hvordan baggrundsprocesserne fungerer i vores database, og om der er problemer som følge af deres arbejde.
Når vi betragter kontrolpunkter, skal vi huske, at kontrolpunkter rydder «snuskede» sider fra det shardede hukommelsesområde til disken og derefter opretter et kontrolpunkt. Dette kontrolpunkt kan derefter bruges som et sted ved genopretning, hvis PostgreSQL skulle afsluttes pludseligt.
For this reason, to flush all 'dirty' pages to disk, a certain amount of writing needs to be done. Typically, on systems with large memory, this is substantial. If we have checkpoints occurring very frequently within a short interval, disk performance can significantly decline. Client requests will suffer from a lack of resources. They will compete for resources and will find the performance inadequate.
Accordingly, through pg_stat_bgwriter and the specified fields, we can monitor the number of occurring checkpoints. If we have a lot of checkpoints within a certain time frame (10-15-20 minutes, half an hour), say 3-4-5, it may indicate a problem. We need to examine the database and check the configuration to identify what is causing this abundance of checkpoints. There might be some large write operations. Based on the workload, we can assess since the workload graphs have already been added. We can fine-tune the checkpoint parameters so that they do not significantly impact query performance.
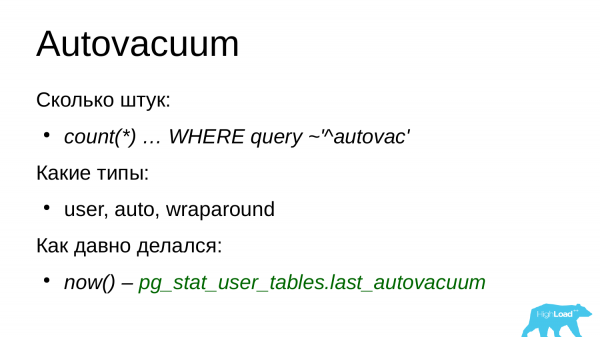
I am returning to autovacuum because it is something, as I've mentioned, that can easily hinder the performance of both disks and queries, so it's always important to evaluate the number of autovacuum tasks.
The number of autovacuum workers in the database is limited. By default, there are three, so if we consistently have three workers running in the database, it means that autovacuum is underconfigured. Limits need to be raised, and autovacuum settings should be reviewed to delve into the configuration.
It is important to evaluate which autovacuum workers are running. It may be one initiated by a user, where a DBA manually started a vacuum task, creating a load. We may encounter certain issues that arise from this. Alternatively, it could be the number of vacuums that are incrementing the transaction counter. For some versions of PostgreSQL, these can be very intensive vacuums. They can easily hinder performance since they read the entire table completely, scanning all blocks in the table.
Og selvfølgelig varigheden af vakuumerne. Hvis vi har lange vakuumer, der arbejder i meget lang tid, betyder det, at vi igen skal overveje konfigurationen af vakuummet og muligvis revidere dets indstillinger. For der kan opstå en situation, hvor vakuummet arbejder over en tabel i lang tid (3-4 timer), men i løbet af vakuumets arbejde har der igen samlet sig et stort antal døde rækker i tabellen. Og så snart vakuummet er færdigt, skal det igen vakuumere denne tabel. Og vi ender i en situation med et uendeligt vakuum. I sådanne tilfælde klarer vakuummet ikke sit arbejde, og tabellerne begynder gradvist at svulme i størrelse, selvom mængden af nyttige data i dem forbliver den samme. Derfor ser vi altid på konfigurationen ved lange vakuumer og forsøger at optimere den, men uden at det går ud over ydeevnen for kundernes forespørgsler.
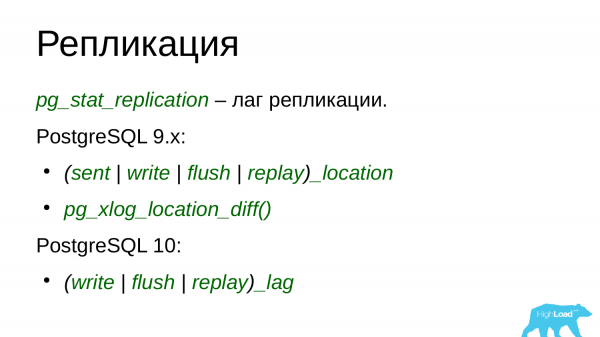
Der er nu næsten ikke nogen installation af PostgreSQL, hvor der ikke er stream replication. Replication er processen med at overføre data fra master til replika.
Replication i PostgreSQL fungerer via transaktionsloggen. Master genererer transaktionsloggen. Transaktionsloggen sendes via netværksforbindelsen til replikaen, og derefter bliver den reproduceret på replikaen. Det er meget simpelt.
Til overvågning af replikaionslag anvendes visningen pg_stat_replication. Men det er ikke så enkelt. I version 10 har visningen gennemgået flere ændringer. For det første er nogle felter blevet omdøbt. Og nogle felter er blevet tilføjet. I version 10 er der tilføjet felter, der gør det muligt at vurdere replikaionslaget i sekunder. Det er meget praktisk. Inden version 10 var det muligt at vurdere replikaionslaget i bytes. Denne mulighed er også bevaret i version 10, dvs. du kan vælge, hvad der er mere praktisk for dig - at vurdere laget i bytes eller vurdere laget i sekunder. Mange gør begge dele.
Men for at kunne vurdere replikaionslaget skal man kende journalens position i transaktionen. Og disse journalpositioner findes netop i visningen pg_stat_replication. Groft sagt kan vi ved hjælp af funktionen pg_xlog_location_diff() tage to punkter i transaktionsloggen. Beregn forskellen mellem dem og få replikaionslaget i bytes. Det er meget praktisk og enkelt.
I den tiende version blev denne funktion omdøbt til pg_wal_lsn_diff(). Generelt blev alle funktioner, udsigtsposter og værktøjer, der indeholdt ordet 'xlog', ændret til 'wal'. Dette gælder både for udsigtsposter og funktioner. Det er sådan en nyhed.
Derudover blev der i den tiende version tilføjet linjer, som specifikt viser lag. Det er write lag, flush lag, replay lag. Det vil sige, at disse faktorer er vigtige at overvåge. Hvis vi ser, at der er lag i replikationen, skal vi undersøge, hvorfor det opstod, hvor det kom fra, og løse problemet.
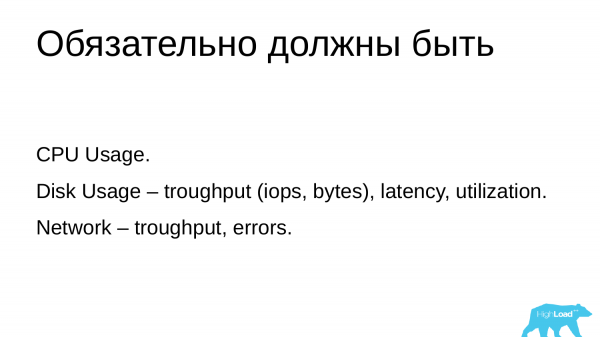
Med de systemmæssige målinger er næsten alt i orden. Når der oprettes en hvilken som helst overvågning, starter den med systemmæssige målinger. Dette dækker CPU-udnyttelse, hukommelse, swap, netværk og disk. Men der er mange parametre, der ikke er inkluderet som standard.
Hvis CPU-udnyttelsen er i orden, er der problemer med diskudnyttelsen. Som regel tilføjer udviklere overvågningsværktøjer oplysninger om båndbredde. Det kan være i iops eller bytes. Men de glemmer latency og udnyttelse af diskene. Disse er vigtigere parametre, som gør det muligt at vurdere, hvor belastede vores diske er, og hvor meget de bremser. Hvis vi har høj latency, betyder det, at der er problemer med diskene. Hvis vi har høj udnyttelse, betyder det, at diskene ikke kan klare opgaven. Dette er mere kvalitetsegnede karakteristika end båndbredde.
Selvom denne statistik også kan opnås fra filsystemet /proc, som det gøres for CPU-udnyttelse. Jeg ved ikke, hvorfor de ikke inkluderer disse oplysninger i overvågninger. Men det er da vigtigt at have dette i sin overvågning.
Det samme gælder netværksinterfaces. Der er oplysninger om netværksbåndbredde i pakker, i bytes, men alligevel er der ingen information om latency og ingen information om udnyttelse, selvom det også er nyttig information.
Enhver overvågning har mangler. Uanset hvilken overvågning du vælger, vil den altid ikke opfylde visse kriterier. Men alligevel udvikler de sig, nye funktioner og nye ting tilføjes, så vælg noget og finpuds det.
Og for at kunne finpudse skal man altid have et klart billede af, hvad den leverede statistik betyder og hvordan man kan bruge den til at løse problemer.
Og nogle nøglepunkter:
- Det er altid vigtigt at overvåge tilgængeligheden og have dashboards, så du hurtigt kan vurdere, at alt er i orden med databasen.
- Det er altid vigtigt at have en forståelse for, hvilke kunder der arbejder med din database, så du kan identificere dårlige kunder og ekskludere dem.
- Det er vigtigt at vurdere, hvordan disse kunder arbejder med dataene. Du skal have en forståelse af din arbejdsbelastning.
- Det er vigtigt at vurdere, hvordan denne arbejdsbelastning dannes, og hvilke forespørgsler der anvendes. Du kan vurdere forespørgslerne, optimere dem, refaktorere dem og bygge indekser til dem. Dette er meget vigtigt.
- Baggrundsprocesser kan negativt påvirke kundeforespørgsler, så det er vigtigt at overvåge, så de ikke bruger for mange ressourcer.
- Systemmetrikker giver dig mulighed for at lave planer for skalering og øgning af kapaciteten på dine servere, så det er også vigtigt at overvåge og vurdere dem.
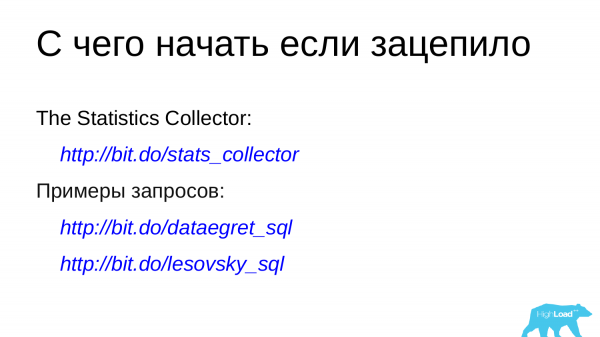
Hvis du er interesseret i dette emne, kan du følge disse links.
— det er den officielle dokumentation til statistikindsamlere. Der er en beskrivelse af alle statistiske visninger og beskrivelse af alle felter. Du kan læse dem, forstå dem og analysere dem. Og på baggrund af dem kan du bygge dine egne grafer og tilføje dem til dine overvågningssystemer.
Eksempler på forespørgsler:
Dette er vores virksomheders repository og mit eget. Der er eksempler på forespørgsler. Der er ikke forespørgsler af typen select* from noget som helst. Der er allerede klare forespørgsler med joins og anvendelse af interessante funktioner, der gør rå tal til læselige, brugbare værdier, altså bytes, tid. Du kan udforske dem, se på dem, analysere dem, tilføje dem til dine overvågningssystemer og bygge dine egne overvågningssystemer baseret på dem.
Spørgsmål
Spørgsmål: Du sagde, at du ikke ville reklamerer for mærker, men jeg er stadig interesseret – hvilke dashboards bruger du i dine projekter?
Svar: Forskelligt. Nogle gange kommer vi til en kunde, og de har allerede deres eget overvågningssystem. Og vi rådgiver kunden om, hvad der skal tilføjes til deres overvågning. Det værste er med Zabbix. Fordi det ikke har mulighed for at opbygge TopN-grafer. Vi bruger selv , fordi vi rådgav disse fyre om overvågning. De lavede overvågningssystemer til PostgreSQL baseret på vores specifikationer. Jeg skriver mit eget pet-project, som indsamler data via Prometheus og visualiserer dem i . Jeg har til opgave at lave min egen eksportør i Prometheus og derefter visualisere alt i Grafana.
Spørgsmål: Findes der nogen alternativer til AWR-rapporter eller ... aggregationer? Kender du til noget sådant?
Svar: Ja, jeg ved, hvad AWR er, det er en fantastisk ting. Der findes faktisk mange forskellige løsninger, der implementerer en nogenlunde lignende model. Med bestemte intervaller logges nogle baselines i den samme PostgreSQL eller i et separat lager. De kan findes via Google, og de eksisterer. En af udviklerne af sådan en løsning er aktiv på forumet sql.ru i tråden om PostgreSQL. Du kan fange ham der. Ja, sådanne løsninger er der, og de kan bruges. Plus, jeg arbejder også på en løsning, der gør det samme. Jeg skriver også noget, der muliggør det samme.
P.S.1 Hvis du bruger postgres_exporter, hvilken dashboard bruger du? Der er flere forskellige. De er allerede forældede. Måske kunne fællesskabet skabe en opdateret skabelon?
P.S.2 Jeg har fjernet pganalyze, da det er et proprietært SaaS-tilbud, der fokuserer på performancesporing og automatiserede tuningforslag.
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Hvilken self-hosted overvågning af PostgreSQL (med dashboard) synes du er den bedste?
30,0%Zabbix + tilføjelser fra Alexey Lesovsky eller zabbix 4.4 eller libzbxpgsql + zabbix libzbxpgsql + zabbix3
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%pganalyze er et proprietært SaaS – kan ikke fjerne det.
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
10 brugere har stemt. 26 brugere har undladt at stemme.
Kilde: habr.com
