

Hej venner. Før vi går ind i den anden del af majferien, deler vi et materiale, som vi har oversat i forkant af lanceringen af det nye kursusforløb. .
App-udviklere bruger meget tid på at sammenligne flere operationelle databaser for at vælge den, der bedst passer til den forventede arbejdsbelastning. Behovene kan omfatte forenklet datamodelering, transaktionelle garantier, læse-/skriveydelse, horisontal skalering og fejltolerance. Traditionsmæssigt begynder valget med databaskategorien SQL eller NoSQL, da hver kategori giver et klart sæt kompromiser. Høj ydeevne i form af lav latency og høj gennemstrømning betragtes normalt som et ufravigeligt krav og er derfor nødvendigt for enhver database i udvalget.
Formålet med denne artikel er at hjælpe app-udviklere med at træffe det rigtige valg mellem SQL og NoSQL i konteksten af applikationens datamodelering. Vi vil se på én SQL-database, nemlig PostgreSQL, samt to NoSQL-databaser – Cassandra og MongoDB, for at tale om grundlæggende database-design, såsom oprettelse af tabeller, udfyldning af dem, læsning af data fra tabellerne og sletning af dem. I den næste artikel vil vi helt sikkert se på indekser, transaktioner, JOINs, TTL-direktiver og database-design baseret på JSON.
Hvad er forskellen mellem SQL og NoSQL?
SQL-databaser øger applikationens fleksibilitet med ACID-transaktionelle garantier samt deres evne til at forespørge data på uventede måder over eksisterende normaliserede modeller af relationelle databaser.
I betragtning af deres monolitisk/single-node arkitektur og brugen af master-slave replikationsmodellen for redundans, har traditionelle SQL-databaser ikke to vigtige egenskaber – lineær skridvækst af skrivning (dvs. automatisk partitionering på flere noder) og automatisk/null datatab. Dette betyder, at mængden af modtagne data ikke kan overstige den maksimale skrivecapacitetsgrænse for en enkelt node. Derudover skal der tages højde for nogle midlertidige datatab i forbindelse med fejltolerance (i en arkitektur uden ressourceopdeling). Her skal det bemærkes, at nylige commits endnu ikke er afspejlet i slavekopien. Også opdateringer uden nedetid er vanskelige at opnå i SQL-databaser.
NoSQL-databaser er i deres natur typisk distribuerede, dvs. data opdeles i sektioner og distribueres over flere noder. De kræver denormalisering. Det betyder, at de indtastede data også skal kopieres flere gange for at svare på specifikke forespørgsler, som du sender. Den overordnede mål er at opnå høj ydeevne ved at reducere antallet af shard, der er tilgængelige under læsning. Heraf følger påstanden, at NoSQL kræver, at du modellerer dine forespørgsler, mens SQL kræver, at du modellerer dine data.
NoSQL fokuserer på at opnå høj ydeevne i en distribueret klynge, og dette er hovedårsagen til mange designkompromiser i databasesystemer, herunder tab af ACID-transaktioner, JOINs og konsistente globale sekundære indekser.
Der er en opfattelse af, at selvom NoSQL-databaser tilbyder lineær skridvækst af skrivning og høj fejltolerance, gør tabet af transaktionsgarantier dem uegnede til kritisk vigtige data.
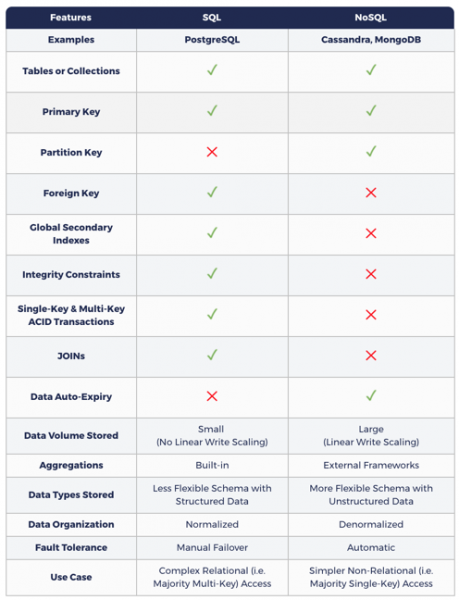
Den følgende tabel viser, hvordan datamodelering i NoSQL adskiller sig fra SQL.
SQL og NoSQL: Hvorfor har vi brug for begge?
I komplekse anvendelser med mange brugere, såsom Amazon.com, Netflix, Uber og Airbnb, hviler udførelsen af komplekse og varierede opgaver. For eksempel har en e-handelsapplikation som Amazon.com brug for at opbevare letvægts, kritiske data som brugeroplysninger, produktinformation, ordrer og fakturaer, sammen med store, men mindre følsomme data som produktanmeldelser, supportbeskeder, brugeraktivitet, vurderinger og anbefalinger fra brugere. Naturligvis afhænger disse applikationer af minimum én SQL-database sammen med mindst én NoSQL-database. I tværregional og globale systemer fungerer NoSQL-databasen som en geografisk distribueret cache for data gemt i en betroet kilde, SQL-databasen, der opererer i et enkelt område.
Hvordan kombinerer YugaByte DB SQL og NoSQL?
Bygget på en log-orienteret blandet lagermotor til lagring, auto-sharding, sharding distribueret konsensus replikation og distribuerede ACID-transaktioner (inspireret af Google Spanner), er YugaByte DB den første open-source database i verden, der samtidig er kompatibel med NoSQL (Cassandra & Redis) og SQL (PostgreSQL). Som vist i tabellen nedenfor tilføjer YCQL, YugaByte DB's Cassandra-kompatible API, begreberne for enkelt- og flermønstret ACID-transaktioner samt globale sekundære indekser til NoSQL API'en, hvilket åbner æraen for transaktionelle NoSQL-databaser. Desuden tilføjer YCQL, YugaByte DB's PostgreSQL-kompatible API, begreberne for lineær optegnelse og automatisk fejltolerance til SQL API'en, og præsenterer den distribuerede SQL-database for verden. Da YugaByte DB i sin essens er transaktionel, kan NoSQL API'en nu bruges i konteksten af kritiske data.
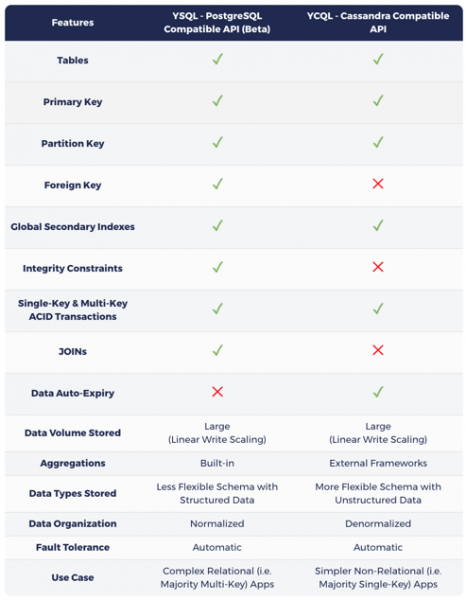
Som nævnt tidligere i artiklen , valget mellem SQL eller NoSQL i YugaByte DB afhænger fuldstændigt af karakteren af den underliggende arbejdsbyrde:
- Hvis den underliggende arbejdsbyrde består af flermønstret operationer med JOINs, så husk at vælge YSQL; dine nøgler kan være fordelt over flere noder, hvilket kan føre til højere latens og/eller lavere båndbredde sammenlignet med NoSQL.
- Hvis ikke, vælg en af de to NoSQL API'er, og husk at du vil få bedre ydeevne fra forespørgsler, der betjenes fra én node ad gangen. YugaByte DB kan fungere som den eneste operationelle database til komplekse applikationer, der kræver håndtering af flere arbejdsbelastninger samtidigt.
I den følgende sektion af laboratoriet for datamodellering (Data modeling lab) findes YugaByte DB-databaser, der er kompatible med PostgreSQL og Cassandra, i modsætning til de oprindelige databaser. Denne tilgang fremhæver enkelheden ved at interagere med to forskellige API'er (på to forskellige porte) af den samme databaseklynge i modsætning til at bruge fuldstændig uafhængige klynger af to forskellige databaser.
I de følgende sektioner vil vi introducere laboratoriet for datamodellering for at illustrere forskellene og nogle fællestræk mellem de undersøgte databaser.
Laboratorium for datamodellering
Installation af databaser
Med fokus på design af datamodeller (og ikke på komplekse implementeringsarkitekturer) vil vi installere databaserne i Docker-containere på den lokale computer og derefter interagere med dem ved hjælp af de relevante kommandolinjegrænseflader.
PostgreSQL & Cassandra-kompatibel database YugaByte DB
mkdir ~/yugabyte && cd ~/yugabyte
wget https://downloads.yugabyte.com/yb-docker-ctl && chmod +x yb-docker-ctl
docker pull yugabytedb/yugabyte
./yb-docker-ctl create --enable_postgres
MongoDB
docker run --name my-mongo -d mongo:latestAdgang via kommandolinjen
Lad os forbinde til databaserne ved hjælp af kommandolinjegrænsefladen for de relevante API'er.
PostgreSQL
— er en kommandolinjegrænseflade til interaktion med PostgreSQL. For nemheds skyld leveres YugaByte DB med psql direkte i bin-mappen.
docker exec -it yb-postgres-n1 /home/yugabyte/postgres/bin/psql -p 5433 -U postgresCassandra
— er en kommandolinjegrænseflade til interaktion med Cassandra og dens kompatible databaser gennem CQL (Cassandra Query Language). For nemheds skyld leveres YugaByte DB med cqlsh i katalogen bin.
Bemærk, at CQL er inspireret af SQL og har lignende begreber som tabeller, rækker, kolonner og indekser. Som et NoSQL-sprog tilføjer det dog et bestemt sæt begrænsninger, hvoraf de fleste også vil blive diskuteret i andre artikler.
docker exec -it yb-tserver-n1 /home/yugabyte/bin/cqlshMongoDB
– er et kommandolinjegrænseflade til interaktion med MongoDB. Den kan findes i bin-kataloget i MongoDB-installationen.
docker exec -it my-mongo bash
cd bin
mongo
Oprettelse af tabel
Nu kan vi interagere med databasen for at udføre forskellige operationer via kommandolinjen. Lad os begynde med at oprette en tabel, der gemmer information om sange skrevet af forskellige kunstnere. Disse sange kan være en del af et album. Desuden er der valgfrie attributter for sangen – udgivelsesår, pris, genre og bedømmelse. Vi skal tage højde for yderligere attributter, der kan blive nødvendige i fremtiden, gennem feltet "tags". Dette kan gemme semistrukturerede data i form af nøgle-værdi-par.
PostgreSQL
CREATE TABLE Music (
    Artist VARCHAR(20) NOT NULL,
    SongTitle VARCHAR(30) NOT NULL,
    AlbumTitle VARCHAR(25),
    Year INT,
    Price FLOAT,
    Genre VARCHAR(10),
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
Cassandra
Oprettelse af tabel i Cassandra ligner meget PostgreSQL. En af de grundlæggende forskelle er fraværet af integritetsbegrænsninger (f.eks. NOT NULL), men dette er i applikationens ansvar og ikke NoSQL-databasens.. Den primære nøgle består af partitionens nøgle (kolonnen Artist i eksemplet nedenfor) og en række clustersøjler (kolonnen SongTitle i det følgende eksempel). Partitionsnøglen bestemmer, hvilken partition/shard der skal placeres i rækken, mens clustersøjlerne angiver, hvordan dataene skal organiseres inden for den aktuelle shard.
CREATE KEYSPACE myapp;
USE myapp;
CREATE TABLE Music (
    Artist TEXT,
    SongTitle TEXT,
    AlbumTitle TEXT,
    Year INT,
    Price FLOAT,
    Genre TEXT,
    CriticRating FLOAT,
    Tags TEXT,
    PRIMARY KEY(Artist, SongTitle)
);
MongoDB
MongoDB organiserer data i databaser (Database) (svarende til Keyspace i Cassandra), hvor der er kollektioner (Collections) (svarende til tabeller), som indeholder dokumenter (Documents) (svarende til rækker i tabellen). I MongoDB kræves der i princippet ikke en oprindelig skema-definition. Kommandoen "use database", som vist nedenfor, opretter en databaseinstans ved første kald og ændrer konteksten til den nyligt oprettede database. Selv kollektioner behøver ikke at blive oprettet eksplicit; de oprettes automatisk ved blot at tilføje det første dokument til en ny kollektion. Bemærk, at MongoDB som standard bruger en testdatabase, så enhver kollektionsoperation uden at angive en specifik database vil blive udført i den som standard.
use myNewDatabase;Hentning af tabelinformation
PostgreSQL
d Musik
Tabel "public.music"
    Kolonne    |         Type          | Sortering | Nullable | Standard
--------------+-----------------------+-----------+----------+--------
 kunstner     | karakter varierende(20)|           | ikke null |
 sangtitel    | karakter varierende(30)|           | ikke null |
 albumtitel   | karakter varierende(25)|           |          |
 år           | heltal               |           |          |
 pris         | dobbelt præcision    |           |          |
 genre        | karakter varierende(10)|           |          |
 anmeldelsesvurdering | dobbelt præcision|      |          |
 tags         | tekst                 |           |          |
Indekser:
    "music_pkey" PRIMARY KEY, btree (kunstner, sangtitel)
Cassandra
BESKRIV TABEL MUSIC;
OPRET TABEL myapp.music (
    kunstner tekst,
    sangtitel tekst,
    albumtitel tekst,
    år int,
    pris float,
    genre tekst,
    tags tekst,
    PRIMARY KEY (kunstner, sangtitel)
) MED KLUSTERING ORDNET EFTER (sangtitel ASC)
    OG default_time_to_live = 0
    OG transaktioner = {'enabled': 'false'};
MongoDB
brug myNewDatabase;
vis samlinger;
Indføring af data i tabel
PostgreSQL
INDsæt I Musik
    (Kunstner, SangTitel, AlbumTitel,
    År, Pris, Genre, AnmeldelsesVurdering,
    Tags)
Værdier(
    'No One You Know', 'Call Me Today', 'Somewhat Famous',
    2015, 2.14, 'Country', 7.8,
    '{"Composers": ["Smith", "Jones", "Davis"],"LengthInSeconds": 214}'
);
INDsæt I Musik
    (Kunstner, SangTitel, AlbumTitel,
    Pris, Genre, AnmeldelsesVurdering)
Værdier(
    'No One You Know', 'My Dog Spot', 'Hey Now',
    1.98, 'Country', 8.4
);
INDsæt I Musik
    (Kunstner, SangTitel, AlbumTitel,
    Pris, Genre)
Værdier(
    'The Acme Band', 'Look Out, World', 'The Buck Starts Here',
    0.99, 'Rock'
);
INDsæt I Musik
    (Kunstner, SangTitel, AlbumTitel,
    Pris, Genre,
    Tags)
Værdier(
    'The Acme Band', 'Still In Love', 'The Buck Starts Here',
    2.47, 'Rock',
    '{"radioStationsPlaying": ["KHCR", "KBQX", "WTNR", "WJJH"], "tourDates": { "Seattle": "20150625", "Cleveland": "20150630"}, "rotation": Heavy}'
);
Cassandra
Generelt er udtrykket INSERT i Cassandra meget lig det tilsvarende i PostgreSQL. Der er dog en stor forskel i semantikken. I Cassandra INSERT er det faktisk en operation UPSERT, hvor de nyeste værdier tilføjes til rækken, hvis rækken allerede eksisterer.
Dataindtastning sker på en måde der ligner PostgreSQL
INSERTover
.
MongoDB
Selvom MongoDB er en NoSQL database, ligner den Cassandra, har dens dataindsættelsesoperation intet at gøre med den semantiske adfærd i Cassandra. I MongoDB har ikke funktionalitet UPSERT, hvilket gør den lig PostgreSQL. At tilføje data uden _idspecified vil føre til, at et nyt dokument tilføjes kollektionen.
db.music.insert( {
 artist: "No One You Know",
 songTitle: "Ring Til Mig I Dag",
 albumTitle: "Lidt Berømt",
 year: 2015,
 price: 2.14,
 genre: "Country",
 tags: {
 Composers: ["Smith", "Jones", "Davis"],
 LengthInSeconds: 214
 }
 }
 );
 db.music.insert( {
 artist: "No One You Know",
 songTitle: "Min Hund Spot",
 albumTitle: "Hej Nu",
 price: 1.98,
 genre: "Country",
 criticRating: 8.4
 }
 );
 db.music.insert( {
 artist: "The Acme Band",
 songTitle: "Se Ud, Verden",
 albumTitle:"Pengene Starter Her",
 price: 0.99,
 genre: "Rock"
 }
 );
 db.music.insert( {
 artist: "The Acme Band",
 songTitle: "Fortsat Forelsket",
 albumTitle:"Pengene Starter Her",
 price: 2.47,
 genre: "Rock",
 tags: {
 radioStationsPlaying:["KHCR", "KBQX", "WTNR", "WJJH"],
 tourDates: {
 Seattle: "20150625",
 Cleveland: "20150630"
 },
 rotation: "Heavy"
 }
 }
 );
Tabelforespørgslen
Måske er den mest væsentlige forskel mellem SQL og NoSQL med hensyn til forespørgselsudformning at bruge formuleringer FROM og HVOR. SQL tillader efter udtrykket FROM at vælge flere tabeller, og udtrykket med HVOR kan have hvilken som helst kompleksitet (inklusive operationer JOIN mellem tabeller). Men NoSQL har en tendens til at pålægge strenge begrænsninger på FROM, og arbejde kun med en angivet tabel, og i HVOR, der altid skal angives en primær nøgle. Dette skyldes ønsket om at forbedre ydeevnen i NoSQL, som vi tidligere har talt om. Dette ønske fører til en reduktion af enhver kryds-tabellering og kryds-nøgle interaktion. Det kan føre til høj forsinkelse i mellem-noden kommunikation ved håndtering af forespørgsler og bør derfor undgås generelt. For eksempel kræver Cassandra, at forespørgsler begrænses til bestemte operatorer (kun tilladt =, IN, , =>, <=) på partition nøgler, undtagen i tilfælde af forespørgsel om sekundær indeks (her er kun operatoren = tilladt).
PostgreSQL
Der vil blive givet tre eksempler på forespørgsler, der nemt kan udføres af en SQL-database.
- Vis alle sange af kunstneren;
- Vis alle sange af kunstneren, der matcher den første del af titlen;
- Vis alle sange af kunstneren, der indeholder et bestemt ord i titlen og har en pris under 1,00.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE 'Call%';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle LIKE '%Today%'
AND Price > 1.00;
Cassandra
Af de nævnte forespørgsler vil kun den første fungere i Cassandra uden ændringer, da operatoren LIKE ikke kan anvendes på clustering columns, såsom SongTitle. I dette tilfælde er kun operatorer = og IN.
SELECT * FROM Music
WHERE Artist='No One You Know';
SELECT * FROM Music
WHERE Artist='No One You Know' AND SongTitle IN ('Call Me Today', 'My Dog Spot')
AND Price > 1.00;
MongoDB
Som vist i de tidligere eksempler, er den primære metode til at udforme forespørgsler i MongoDB . Denne metode indeholder eksplicit navnet på kollektionen (music i eksemplet nedenfor), så forespørgsler over flere samlinger er forbudt.
db.music.find( {
  artist: "No One You Know"
 }
);
db.music.find( {
  artist: "No One You Know",
  songTitle: /Call/
 }
);
Læse alle rækker i tabellen
At læse alle rækker er ganske enkelt et særligt tilfælde af den forespørgsels skabelon, vi tidligere har set.
PostgreSQL
SELECT *
FROM Music;
Cassandra
Ligesom eksemplet i PostgreSQL ovenfor.
MongoDB
db.music.find( {} );Redigere data i tabellen
PostgreSQL
PostgreSQL giver instruktionen OPDATERING til at ændre data. Denne har ikke muligheder UPSERT, så udførelsen af denne instruktion vil fejle, hvis rækkene ikke længere findes i databasen.
UPDATE Music
SET Genre = 'Disco'
WHERE Artist = 'The Acme Band' AND SongTitle = 'Still In Love';
Cassandra
I Cassandra er der OPDATERING en tilsvarende struktur i PostgreSQL. OPDATERING har samme semantik UPSERT, ligesom INSERT.
Ligesom eksemplet i PostgreSQL ovenfor.
MongoDB
Operation I MongoDB kan man fuldt opdatere et eksisterende dokument eller kun opdatere bestemte felter. Som standard opdaterer den kun ét dokument uden semantik. UPSERT. Opdatering af flere dokumenter og adfærd ligner. UPSERT kan anvendes ved at indstille yderligere flags til operationen. Som i eksemplet nedenfor opdateres genren af en bestemt kunstner baseret på deres sang.
db.music.update(
  {"artist": "The Acme Band"},
  {
    $set: {
      "genre": "Disco"
    }
  },
  {"multi": true, "upsert": true}
);
Sletning af data fra tabellen
PostgreSQL
DELETE FROM Music
WHERE Artist = 'The Acme Band' AND SongTitle = 'Look Out, World';
Cassandra
Ligesom eksemplet i PostgreSQL ovenfor.
MongoDB
I MongoDB er der to typer operationer til at slette dokumenter — og . Begge typer sletter dokumenter, men returnerer forskellige resultater.
db.music.deleteMany( {
        artist: "The Acme Band"
    }
);
Sletning af tabellen
PostgreSQL
DROP TABLE Music;Cassandra
Ligesom eksemplet i PostgreSQL ovenfor.
MongoDB
db.music.drop();Konklusion
Debatten om valget mellem SQL og NoSQL har raset i mere end 10 år. Der er to grundlæggende aspekter af denne debat: arkitektur af databasekernen (monolitisk, transaktionel SQL versus distribueret, ikke-transaktionel NoSQL) og tilgang til database-design (datamodellering i SQL versus modellering af dine forespørgsler i NoSQL).
Med en distribueret transaktionel database som YugaByte DB kan debatten om databasearkitektur let afvises. Efterhånden som datamængderne overstiger det, der kan skrives til én node, bliver en fuldstændig distribueret arkitektur, der understøtter lineær skrive-skalering med automatisk sharding/omfordeling, nødvendig.
Udover det, som nævnt i en af artiklerne , anvendes transaktionelle, strengt konsistente arkitekturer nu mere bredt for at sikre bedre fleksibilitet i udviklingen end ikke-transaktionelle, endeligt konsistente arkitekturer.
Når vi vender tilbage til diskussionen om database design, er det rimeligt at sige, at begge tilgange til design (SQL og NoSQL) er nødvendige for enhver kompleks, virkelighedsbaseret applikation. SQL-tilgangen "data-modellering" gør det nemmere for udviklere at imødekomme skiftende forretningskrav, mens NoSQL-tilgangen "forespørgsels-modellering" giver de samme udviklere mulighed for at håndtere store datamængder med lav forsinkelse og høj kapacitet. Af denne grund tilbyder YugaByte DB SQL og NoSQL API i et fælles kerne, i stedet for at fremme én tilgang over den anden. Desuden, ved at sikre kompatibilitet med populære database-sprog som PostgreSQL og Cassandra, sikrer YugaByte DB, at udviklerne ikke behøver at lære et andet sprog for at arbejde med den distribuerede, streng overensstemmende databasekerne.
I denne artikel har vi undersøgt, hvordan grundlæggende database designprincipper adskiller sig mellem PostgreSQL, Cassandra og MongoDB. I de næste artikler dykker vi ned i avancerede designkoncepter som indekser, transaktioner, JOINs, TTL-direktiver og JSON-dokumenter.
Vi ønsker jer en fantastisk tilbageholdende weekend og inviterer jer til , som finder sted den 14. maj.
Kilde: habr.com
