

Denne forår har vi allerede diskuteret nogle grundlæggende emner, for eksempel, og . I det andet emne lovede vi endda at fortsætte med at undersøge ydeevnen af forskellige multi-disk topologier i ZFS. Det er et næste generations filsystem, der i øjeblikket implementeres overalt: fra op til .
Nå, i dag er den perfekte dag til at lære ZFS at kende, nysgerrige læsere. Bare husk, at ifølge udvikleren af OpenZFS, Matt Arons, "det er virkelig kompliceret".
Men inden vi når frem til tallene — og de vil komme, det lover jeg — for alle typer med otte disk konfigurationer i ZFS, skal vi tale om, hvordan hvordan ZFS overhovedet gemmer data på disken.
Zpool, vdev og device
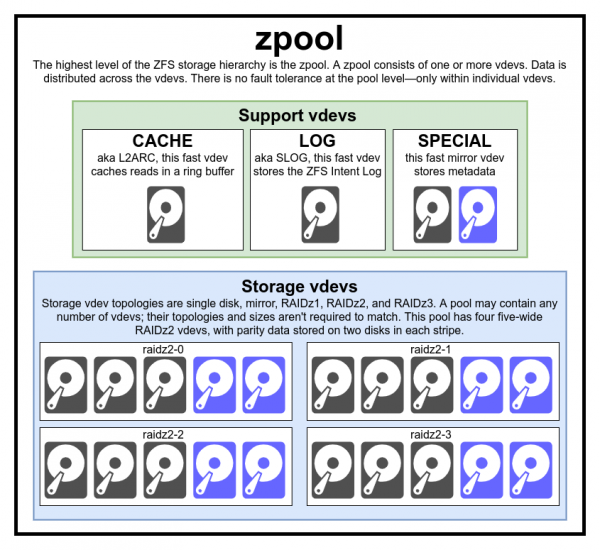
Denne diagram over den kompletnet zpool inkluderer tre hjælpe vdev'en, en af hver type, og fire til RAIDz2
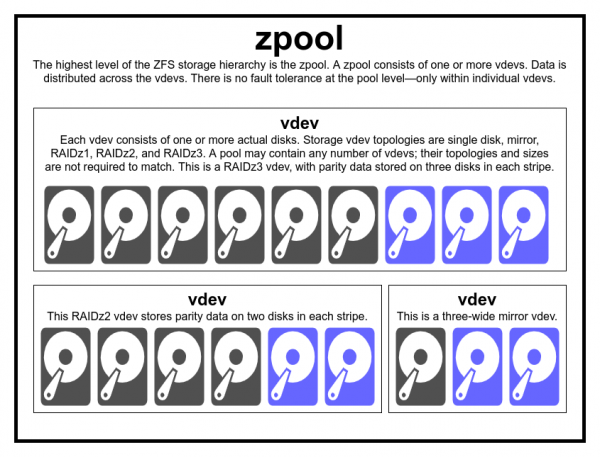
Der er normalt ingen grund til at oprette en pool af ikke-sammenlignelige typer og størrelser af vdev — men hvis du ønsker det, er der intet, der forhindrer dig i at gøre det
For virkelig at forstå ZFS-filsystemet skal man se nærmere på dens faktiske struktur. For det første kombinerer ZFS de traditionelle niveauer af volumenstyring og filsystemet. For det andet bruger det en transaktionel metode til skrivning. Disse egenskaber betyder, at systemet er strukturelt meget forskelligt fra almindelige filsystemer og RAID-arrays. Den første sætningssæt af grundlæggende byggeklodser til forståelse: det er et lagringspul (zpool), et virtuelt device (vdev) og et reelt device (device).
zpool
Lagringspul zpool er den overordnede struktur i ZFS. Hver pul indeholder et eller flere virtuelle enheder. Hver af disse indeholder et eller flere reelle enheder (device). Virtuelle pul er selvstændige blokke. En fysisk computer kan indeholde to eller flere separate puuld, men hver er helt uafhængig af de andre. Puler kan ikke dele virtuelle enheder.
ZFS's redundans er på niveau med de virtuelle enheder snarere end på niveau med pulerne. På niveauet for pulerne er der slet ingen redundans — hvis nogen vdev-enhed eller special vdev går tabt, går hele pulen tabt med den.
Moderne lagringspuljer kan overleve tabet av cache eller logg fra det virtuelle enheten - selv om de kan miste en liten mengde skitne data hvis de mister vdev-loggen under strømutkobling eller systemfeil.
Det er en utbredt misforståelse at «data stripes» (stripe) i ZFS skrives over hele puljen. Det er ikke riktig. Zpool er slett ikke et morsomt RAID0, det er snarere morsomt med en kompleks variabel distribusjonsmekanisme.
For det meste blir registreringene fordelt mellom de tilgjengelige virtuelle enhetene i henhold til den frie plassen som er tilgjengelig, slik at de teoretisk sett vil bli fylt samtidig. I senere versjoner av ZFS tas det hensyn til den nåværende bruken (utnyttelsen) av vdev - hvis en virtuell enhet er betydelig mer belastet enn en annen (for eksempel på grunn av leseoperasjoner), vil den bli midlertidig hoppet over for skriving, til tross for at den har den høyeste frie plassen.
Utnyttelsesmekanismen innebygd i moderne ZFS-skrivfordelingsmetoder kan redusere latens og øke gjennomstrømningen i perioder med unormalt høy belastning - men det er ikke blankosjekk for ufrivillig blanding av langsomme HDD-er og raske SSD-er i én pulje. En slik ujevn pulje vil fortsatt fungere med hastigheten til den tregeste enheten, altså som om den helt og holdent var laget av slike enheter.
vdev
Hver lagringspulje består av ett eller flere virtuelle enheter (virtual device, vdev). Hver vdev inkluderer igjen ett eller flere fysiske enheter. De fleste virtuelle enheter brukes til enkel datalagring, men det finnes flere hjelpekategorier av vdev, inkludert CACHE, LOG og SPECIAL. Hver av disse typene vdev kan ha en av fem topologier: enkelt enhet (single-device), RAIDz1, RAIDz2, RAIDz3 eller speil (mirror).
RAIDz1, RAIDz2 og RAIDz3 er specielle varianter af det, som gamle folk ville kalde RAID med dobbelt (diagonal) paritet. 1, 2 og 3 henviser til, hvor mange paritetsblokke der er tildelt til hver dataramme. I stedet for separate diske til at sikre paritet fordeler RAIDz virtuelle enheder denne paritet jævnt mellem diskene. Et RAIDz-array kan miste så mange diske, som det har paritetsblokke; hvis det mister en mere, vil det fejle og tage lagringspuljen med sig.
I spejlede virtuelle enheder (mirror vdev) gemmes hver blok på hver enhed i vdev. Selvom to-dobbelte spejle (two-wide) er de mest almindelige, kan der være et vilkårligt antal enheder i et spejl - i større installationer bruges der ofte tre-dobbelte enheder for at forbedre læseydelsen og fejlresistensen. Et spejl vdev kan overleve enhver fejl, så længe mindst én enhed i vdev stadig fungerer.
Enkeltstående vdev er i sin essens farlige. En sådan virtuel enhed vil ikke overleve nogen fejl - og hvis den bruges som lager eller special vdev, vil dens fejl resultere i ødelæggelsen af hele puljen. Vær meget, meget forsigtig her.
Virtuelle enheder CACHE, LOG og SPECIAL kan oprettes efter hvilken som helst af de ovennævnte topologier - men husk, at tabet af en virtuel enhed SPECIAL betyder tab af hele puljen, så det anbefales kraftigt at have en redundant topologi.
enhed
Dette er sandsynligvis det letteste at forstå begreb i ZFS - det er bogstaveligt talt et bloklagringsapparat. Husk, at virtuelle enheder består af separate enheder, mens puljen er lavet af virtuelle enheder.
Drev - magnetiske eller SSD - er de mest almindelige bloklagringsenheder, der bruges som byggesten til vdev. Dog kan ethvert apparat med en beskrivelse i /dev bruges - så hele hardware RAID-arrays kan bruges som separate enheder.
En simpel råfil er en af de vigtigste alternative bloklagringsenheder, som et vdev kan bygges af. Testpuljer fra er en meget bekvem måde at teste pulje-kommandoer på og se, hvor meget plads der er tilgængelig i puljen eller det virtuelle enhed i den pågældende topologi.
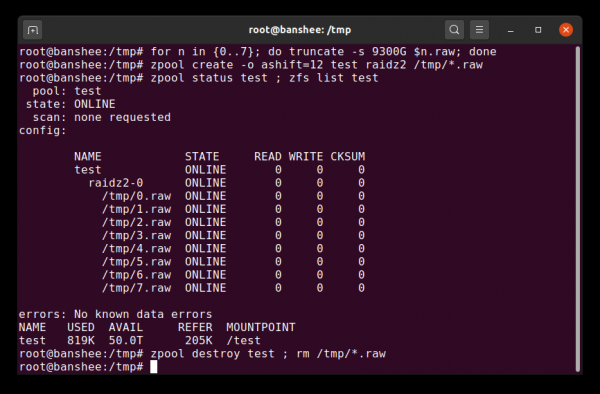
Du kan oprette et test-pool med sparsomme filer på blot et par sekunder — men glem ikke at slette hele poolen og dens komponenter efterfølgende.
Lad os sige, at du vil opsætte en server med otte diske og planlægger at bruge diske på 10 TB (~9300 GiB) — men du er ikke sikker på, hvilken topologi der bedst opfylder dine behov. I ovenstående eksempel opretter vi på få sekunder et test-pool med sparsomme filer — og vi ved nu, at et RAIDz2 vdev med otte diske på 10 TB giver 50 TiB nyttig kapacitet.
En anden særlig klasse af enheder er SPARE (reservedele). Hot-swappable enheder tilhører, i modsætning til almindelige enheder, hele poolen, ikke et enkelt virtuelt device. Hvis et vdev i poolen svigter, og en reservedele er tilsluttet poolen og tilgængelig, vil den automatisk blive tilsluttet det berørte vdev.
Efter at være blevet tilsluttet det berørte vdev, begynder reservedele-enheden at modtage kopier eller rekonstruktioner af data, der skulle være på den manglende enhed. I traditionel RAID kaldes dette genopbygning (rebuilding), mens det i ZFS kaldes 'genopretning af redundans' (resilvering).
Det er vigtigt at bemærke, at reservedele ikke permanent erstatter defekte enheder. Det er kun en midlertidig erstatning for at reducere den tid, hvor vdev er i degradering. Når administratoren har udskiftet den defekte enhed i vdev, udføres genopretning af redundans på denne permanente enhed, og SPARE løsnes fra vdev og returneres til at være en reserve for hele poolen.
Datasæt, blokke og sektorer
Den næste gruppe byggesten, som vi skal forstå i vores rejse gennem ZFS, handler ikke så meget om hardware, men om, hvordan dataene selv er organiseret og gemt. Vi springer her flere niveauer over — såsom metaslab — for ikke at overbelaste detaljerne, men for at bevare forståelsen af den overordnede struktur.
Datasæt (dataset)
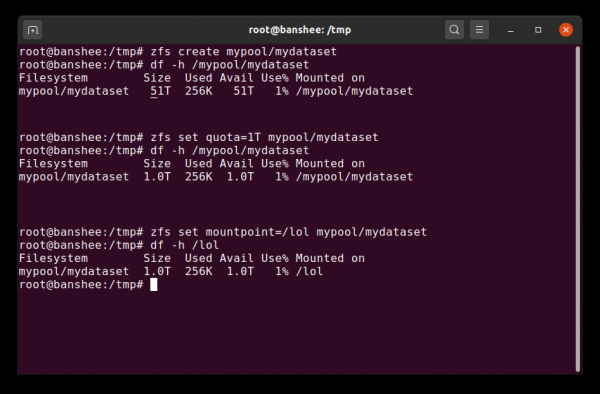
Når vi først opretter et datasæt, viser det al tilgængelig plads i poolen. Derefter indstiller vi en kvote — og ændrer monteringspunktet. Magi!
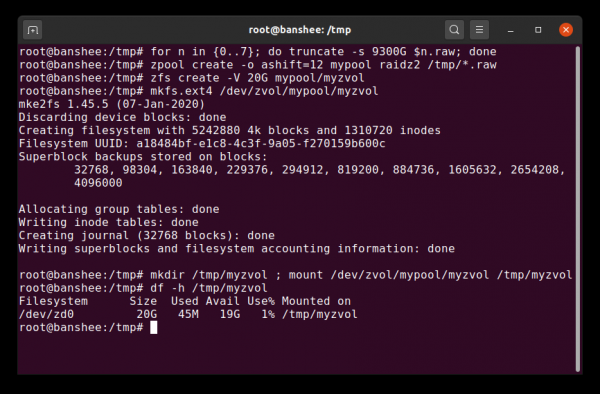
Zvol er i det store og hele blot et datasæt, der mangler sit lag af filsystem, som vi her erstatter med et helt normalt filsystem som ext4.
ZFS-datasettet er omtrent det samme som et standard montert filsystem. Som et vanlig filsystem, ser det ved første øyekast ut som "bare en annen mappe". Men akkurat som med vanlige monterte filsystemer, har hvert ZFS-datasett sitt eget sett med grunnleggende egenskaper.
Først og fremst kan et datasett ha en tildelt kvote. Hvis du setter zfs set quota=100G poolname/datasetname, vil du ikke være i stand til å skrive til den monterte mappen /poolname/datasetname mer enn 100 GiB.
La merke til tilstedeværelsen – og fraværet – av skråstreker i begynnelsen av hver linje? Hvert datasett har sin egen plass både i ZFS-hierarkiet og i det systemiske monteringshierarkiet. I ZFS-hierarkiet er det ingen ledende skråstrek – du starter med navnet på bassenget, og deretter veien fra ett datasett til et annet. For eksempel, pool/parent/child for et datasett med navnet child under det overordnede datasettet parent i bassenget med det kreative navnet pool.
Som standard vil monteringspunktet for datasettet være likt navnet i ZFS-hierarkiet, med en skråstrek i begynnelsen – bassenget med navnet pool blir montert som /pool, datasettet parent monteres i /pool/parent, og det underordnede datasettet child blir montert i /pool/parent/child. Imidlertid kan det systemiske monteringspunktet for datasettet endres.
Hvis vi angir zfs set mountpoint=/lol pool/parent/child, vil datasettet pool/parent/child bli montert i systemet som /lol.
I tillegg til datasettene, må vi nevne volumene (zvols). Et volum er omtrent det samme som et datasett, bortsett fra at det faktisk ikke har et filsystem – det er bare et blokkeringsenhet. Du kan for eksempel lage zvol med navnet mypool/myzvol, deretter formatere det med filsystemet ext4, og deretter montere dette filsystemet – nå har du et ext4-filsystem, men med støtte for alle ZFS-sikkerhetsfunksjonene! Dette kan virke meningsløst på én datamaskin, men gir mye mer mening som backend når du eksporterer iSCSI-enheter.
Units
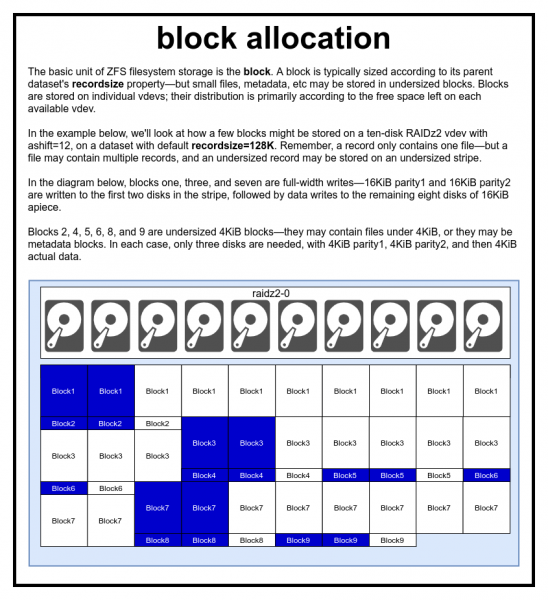
En fil er representert av en eller flere blokker. Hver blokk lagres på ett virtuelt enhet. Størrelsen på blokkene er vanligvis lik parameteren recordsize, men kan reduseres til 2^ashift, hvis det inneholder metadata eller en liten fil.
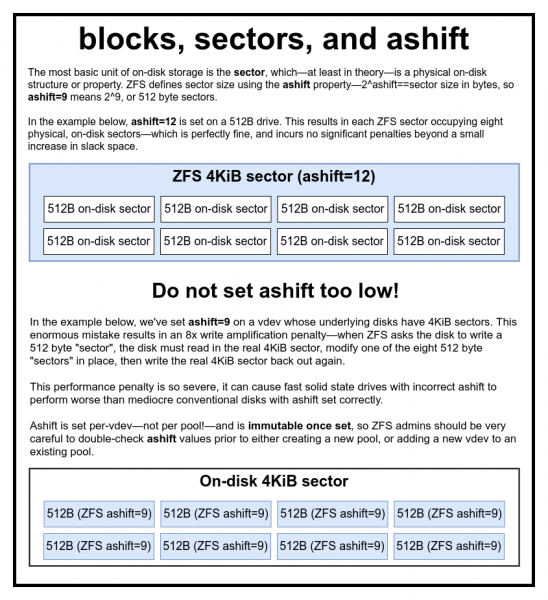
Vi mener virkelig, faktisk at vi ikke spøker med det enorme ytelsestapet hvis vi setter en for liten ashift.
I ZFS-pool gemmes alle data, inklusive metadata, i blokke. Den maksimale blokstørrelse for hver dataset defineres i egenskaben recordsize (optagelsesstørrelse). Optagelsesstørrelsen kan ændres, men dette vil ikke ændre størrelsen eller placeringen af eventuelle blokke, der allerede er skrevet til datasættet - det gælder kun for nye blokke, efterhånden som de skrives.
Medmindre andet er angivet, er den aktuelle standard optagelsesstørrelse 128 KiB. Dette er en slags kompliceret kompromis, hvor ydelsen vil være acceptabel, men ikke optimal i de fleste tilfælde. Optagelsesstørrelse kan indstilles til enhver værdi fra 4K til 1M (med yderligere indstillinger recordsize kan indstilles endnu større, men det er sjældent en god idé).
Enhver blok henviser kun til data fra én fil - du kan ikke presse to forskellige filer ind i én blok. Hver fil består af en eller flere blokke, afhængigt af størrelsen. Hvis filstørrelsen er mindre end optagelsesstørrelsen, vil den blive gemt i en mindre blok - for eksempel vil en blok med en fil på 2 KiB kun optage én 4 KiB sektor på disken.
Hvis filen er stor nok og kræver flere blokke, vil alle optagelser med denne fil have størrelsen recordsize — inklusive den sidste optagelse, hvis hovedpart kan være .
Zvol-mængder har ikke egenskaben recordsize — i stedet har de en tilsvarende egenskab volblocksize..
Sektorer
Den sidste, mest grundlæggende byggeklods er sektoren. Det er den mindste fysiske enhed, der kan skrives eller læses fra det underliggende device. I flere årtier har de fleste diske brugt sektorer på 512 byte. I de seneste år har de fleste diske været indstillet til 4 KiB-sektorer, og i nogle - især SSD'er - 8 KiB-sektorer eller endda større.
I ZFS-systemet er der en egenskab, der gør det muligt at indstille sektorstørrelsen manuelt. Denne egenskab ashift. Det er lidt forvirrende, at ashift er en potens af to. For eksempel, ashift=9 betyder sektorstørrelse 2^9 eller 512 byte.
ZFS anmoder operativsystemet om detaljerede oplysninger om hver blok enhed, når det tilføjes til en ny vdev, og teoretisk set indstiller det automatisk ashift korrekt baseret på disse oplysninger. Desværre lyver mange diske om deres sektorstørrelse for at bevare kompatibiliteten med Windows XP (som ikke kunne forstå diske med andre sektorstørrelser).
Dette betyder, at ZFS-administratorer stærkt anbefales at kende den faktiske sektorstørrelse af deres enheder og manuelt indstille ashift. Hvis en for lille ashift er indstillet, stiger antallet af læse-/skriveoperationer astronomisk. Således betyder skrivning af 512-bytes 'sektorer' til en faktisk sektor på 4 KiB, at det er nødvendigt først at skrive den 'sektor', så læse den 4 KiB sektor, ændre den med den anden 512-bytes 'sektor', skrive den tilbage til en ny 4 KiB sektor og så videre for hver skrivning.
I den virkelige verden rammer en sådan straf SSD'er fra Samsung EVO, for hvilke der skal være ashift=13, men disse SSD'er lyver om deres sektorstørrelse, og derfor er standardindstillingen ashift=9. Hvis en erfaren systemadministrator ikke ændrer denne parameter, fungerer denne SSD langsommere som en almindelig magnetisk HDD.
Til sammenligning er der næsten ingen straf for en for stor størrelse ashift . Der er ingen reel nedsættelse af ydeevnen, og stigningen i ubrugt plads er uendeligt lille (eller lig nul ved aktiveret kompression). Derfor anbefaler vi kraftigt, at selv de diske, der faktisk bruger 512-bytes sektorer, skal indstille ashift=12 eller endda ashift=13, for at se mod fremtiden med tillid.
Egenskab ashift indstilles for hver virtuel enhed vdev, og ikke for puljen, som mange fejlagtigt tror - og ændres ikke efter installation. Hvis du ved en fejltagelse har ændret ashift da du tilføjede en ny vdev til puljen, har du uopretteligt forurenet denne pulje med en enhed med lav ydeevne, og der er som regel ikke andet valg end at ødelægge puljen og starte forfra. Selv fjernelse af vdev redder ikke fra den forkert indstillede ashift!
Skrivningsmekanismen
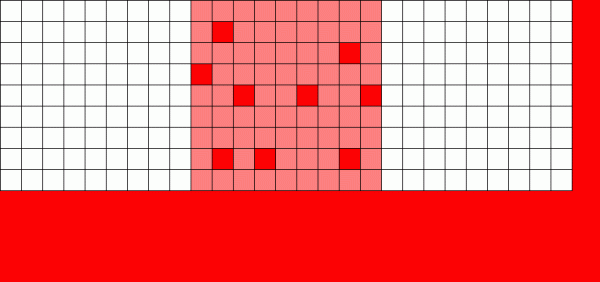
Hvis et almindeligt filsystem skal skrive data igen - ændrer det hver blok, hvor den står
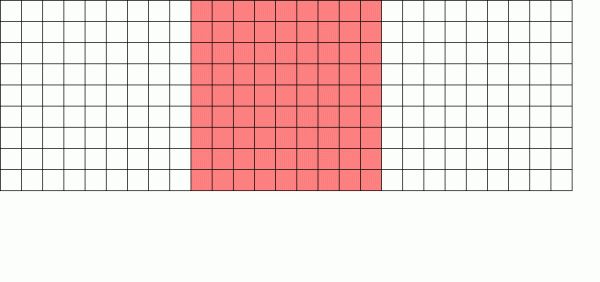
Filssystemet med skriv-kopiering skriver en ny version af blokken og ulåser derefter den gamle version.
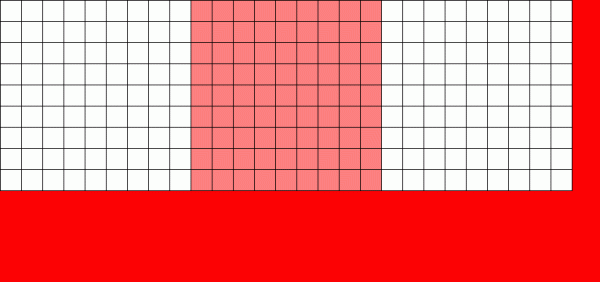
I abstrakt forstand, hvis man ser bort fra den faktiske fysiske placering af blokke, forenkles vores „datakometa“ til et „datorm“ som bevæger sig fra venstre mod højre på kortet af det tilgængelige rum.
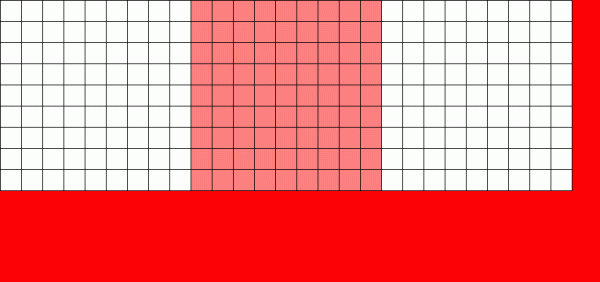
Nu kan vi få en god forståelse for, hvordan snapshot af skriv-kopiering fungerer — hver blok kan tilhøre flere snapshots og bevares, indtil alle tilknyttede snapshots fjernes.
Skriv-kopieringsmekanisme (Copy on Write, CoW) er den grundlæggende basis for, hvad der gør ZFS til et så fantastisk system. Hovedkonceptet er enkelt — hvis du beder et traditionelt filsystem om at ændre en fil, vil det gøre præcist det, du bad om. Hvis du beder et filsystem med skriv-kopiering om at gøre det samme, vil det sige „okay“ — men lyve for dig.
I stedet skriver filsystemet med skriv-kopiering en ny version af den ændrede blok og opdaterer derefter filmetadataene for at bryde forbindelsen til den gamle blok og binde den til den nye blok, som du lige har skrevet.
Frakoblingen af den gamle blok og bindingen af den nye udføres i en enkelt operation, så den ikke kan afbrydes — hvis du slukker strømmen, efter at det er sket, har du en ny filversion, og hvis du slukker strømmen før, har du den gamle version. I begge tilfælde vil der ikke opstå konflikter i filsystemet.
Skriv-kopiering i ZFS foregår ikke kun på filsystemniveau, men også på diskstyringsniveau. Det betyder, at ZFS ikke er modtagelig for skrivefejl () — et fænomen, hvor båndet kun er blevet delvist skrevet, før systemet fejler, hvilket resulterer i et beskadiget array efter genstart. Her skrives båndet atomisk, vdev er altid konsistent, og .
ZIL: ZFS intentionslog.
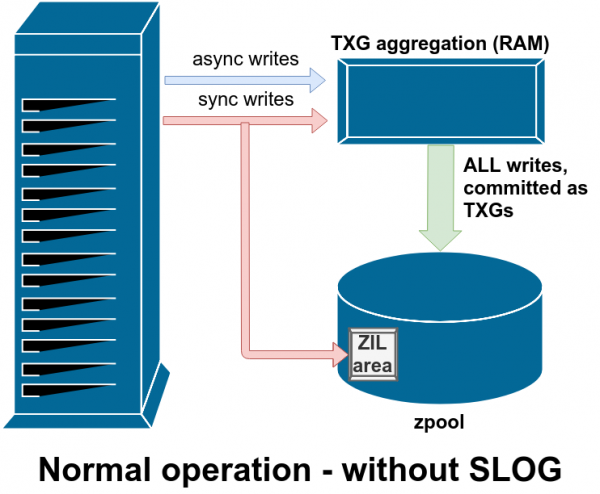
ZFS-systemet håndterer synkroniserede skrivninger på en særlig måde — det gemmer dem midlertidigt, men straks i ZIL, før de senere skrives permanent sammen med asynkrone skrivninger.
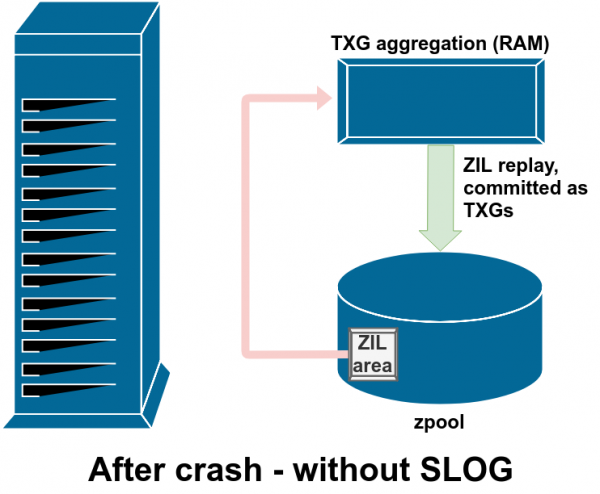
Normalt bliver data skrevet til ZIL aldrig læst igen. Men det er muligt efter et systemfejl.
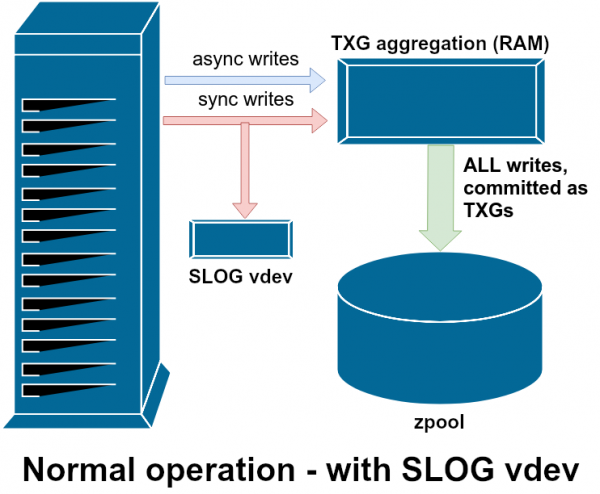
SLOG, eller det sekundære LOG-enhed, er blot et specielt - og helst meget hurtigt - vdev, hvor ZIL kan opbevares adskilt fra det primære lager.
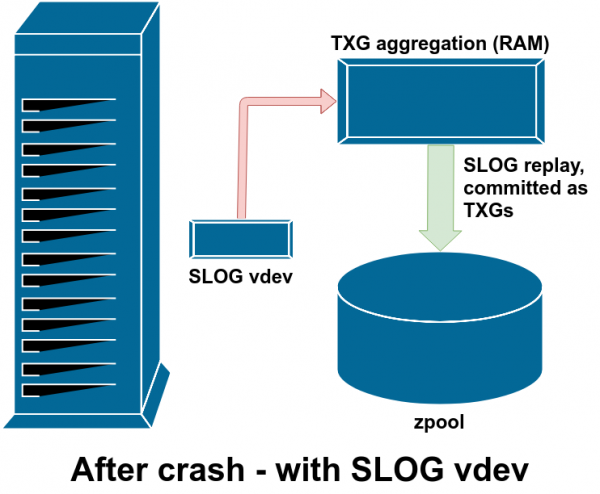
Efter et nedbrud genskabes alle de beskidte data i ZIL - i dette tilfælde er ZIL placeret på SLOG, så de genskabes netop derfra.
Der er to hovedkategorier af skriveoperationer - synkrone (sync) og asynkrone (async). For de fleste arbejdsbelastninger er langt størstedelen af skriveoperationerne asynkrone - filsystemet tillader at aggregere dem og udlevere i pakker, hvilket reducerer fragmentering og betydeligt øger båndbredden.
Synkrone skrivninger er noget helt andet. Når en applikation anmoder om en synkron skrivning, siger den til filsystemet: 'Du skal gemme dette i non-volatile hukommelse, lige nu, og indtil da kan jeg ikke gøre noget mere'. Derfor skal synkrone skrivninger straks bekræftes på disken - og hvis det øger fragmenteringen eller nedsætter båndbredden, så vær sådan.
ZFS håndterer synkrone skrivninger anderledes end almindelige filsystemer - i stedet for straks at indlæse dem i det almindelige lager, bevarer ZFS dem i et særligt opbevaringsområde kaldet ZFS Intent Log, eller ZIL. Hemmeligheden er, at disse poster også forbliver i hukommelsen, mens de er aggregeret sammen med almindelige asynkrone skriveanmodninger, for senere at blive udskrevet til lager som helt normale TXG (Transaction Groups).
I normal drift skrives ZIL, og den læses aldrig igen. Når skriveanmodninger fra ZIL efter et par øjeblikke bekræftes i det primære lager i almindelige TXG fra RAM, frakobles de fra ZIL. Det eneste tidspunkt, hvor noget læses fra ZIL, er ved import af puljen.
Hvis der opstår et ZFS-nedbrud - et systemfejl eller strømsvigt - når der er data i ZIL, vil disse data blive læst under næste import af puljen (f.eks. ved genstart af det katastrofeafhjælpende system). Alt, hvad der er i ZIL, vil blive læst, samlet i TXG-grupper, gemt i det primære lager og derefter frakoblet fra ZIL under importprocessen.
En af hjælpeklasserne vdev kaldes LOG eller SLOG, det sekundære LOG-enhed. Dens opgave er at give poolen en separat og, helst, meget hurtigere vdev-enhed med meget høj skrivebestandighed til opbevaring af ZIL, i stedet for at opbevare ZIL på det primære vdev-lager. ZIL opfører sig ens uanset opbevaringsstedet, men hvis vdev med LOG har en meget høj skriveydelse, vil synkrone skrivninger finde sted hurtigere.
Tilføjelse af vdev med LOG til poolen vil ikke kan ikke forbedre ydeevnen for asynkrone skrivninger – selv hvis du tvinger alle skrivninger til ZIL med zfs set sync=always, vil de stadig være bundet til det primære lager i TXG på samme måde og i samme tempo som uden log. Den eneste direkte forbedring i ydeevnen er forsinkelsen af synkrone skrivninger (da højere loghastighed accelererer udførelsen af operationer synk).
Men i et miljø, der allerede kræver mange synkrone skrivninger, kan vdev LOG indirekte accelerere asynkrone skrivninger og ikke-cachede læsninger. Afsendelse af ZIL-skrivninger til en separat vdev LOG betyder mindre konkurrence om IOPS i det primære lager, hvilket forbedrer ydeevnen for alle læse- og skriveoperationer i nogen grad.
Snapshots
Skrive-ved-kopi mekanismen er også en nødvendig grundpille for atomare snapshots af ZFS og inkrementel asynkron replikering. I et aktivt filsystem findes der et træ af pegepinde, der markerer alle poster med nuværende data – når du tager et snapshot, laver du blot en kopi af dette træ af pegepinde.
Når en post i det aktive filsystem overskrives, skriver ZFS først den nye version af blokken til ikke-brugt plads. Derefter adskiller den den gamle version af blokken fra det nuværende filsystem. Men hvis et snapshot refererer til den gamle blok, forbliver den stadig uændret. Den gamle blok vil faktisk ikke blive genoprettet som ledig plads, indtil alle snapshots, der refererer til denne blok, er slettet!
Replikering
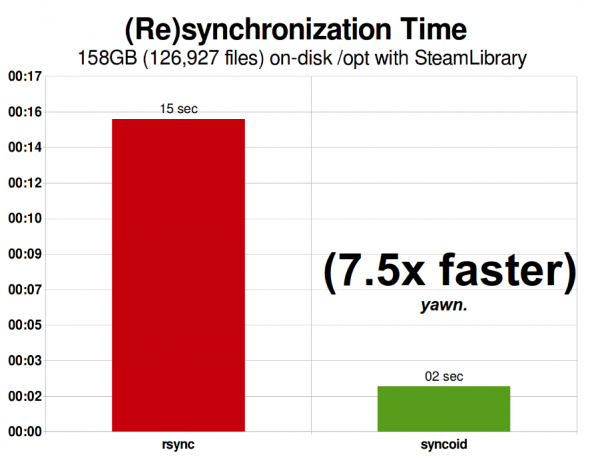
Mit Steam-bibliotek i 2015 fyldte 158 GiB og indeholdt 126.927 filer. Det er ret tæt på den optimale situation for rsync – ZFS-replikering over nettet var "kun" 750% hurtigere.
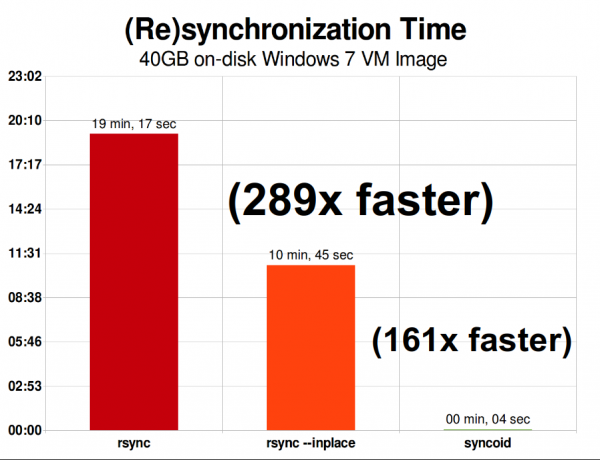
I samme netværk er replikeringen af en 40-gigabyte Windows 7 virtuel maskine billede en helt anden historie. ZFS-replikering sker 289 gange hurtigere end rsync – eller "kun" 161 gange hurtigere, hvis du er tilpas kyndig til at kalde rsync med flaget –inplace.
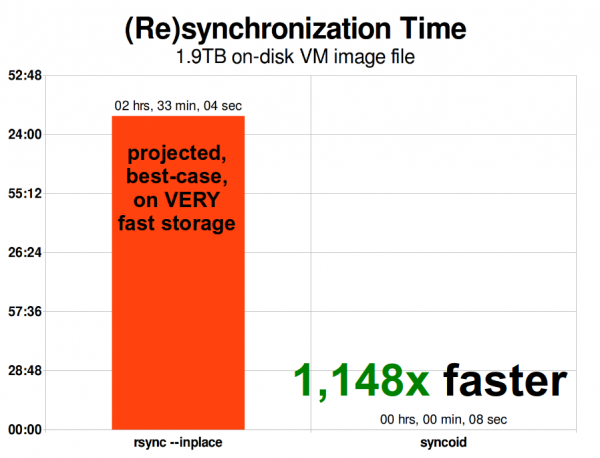
Når billedet af den virtuelle maskine skaleres, skaleres rsync-problemerne med det. Størrelsen 1,9 TiB er ikke så stor for et moderne billed af en virtuel maskine – men den er stor nok til, at ZFS-replikering er 1148 gange hurtigere end rsync, selv med rsync-argumentet –inplace.
Når du først forstår, hvordan snapshots fungerer, er det ikke svært at fange essensen af replikation. Da et snapshot blot er et træ af pegepinde på poster, følger det, at hvis vi laver zfs send et snapshot, så sender vi både dette træ og alle tilknyttede poster. Når vi overfører dette zfs send i zfs receive til det målobjekt, skriver det både det faktiske indhold af blokken samt træet af pegepinde, der refererer til blokkene, i det målretter datasæt.
Det bliver endnu mere interessant i det andet zfs send. Nu har vi to systemer, hver med poolname/datasetname@1, og du tager et nyt snapshot poolname/datasetname@2. Så i den oprindelige pulje har du datasetname@1 og datasetname@2, mens den målrettede pulje indtil videre kun har det første snapshot. datasetname@1.
Da vi har et fælles snapshot mellem kilde og mål datasetname@1, kan vi lave en inkrementel zfs send over det. Når vi siger til systemet zfs send -i poolname/datasetname@1 poolname/datasetname@2, sammenligner det de to træer af pegepinde. Enhver pegepind, der kun eksisterer i @2, refererer klart til nye blokke – derfor har vi brug for indholdet af disse blokke.
I det fjerntliggende system er behandlingen af den inkrementelle send lige så enkel. Først skriver vi alle nye poster inkluderet i strømmen send, og derefter tilføjer vi pegepindene til disse blokke. Voila, vi har @2 i det nye system!
Asynkron inkrementel replikation af ZFS er et kæmpe forbedring i forhold til tidligere metoder, der ikke er baseret på snapshots, såsom rsync. I begge tilfælde overføres kun de ændrede data – men rsync skal først læse læse alle data fra begge sider for at kontrollere summen og sammenligne den. I modsætning hertil læser ZFS-replikation ikke noget bortset fra træerne af pegepinde – og eventuelle blokke, der ikke er repræsenteret i det fælles snapshot.
Indbygget kompression
Kopieringsmekanismen ved skrivning forenkler også systemet med indbygget kompression. I traditionelle filsystemer er kompression problematisk — både den gamle og den nye version af ændrede data befinder sig i det samme rum.
Hvis vi ser på et datastykke midt i en fil, der begynder sit liv som en megabyte af nuller fra 0x00000000 og fremad — så er det meget nemt at komprimere det til en enkelt sektor på disken. Men hvad sker der, hvis vi erstatter denne megabyte af nuller med en megabyte af ikke-komprimerbare data, såsom JPEG eller pseudorandom støj? Pludselig vil denne megabyte data kræve ikke én, men 256 sektorer på 4 KiB, mens der kun er reserveret én sektor på dette sted på disken.
ZFS har ikke dette problem, da ændrede poster altid skrives til ubrugt plads — den oprindelige blok optager kun én sektor på 4 KiB, og den nye post vil optage 256, men det er ikke et problem — det nyligt ændrede stykke fra "midten" af filen ville blive skrevet i ubrugt plads uanset om dens størrelse ændrede sig eller ej, så for ZFS er det en ganske almindelig situation.
Indbygget kompression i ZFS er deaktiveret som standard, og systemet tilbyder tilsluttede algoritmer — lige nu inkluderer de LZ4, gzip (1-9), LZJB og ZLE.
- LZ4 — det er en stream-algoritme, der tilbyder ekstremt hurtig kompression og dekompression og præstationsgevinster for de fleste brugsscenarier — selv på ret langsomme CPU'er.
- GZIP — en anerkendt algoritme, som alle brugere af Unix-systemer kender og elsker. Den kan implementeres med kompressionsniveauer fra 1-9, hvor kompressionen og CPU-forbruget stiger, jo tættere man kommer på niveau 9. Algoritmen fungerer godt for alle tekstbaserede (eller andre ekstremt komprimerbare) anvendelser, men ellers kan den ofte forårsage CPU-problemer — brug den med forsigtighed, især på højere niveauer.
- LZJB — den oprindelige algoritme i ZFS. Den er forældet og bør ikke længere bruges, LZ4 overgår den på alle punkter.
- ZLE — nullniveau kodning, Zero Level Encoding. Den berører slet ikke normale data, men komprimerer store sekvenser af nuller. Dette er nyttigt til helt ukomprimerbare datasæt (f.eks. JPEG, MP4 eller andre allerede komprimerede formater), da det ignorerer ukomprimerbare data, men komprimerer det ubenyttede rum i de endelige poster.
Vi anbefaler LZ4-komprimering til næsten alle anvendelsessituationer; præstationsstraffen ved mødet med ukomprimerbare data er meget lille, og vækst præstationen for typiske data er betydelig. Kopiering af et virtuelt maskinebillede til en ny installation af Windows-operativsystemet (nyinstalleret OS, ingen data indeni endnu) med compression=lz4 foregik 27% hurtigere end med compression=none, i .
ARC — adaptiv erstatningsbuffer
ZFS — er det eneste moderne filsystem, vi kender, der bruger sin egen læsebuffer mekanisme, og ikke er afhængig af kernels sidecache til at opbevare kopier af nyligt læste blokke i RAM.
Selvom den egen cache ikke er uden sine problemer — ZFS kan ikke reagere på nye anmodninger om hukommelsesallokering lige så hurtigt som kernen, derfor kan en ny anmodning malloc() om hukommelsesallokering mislykkes, hvis den kræver RAM, der aktuelt er optaget af ARC. Men der er gode grunde til at bruge den egen cache, i det mindste nu.
Alle kendte moderne operativsystemer, herunder MacOS, Windows, Linux og BSD, bruger LRU (Least Recently Used) algoritmen til at implementere sidecache. Dette er en simpel algoritme, der flytter den cachede blok 'op i køen' efter hver læsning og udskifter blokke 'nederst i køen' efter behov for at tilføje nye cachemiss (blokke, der skulle have været læst fra disken og ikke fra cachen) op.
Algoritmen fungerer normalt godt, men i systemer med store arbejdsdatasæt fører LRU let til thrashing — udskiftning af ofte nødvendige blokke for at frigøre plads til blokke, der aldrig vil blive læst igen fra cachen.
— en langt mindre naiv algoritme, der kan betragtes som en "vægtet" cache. Efter hver aflæsning af en cachet blok, bliver den lidt "tungere" og sværere at fjerne — og selv efter fjernelse bliver blokken sporbar i en bestemt periode. En blok, der er blevet fjernet, men som derefter skal læses tilbage i cachen, vil også blive "tungere".
Det endelige resultat af dette er en cache med en langt højere hit ratio — forholdet mellem hits i cachen (læsninger udført fra cachen) og misses (læsninger fra disken). Dette er en ekstremt vigtig statistik — ikke blot behandles cache-hits hurtigere, men også cache-misses kan behandles hurtigere, da jo flere cache-hits, desto færre parallelle anmodninger til disken og dermed mindre forsinkelse for de resterende misses, som skal behandles fra disken.
Konklusion
Efter at have studeret den grundlæggende semantik af ZFS — hvordan kopiering ved skrivning fungerer, samt forholdet mellem lagringspuljer, virtuelle enheder, blokke, sektorer og filer — er vi klar til at diskutere den faktiske ydeevne med reelle tal.
I den næste del vil vi se på den faktiske ydeevne af puljer med spejl-vdev og RAIDz, sammenlignet med hinanden, samt sammenlignet med de traditionelle RAID-topologier i Linux-kernen, som vi har undersøgt. .
Først ville vi kun se på det grundlæggende — selve ZFS-topologierne — men efter sådan er vi klar til at tale om mere avanceret konfiguration og tuning af ZFS, inklusive brugen af hjælpetyper af vdev, såsom L2ARC, SLOG og Special Allocation.
Kilde: habr.com
