

I Linux er der et væld af værktøjer til debugging af kerneler og applikationer. De fleste af dem påvirker applikationernes ydeevne negativt og kan ikke anvendes i produktion.
For et par år siden blev der — eBPF. Det giver mulighed for at spore kernen og brugerapplikationer med lav overhead og uden behov for at ombygge programmer og indlæse tredjepartsmoduler i kernen.
I dag findes der allerede mange anvendelsestjenester, der bruger eBPF, og i denne artikel vil vi se på, hvordan man skriver sin egen profileringsapplikation baseret på biblioteket . Artiklen er baseret på virkelige begivenheder. Vi vil gå fra opståen af problemet til dets løsning for at vise, hvordan allerede eksisterende værktøjer kan bruges i specifikke situationer.
Ceph Er Langsom
En ny vært blev tilføjet til Ceph-klyngen. Efter migrationen af dele af dataene til den, bemærkede vi, at skriveforespørgslernes behandlingshastighed var meget lavere end på andre servere.
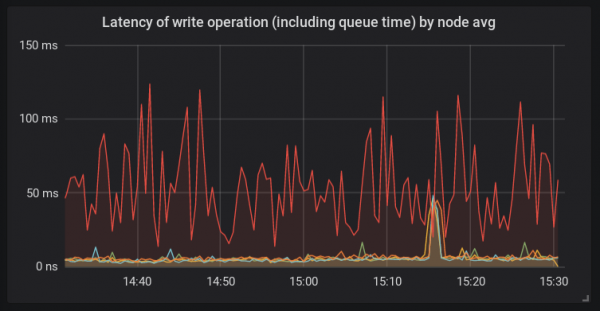
I modsætning til andre platforme brugte denne vært bcache og den nye linux 4.15 kerne. En vært med sådan en konfiguration blev brugt her for første gang. Og dengang var det klart, at roden af problemet teoretisk kunne være alt muligt.
Undersøgelse af Værten
Lad os starte med at se på, hvad der sker inde i processus ceph-osd. Til dette vil vi bruge og (mere om hvilke kan læses ):
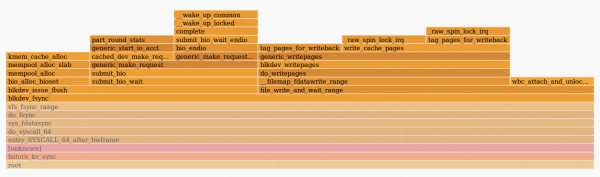
Billedet viser os, at funktionen fdatasync() brugte meget tid ved at sende forespørgslen i funktionen generic_make_request(). Det betyder, at årsagen til problemerne sandsynligvis ligger et sted uden for selve osd-dæmonen. Det kan være enten kernen eller diskene. iostat-output viste høj ventetid for behandling af forespørgsler fra bcache-diskene.
Ved tjek af værten opdagede vi, at dæmonen systemd-udevd bruger meget CPU-tid — omkring 20% på flere kerner. Denne mærkelige adfærd kræver, at vi finder årsagen. Da Systemd-udevd arbejder med uevent'er, besluttede vi at se på dem gennem udevadm monitor. Det viste sig, at der blev genereret et stort antal change-begivenheder for hver blokenhed i systemet. Dette er ret usædvanligt, så vi skal finde ud af, hvad der genererer alle disse begivenheder.
Brug af BCC Toolkit
Som vi allerede har fastslået, bruger kernen (og ceph-dæmonen i systemopkaldet) meget tid i generic_make_request(). Lad os måle hastigheden af denne funktion. I er der allerede et fremragende værktøj — funclatency. Vi vil spore daemonen efter dens PID med et interval mellem informationsudgivelser på 1 sekund og vise resultatet i millisekunder.
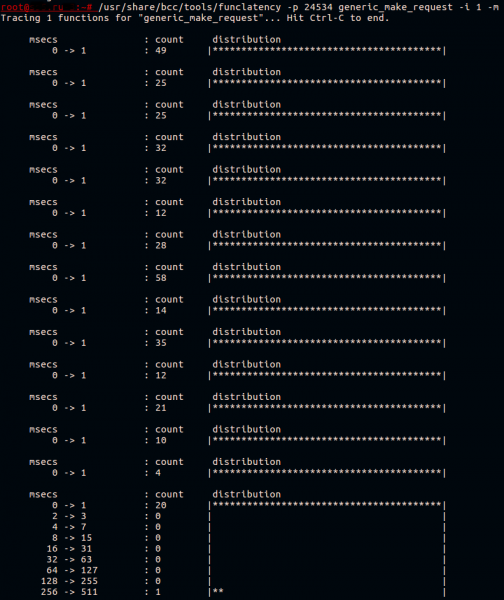
Normalt arbejder denne funktion hurtigt. Alt, hvad den gør, er at sende anmodningen til en enqueued driver.
Bcache er en kompleks enhed, der faktisk består af tre diske:
- backing device (cache-disk), i dette tilfælde en langsom HDD;
- caching device (cache-disk), her er det én partition af NVMe-enheden;
- et virtuelt bcache-device, som applikationen arbejder med.
Vi ved, at anmodningsoverførslen hænger, men for hvilken af disse enheder? Lad os finde ud af det lidt senere.
Lige nu ved vi, at uevent’erne sandsynligvis forårsager problemer. At finde ud af, hvad der præcist genererer dem, er ikke så let. Lad os antage, at det er en eller anden software, der kører periodisk. Lad os se, hvilken software der kører i systemet ved hjælp af scriptet execsnoop fra det samme . Lad os køre det og dirigere output til en fil.
For eksempel sådan her:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Vi vil ikke vise den fulde output af execsnoop her, men én interessant linje så sådan ud:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Den tredje kolonne er PPID (parent PID) for processen. Processen med PID 5802 viste sig at være en af trådene i vores overvågningssystem. Ved kontrol af konfigurationen af overvågningssystemet blev fejlagtige parametre fundet. Temperaturen af HBA-adapteren blev registreret hvert 30. sekund, hvilket var meget oftere, end nødvendigt. Efter ændring af kontrolintervallet til en længere periode, fandt vi ud af, at forsinkelsen i behandlingen af anmodninger på denne vært ikke længere skillede sig ud blandt de andre værter.
Men det er stadig ikke klart, hvorfor bcache-enheden var så langsom. Vi har forberedt en testplatform med identisk konfiguration og forsøgte at reproducere problemet ved at køre fio på bcache og periodisk køre udevadm trigger for at generere uevents.
Writing BCC-Based Tools
Lad os prøve at skrive et enkelt værktøj til at spore og vise de langsomste kald generic_make_request(). Vi er også interesseret i navnet på disken, som denne funktion blev kaldt for.
Planen er enkel:
- Registrerer kprobe og få en fungerende kommando. generic_make_request():
- Vi gemmer navnet på disken i hukommelsen, som er tilgængeligt via funktionens argument;
- Vi gemmer tidsstemplet.
- Registrerer kretprobe ved retur fra generic_make_request():
- Henter den nuværende tidsstempel;
- Søger efter den gemte tidsstempel og sammenligner den med den nuværende;
- Hvis resultatet er større end det angivne, finder vi det gemte drevnavn og viser det på terminalen.
Kprobes og kretprobes bruger breakpoint-mekanismen til dynamisk at ændre funktionskode. Du kan læse og artikel om emnet. Hvis du ser på koden i forskellige værktøjer, , kan du bemærke, at de har en identisk struktur. Så vi vil i denne artikel springe parsing af script-argumenter over og gå direkte til selve BPF-programmet.
eBPF-koden i python-scriptet ser således ud:
bpf_text = ''""" # Her vil være bpf programkode """
Til datadeling mellem funktioner bruger eBPF-programmer . Det gør vi også. Som nøgle vil vi bruge proces-PID, og som værdi definerer vi strukturen:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Her registrerer vi en hash-tabel, der kaldes p, med nøgletypen u64 og værditypen struct data_t. Tabellen vil være tilgængelig i konteksten af vores BPF-program. Makroen BPF_PERF_OUTPUT registrerer en anden tabel kaldet events, som bruges til til brugerrummet.
Når du måler forsinkelsen mellem et funktionskald og dets returnering, eller mellem kald af forskellige funktioner, skal du huske, at de opnåede data skal tilhøre en enkelt kontekst. Med andre ord, husk på, at der kan være samtidig udførelse af funktioner. Vi har mulighed for at måle forsinkelsen mellem et funktionskald i konteksten af én proces og tilbagevenden fra den funktion i konteksten af en anden proces, men det vil sandsynligvis være ubrugeligt. Et godt eksempel her kan være , hvor hash-tabelens nøgle er en pointer til struct request, som afspejler en enkelt forespørgsel til disken.
Dernæst skal vi skrive kode, der vil blive udført, når den undersøgte funktion kaldes:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Her vil den første parameter, der kaldes til funktionen, blive brugt som den anden parameter. . Efter dette får vi PID-processen, i konteksten hvor vi arbejder, og den aktuelle tidsstempel i nanosekunder. Vi indskriver dette hele i den nyfordelte struct data_t data. Navnet på disken får vi fra strukturen bio, som overføres ved kaldet generic_make_request(), og gemmer det i den samme struktur data. Som det sidste skridt tilføjer vi en post i hash-tabellen, som nævnt tidligere.
Den næste funktion vil blive kaldt ved tilbagevenden fra generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Denne funktion ligner den forrige: vi finder PID-processen og tidsstemplet, men allokerer ikke hukommelse til en ny data-struktur. I stedet leder vi efter den eksisterende struktur i hash-tabellen ved nøglen == den aktuelle PID. Hvis strukturen findes, får vi navnet på den kørende proces og tilføjer det til den.
Den binære skift, vi bruger her, er nødvendigt for at få tråd GID. dvs. PID for den hovedproces, der startede tråden, i konteksten hvor vi arbejder. Den kalde funktion returnerer både tråd GID og dens PID i en enkelt 64-bits værdi.
Når vi viser i terminalen, er vi nu ikke interesseret i tråden, men i hovedprocessen. Efter sammenligning af den opnåede latens med den angivne grænse, overfører vi vores struktur data til brugerrummet via tabellen events, hvorefter vi sletter posten fra p.
I Python-scriptet, der vil indlæse denne kode, skal vi udskifte MIN_US og FACTOR med grænseværdier for latens og tidsenheder, som vi vil videregive gennem argumenter:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Nu skal vi forberede BPF-programmet gennem og registrere prøver:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Vi skal også definere struct data_t i vores script, ellers vil vi ikke kunne læse noget:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Det sidste skridt er at udskrive data til terminalen:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# format output
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Selve scriptet er tilgængeligt på . Lad os prøve at køre det på en testplatform, hvor fio kører og skriver til bcache, og kalde udevadm monitor:
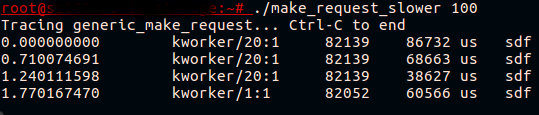
Endelig! Nu ser vi, at det, der så ud som et langsom bcache-enhed, faktisk er et langsom kald generic_make_request() for den cachede disk.
Dyk ned i kernen
Hvad præcist forsinker under forespørgselsoverførslen? Vi ser, at forsinkelsen opstår selv før start af anmodningsregnskab, dvs. registreringen af den specifikke anmodning for yderligere statistisk output ( /proc/diskstats eller iostat) er endnu ikke begyndt. Dette kan let bekræftes ved at køre iostat under reproduktionen af problemet, eller , som er baseret på begyndelsen og slutningen af anmodningsregnskabet. Ingen af disse værktøjer vil vise problemer for anmodninger til den cachede disk.
Hvis vi ser på funktionen generic_make_request(), vil vi se, at før begynnelsen af anmodningsregnskabet kaldes der stadig to funktioner. Den første er generic_make_request_checks(), som udfører legitimitetskontroller af anmodningen med hensyn til diskens indstillinger. Den anden er , hvor der er et interessant kald :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
Her venter kernen på, at køen bliver optøet. Lad os måle forsinkelsen blk_queue_enter():
~# /usr/share/bcc/tools/funclatency blk_queue_enter -i 1 -m
Tracing 1 functions for "blk_queue_enter"... Hit Ctrl-C to end.

 	msecs           	: count 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: count 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Det ser ud til, at vi er tæt på at finde svaret. Funktionerne, der bruges til "frysning/optøning" af køen, er og . De bruges, når det er nødvendigt at ændre indstillingerne for anmodningskøen, hvilket potentielt kan være farligt for anmodningerne i denne kø. Når kaldet sker blk_mq_freeze_queue() af funktionen inkrementeres tælleren q->mq_freeze_depth. Efter dette venter kernen på, at køen tømmes i .
Ventetiden for at tømme denne kø svarer til diskens forsinkelse, da kernen venter på, at alle de anmodninger, der er sat i kø, afsluttes. Så snart køen er tom, anvendes ændringerne i indstillingerne. Derefter kaldes , der dekrementerer tælleren freeze_depth.
Nu ved vi nok til at løse problemet. Kommandoen udevadm trigger resulterer i, at indstillingerne anvendes til blokenheden. Disse indstillinger er beskrevet i udev-reglerne. Vi kan finde ud af, hvilke indstillinger der "fryser" køen ved at forsøge at ændre dem gennem sysfs eller ved at se på kildeteksten i kernen. Vi kan også prøve værktøjet BCC , som viser staksporene for kernen og brugerområdet for hver opkald af blk_freeze_queue, for eksempel:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Udev-regler ændrer sig sjældent og sker normalt under kontrol. Så vi ser, at selv anvendelsen af allerede angivne værdier forårsager et spike i ventetid for anmodningen fra applikationen til disken. Selvfølgelig er det ikke god praksis at generere udev-begivenheder, når der ikke er nogen ændringer i diskens konfiguration (f.eks. når en enhed ikke tilsluttes/frakobles). Alligevel kan vi hjælpe kernen med ikke at udføre unødvendigt arbejde og ikke "fryse" anmodningskøen, hvis det ikke er nødvendigt. løser problemet.
Konklusion
eBPF er et meget fleksibelt og kraftfuldt værktøj. I artiklen har vi undersøgt et praktisk tilfælde og demonstreret en lille del af, hvad der er muligt at gøre. Hvis du er interesseret i udviklingen af BCC-værktøjer, er det værd at se på , som godt beskriver grundlæggende funktioner.
Der er også andre interessante værktøjer til fejlfinding og profilering baseret på eBPF. Et af dem er , som giver mulighed for at skrive kraftfulde en-linjers scripts og små programmer på et awk-lignende sprog. Et andet er , der gør det muligt at indsamle lavniveau-højopløsningsmetriker direkte til din prometheus-server, med mulighed for at få smuk visualisering og endda alarmer senere hen.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish