

I artiklen vil jeg fortælle, hvordan vi har grebet spørgsmålet om PostgreSQLs fejlfindingskapacitet an, hvorfor det blev vigtigt for os, og hvad vi endte med.
Vi har en højbelastet tjeneste: 2,5 millioner brugere verden over, 50K+ aktive brugere hver dag. Serverne er placeret i Amazon i én region i Irland: i drift har vi konstant 100+ forskellige servere, hvoraf næsten 50 har databaser.
Hele backend er en stor monolitisk stateful-applikation på Java, som opretholder en konstant websocket-forbindelse til klienten. Når flere brugere arbejder samtidig på én tavle, ser de alle ændringer i realtid, fordi hver ændring gemmes i databasen. Vi har cirka 10K forespørgsler pr. sekund til vores databaser. Ved maksimal belastning skriver vi 80-100K forespørgsler pr. sekund i Redis.
Hvorfor vi gik fra Redis til PostgreSQL
Oprindeligt fungerede vores tjeneste med Redis, et key-value lager, der gemmer alle data i RAM. server.
Fordele ved Redis:
- Høj svartid, da alt er gemt i hukommelsen;
- Nemmere backup og replikering.
Ulemper ved Redis for os:
- Ingen ægte transaktioner. Vi prøvede at efterligne dem på applikationsniveau. Desværre fungerede det ikke altid godt og krævede meget kompleks kode.
- Datamængden er begrænset af mængden af hukommelse. Når datamængden stiger, vil hukommelsen vokse, og til sidst vil vi støde på begrænsningerne for den valgte instans, hvilket i AWS kræver, at vi stopper vores tjeneste for at ændre instanstypen.
- Det er nødvendigt konstant at opretholde et lavt latencyniveau, da vi har et meget stort antal forespørgsler. Det optimale latencyniveau for os er 17-20 ms. Ved et niveau på 30-40 ms får vi lange svartider på vores applikationsforespørgsler og degradering af tjenesten. Desværre oplevede vi dette i september 2018, da en af instanserne med Redis pludselig fik et latency på det dobbelte af normalt. For at løse problemet stoppede vi tjenesten midt på arbejdsdagen for planlagt vedligeholdelse og udskiftede den problematiske Redis-instans.
- Det er let at få inkonsistens i data, selv ved små fejl i koden, og derefter bruge meget tid på at skrive kode for at rette disse data.
Vi har taget hensyn til ulemperne og indset, at vi har brug for at flytte til noget mere praktisk, med normale transaktioner og mindre afhængighed af latency. Vi gennemførte en undersøgelse, analyserede mange muligheder og valgte PostgreSQL.
Vi er allerede i gang med at flytte til den nye database i 1,5 år og har kun overført en lille del af dataene, så vi arbejder nu samtidig med Redis og PostgreSQL. Læs mere om faserne i flytningen og dataoverførslen mellem databaser i artiklen fra min kollega.
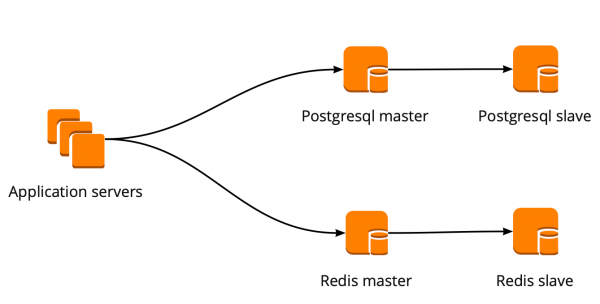
Da vi lige begyndte at flytte, arbejdede vores applikation direkte med databasen og henvendte sig til masteren af Redis og PostgreSQL. PostgreSQL-klyngen bestod af en master og en replika med asynkron replikering. Sådan så arbejdet med databaserne ud:
Implementering af PgBouncer
Mens vi flyttede, udviklede produktet sig også: antallet af brugere og antallet af servere, der arbejdede med PostgreSQL, voksede, og vi fik ikke nok forbindelser. PostgreSQL opretter en separat proces for hver forbindelse og bruger ressourcer. Antallet af forbindelser kan øges op til et vist punkt, ellers er der en chance for, at databasen arbejder suboptimalt. Den ideelle løsning i en sådan situation ville være at vælge en forbindelsesmanager, som placeres foran databasen.
Vi havde to muligheder for forbindelsesmanageren: Pgpool og PgBouncer. Men den første understøtter ikke transaktionsdrift med databasen, så vi valgte PgBouncer.
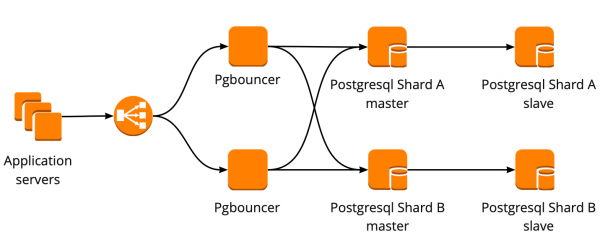
Vi har indstillet følgende arbejdsmetode: vores applikation henvender sig til en PgBouncer, der står bag masterne af PostgreSQL, og bag hver master er der en replika med asynkron replikering.
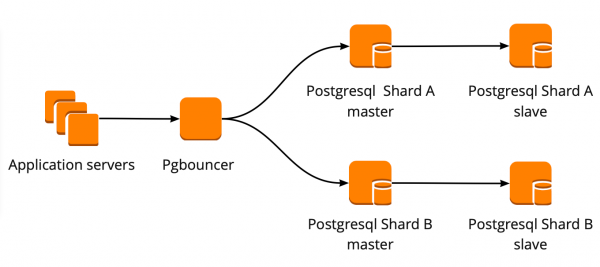
På samme tid kunne vi ikke opbevare hele datamængden i PostgreSQL, og hastigheden i arbejdet med databasen var vigtig for os, så vi begyndte at shardere PostgreSQL på applikationsniveau. Den ovenfor beskrevne skema er relativt praktisk til dette: ved tilføjelse af et nyt shard er det tilstrækkeligt at opdatere PgBouncer-konfigurationen, og applikationen kan straks arbejde med det nye shard.
Fejltolerance for PgBouncer
Denne ordning fungerede indtil den eneste PgBouncer-instans gik ned. Vi er i AWS, hvor alle instanser kører på hardware, der periodisk fejler. I sådanne tilfælde flytter instansen blot til ny hardware og fungerer igen. Det skete også med PgBouncer, men den blev utilgængelig. Resultatet af dette nedbrud var, at vores service var utilgængelig i 25 minutter. AWS anbefaler brugerredundans for sådanne situationer, hvilket ikke var implementeret hos os på det tidspunkt.
Efter dette begyndte vi seriøst at overveje PgBouncers og PostgreSQL-klusters fejltolerance, da en lignende situation kunne opstå med enhver instans i vores AWS-konto.
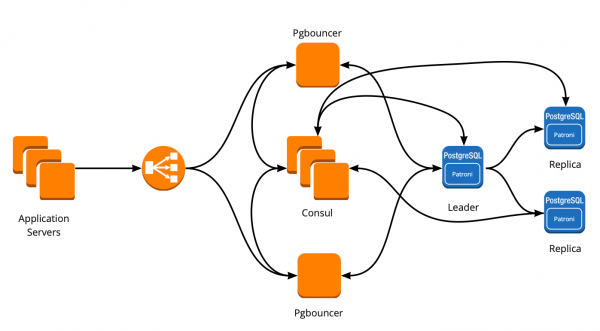
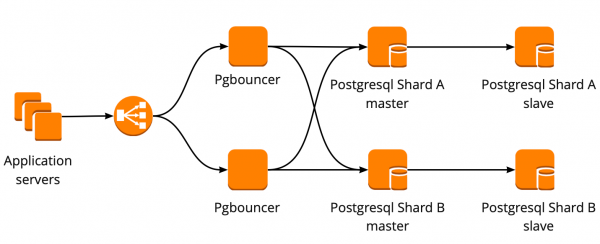
Vi opbyggede PgBouncers fejltolerance-ordning på følgende måde: alle applikationens servere henvender sig til Network Load Balancer, bag hvilken der står to PgBouncer. Hver PgBouncer ser på de samme master PostgreSQL for hver shard. I tilfælde af at der opstår en situation med nedbrud af instansen i AWS, omdirigeres al trafik gennem en anden PgBouncer. Network Load Balancer's fejltolerance sikres af AWS.
Denne ordning gør det problemfrit at tilføje nye PgBouncer-servere.
Oprettelse af et fejltolerant PostgreSQL-kluster
I løsningen af denne opgave overvejede vi forskellige muligheder: egenudviklet failover, repmgr, AWS RDS, Patroni.
Hjemmelavede scripts
De kan overvåge maestroens arbejde, og i tilfælde af dens nedbrud, promovere en replica til maestro og opdatere konfigurationen af PgBouncer.
Fordelen ved denne tilgang er maksimal enkelhed, fordi du selv skriver scripts og præcist forstår, hvordan de fungerer.
Ulemper:
- Maestroen kunne være blevet værende aktiv, i stedet kunne der være opstået et netværksproblem. Failover, uden at vide det, ville promovere replicaen til maestro, mens den gamle maestro fortsætter med at fungere. Som et resultat ville vi have to servere i rollen som maestro og ikke vide, hvilken af dem der har de seneste opdaterede data. Denne situation kaldes også split-brain;
- Vi blev uden en replica. I vores konfiguration er der en maestro og én replica. Efter skiftet promoveres replicaen til maestro, og vi har ikke flere replicas, så vi må manuelt tilføje en ny replica.
- Der er behov for yderligere overvågning af failover-arbejdet, da vi har 12 PostgreSQL-shards, hvilket betyder, at vi skal overvåge 12 klustre. Ved en stigning i antallet af shards skal vi huske at opdatere failover også.
At skabe en failover-løsning fra bunden virker meget komplekst og kræver ikke-triviel support. Med én PostgreSQL-klynge vil dette være den simpleste løsning, men den kan ikke skaleres, så den passer ikke til os.
Repmgr
Replication Manager til PostgreSQL-klynger, som kan styre driften af en PostgreSQL-klynge. Der er dog ikke en automatisk failover “out of the box”, så der kræves en egen “wrapper” oven på den eksisterende løsning. Det kan altså vise sig at være endnu mere kompliceret end med skræddersyede scripts, derfor valgte vi endda ikke at afprøve Repmgr.
AWS RDS
Den understøtter alt det nødvendige for os, kan lave backups og understøtter en connection pool. Den har automatisk switch: når masteren dør, bliver replikaen den nye master, og AWS opdaterer DNS-posten til den nye master, mens replikaerne kan være placeret i forskellige AZ.
En ulempe er manglen på fine indstillinger. Et eksempel på fine indstillinger: på vores instanser er der begrænsninger for TCP-forbindelser, noget der desværre ikke kan gøres i RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Desuden er prisen på AWS RDS næsten dobbelt så høj som den normale pris for instanser, hvilket var hovedårsagen til at vi valgte ikke at tage denne løsning.
Patroni
Dette er en skabelon i Python til at administrere PostgreSQL med god dokumentation, automatisk failover og kildekoden tilgængelig på GitHub.
Fordele ved Patroni:
- Hver konfigurationsparameter er beskrevet, så det er klart, hvordan tingene fungerer;
- Automatisk failover fungerer fra starten;
- Skriver i Python, og da vi selv skriver meget i Python, vil det være lettere for os at finde os til rette med problemerne og måske endda hjælpe med projektets udvikling;
- Styrer fuldstændigt PostgreSQL, tillader ændring af konfigurationen på alle noder i klyngen, og hvis en genstart af klyngen kræves for at anvende den nye konfiguration, kan dette også gøres ved hjælp af Patroni.
Ulemper:
- Fra dokumentationen er det uklart, hvordan man korrekt arbejder med PgBouncer. Selvom det er svært at betegne som en ulempe, for det er Patronis opgave at styre PostgreSQL, hvordan forbindelser til Patroni håndteres, er vores problem;
- Der er få eksempler på implementering af Patroni i stor skala, men mange eksempler på implementering fra bunden.
I sidste ende valgte vi netop Patroni til at skabe en failover-klynge.
Implementeringsprocessen for Patroni
Inden vi brugte Patroni, havde vi 12 PostgreSQL sharder i en konfiguration med én master og én replika med asynkron replikation. Applikationsserverne kommunikerede med databaserne via en Network Load Balancer, som havde to instanser med PgBouncer, og bag dem var alle PostgreSQL-serverne.
For at implementere Patroni skulle vi vælge et distribueret konfigurationslager for klyngen. Patroni arbejder med distribuerede konfigurationslagre som etcd, Zookeeper og Consul. Vi har allerede et fuldt fungerende Consul-klynge i produktion, som arbejder sammen med Vault, og ellers bruger vi det ikke. Dette er en glimrende mulighed for at begynde at anvende Consul til det, det er beregnet til.
Hvordan Patroni arbejder med Consul
Vi har en Consul-klynge, der består af tre noder, og en Patroni-klynge, som består af en leder og en replika (i Patroni kaldes masteren lederen af klyngen, mens slaverne er replikaer). Hver instans af Patroni-klyngen sender konstant oplysninger om klyngets tilstand til Consul. Derfor kan man altid få den aktuelle konfiguration af Patroni-klyngen fra Consul og se, hvem der er lederen lige nu.
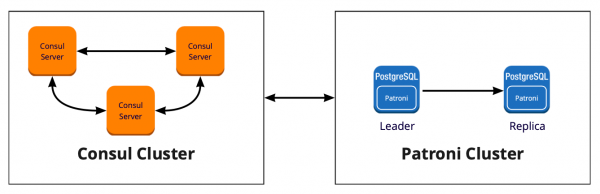
For at forbinde Patroni til Consul er det tilstrækkeligt at konsultere den officielle dokumentation, hvor det er angivet, at der skal angives en vært i formatet http eller https afhængigt af, hvordan vi arbejder med Consul, samt en tilslutningsskema, som er valgfri:
host: værten:port for Consul-endepunktet, i formatet: http(s)://host:port
scheme: (valgfrit) http eller https, standard er http
Det ser simpelt ud, men her begynder udfordringerne. Vi arbejder med Consul via en sikker forbindelse over https, og vores forbindelseskonfiguration vil se således ud:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Men det fungerer ikke. Ved opstart kan Patroni ikke forbinde til Consul, fordi det stadig forsøger at forbinde via http.
Løsningen på problemet fandt vi i koden til Patroni. Heldigvis er den skrevet i Python. Det viser sig, at parameteren host ikke parses korrekt, og protokollen skal angives i scheme. Her er et fungerende konfigurationsblok for at arbejde med Consul hos os:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Så, vi har valgt opbevaringen til konfigurationen. Nu skal vi forstå, hvordan PgBouncer vil skifte sin konfiguration, når lederen i Patroni-klusteret skifter. Der er ikke noget svar på dette i dokumentationen, da arbejdet med PgBouncer overhovedet ikke beskrives.
I søgen efter en løsning fandt vi en artikel (titlen kan jeg desværre ikke huske), hvor det blev nævnt, at Consul-template var meget nyttig i forbindelsen mellem PgBouncer og Patroni. Dette motiverede os til at undersøge, hvordan Consul-template fungerer.
Det viste sig, at Consul-template konstant overvåger PostgreSQL-klusterets konfiguration i Consul. Ved skift af leder opdaterer den PgBouncer-konfigurationen og sender en kommando til at genindlæse den.
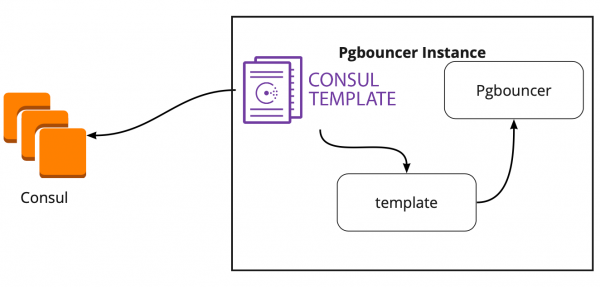
En stor fordel ved template er, at den opbevares som kode, så når der tilføjes en ny shard, er det nok at lave et nyt commit og opdatere template automatisk, hvilket understøtter princippet om Infrastructure as code.
Ny arkitektur med Patroni
Som resultat fik vi følgende arbejdsscheme:
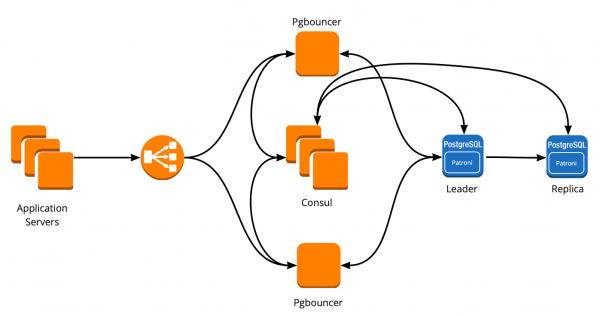
Alle applikationsservere henvender sig til load balancer → Bag den står to PgBouncer-instanser → På hver instans kører Consul-template, som overvåger status for hver Patroni-kluster og sikrer, at PgBouncer-konfigurationen, der sender anmodninger til den nuværende leder af hvert kluster, er opdateret.
Manuel testning
Vi kørte dette scheme i et lille testmiljø før udrulning til produktion og kontrollerede, hvordan automatisk skiftede fungerer. Vi åbnede tavlen, flyttede en klistermærke, og i det øjeblik 'dræbte' vi lederen af klusteret. I AWS er det nok at slukke instansen via konsollen.
Klistermærket vendte tilbage inden for 10-20 sekunder og begyndte derefter at flytte normalt igen. Det betyder, at Patroni-klusteret fungerede korrekt: det skiftede lederen, sendte information til Consul, og Consul-template greb straks denne information, erstattede PgBouncer-konfigurationen og sendte en kommando til reload.
Hvordan overlever man under høj belastning og bevarer minimal nedetid?
Det fungerer glimrende! Men der opstår nye spørgsmål: Hvordan vil det fungere under høj belastning? Hvordan udruller man det hurtigt og sikkert i produktion?
Vi besvarer det første spørgsmål ved hjælp af et testmiljø, hvor vi udfører belastningstest. Det er helt identisk med produktionen i sin arkitektur og har genererede testdata, der omtrent svarer til produktionen i volumen. Vi beslutter os for at "dræbe" en af PostgreSQL-masterne under testen og se, hvad der sker. Men før dette er det vigtigt at kontrollere den automatiske udrulning, da vi har flere PostgreSQL-shards i dette miljø, så vi får en fremragende test af konfigurationsskripterne inden produktionen.
Begge opgaver ser ambitiøse ud, men vi har PostgreSQL 9.6. Skal vi måske straks opgradere til 11.2?
Vi har besluttet at gøre dette i 2 faser: først opgradere versionen til 11.2, derefter starte Patroni.
Opgradering af PostgreSQL
For hurtigt at opgradere versionen af PostgreSQL skal der anvendes indstillingen -k, som opretter hard links på disken, og der er ikke behov for at kopiere dine data. På databaser med 300-400 GB tager opgraderingen 1 sekund.
Vi har mange shards, så opgraderingen skal udføres automatisk. Til dette har vi skrevet en Ansible playbook, som udfører hele opgraderingsprocessen for os:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--link </b>
--old-datadir='' --new-datadir=''
 --old-bindir=''  --new-bindir=''
 --old-options=' -c config_file='
 --new-options=' -c config_file='
Her er det vigtigt at bemærke, at før opgraderingen skal den udføres med parameteren —check, for at være sikker på muligheden for opgraderingen. Vores script håndterer også udskiftning af konfigurationsfilerne under opgraderingen. Scriptet blev udført på 30 sekunder, hvilket er et fremragende resultat.
Start af Patroni
For at løse det andet problem er det tilstrækkeligt at se på konfigurationen af Patroni. I det officielle repository findes der et eksempel på en konfiguration med initdb, som er ansvarlig for at initialisere en ny database ved første opstart af Patroni. Men da vi allerede har en færdig database, har vi blot fjernet dette afsnit fra konfigurationen.
Da vi begyndte at installere Patroni på den eksisterende PostgreSQL-klynge og starte den, stødte vi på et nyt problem: begge servere blev startet som leader. Patroni ved ikke noget om den tidligere tilstand af klyngen og forsøger at starte begge servere som to separate klynger med samme navn. For at løse dette problem er det nødvendigt at slette data mappen på slaven:
rm -rf /var/lib/postgresql/Dette skal kun gøres på slaven!
Når en ren replika forbinder, laver Patroni en basebackup af lederen og genopretter den på replikken, inden den indhenter den aktuelle tilstand via wal-logs.
Endnu en udfordring, vi stod overfor, var, at alle PostgreSQL-klynger som standard hedder main. Når hver klynge ikke kender til de andre, er det fint. Men når du vil bruge Patroni, skal alle klynger have et unikt navn. Løsningen er at ændre klynge-navnet i PostgreSQL-konfigurationen.
Belastningstest
Vi kørte en test, der simulerer brugeraktivitet på tavlerne. Da belastningen nåede vores gennemsnitlige daglige niveau, gentog vi præcist den samme test og slukkede en instans med leader PostgreSQL. Den automatiske failover fungerede som forventet: Patroni skiftede leder, Consul-template opdaterede konfigurationen af PgBouncer og sendte en kommando til opdatering. På vores grafikker i Grafana kunne vi se, at der var forsinkelser på 20-30 sekunder og et lille antal fejl fra serverne relateret til databaseforbindelsen. Det er en normal situation, sådanne værdier er acceptable for vores failover og bestemt bedre end nedetid for tjenesten.
Patroni-output på produktion
Resultatet blev, at vi fik følgende plan:
- Deployment af Consul-template på PgBouncer-serverne og opstart;
- Opdatering af PostgreSQL til version 11.2;
- Ændring af klyngens navn;
- Opstart af Patroni-klyngen.
Vores plan tillader, at vi kan udføre det første punkt på næsten ethvert tidspunkt; vi kan tage hver PgBouncer ud af drift en ad gangen og udføre deployment og opstart af consul-template på dem. Det gjorde vi.
Til hurtig udrulning brugte vi Ansible, da vi allerede havde testet alle playbooks i testmiljøet, og udførelsestiden for hele scenariet var fra 1,5 til 2 minutter for hver shard. Vi kunne rulle det ud én ad gangen på hver shard uden at stoppe vores service, men det ville kræve, at vi slukkede hver PostgreSQL i et par minutter. I dette tilfælde ville brugerne, hvis data findes på denne shard, ikke kunne arbejde ordentligt i mellemtiden, og det er uacceptabelt for os.
Udvejen ud af denne situation var en planlagt vedligeholdelse, som finder sted hver tredje måned. Dette er et vindue til planlagt arbejde, hvor vi fuldstændig slukker for vores service og opdaterer databaseinstanserne. Der var kun en uge tilbage til det næste vindue, og vi besluttede at vente og forberede os yderligere. I ventetiden tog vi også ekstra forholdsregler: For hver PostgreSQL shard oprettede vi en sekundær replika som backup i tilfælde af fejl for at bevare de nyeste data, og vi tilføjede en ny instans for hver shard, som skulle blive en ny replika i Patroni-klyngen for ikke at skulle udføre kommandoen til at slette data. Alt dette hjalp med at minimere risikoen for fejl.
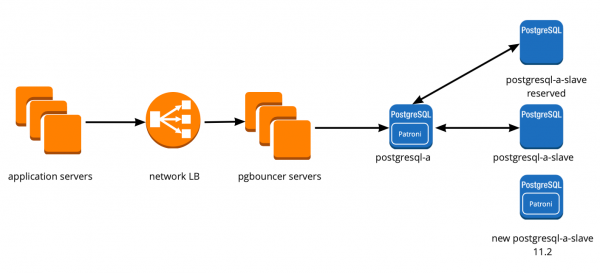
Vi genstartede vores service, og alt fungerede som det skulle, brugerne fortsatte med at arbejde, men på graferne bemærkede vi en unormalt høj belastning på Consul-serverne.
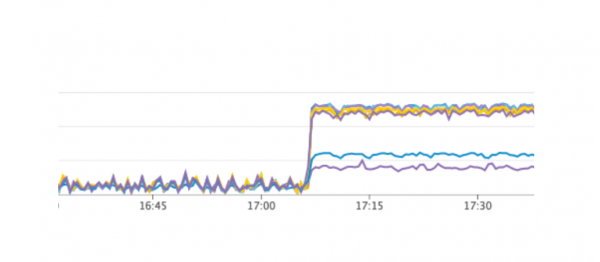
Hvorfor så vi ikke dette i testmiljøet? Dette problem illustrerer meget godt, at det er nødvendigt at følge princippet om Infrastructure as Code og forbedre hele infrastrukturen, fra testmiljøer til produktion. Ellers kan man nemt få et problem som det, vi fik. Hvad skete der? Consul blev først introduceret i produktion og derefter i testmiljøerne, hvilket betød, at versionen af Consul i testmiljøerne var højere end i produktionen. Netop i en af udgivelserne blev der løst et CPU-lækageproblem ved brug af consul-template. Derfor opdaterede vi simpelthen Consul for at løse problemet.
Genstart Patroni klynge
Men vi stødte på et nyt problem, som vi ikke engang havde mistanke om. Ved opdateringen af Consul fjerner vi blot en Consul-node fra klyngen med kommandoen consul leave → Patroni forbinder sig til en anden Consul-server → alt fungerer. Men da vi nåede den sidste instans i Consul-klyngen og sendte den kommandoen consul leave, genstartede alle Patroni-klynger simpelthen, og i loggene så vi følgende fejl:
FEJL: get_cluster
Traceback (seneste kald senest):
...
RetryFailedError: 'Overskredet forsøgsfrist'
FEJL: Fejl i kommunikationen med DCS
<b>LOG: databasesystemet er lukket</b>
Patroni-klyngen kunne ikke få oplysninger om sin klynge og genstartede.
For at finde en løsning kontaktede vi forfatterne af Patroni via en issue på GitHub. De foreslog forbedringer til vores konfigurationsfiler:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Vi var i stand til at gentage problemet i testmiljøet og teste disse parametre der, men desværre fungerede de ikke.
Problemet er stadig uafklaret. Vi planlægger at prøve følgende løsningsmuligheder:
- Bruge Consul-agent på hver instans i Patroni-klyngen;
- Korrigere problemet i koden.
Vi forstår, hvor fejlen opstår: sandsynligvis er problemet med brugen af standard tidsgrænsen, som ikke bliver overskrevet i konfigurationsfilen. Når den sidste Consul-server fjernes fra klyngen, fryser hele Consul-klyngen i mere end et sekund, hvilket gør, at Patroni ikke kan få klyngens status og genstarter hele klyngen.
Heldigvis har vi ikke stødt på flere fejltagelser.
Resultater af brugen af Patroni
Efter den vellykkede opstart af Patroni tilføjede vi en ekstra replik i hver klynge. Nu har hver klynge en form for flertalsafstemning: en leder og to replikaer, for at være sikker i tilfælde af split-brain under skift.
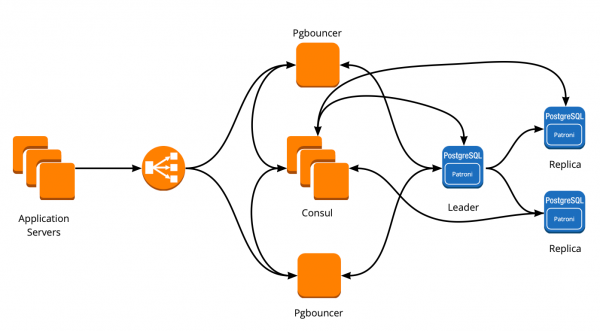
Patroni har fungeret i mere end tre måneder i produktionen. I løbet af denne tid har det allerede hjulpet os. For nylig døde lederen af en af klyngerne i AWS, automatisk failover blev aktiveret, og brugerne fortsatte med at arbejde. Patroni udførte sin hovedopgave.
En lille opsummering af brugen af Patroni:
- Nem ændring af konfigurationen. Det er tilstrækkeligt at ændre konfigurationen på en instans, og den vil blive anvendt på hele klyngen. Hvis en genstart er nødvendig for at anvende den nye konfiguration, vil Patroni informere om det. Patroni kan genstarte hele klyngen med én enkelt kommando, hvilket også er meget praktisk.
- Den automatiske failover fungerer og har allerede hjulpet os.
- Opdatering af PostgreSQL uden nedetid for applikationen. Det er nødvendigt først at opdatere replikaerne til den nye version, derefter skifte lederen i Patroni-klyngen og opdatere den gamle leder. I denne proces foretages den nødvendige test af den automatiske failover.
Kilde: habr.com
