

Mit mit arbejde handler det for det meste om implementering af software systemer, så jeg bruger en hel del tid på at forsøge at besvare sådanne spørgsmål:
- Det fungerer for udvikleren, men ikke for mig. Hvorfor?
- I går virkede det for mig, men i dag gør det ikke. Hvorfor?
Dette er en slags fejlfinding, som adskiller sig lidt fra den almindelige fejlfinding af software. Almindelig fejlfinding handler om logikken i koden, mens deploy-fejlfinding handler om interaktionen mellem koden og miljøet. Selv hvis roden til problemet er en logisk fejl, betyder det faktum, at det fungerer på én maskine, men ikke på en anden, at noget er galt med miljøet på en eller anden måde.
Så i stedet for de normale fejlfinding værktøjer såsom gdb har jeg et andet sæt værktøjer til fejlfindingsafvikling. Og mit yndlingsværktøj til at tackle spørgsmålet "Hvorfor fungerer dette software ikke for mig?" kaldes strace.
Hvad er strace?
— det er et værktøj til "systemopkaldstrackning". Oprindeligt udviklet til Linux, men de samme teknikker til fejlfinding kan anvendes med værktøjer til andre systemer ( eller ).
Hovedanvendelsen er ganske simpel. Du skal blot køre strace med en vilkårlig kommando, og den vil udskrive alle systemopkald (og du bliver nok nødt til at installere selve strace):
$ strace echo Hello
...Snip lots of stuff...
write(1, "Hellon", 6)                  = 6
close(1)                                = 0
close(2)                                = 0
exit_group(0)                           = ?
+++ exited with 0 +++
Hvad er disse systemopkald? Det er noget, der ligner en API for operativsystemets kerne. Dengang havde software direkte adgang til "hardwaren", den kørte på. Hvis man for eksempel skulle vise noget på skærmen, legede det med portene og/eller de hukommelsesregistrer, der var tilgængelige for videoenhederne. Da fleropgavecomputer systemer blev populære, opstod der kaos, fordi forskellige applikationer kæmpede om "hardwaren". Fejl i én applikation kunne bringe andre applikationers funktion eller endda hele systemet i fare. Herefter blev der indført privilegerede tilstande (eller "ringbeskyttelse") i CPU'en. Den mest privilegerede var kernen: den fik fuld adgang til "hardwaren" og kunne generere mindre privilegerede applikationer, der måtte anmode kernen om adgang for at interagere med "hardwaren" — gennem systemopkald.
På det binære niveau adskiller systemkald sig lidt fra simple funktionsopkald, men de fleste programmer bruger en indpakning fra standardbiblioteket. Det vil sige, at standard C POSIX-biblioteket indeholder funktionsopkaldet write(), som indeholder al arkitekturafhængig kode til systemkaldet write.
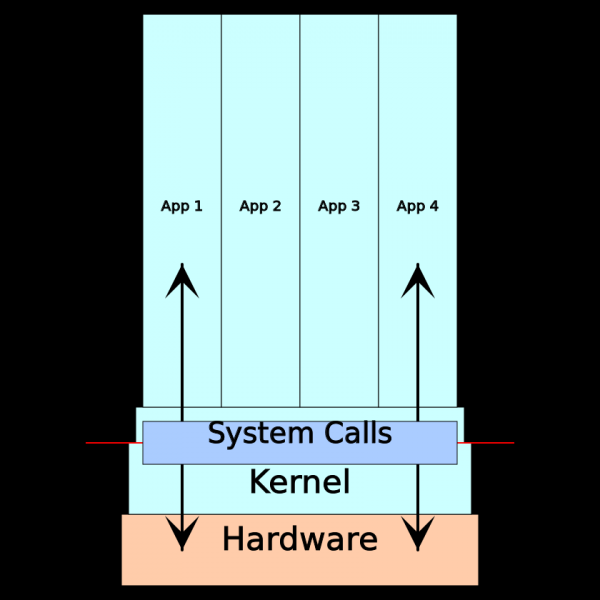
Kort sagt foretages al interaktion mellem applikationen og dens miljø (computersystemer) gennem systemkald. Derfor, når softwaren fungerer på én maskine, men ikke på en anden, er det en god idé at kigge på resultaterne fra systemkaldstracing. Mere specifikt er her en liste over typiske aspekter, der kan analyseres ved hjælp af tracing af systemkald:
- Konsol input/output
- Netværk input/output
- Adgang til filsystemet og fil input/output
- Håndtering af proces-tråd livscyklus
- Lavniveau hukommelsesadministration
- Adgang til drivere for særlige enheder
Hvornår skal man bruge strace?
Teoretisk set strace bruges med alle programmer i brugerrummet, da enhver program i brugerrummet skal udføre systemkald. Det fungerer mere effektivt med kompilérbare, lavniveau programmer, men virker også med højere niveauer som Python, hvis man kan komme igennem det ekstra støj fra kørselsmiljøet og fortolker.
I al sin glans strace komme til sin ret under debugging af software, der fungerer godt på én maskine, men pludselig stopper med at fungere på en anden og giver uklare beskeder om filer, tilladelser eller mislykkede forsøg på at udføre bestemte kommandoer eller lignende... Desværre fungerer det ikke så godt med højniveau problemer som certifikatvalideringsfejl. Her kræves normalt en kombination strace, nogle gange og værktøjer af højere niveau (som kommandolinjeværktøjet openssl til debugging af certifikatet).
For eksempel tager vi arbejdet på en isoleret server, men tracing af systemkald kan ofte udføres på mere komplekse implementeringsplatforme. Det handler bare om at finde det rigtige værktøj.
Eksempel på simpel debug
Lad os sige, at du vil køre den fantastiske serverapp foo, men det ser sådan ud:
$ foo
Fejl ved åbning af konfigurationsfil: Ingen sådan fil eller katalog
Det er åbenlyst, at han ikke kunne finde den konfigurationsfil, du har skrevet. Dette sker, fordi pakkehåndterere nogle gange, når de kompilerer et program, overskriver den forventede placering af filer. Og hvis man følger installationsvejledningen for én distribution, finder man filer et helt andet sted, end man forventede i en anden. Problemet kunne løses på et par sekunder, hvis fejlmeddelelsen fortalte, hvor den konfigurationsfil skal findes, men det gør den ikke. Så hvor skal man lede?
Hvis der er adgang til kildekoden, kan man læse den og finde svarene. Det er en god backup-plan, men ikke den hurtigste løsning. Man kan bruge en trin-for-trin debugger som gdb og se, hvad programmet laver, men det er langt mere effektivt at bruge et værktøj, der er specielt designet til at vise interaktionen med miljøet: strace.
Output strace det kan virke overflødigt, men de gode nyheder er, at det meste af det kan ignoreres. Det er ofte nyttigt at bruge -o operatoren til at gemme sporingsresultaterne i en separat fil:
$ strace -o /tmp/trace foo
Fejl ved åbning af konfigurationsfil: Ingen sådan fil eller bibliotek
$ cat /tmp/trace
execve("foo", ["foo"], 0x7ffce98dc010 /* 16 variabler */) = 0
brk(NULL)                               = 0x56363b3fb000
access("/etc/ld.so.preload", R_OK)      = -1 ENOENT (Ingen sådan fil eller bibliotek)
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=25186, ...}) = 0
mmap(NULL, 25186, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f2f12cf1000
close(3)                                = 0
openat(AT_FDCWD, "/lib/x86_64-linux-gnu/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "177ELF2113 3 > 1 260A2 "..., 832) = 832
fstat(3, {st_mode=S_IFREG|0755, st_size=1824496, ...}) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f2f12cef000
mmap(NULL, 1837056, PROT_READ, MAP_PRIVATE|MAP_DENYWRITE, 3, 0) = 0x7f2f12b2e000
mprotect(0x7f2f12b50000, 1658880, PROT_NONE) = 0
mmap(0x7f2f12b50000, 1343488, PROT_READ|PROT_EXEC, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x22000) = 0x7f2f12b50000
mmap(0x7f2f12c98000, 311296, PROT_READ, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x16a000) = 0x7f2f12c98000
mmap(0x7f2f12ce5000, 24576, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x1b6000) = 0x7f2f12ce5000
mmap(0x7f2f12ceb000, 14336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0) = 0x7f2f12ceb000
close(3)                                = 0
arch_prctl(ARCH_SET_FS, 0x7f2f12cf0500) = 0
mprotect(0x7f2f12ce5000, 16384, PROT_READ) = 0
mprotect(0x56363b08b000, 4096, PROT_READ) = 0
mprotect(0x7f2f12d1f000, 4096, PROT_READ) = 0
munmap(0x7f2f12cf1000, 25186)           = 0
openat(AT_FDCWD, "/etc/foo/config.json", O_RDONLY) = -1 ENOENT (Ingen sådan fil eller bibliotek)
dup(2)                                  = 3
fcntl(3, F_GETFL)                       = 0x2 (flags O_RDWR)
brk(NULL)                               = 0x56363b3fb000
brk(0x56363b41c000)                     = 0x56363b41c000
fstat(3, {st_mode=S_IFCHR|0620, st_rdev=makedev(0x88, 0x8), ...}) = 0
write(3, "Fejl ved åbning af konfigurationsfil"..., 60) = 60
close(3)                                = 0
exit_group(1)                           = ?
+++Exited med 1 +++
Næsten hele den første side af output strace — det er normalt lavniveau-forberedelse til at køre. (Mange kald til mmap, mprotect, brk til opgaver som opdagelse af lavnivåhukommelse og kortlægning af dynamiske biblioteker.) Generelt set er det ofte strace bedre at læse outputet fra bunden. Nederst er der et kald write, der viser en fejlmeddelelse. Vi ser op og ser det første fejlslagne systemopkald — kaldet openat, som returnerer fejlen ENOENT («fil eller katalog findes ikke»), der forsøger at åbne /etc/foo/config.json. Her skal konfigurationsfilen være.
Dette var blot et eksempel, men jeg vil sige, at 90% af tiden, når jeg bruger strace, er der ikke meget mere kompleksitet i det, end hvad der skal gøres. Nedenfor er en komplet trin-for-trin vejledning til fejlfinding:
- Bliv frustreret over en utydelig systemfejlmeddelelse fra programmet.
- Genstart programmet med strace
- Find fejlmeddelelsen i sporingsresultaterne.
- Bevæg dig op, indtil du når det første fejlslagne systemopkald.
Det er meget sandsynligt, at systemopkaldet i trin 4 vil vise, hvad der gik galt.
Tips
Før jeg viser et eksempel på mere kompleks fejlfinding, vil jeg dele nogle tricks til effektiv brug. strace:
man — din ven
På mange *nix-systemer kan du få den fulde liste over systemopkald til kernen ved at køre man syscalls. Du vil se ting som brk(2), og derfor kan du få mere information ved at køre man 2 brk.
Små faldgruber: man 2 fork viser mig siden for shellen fork() i GNU libc, som åbenbart er implementeret ved hjælp af opkaldet clone(). Semantikken af opkaldet fork forbliver den samme, hvis du skriver et program, der bruger fork(), og kører sporingen — jeg vil ikke finde opkaldene fork, i stedet vil der være clone(). Sådanne faldgruber forvirrer kun, hvis du begynder at sammenligne koden med outputtet. strace.
Brug -o for at gemme output i en fil
strace kan generere omfattende output, så det er ofte nyttigt at gemme sporingsresultaterne i separate filer (som i det ovenfor nævnte eksempel). Det hjælper også med ikke at blande programoutput med output strace i konsollen.
Brug -s for at se flere argumentdata
Du har sikkert bemærket, at den anden halvdel af fejlmeddelelsen ikke vises i det ovenfor nævnte sporings eksempel. Det er fordi strace som standard kun viser de første 32 byte af argumentstrengen. Hvis du vil se mere, kan du tilføje noget som -s 128 til opkaldet strace.
-u gør det lettere at følge filsocket og lignende.
«Alt er en fil» betyder, at *nix-systemer udfører al input-output via filbeskrivelser, hvad enten det gælder filer, netværk eller interprocess-kanaler. Dette er praktisk for programmering, men det gør det svært at følge med i, hvad der faktisk sker, når du ser på generelle write og write i outputtet fra systemopkaldssporet.
Ved at tilføje flaget -u, vil du få strace til at annotere hver filbeskrivelse i outputtet med en bemærkning om, hvad den refererer til.
Tilslut til en allerede kørende proces med -p**
Som det fremgår af det følgende eksempel, nogle gange skal du spore et program, der allerede kører. Hvis du ved, at det kører som proces 1337 (lad os sige, fra outputtene ps), kan du spore det sådan her:
$ strace -p 1337
...systemopkalds sporingsoutput...
Måske har du brug for root-rettigheder.
Brug -f for at følge underprocesserne
strace Som standard sporer det kun en proces. Hvis denne proces dog skaber underprocesser, kan du se systemkaldet for at oprette en underproces, men systemkald fra underprocessen vil ikke blive vist.
Hvis du mener, at fejlen ligger i underprocessen, skal du bruge operatoren -f, dette vil aktivere dens sporingsfunktion. Ulempen ved dette er, at outputtet vil forvirre dig endnu mere. Når strace det sporer en proces eller en gren, viser det en enkelt strøm af begivenheder i opkaldene. Når den sporer flere processer samtidigt, kan du muligvis se begyndelsen af et opkald, der bliver afbrudt af meddelelsen <unfinished …>, derefter en gruppe opkald for andre eksekveringsgange, og kun derefter afslutningen af den første med <… foocall resumed>. Alternativt kan du opdele alle sporingsresultaterne i forskellige filer, ved også at bruge operatoren -ff (detaljer findes i efter strace).
Filtrer sporing ved hjælp af -e
Som du kan se, er resultatet af sporing en ægte bunke af alle mulige systemkald. Flaget -e kan bruges til at filtrere sporing (se. efter strace). Den største fordel ved at køre sporing med filtrering er, at det går hurtigere end at lave en fuld sporing og derefter grep`alderen. For at være ærlig, er jeg næsten altid ligeglad.
Ikke alle fejl er dårlige
Et simpelt og almindeligt eksempel er et program, der søger efter en fil på flere steder, som f.eks. en shell, der søger, hvilket kildemappe den udførlige fil ligger i:
$ strace sh -c uname
...
stat("/home/user/bin/uname", 0x7ffceb817820) = -1 ENOENT (Ingen sådan fil eller mappe)
stat("/usr/local/bin/uname", 0x7ffceb817820) = -1 ENOENT (Ingen sådan fil eller mappe)
stat("/usr/bin/uname", {st_mode=S_IFREG|0755, st_size=39584, ...}) = 0
...
Heuristikken "den sidste mislykkede forespørgsel før fejmeddelelsen" er god til at finde relevante fejl. Uanset hvad, er det logisk at starte fra slutningen.
At forstå systemkald hjælper meget, hvis du tjekker programmeringsvejledninger i C
De standardopkald, der foretages til C-bibliotekerne, er ikke systemkald, men blot et fint overfladelag. Derfor, hvis du har lidt forståelse for, hvordan og hvad man gør i C, vil det være lettere for dig at forstå resultaterne af systemkaldssporingen. For eksempel, hvis du har problemer med at debugge opkald til netværksystemer, tjek den klassiske .
Et mere komplekst debugging eksempel
Jeg har allerede nævnt, at et eksempel på simpel fejlsøgning er et eksempel på, hvad jeg i høj grad arbejder med i mit arbejde med strace. Men nogle gange kræver det faktisk en reel undersøgelse, så her er et virkeligt eksempel på en mere kompliceret fejlsøgning.
— en opgaveplanlægger, en anden implementation af en *nix daemon cron. Den er installeret på serveren, men når nogen prøver at redigere tidsplanen, sker der følgende:
# crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
Okay, så bcron prøvede at skrive en fil, men det lykkedes ikke, og den indrømmer ikke hvorfor. Lad os finde ud af strace:
# strace -o /tmp/trace crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
# cat /tmp/trace
...
openat(AT_FDCWD, "bcrontab.14779.1573691864.847933", O_RDONLY) = 3
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
read(3, "#Ansible: logsaggn20 14 * * * lo"..., 8192) = 150
read(3, "", 8192)                       = 0
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
socket(AF_UNIX, SOCK_STREAM, 0)         = 3
connect(3, {sa_family=AF_UNIX, sun_path="/var/run/bcron-spool"}, 110) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
write(3, "156:Slogs #Ansible: logsaggn20 1"..., 161) = 161
read(3, "32:ZCould not create temporary f"..., 8192) = 36
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
write(2, "bcrontab: Fatal: Could not creat"..., 49) = 49
unlink("bcrontab.14779.1573691864.847933") = 0
exit_group(111)                         = ?
+++ exited with 111 +++
Mod slutningen er der en fejlmeddelelse write, men denne gang er der noget anderledes. For det første er der ingen relevant systemfejl, som normalt sker før dette. For det andet kan man se, at et eller andet sted er der allerede nogen, der har læst fejlmeldingen. Det ligner, at det reelle problem ligger et andet sted, mens bcrontab bare gengiver meddelelsen.
Ser man på man 2 read, kan man se, at det første argument (3) er en filbeskriver, som *nix bruger til al input-output behandling. Hvordan finder man ud af, hvad filbeskriveren 3 repræsenterer? I dette specifikke tilfælde kan man køre strace med operatoren -u (se ovenfor), og det vil automatisk fortælle det, men for at beregne sådanne ting er det nyttigt at vide, hvordan man læser og analyserer sporingsresultater.
Kilden til filbeskriveren kan være et af mange systemopkald (det afhænger helt af, hvad beskriveren bruges til — til konsollen, netværkssocket, den egentlige fil eller noget andet), men uanset hvad, søger vi opkaldene, der returnerer 3 (dvs. vi søger «= 3» i sporingsresultaterne). I dette resultat er der 2: openat øverst og socket openat i midten. closeåbner filen, men socket() (3) vil efterfølgende vise, at den lukkes igen. (Fælde: filbeskrivere kan genbruges, når de åbnes og lukkes). Opkaldet read()er relevant, da det er det sidste før , og det viser sig, at bcrontab arbejder med noget gennem en socket. Den næste linje viser, at filbeskriveren er forbundet til unix domain socket /var/run/bcron-spool.
ved stien Så man skal finde den proces, der er bundet til unix socket netstat eller den nyere ss (socket status). Begge kommandoer viser aktive netværksforbindelser i systemet og tager operatøren -l til beskrivelse af lytende sockets, samt operatøren -p til at vise programmer, der er tilsluttet socketen som klient. (Der er mange nyttige muligheder, men for denne opgave er disse to nok.)
# ss -pl | grep /var/run/bcron-spool
u_str LISTEN 0   128   /var/run/bcron-spool 1466637   * 0   users:(("unixserver",pid=20629,fd=3))
Dette indikerer, at lytende er en kommando inixserver, der arbejder med proces-ID 20629. (Og tilfældigvis bruger den filbeskrivelsen 3 som socket.)
Et andet virkelig nyttigt værktøj til at finde den samme information kaldes lsof. Det oplister alle åbne filer (eller filbeskrivelser) i systemet. Alternativt kan man få information om en specifik fil:
# lsof /var/run/bcron-spool
COMMAND   PID   USER  FD  TYPE  DEVICE              SIZE/OFF  NODE    NAME
unixserve 20629 cron  3u  unix  0x000000005ac4bd83  0t0       1466637 /var/run/bcron-spool type=STREAM
Proces 20629 er en langlivet server, så man kan vedhæfte til den strace ved hjælp af noget som strace -o /tmp/trace -p 20629. Hvis man redigerer cron-jobbet i et andet terminalvindue, får man output fra sporingen med den opståede fejl. Her er resultatet:
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21181
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Skal genstartes, hvis SA_RESTART er indstillet)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21181, si_uid=998, si_status=0, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 0}], WNOHANG|WSTOPPED, NULL) = 21181
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Ingen børneprocesser)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21200
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Skal genstartes, hvis SA_RESTART er indstillet)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21200, si_uid=998, si_status=111, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 111}], WNOHANG|WSTOPPED, NULL) = 21200
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Ingen børneprocesser)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL
(Den sidste accept() vil ikke blive afsluttet under sporing.) Og igen, som det er trist, men dette resultat indeholder ikke den fejl, vi leder efter. Vi ser ingen meddelelser, som bcrontag sendte til socketen eller modtog fra den. I stedet er det rent processtyring (clone, wait4, SIGCHLD og osv.) Denne proces genererer en underproces, der, som man kan gætte, udfører det egentlige arbejde. Og hvis det er nødvendigt at opfange dens spor, tilføj til opkaldet strace -f. Her er hvad vi finder, når vi søger efter en fejlmeddelelse i det nye resultat med strace -f -o /tmp/trace -p 20629:
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Adgang nægtet)
21470 write(1, "32:ZKunne ikke oprette midlertidig f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Ingen sådan fil eller bibliotek)
21470 exit_group(111)                   = ?
21470 +++ afsluttet med 111 +++
Her, dette er allerede noget. Proces 21470 får fejlen "adgang nægtet" når den forsøger at oprette en fil på stien tmp/spool.21470.1573692319.854640 (vedrørende det nuværende arbejdsbibliotek). Hvis vi blot visste det nuværende arbejdsbibliotek, ville vi også vide den fulde sti og kunne finde ud af, hvorfor processen ikke kan oprette sin midlertidige fil der. Desværre er processen allerede afsluttet, så vi kan ikke bare bruge lsof -p 21470 til at finde det nuværende bibliotek, men vi kan arbejde baglæns — søge systemopkald fra PID 21470, der ændrer biblioteket. (Hvis der ikke er nogen, har PID 21470 sandsynligvis arvet dem fra forældreprocessen, og det er allerede gennem lsof -p ikke at finde ud af.) Dette systemopkald — chdir (som ikke er svært at finde ud af ved hjælp af moderne søgemaskiner). Og her er resultaterne af de baglæns søgninger baseret på sporingsresultaterne, ned til serveren PID 20629:
20629 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21470
...
21470 execve("/usr/sbin/bcron-spool", ["bcron-spool"], 0x55d2460807e0 /* 27 vars */) = 0
...
21470 chdir("/var/spool/cron")          = 0
...
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Adgang nægtet)
21470 write(1, "32:ZKunne ikke oprette midlertidig f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatal: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Ingen sådan fil eller bibliotek)
21470 exit_group(111)                   = ?
21470 +++ afsluttet med 111 +++
(Hvis du er fortabt, kan det være en god idé at læse mit tidligere indlæg .) Så serveren PID 20629 fik ikke tilladelse til at oprette en fil på stien /var/spool/cron/tmp/spool.21470.1573692319.854640. Sandsynligvis er årsagen de klassiske indstillinger for filsystemrettigheder. Lad os tjekke:
# ls -ld /var/spool/cron/tmp/
drwxr-xr-x 2 root root 4096 Nov  6 05:33 /var/spool/cron/tmp/
# ps u -p 20629
USER       PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
cron     20629  0.0  0.0   2276   752 ?        Ss   Nov14   0:00 unixserver -U /var/run/bcron-spool -- bcron-spool
Her er hunden begravet! Serveren kører som brugercron, men kun root har rettighed til at skrive i biblioteket /var/spool/cron/tmp/. En simpel kommando chown cron /var/spool/cron/tmp/ vil gøre det bcron arbejde korrekt. (Hvis problemet ikke lå her, er den næste mest sandsynlige mistænkte en sikkerhedsmodeul som SELinux eller AppArmor, så jeg ville tjekke kernelens log med dmesg.)
I alt
En nybegynder kan drukne i resultaterne af systemopkaldstraceringen, men jeg håber, jeg har vist, at de er en hurtig måde at debugge en hel klasse af almindelige implementeringsproblemer på. Forestil dig at forsøge at debugge en multiprocess bcron, ved at bruge en trinvise debugger.
At analysere resultaterne af traceringskæden baglæns kræver færdigheder, men som jeg nævnte, bruger jeg næsten altid strace, jeg får blot traceringsresultatet og leder efter fejl, startende fra slutningen. Under alle omstændigheder, strace hjælper mig med at spare en masse tid på debugging. Jeg håber, det også vil være nyttigt for dig.
Kilde: habr.com
