

For et par år siden blev Kubernetes i den officielle GitHub blog. Siden da er det blevet en standardteknologi til implementering af tjenester. Nu styrer Kubernetes en betydelig del af interne og offentlige tjenester. Efterhånden som vores klynger voksede, og kravene til ydeevne blev mere strenge, begyndte vi at bemærke, at nogle tjenester på Kubernetes sporadisk oplevede forsinkelser, som ikke kunne forklares med belastningen fra selve applikationen.
I essensen opstår der i applikationerne en tilfældig netværksforsinkelse på op til 100 ms eller mere, hvilket medfører timeouts eller genforsøg. Det var forventet, at tjenesterne kunne svare på anmodninger langt hurtigere end 100 ms. Men det er umuligt, hvis selve forbindelsen tager så lang tid. Separat observerede vi meget hurtige MySQL-anmodninger, der burde tage millisekunder, og MySQL klarede det faktisk på millisekunder, men fra det anmodende applikations perspektiv tog svaret 100 ms eller mere.
Det blev hurtigt klart, at problemet kun opstod ved forbindelsen til Kubernetes-noden, selv når opkaldet kom udefra Kubernetes. Det er lettest at gengive problemet i en test , der kører fra enhver intern værtsmaskine, tester Kubernetes-tjenesten på en bestemt port, og sporadisk registrerer stor forsinkelse. I denne artikel vil vi se på, hvordan vi har været i stand til at spore årsagen til dette problem.
Fjerner unødvendig kompleksitet i fejlens kæde
Ved at gengive det samme eksempel ønskede vi at indsnævre problemfokuset og fjerne unødvendige lag af kompleksitet. Oprindeligt var der for mange elementer i strømmen mellem Vegeta og pod'erne på Kubernetes. For at afdække et dybere netværksproblem skal nogle af dem udelukkes.
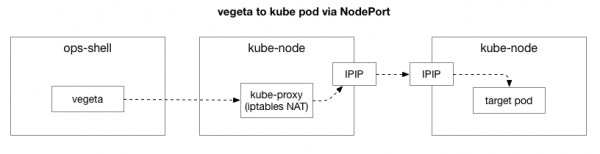
Klienten (Vegeta) opretter en TCP-forbindelse til enhver node i klyngen. Kubernetes fungerer som et overlay-netværk (oven på det eksisterende datacenter-netværk), der bruger , hvilket vil sige at indkapsle IP-pakkerne fra overlay-netværket inde i IP-pakkerne fra datacentret. Når der oprettes forbindelse til den første node, udføres der netværksadresseoversættelse. (NAT) med tilstandsmonitorering til at konvertere IP-adressen og porten for Kubernetes-node til IP-adresse og port i overlay-netværket (især for en pod med en applikation). For de indkommende pakker udføres en omvendt rækkefølge. Dette er et komplekst system med mange tilstande og mange elementer, der konstant opdateres og ændres, mens tjenester deployeres og flyttes.
Utility tcpdump i Vegeta-testen medfører forsinkelse under TCP-håndtrykket (mellem SYN og SYN-ACK). For at fjerne denne overflødige kompleksitet kan man bruge hping3 til enkle 'pinger' med SYN-pakker. Vi tjekker for forsinkelse i det svarende pakke og nulstiller derefter forbindelsen. Vi kan filtrere dataene ved kun at inkludere pakker over 100 ms og få en simplere måde at reproducere problemet på end en fuld netværksniveau 7-test i Vegeta. Her er 'pinger' til Kubernetes-noden, der bruger TCP SYN/SYN-ACK på 'service-node-porten' (30927) med et interval på 10 ms, filtreret efter de langsomste svar:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Man kan straks gøre den første observation. Ud fra sekvensnumre og timing kan det ses, at dette ikke er engangsstop. Forsinkelse akkumuleres ofte, og til sidst behandles det.
Dernæst ønsker vi at finde ud af, hvilke komponenter der kan være involveret i at skabe stoppet. Er det nogle af de hundrede iptables-regler i NAT? Eller nogle tunneleringsproblemer med IPIP i netværket? En måde at teste dette på er at kontrollere hvert trin i systemet ved at udelukke det. Hvad sker der, hvis man fjerner NAT og firewall-logikken, så man kun har IPIP-delen:
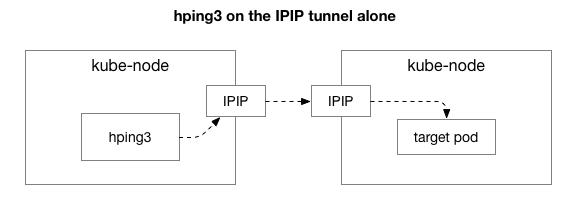
Heldigvis gør Linux det nemt at tilgå overlay-laget IP direkte, hvis maskinen er på samme netværk:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
If the results are anything to go by, the problem still persists! This rules out iptables and NAT. So, is the issue with TCP? Let's see how a standard ICMP ping goes:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
The results show that the problem hasn’t gone away. Could it be an IPIP tunnel? Let's simplify the test further:
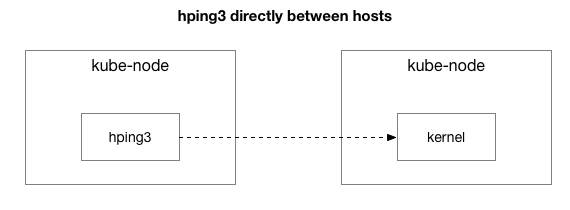
Are all packets being sent between these two hosts?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
We’ve simplified the situation to two Kubernetes nodes sending any packets to each other, even ICMP pings. They still experience latency if the target host is 'bad' (some worse than others).
Now for the final question: why does latency only occur on kube-node servers? And does it happen when kube-node is the sender or the receiver? Fortunately, this can also be figured out easily by sending a packet from a host outside Kubernetes, but to the same 'known bad' receiver. As we can see, the problem hasn't disappeared:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Then we’ll perform the same requests from the previous source kube-node to the external host (which excludes the source host since the ping includes both RX and TX as components):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statistik ---
 22352 pakker sendt, 22350 pakker modtaget, 1% pakke tab
 round-trip min/kv./maks = 0.2/7.6/1010.6 ms
Efter at have analyseret pakkefangst med ventetid, har vi fået lidt yderligere information. Især at afsenderen (nederst) ser denne timeout, mens modtageren (øverst) ikke gør — se Delta-kolonnen (i sekunder):
Derudover, når man ser på forskellen i rækkefølgen af TCP- og ICMP-pakker (efter sekvensnumre) på modtagerens side, ankommer ICMP-pakker altid i den rækkefølge, de blev sendt, men med forskellig timing. I mellemtiden skifter TCP-pakker nogle gange omkring, og en del af dem sidder fast. Specifikt, hvis man undersøger SYN-pakkernes porte, går de i rækkefølge på senderens side, men ikke på modtagerens.
Der er en subtil forskel i den måde moderne servere (som i vores datacenter) behandler pakker, der indeholder TCP eller ICMP. Når en pakke ankommer, 'hash'er netværksadapteren det efter forbindelsen', hvilket betyder, at den forsøger at fordele forbindelserne på køer og sende hver kø til et separat CPU-kerne. For TCP inkluderer denne hash både kilde- og destinations-IP-adressen samt port. Med andre ord, hver forbindelse hash'es (potentielt) forskelligt. For ICMP hash'es kun IP-adresserne, da der ikke er nogen porte.
En anden ny observation: i løbet af denne periode ser vi ICMP-forsinkelser på alle kommunikationer mellem to værter, mens der ikke er nogen for TCP. Dette fortæller os, at årsagen sandsynligvis er relateret til hash'en af RX-køer: der opstår næsten med sikkerhed flaskehals i behandlingen af RX-pakker, ikke i sendingen af svar.
Dette udelukker paketafsendelse fra listen over mulige årsager. Nu ved vi, at problemet med pakkebehandling ligger på modtagersiden på nogle kube-node-servere.
Vi undersøger pakkeprocessering i Linux-kernen
For at forstå, hvorfor problemet opstår hos modtageren på nogle kube-node-servere, lad os se på, hvordan Linux-kernen behandler pakker.
Tilbage til den mest grundlæggende traditionelle implementering modtager netværkskortet en pakke og sender til Linux-kernen, der indikerer, at der er en pakke, der skal behandles. Kernen stopper andet arbejde, skifter kontekst til afbryderbehandleren, behandler pakken og vender derefter tilbage til de aktuelle opgaver.
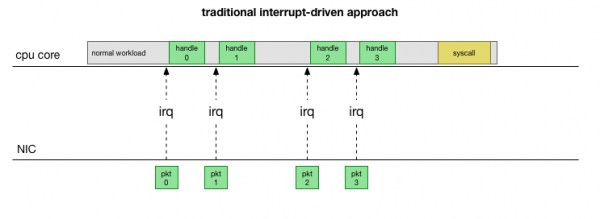
Denne kontekstskift foregår langsomt: måske var forsinkelsen usynlig på 10-megabit netværkskort i 90'erne, men på moderne 10G-kort med en maksimal kapacitet på 15 millioner pakker per sekund kan hvert lille kerne af en otte-kernet server blive afbrudt millioner af gange i sekundet.
For at undgå konstant behandling af afbrydelser blev der for mange år siden tilføjet : et netværks-API, som alle moderne drivere bruger til at øge ydeevnen ved høje hastigheder. Ved lavere hastigheder modtager kernen stadig afbrydelser fra netværkskortet på den gamle måde. Så snart der kommer et tilstrækkeligt antal pakker, der overstiger en tærskel, deaktiverer kernen afbrydelserne og begynder i stedet at pollere netværksadapteren og hente pakker i portioner. Behandlingen udføres i softirq, det vil sige i efter systemopkald og hardwareafbrydelser, når kernen (i modsætning til brugerområdet) allerede er aktiv.
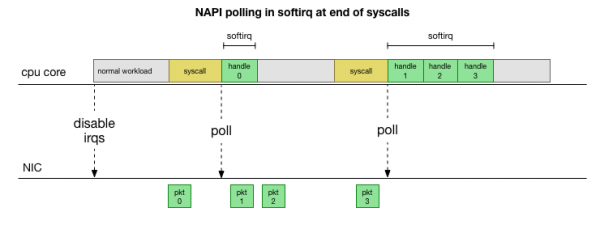
Dette er meget hurtigere, men skaber et andet problem. Hvis der er for mange pakker, går hele tiden til behandling af pakkerne fra netværkskortet, og processerne i brugerområdet får ikke tid til effektivt at tømme disse køer (læse fra TCP-forbindelser osv.). Til sidst fyldes køerne, og vi begynder at kassere pakker. For at finde en balance fastsætter kernen et budget for det maksimale antal pakker, der behandles i softirq-konteksten. Så snart dette budget overskrides, vækkes en separat tråd ksoftirqd (du vil se en af dem i ps for hvert kerne), som behandler disse softirq uden for den normale syscall-/interrupt-sti. Denne tråd planlægges med den almindelige procesplanlægger, som forsøger at fordele ressourcerne retfærdigt.
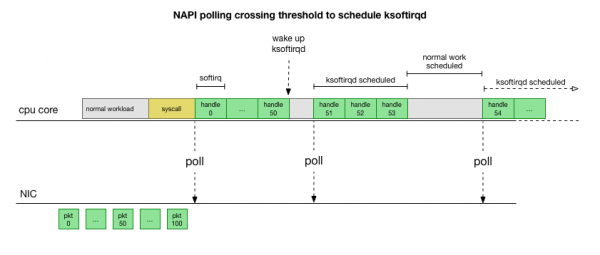
Når man undersøger, hvordan kernen behandler pakker, kan man bemærke, at der er en vis sandsynlighed for flaskehalse. Hvis softirq-opkaldene kommer sjældnere, må pakkerne vente noget tid på behandling i RX-køen på netværkskortet. Dette kan være forårsaget af en opgave, der blokerer for kernen, eller at noget andet forhindrer kernen i at starte softirq.
Vi indsnævrer behandlingen til kernen eller metoden
Softirq forsinkelse er endnu kun en hypotese. Men det giver mening, og vi ved, at vi observerer noget meget lignende. Så næste skridt er at bekræfte denne teori. Og hvis den bekræftes, skal vi finde årsagen til forsinkelsen.
Lad os vende tilbage til vores langsomme pakker:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Som tidligere diskuteret, disse ICMP-pakker hashes i en kø på NIC RX og behandles af en CPU-kerne. Hvis vi vil forstå, hvordan Linux fungerer, er det nyttigt at vide, hvor (på hvilken CPU-kerne) og hvordan (softirq, ksoftirqd) disse pakker behandles, så vi kan spore processen.
Nu er det tid til at bruge værktøjer, der tillader os at overvåge Linux-kernens arbejde i realtid. Her har vi brugt . Dette værktøjskit giver mulighed for at skrive små programmer i C, der fanger vilkårlige funktioner i kernen og buffrer begivenheder i et Python-brugerprogram, der kan behandle dem og returnere resultater til dig. Hooks til vilkårlige funktioner i kernen er komplicerede, men værktøjet er designet til maksimal sikkerhed og er beregnet til at overvåge netop sådanne produktionsproblemer, der er svære at genskabe i test- eller udviklingsmiljøer.
Planen her er enkel: vi ved, at kernen behandler disse ICMP pinger, så vi vil sætte et hook på kernens funktion , som modtager en indkommende ICMP-pakke "echo request" og initierer afsendelsen af ICMP-svaret "echo response". Vi kan identificere pakken ved at se på stigningen i nummeret icmp_seq, som viser hping3 højere.
Kode ser komplekst ud, men det er ikke så skræmmende, som det ser ud til. Funktionen icmp_echo overfører struct sk_buff *skb: er en pakke med en "echo request". Vi kan spore den, trække sekvensen ud echo.sequence (som svarer til icmp_seq fra hping3 over), og sende den til brugerområdet. Det er også praktisk at fange det nuværende procesnavn/identifikator. Nedenfor er resultaterne, som vi ser under behandling af pakkerne af kernen:
TGID    PID     PROCESS NAME    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Det er vigtigt at bemærke, at i denne kontekst softirq processer, der har udført systemanrop, vil blive vist som "processer", selvom det i virkeligheden er kernen, der sikkert håndterer pakker i kernekonteksten.
Med dette værktøj kan vi etablere forbindelsen mellem specifikke processer og specifikke pakker, der viser forsinkelse i hping3. Vi laver et simpelt grep på dette afhæng af bestemte værdier icmp_seq. Pakker, der svarer til de nævnte icmp_seq-værdier, blev markeret sammen med deres RTT, som vi så ovenfor (de forventede RTT-værdier for pakkerne, som vi filtrerede ud på grund af RTT-værdier under 50 ms, er angivet i parentes):
TGID    PID     PROCESS NAME    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Resultaterne fortæller os flere ting. For det første håndteres alle disse pakker af konteksten ksoftirqd/11. Dette betyder, at for dette specifikke par maskiner blev ICMP-pakkerne hashet til kerne 11 på modtagerens side. Vi ser også, at der ved hver blokering er pakker, der behandles i konteksten af systemanrop cadvisor. Derefter ksoftirqd tager opgaven over og behandler den opsamlede kø: netop det antal pakker, der er blevet samlet op efter cadvisor.
Det forhold, at der altid er aktivitet direkte før dette cadvisor, antyder dets involvering i problemet. Ironisk nok er formålet med — "analysere ressourceforbrug og ydelse af kørende containere", snarere end at forårsage dette ydelsesproblem.
Som ligesom med andre aspekter af containerdrift, er dette alt sammen et meget avanceret værktøj, hvor man godt kan forvente problemer med ydeevnen under visse uforudsete omstændigheder.
Hvad er det, cadvisor gør, som bremser pakkekøen?
Nu har vi en ret god forståelse af, hvordan fejlen opstår, hvilken proces der forårsager den, og på hvilken CPU. Vi kan se, at på grund af tight locking har Linux-kernen ikke tid til at planlægge ksoftirqd. Og vi ser, at pakker behandles i konteksten af cadvisor. Det ville være logisk at antage, at cadvisor kører en langsom syscall, hvorefter alle de opbyggede pakker i mellemtiden bliver behandlet:
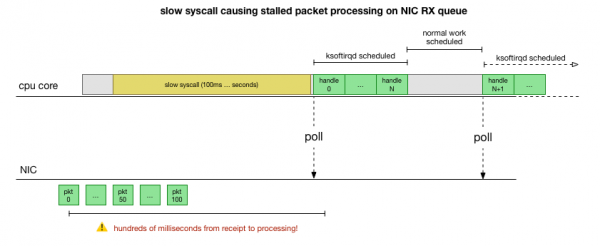
Dette er teorien, men hvordan kan vi teste den? Hvad vi kan gøre, er at spore CPU-kernels arbejde gennem hele denne proces, finde det punkt, hvor budgettet for antallet af pakker overskrides, og ksoftirqd aktiveres, og så se lidt tidligere – hvad der præcist kørte på CPU-kernen lige før dette øjeblik. Det er som et røntgenbillede af CPU'en hvert par millisekunder. Det vil se nogenlunde sådan her ud:
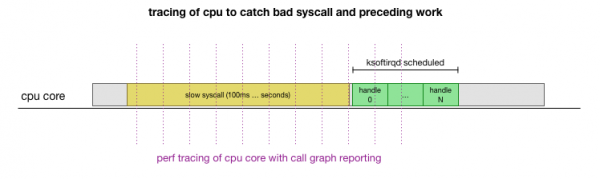
Det er praktisk, at alt dette kan gøres med eksisterende værktøjer. For eksempel, kontrollerer med jævne mellemrum en given CPU-kerne og kan generere et kaldediagram for det kørende system, inklusiv både brugerrum og Linux-kernen. Vi kan tage denne optagelse og bearbejde den med en lille fork af programmet af Brendan Gregg, som bevarer rækkefølgen af stakspor. Vi kan gemme én-linjede stakspor hvert 1 ms, og derefter fremhæve og gemme et udvalg for 100 millisekunder før det, hvor sporet når ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Her er resultaterne:
(hundreder af spor, der ser ens ud)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Der er meget at observere, men det vigtigste er, at vi finder mønsteret "cadvisor før ksoftirqd", som vi tidligere har set i ICMP-tracerne. Hvad betyder dette?
Hver linje repræsenterer en CPU-trace på et givet tidspunkt. Hver nedadgående kald i stakken adskilles med et semikolon. I midten af linjerne ser vi den kaldte systemopkald: read(): .... ;do_syscall_64;sys_read; .... Således bruger cadvisor meget tid på systemopkaldet read(), der vedrører funktionerne mem_cgroup_* (toppen af opkaldsstakken/slutningen af linjen).
I opkaldstraceringen er det ubelejligt at se, hvad der specifikt bliver læst, så lad os køre strace og se, hvad cadvisor laver, samt finde systemopkald, der tager længere tid end 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Som ventet ser vi her langsomme opkald. read(). Fra indholdet af læseoperationer og konteksten mem_cgroup er det tydeligt, at disse kald read() vedrører filen memory.stat, som viser hukommelsesforbrug og begrænsninger for cgroup (en ressourceisoleringsteknologi i Docker). Værktøjet cadvisor forespørger denne fil for at få oplysninger om ressourcernes brug i containere. Lad os undersøge, om det er kernen eller cadvisor, der gør noget uventet:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Nu kan vi genskabe fejlen og forstår, at Linux-kernen står over for en anomali.
Hvad får læseoperationen til at være så langsom?
På dette tidspunkt er det meget lettere at finde rapporter fra andre brugere om lignende problemer. Som det viste sig, blev der i cadvisor-tracker nævnt denne fejl som en , bare ingen opdagede, at forsinkelsen også tilfældigt påvirker netværksstakken. Det blev faktisk bemærket, at cadvisor forbruger mere CPU-tid end forventet, men dette blev ikke betragtet som et stort problem, da vores servere har mange CPU-ressourcer, så problemet blev ikke undersøgt grundigt.
Problemet er, at kontrolgrupper (cgroups) tager højde for hukommelsesforbruget inden for navnerummet (containeren). Når alle processer i denne cgroup afsluttes, frigiver Docker hukommelseskontrolgruppen. Men 'hukommelse' er ikke bare processens hukommelse. Selvom selve processens hukommelse ikke længere er i brug, viser det sig, at kernen stadig tildeler cacherede indhold såsom dentries og inodes (metadata for mapper og filer), som caches i memory cgroup. Fra problembeskrivelsen:
cgroups-zombier: kontrolgrupper, hvor der ikke er nogen processer, og de er blevet slettet, men der stadig er tildelt hukommelse (i mit tilfælde fra dentry-cachen, men det kan også tildeles fra sidetalleren eller tmpfs).
Kernens kontrol af alle sider i cachen, når cgroup frigives, kan være meget langsom, så en latensproces er valgt: at vente på, at disse sider bliver anmodet igen, og først når hukommelsen faktisk er nødvendig, endelig rydde cgroup. Indtil det tidspunkt tælles cgroup stadig med i statistikindsamlingen.
Set fra et præstationmæssigt perspektiv har de ofret hukommelse til fordel for ydeevnen: hurtigere indledende oprydning ved at efterlade lidt cache-hukommelse. Det er acceptabelt. Når kernen bruger den sidste del af den cachede hukommelse, bliver cgroup til sidst ryddet op, så det kan ikke kaldes en "lækage". Desværre gør den specifikke implementering af søgemekanismen, memory.stat i denne version af kernen (4.9), sammen med det enorme hukommelsesforbrug på vores servere, at det kræver meget længere tid at genoprette de seneste cachede data og rydde cgroup-zombierne.
Det viser sig, at nogle af vores noder havde så mange cgroup-zombier, at læsning og forsinkelse oversteg et sekund.
En måde at omgå cadvisor-problemet på er straks at frigive cachen af dentries/inodes i hele systemet, hvilket straks eliminerer læseforsinkelsen samt netværksforsinkelsen på værten, da fjernelsen af cachen inkluderer cachede sider fra cgroup-zombierne, som også bliver frigivet. Dette er ikke en løsning, men bekræfter årsagen til problemet.
Det viser sig, at nyere versioner af kernen (4.19+) har forbedret ydeevnen ved kaldet, memory.stat, så opgradering til denne kerne løste problemet. Samtidig havde vi værktøjer til at opdage problematiske noder i Kubernetes-klustre, elegant at skylle dem og genstarte dem. Vi gennemgik alle klustre, fandt noder med tilstrækkelig høj forsinkelse og genstartede dem. Dette gav os tid til at opdatere OS på de øvrige servere.
Sammenfattende
Da denne fejl stoppede NIC RX-køens behandling i hundredvis af millisekunder, skabte det samtidig både en stor forsinkelse ved korte forbindelser og en forsinkelse midt i forbindelsen, for eksempel mellem MySQL-forespørgsler og svarpakker.
At forstå og opretholde ydeevnen af de mest fundamentale systemer som Kubernetes er afgørende for pålideligheden og hastigheden af alle de tjenester, der kører på dem. Alle systemer, der køres, drager fordel af forbedringer i Kubernetes' ydeevne.
Kilde: habr.com
