

Jo mere kompleks et system er, jo flere alarmer opstår der. Det skaber behov for at reagere på disse alarmer, aggregere dem og visualisere dem. Jeg tror, mange kender situationen så godt, at de får nervøse tics.
Løsningen, vi vil tale om, er ikke den mest overraskende, men en ordentlig artikel om emnet kan være svær at finde.
Derfor har jeg besluttet at dele erfaringerne fra FunCorp og fortælle, hvordan vagtprocessen er opbygget, hvem der ringer, hvorfor, og hvordan man kan se på det hele.
Hvad er PagerDuty?
Så for at løse alle disse opgaver begyndte vi at lede efter et praktisk værktøj. Efter en kort søgning valgte vi PagerDuty. PD virkede som en tilstrækkelig komplet og kortfattet løsning med mange integrationer og indstillingsmuligheder. Hvad består den egentligt af?
Kort sagt, PagerDuty er en platform til håndtering af hændelser, der kan håndtere indkommende hændelser gennem forskellige integrationer, indstille vagtrækkefølgen og derefter udføre alarmering til den vagthavende ingeniør baseret på hændelsens niveau (ved højt niveau — et opkald, ved lavt — en push fra appen/sms).
Hvem er den vagthavende?
Det er nok det første, man skal begynde at indstille i PD.
I FunCorp, ligesom i andre virksomheder, er der en ærestitel som vagthavende. Den overleveres fra ingeniør til ingeniør hver dag. Der er såkaldte første og anden linje til at reagere på alarmer fra PagerDuty. Antag, at der kommer en alarm med høj prioritet, og hvis der ikke reageres på den inden for 10 minutter efter opkaldet til den vagthavende fra første linje (dvs. den ikke er blevet ændret til status anerkendt eller løst), går opkaldet videre til den anden vagthavende ingeniør. Dette indstilles i selve PagerDuty gennem Escalation Policies.
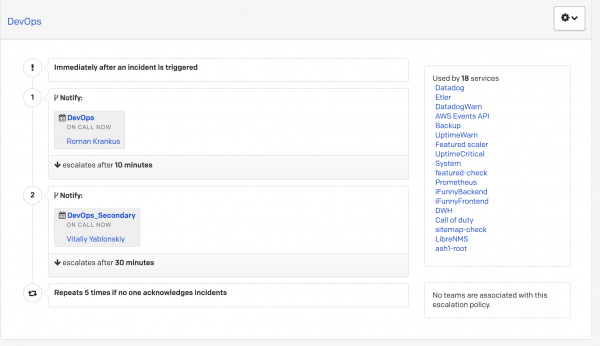
Hvis den anden vagthavende heller ikke svarer, returneres underretningen tilbage til den hoved vagthavende.
Således kan enhver indkommende alarm med høj prioritet ikke forblive ubearbejdet.
Lad os nu se, hvor indlæggene kan komme fra.
Hvilke integrationer bruger vi?
Der kommer mange forskellige hændelser fra forskellige tjenester til PD. Vi har i øjeblikket cirka 25 sådanne tjenester, og til at håndtere dem bruger vi nogle af de eksisterende integrationer.
- Prometheus
Det primære metrics indsamling system er Prometheus. Der er allerede skrevet meget om det på Habr, jeg vil blot sige, at vi har flere af dem til forskellige miljøer: en indsamler metrics fra virtuelle maskiner og Docker, en anden fra Amazons tjenester, og en tredje fra "bare metal" maskiner. Telegraf bruges primært som metrics eksportør.
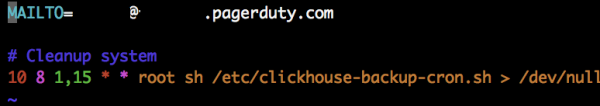
Her er det også, synes jeg, alt klart fra navnet. Denne integration bruges til at sende notificationer fra visse scripts, der køres via cron. PD giver dig en bestemt adresse, hvorefter du sender e-mails. Når du opretter en service med en sådan integration, kan du indstille prioriteter for, hvordan indkommende hændelser skal behandles, og hvordan du ønsker at oprette en alert (for hver indkommende e-mail, for en indkommende e-mail + en bestemt regel osv.).
- Slack
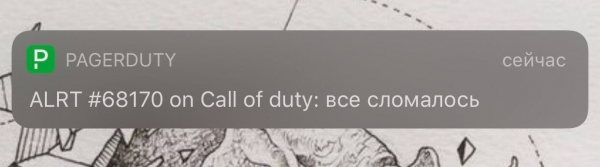
Efter min mening er det en ret interessant integration. Der forekommer situationer, hvor noget sker, men ikke dækkes af hændelser. Derfor har vi tilføjet en Slack integration til at oprette en hændelse. Det vil sige, at man kan skrive i virksomhedens Slack /callofduty все тормозит и скоро сломается og PD vil behandle dette og sende hændelsen til den on-call ingeniør.
Vi gør:
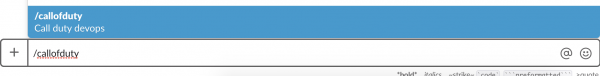
Vi ser:
- API
HTTP integration. Her, er der egentlig ikke noget særligt interessant, blot en POST-anmodning med en krop i JSON-format. For eksempel, noget interessant: vi bruger det til ekstern overvågning med hjælp fra . Denne service tjekker tilgængeligheden af vores websites fra forskellige steder i verden. Hvis vi modtager en uacceptabel svarkode (for eksempel 502), oprettes en hændelse, og så fortsætter alt som beskrevet ovenfor. I StatusCake er der mulighed for overvågning af interne URLs, udløb af SSL-certifikat eller domæne.
- LibreNMS
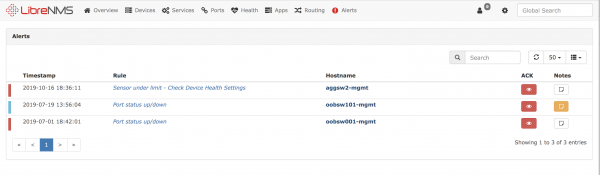
Dette er endnu et overvågningssystem, om det kan du læse mere på deres hjemmeside . Ved hjælp af det laver vi overvågning af netværksinterfaces og iDRAC fra serverne.
Der har også været sådanne integrationer som Datadog, CloudWatch. Du kan se nærmere på, hvad der er sket med dem .
Visualisering
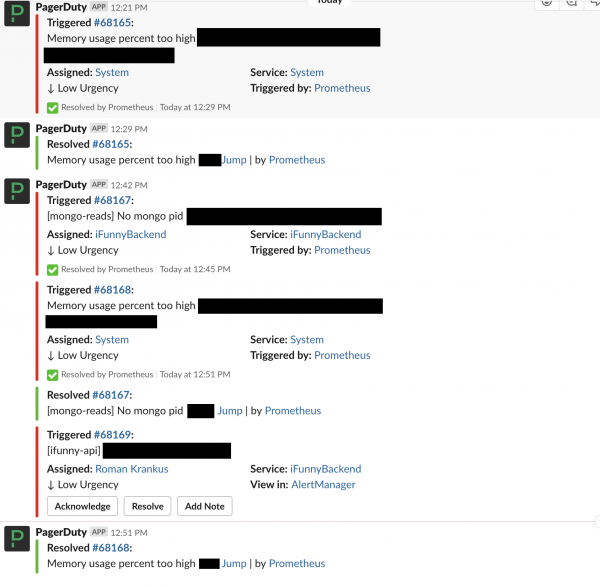
Det primære system til hændelsesmeddelelse er Slack. Alle indkommende hændelser i PD skrives i en speciel chat, og hvis deres status ændres, vises dette også i chatten.
Da muligheden for at vise nyttige data på skærme, der hænger fra loftet, pludselig opstod, indså vi (i devops-afdelingen), at vi ikke havde noget at vise på dem. Grafana er fantastisk, men den kan ikke dække det hele, og medarbejderne reagerer på alarmer, ikke på grafer.
Efter en grundig, men mislykket søgning på GitHub efter et kortfattet og informativt 'board' til PD, besluttede vi at skrive vores eget — kun med det, vi har brug for. Selvom idéen i starten var at vise selve PD-interface på skærmen, så det endnu mere besværligt ud.
For at skrive det, kræver det kun at få nøglen til PD med read-only rettigheder.
Og her er resultatet:
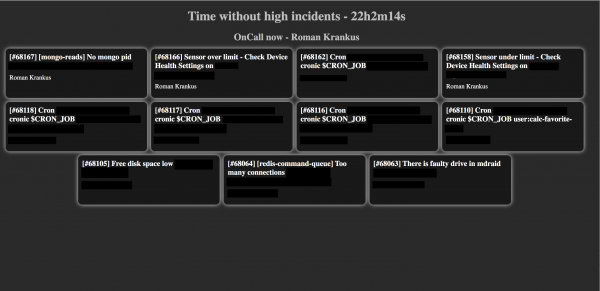
Skærmen viser aktuelle åbne hændelser, navnet på den nuværende vagthavende ingeniør fra den valgte tidsplan og tiden uden en højprioritet hændelse (panelet med højprioritet hændelsen vil blive fremhævet med rødt).
.
Resultatet er, at vi har fået et praktisk dashboard til at se alle vores hændelser. Jeg vil være glad, hvis vores erfaring kan være nyttig for nogen af jer.
Kilde: habr.com
