

Hvordan man læser denne artikel: jeg undskylder for, at teksten er blevet så lang og kaotisk. For at spare din tid starter jeg hvert kapitel med en introduktion "Hvad jeg har lært", hvor jeg i en eller to sætninger opsummerer essensen af kapitlet.
"Vis bare løsningen!" Hvis du blot ønsker at se, hvad jeg er kommet frem til, kan du gå til kapitlet "Jeg bliver mere opfindsom", men jeg mener, at det er mere interessant og nyttigt at læse om fejltagelser.
For nylig fik jeg til opgave at indstille behandlingsprocessen for et stort volumen af rå DNA-sekvenser (teknisk set er det SNP-chip). Jeg skulle hurtigt hente data om en given genetisk lokalitet (som kaldes SNP) til efterfølgende modellering og andre opgaver. Ved hjælp af R og AWK lykkedes det mig at rense og organisere dataene på en naturlig måde, hvilket væsentligt accelerationer forespørgselsbehandlingen. Det var en udfordring og krævede mange iterationer. Denne artikel vil hjælpe dig med at undgå nogle af mine fejl og vise, hvad jeg til sidst opnåede.
For at begynde med nogle indledende forklaringer.
Data
Vores universitetets center for genetisk informationsbehandling gav os data i form af TSV på 25 TB. Jeg modtog dem opdelt i 5 pakker, komprimeret med Gzip, hvor hver pakke indeholdt omkring 240 fire-gigabyte filer. Hver række indeholdt data for en SNP fra én person. I alt blev der sendt data om ~2,5 millioner SNP'er og ~60.000 personer. Udover SNP-information var der talrige kolonner med tal, der afspejlede forskellige egenskaber, såsom læseintensitet, hyppighed af forskellige alleler osv. Der var i alt omkring 30 kolonner med unikke værdier.
Formålet
Som i enhver datastyringsprojekt var det vigtigste at bestemme, hvordan dataene ville blive brugt. I dette tilfælde vil vi primært tilpasse modeller og arbejdsgange for SNP baseret på SNP. Det vil sige, at vi samtidigt kun har brug for data for én SNP. Jeg skulle lære at trække alle optegnelser relateret til en af de 2,5 millioner SNP'er så enkelt, hurtigt og billigt som muligt.
Hvordan man ikke gør det
Jeg citerer en passende kliché:
Jeg har ikke mislykkedes tusind gange, jeg har kun fundet tusind måder at undgå at parse en masse data i et format, der er ligetil for forespørgsler.
Første forsøg
Hvad jeg har lært: der findes ikke en billig måde at parse 25 TB ad gangen.
Da jeg lyttede til kurset "Avancerede metoder til behandling af store data" på Vanderbilt University, var jeg sikker på, at det ville være en leg. Det ville måske tage en times tid eller to at konfigurere Hive-serveren for at køre gennem alle dataene og rapportere resultatet. Da vores data opbevares i AWS S3, brugte jeg tjenesten , som gør det muligt at anvende Hive SQL-forespørgsler på S3-data. Du skal ikke konfigurere/benytte Hive-klyngen, og du betaler kun for de data, du søger efter.
Efter at have vist Athena mine data og deres format, kørte jeg nogle tests med lignende forespørgsler:
select * from intensityData limit 10;Og fik hurtigt velstrukturerede resultater. Klar.
Indtil vi prøvede at bruge dataene i praksis …
Jeg blev bedt om at trække alle oplysninger om SNP for at teste en model med den. Jeg kørte forespørgslen:
select * from intensityData
where snp = 'rs123456';
…og begyndte at vente. Efter otte minutter og over 4 TB anmodede data fik jeg et resultat. Athena opkræver betaling for mængden af fundne data, $5 pr. terabyte. Så denne enkeltforespørgsel kostede $20 og otte minutters ventetid. For at køre modellen på alle data skulle jeg have ventet 38 år og betalt $50 millioner. Åbenlyst, det var ikke en løsning for os.
Vi skulle bruge Parquet …
Hvad jeg har lært: vær forsigtig med størrelsen på dine Parquet-filer og deres organisering.
Først forsøgte jeg at rette op på situationen ved at konvertere alle TSV til . De er velegnede til arbejde med store datasæt, fordi informationen gemmes i kolonneformat: hver kolonne ligger i sit eget segment af hukommelse/disk, i modsætning til tekstfiler, hvor rækker indeholder elementer fra hver kolonne. Og hvis du skal finde noget, er det tilstrækkeligt blot at læse den nødvendige kolonne. Desuden er der i hver fil et intervalsæt af værdier i kolonnen, så hvis den søgte værdi ikke er inden for intervallet for kolonnen, vil Spark ikke spilde tid på at scanne hele filen.
Jeg kørte en simpel opgave til at konvertere vores TSV til Parquet og uploadede nye filer til Athena. Det tog cirka 5 timer. Men da jeg kørte forespørgslen, tog det omtrent lige så lang tid og lidt færre penge. Problemet er, at Spark, i forsøget på at optimere opgaven, blot udpakkede en TSV-chunk og lagde den i sin egen Parquet-chunk. Og fordi hver chunk var ret stor og indeholdt komplette poster fra mange personer, indeholdt hver fil alle SNP'er, så Spark måtte åbne alle filer for at udtrække den nødvendige information.
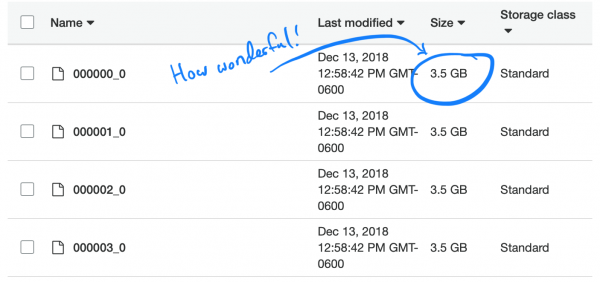
Det er interessant, at den anvendte kompressionstype i Parquet – snappy – ikke er delbar (splitable). Derfor hængte hver executor fast i opgaven med at udpakkes og indlæse den fulde datasæt på 3,5 GB.
Lad os se nærmere på problemet
Hvad jeg har lært: sortering er kompliceret, især hvis data er distribueret.
Jeg troede, jeg nu forstod essensen af problemet. Jeg skulle bare sortere dataene efter kolonnen SNP, ikke efter folk. Så ville flere SNP'er blive gemt i en separat chunk af data, og så kunne den 'smarte' Parquet-funktion 'åbne kun hvis værdien er inden for intervallet' vise sig i fuldt omfang. Desværre viste det sig at sortere milliarder af rækker spredt over klyngen at være en udfordrende opgave.
Jeg, der tager algoritmekursus på universitetet: «Åh, ingen gider at høre om beregningskompleksiteten af alle disse sorteringsalgoritmer»
Jeg forsøger at sortere i en kolonne i en 20TB tabel: «Hvorfor tager det så lang tid?» kampe.
— Nick Strayer (@NicholasStrayer)
AWS ønsker bestemt ikke at refundere penge med undskyldningen 'Jeg er en distræt studerende'. Efter jeg kørte sortering på Amazon Glue, kørte det i 2 dage og fejlede.
Hvad med partitionering?
Hvad jeg har lært: partitioner i Spark skal være balancerede.
Derefter fik jeg idéen til at partitionere dataene i kromosomer. Der er 23 af dem (og yderligere nogle, hvis man inkluderer mitochondriel DNA og uafkodede områder).
Dette vil muliggøre opdeling af dataene i mindre portioner. Hvis jeg kun tilføjede én linje til Spark-eksportfunktionen i Glue-scriptet partition_by = "chr", vil dataene blive opdelt i buckets.
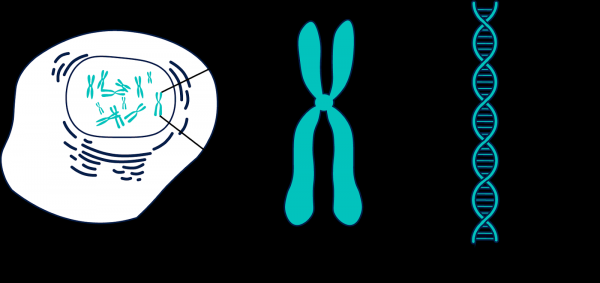
Genomet består af mange fragmenter, der kaldes kromosomer.
Desværre virkede det ikke. Kromosomerne har forskellige størrelser, hvilket betyder, at de indeholder forskellige mængder information. Det betyder, at opgaverne, som Spark sendte til arbejderne, ikke var afbalancerede og blev udført langsomt, fordi nogle noder blev færdige før andre og dermed stod stille. Opgaverne blev dog udført. Men da der blev bedt om en enkelt SNP, blev ubalancen igen et problem. Omkostningen ved at behandle SNP i de større kromosomer (dvs. der, hvor vi ønsker at hente dataene fra) blev kun reduceret med omtrent 10 gange. Meget, men ikke nok.
Hvad hvis vi deler op i endnu mindre partitioner?
Hvad jeg har lært: forsøg aldrig at lave 2,5 millioner partitioner.
Jeg besluttede at gå all in og partitionerede hver SNP. Det sikrede ens størrelse på partitionerne. DET VAR EN DÅRLIG IDE. Jeg brugte Glue og tilføjede den uskyldige linje partition_by = 'snp'. Opgaven blev startet og begyndte at køre. En dag senere tjekkede jeg og så, at der stadig ikke var skrevet noget til S3, så jeg dræbte opgaven. Det ser ud til, at Glue skrev midlertidige filer et skjult sted i S3, og der var mange filer, muligvis et par millioner. Som resultat kostede min fejl over tusinde dollars og glædede ikke min mentor.
Partitionering + sortering
Hvad jeg har lært: sortering er stadig svært, ligesom at konfigurere Spark.
Mit sidste forsøg med partitionering var at jeg partitionerede kromosomerne og derefter sorterede hver partition. I teorien skulle dette fremskynde hver forespørgsel, fordi de ønskede SNP-oplysninger skulle befinde sig inden for et par Parquet-chunks inden for det angivne interval. Desværre viste det sig at sortere selv partitionerede data var en svær opgave. Resultatet var, at jeg skiftede til EMR for en tilpasset klynge og brugte otte kraftfulde instanser (C5.4xl) og Sparklyr for at skabe en mere fleksibel arbejdsproces…
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…men opgaven blev stadig ikke udført. Jeg konfigurerede på alle mulige måder: jeg øgede hukommelsen for hver opgaveudfører, brugte noder med større hukommelse, anvendte broadcast-variabler, men hver gang endte det med at være halvmidler, og gradvist begyndte udførerne at fejle, indtil det hele stoppede.
Update: så begynder det.
— Nick Strayer (@NicholasStrayer)
Jeg bliver mere opfindsom
Hvad jeg har lært: nogle gange kræver særlige data særlige løsninger.
Hver SNP har en positionsværdi. Det er et tal, der svarer til antallet af baser langs dens kromosom. Dette er en god og naturlig måde at organisere vores data på. Først ville jeg partitionere efter områderne af hvert kromosom. For eksempel positioner 1 - 2000, 2001 - 4000 osv. Men problemet er, at SNP'er er ujævnt fordelt på kromosomerne, så størrelsen på grupperne vil variere meget.
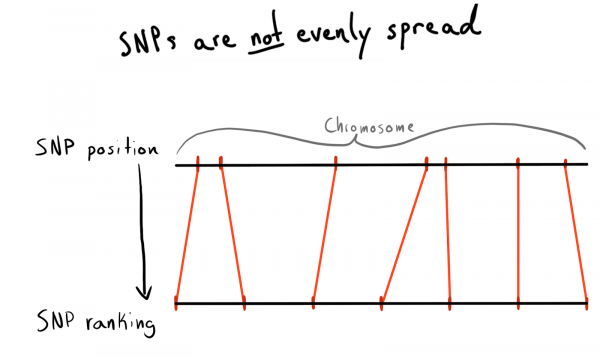
Som et resultat kom jeg til opdelingen efter kategorier (rank) af positioner. På de allerede indlæste data kørte jeg en forespørgsel for at få en liste over unikke SNP'er, deres positioner og kromosomer. Derefter sorterede jeg dataene inden for hvert kromosom og samlede SNP'er i grupper (bin) af en bestemt størrelse. Lad os sige, 1000 SNP'er. Dette gav mig en forbindelse mellem SNP'er og gruppen i kromosomet.
Til sidst lavede jeg grupper (bin) med 75 SNP'er, årsagen vil jeg forklare nedenfor.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
Første forsøg med Spark
Hvad jeg har lært: sammenlægning i Spark fungerer hurtigt, men partitionering er stadig dyr.
Jeg ville læse dette lille (2,5 millioner rækker) dataframe ind i Spark, sammenlægge det med rådataene og derefter partitionere efter den nyligt tilføjede kolonne bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Jeg har brugt sdf_broadcast(), så Spark ved, at han skal sende dataframen til alle noder. Dette er nyttigt, hvis dataene er små, og de er nødvendige for alle opgaver. Ellers forsøger Spark at være smart og distribuerer data efter behov, hvilket kan føre til stød.
Og igen virkede min idé ikke: opgaverne kørte et stykke tid, afsluttede sammenlægningen, og derefter, ligesom de startede med partitionering, begyndte de at fejle.
Jeg tilføjer AWK
Hvad jeg har lært: sov ikke, når du får undervisning i grundlæggende. Der er sikkert nogen, der har løst dit problem allerede i 1980'erne.
Indtil dette punkt var årsagen til alle mine fiaskoer med Spark sammenblandingen af data i klyngen. Måske kan situationen forbedres med forbehandling. Jeg besluttede at prøve at dele rå tekstdata op i kromosomkolonner, i håbet om at give Spark 'forbehandlede' data.
Jeg søgte på StackOverflow, hvordan man opdeler efter kolonneværdier, og fandt Med AWK kan du opdele en tekstfil baseret på kolonneværdier ved at udføre optagelser i scriptet i stedet for at sende resultaterne til stdout.
Som et eksperiment skrev jeg et Bash-script. Jeg downloadede en af de pakkede TSV-filer og udpakke den med hjælp af gzip og sendte det til awk.
gzip -dc vej/til/chunk/fil.gz |
awk -F 't'
'{print $1",..."$30">"chunked/"$chr"_chr"$15".csv"}'
Det virkede!
Udfyldning af kerner
Hvad jeg har lært: gnu parallel er en magisk ting, alle bør bruge det.
Opdelingen skete ret langsomt, og da jeg kørte htop, for at tjekke brugen af den kraftfulde (og dyre) EC2-instans, viste det sig, at jeg kun brugte en kerne og ca. 200 MB hukommelse. For at løse opgaven og ikke miste penge, var jeg nødt til at finde ud af, hvordan jeg kunne parallelisere arbejdet. Heldigvis fandt jeg i den helt fantastiske bog af Jeron O. Jonsson et kapitel, der omhandlede parallelisering. Der lærte jeg om gnu parallel, en meget fleksibel metode til implementering af multithreading i Unix.
Da jeg kørte opdelingen med den nye proces, fungerede alt fint, men der var et flaskehals — download af S3-objekter til disk var ikke særlig hurtigt og ikke helt paralleliseret. For at løse dette gjorde jeg følgende:
- Jeg fandt ud af, at jeg kunne implementere S3-downloadet direkte i røret, hvilket helt udelukkede mellemopbevaring på disken. Det betyder, at jeg kunne undgå at skrive rådata til disken og i stedet bruge et endnu mindre og dermed billigere lager på AWS.
- Med kommandoen
aws configure set default.s3.max_concurrent_requests 50øgede jeg kraftigt antallet af tråde, som AWS CLI bruger (standard er 10). - Jeg skiftede til en netværksoptimeret EC2-instans med et n i navnet. Jeg fandt ud af, at tabet af computerkraft ved brug af n-instansen blev mere end opvejet af den øgede downloadhastighed. Til de fleste opgaver brugte jeg c5n.4xl.
- Jeg ændrede
gzipog få en fungerende kommando. , det er et gzip-værktøj, der kan gøre nogle fantastiske ting til at parallelisere en oprindeligt ikke-parallel opgave med filudpakning (det var den mindste hjælp).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Disse trin kombineres med hinanden, så alt fungerer meget hurtigt. På grund af den øgede downloadhastighed og fraværet af skrivning til disk kunne jeg nu behandle et 5-terabyte batch på blot et par timer.
Der er ikke noget sødere end at se alle de kerner, du betaler for på AWS, blive brugt. Takket være gnu-parallel kan jeg udpakkede og opdele en 19 gig csv lige så hurtigt, som jeg kan downloade den. Jeg kunne ikke engang få Spark til at køre det.
— Nick Strayer (@NicholasStrayer)
Denne tweet skulle have nævnt 'TSV'. Desværre.
Brug af nyparsers data
Hvad jeg har lært: Spark elsker ukomprimerede data og bryder sig ikke om at kombinere partitioner.
Nu lå dataene i S3 i et ukomprimeret (læs: delbart) og halvordnet format, og jeg kunne vende tilbage til Spark. Jeg blev mødt med en overraskelse: Jeg kunne igen ikke opnå det ønskede! Det var meget svært at fortælle Spark nøjagtigt, hvordan dataene var partitionerede. Og selv når jeg gjorde det, viste det sig, at der var for mange partitioner (95.000), og da jeg med coalesce reducerede antallet til rimelige niveauer, ødelagde det min partitionering. Jeg er sikker på, at det kan rettes, men efter et par dages søgning kunne jeg ikke finde en løsning. Til sidst fik jeg udført alle opgaverne i Spark, selvom det tog lidt tid, og mine delte Parquet-filer var ikke særlig små (~200 kb). Men dataene lå der, hvor de skulle.
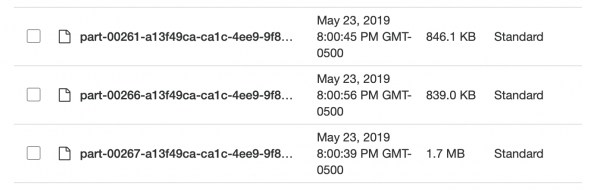
For små og uens, vidunderligt!
Test af lokale Spark-forespørgsler
Hvad jeg har lært: Der er for meget overhead i Spark ved udførelse af enkle opgaver.
Ved at indlæse data i et gennemtænkt format, kunne jeg teste hastigheden. Jeg satte et script på R til at køre en lokal Spark-server, og derefter indlæste jeg et Spark-dataframe fra det angivne Parquet-gruppelager (bin). Jeg prøvede at indlæse alle dataene, men kunne ikke få Sparklyr til at genkende partitioneringen.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Start en timer
start_time <- Sys.time()

# Indlæs det ønskede bin i Spark
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Underudtag bin til snp og så indsamle til lokalt
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
Udførelsen tog 29,415 sekunder. Meget bedre, men ikke godt nok til massiv test af noget. Desuden kunne jeg ikke accelerere arbejdet ved hjælp af caching, fordi når jeg forsøgte at cache dataframen i hukommelsen, crashede Spark altid, selv når jeg tildelte mere end 50 GB hukommelse til datasættet, der vejede mindre end 15.
Tilbage til AWK
Hvad jeg har lært: Associative arrays i AWK er meget effektive.
Jeg vidste, at jeg kunne opnå højere hastighed. Jeg kom til at tænke på den fantastiske Jeg læste om en cool funktion, der hedder “”. I essensen er det nøgle-værdi-par, som af en eller anden grund i AWK blev kaldt noget andet, og derfor har jeg ikke rigtig tænkt på dem. mindede mig om, at termen “associerende arrays” er meget ældre end termen “nøgle-værdi-par”. Selv hvis du , vil du ikke finde den term der, men derimod associerende arrays! Desuden er “nøgle-værdi-par” oftest forbundet med databaser, så det giver meget mere mening at sammenligne med hashmap. Jeg indså, at jeg kan bruge disse associerende arrays til at forbinde mine SNP'er med gruppetabellen (bin table) og de rå data uden at anvende Spark.
Til dette brugte jeg i AWK-scriptet blokken BEGIN. Det er et kodefragment, som udføres, før den første datalinje sendes til hoveddelen af scriptet.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Kommandoen while(getline...) indlæste alle rækker fra CSV-gruppen (bin), satte den første kolonne (navn på SNP) som nøgle til det associerende array bin og den anden værdi (gruppe) som værdien. Derefter i blokken { }, som udføres for alle rækker i hovedfilen, sendes hver række til uddatafilen, som får et unikt navn afhængigt af dens gruppe (bin): ..._bin_"bin[$1]"_....
Variabler batch_num og chunk_id svarende til de data, der blev leveret af pipelinen, hvilket gjorde det muligt at undgå race-forhold, og hver kørselsstrøm, der blev startet parallel, skrev til sin egen unikke fil.
Da jeg havde organiseret alle de rå data i mapper efter kromosomer fra mit tidligere eksperiment med AWK, kunne jeg nu skrive et andet Bash-script til at behandle én kromosom ad gangen og sende dybere partitionerede data til S3.
DESIRED_CHR='13'

# Download kromosomdata fra s3 og del op i bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'læser {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Kombiner alle de parallelle proceschunk til enkle filer og upload til rds ved hjælp af R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipper bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
I scriptet er der to sektioner parallel.
I den første sektion læses data fra alle filer, der indeholder information om den ønskede kromosom, hvorefter disse data fordeles til tråde, som sorterer filerne i de relevante grupper (bin). For at undgå race-tilstande, hvor flere tråde skriver til én fil, overfører AWK filnavne til forskellige steder for dataregistrering, for eksempel chr_10_bin_52_batch_2_aa.csv. Som et resultat oprettes der mange små filer på disken (til dette brugte jeg terabyte EBS-volume).
Røret fra den anden sektion parallel går gennem grupperne (bin) og sammenfletter deres separate filer til en fælles CSV med cat, og sender dem derefter til eksport.
Oversætter til R?
Hvad jeg har lært: kan kaldes fra stdin og stdout fra R-scriptet, hvilket betyder, at det også kan bruges i røret.
I Bash-scriptet kunne du have bemærket følgende linje: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Den oversætter alle de sammensmeltede filer fra gruppen (bin) til det følgende R-script. {} er en særlig metode parallel, der indsætter enhver data, den sender til den angivne strøm, direkte ind i selve kommandoen. Muligheden {#} giver en unik ID for udførelsestrømmen, mens {%} er nummeret på jobslotten (gentages, men aldrig samtidig). En liste over alle muligheder kan findes i
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Når variablen file("stdin") overføres til readr::read_csv, indlæses data, der er oversat til R-scriptet, i et dataframe, som derefter gemmes som .rds-fil ved hjælp af aws.s3 som skrives direkte til S3.
RDS er en slags lettere version af Parquet, uden de finere funktioner fra kolonneopbevaring.
Efter afslutningen af Bash-scriptet fik jeg en bunke .rds-filer, som lå i S3, hvilket gjorde det muligt for mig at anvende effektiv kompression og indbyggede typer.
På trods af at jeg brugte langsom R, fungerede alt meget hurtigt. Det er ikke overraskende, at de stykker i R, der er ansvarlige for læsning og skrivning af data, er godt optimeret. Efter test på en mellemstor kromosom blev opgaven udført på en C5n.4xl instans på ca. to timer.
S3's begrænsninger
Hvad jeg har lært: takket være smart implementering kan S3 håndtere mange filer.
Jeg var bekymret for, om S3 ville kunne behandle det mange filer, der blev overført til den. Jeg kunne give filnavne en meningsfuld betydning, men hvordan ville S3 søge i dem?
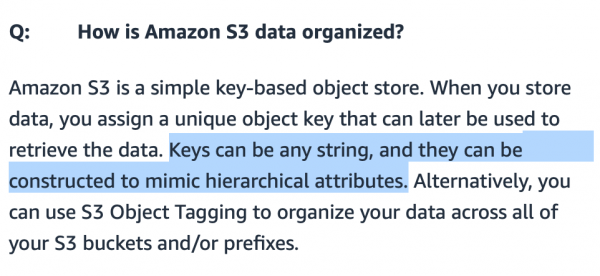
Mapper i S3 er kun for syns skyld, faktisk interesserer systemet sig ikke for symbolet /.
Det ser ud til, at S3 repræsenterer stien til en specifik fil som en simpel nøgle i en slags hash-tabel eller dokumentbaseret database. En bucket kan betragtes som en tabel, og filer som poster i denne tabel.
Da hastighed og effektivitet er vigtige for at generere profit i Amazon, er det ikke underligt, at dette "nøgle-til-fil-sti"-system er ekstremt optimeret. Jeg forsøgte at finde balancen: for ikke at skulle lave mange get-anmodninger, men stadig have hurtige anmodninger. Det viste sig, at det bedste var at lave omkring 20.000 bin-filer. Jeg tror, at hvis man fortsætter med at optimere, kan man opnå hurtigere hastigheder (for eksempel ved at lave en særlig bucket kun til data, hvilket reducerer størrelsen på opslagstabel). Men jeg havde ikke tid eller penge til flere eksperimenter.
Hvordan er det med tværkompatibilitet?
Hvad jeg har lært: Den vigtigste årsag til tabt tid er premature optimering af din lagringsmetode.
På dette tidspunkt er det meget vigtigt at stille sig selv spørgsmålet: "Hvorfor bruge et proprietært filformat?" Årsagen ligger i indlæsningshastigheden (komprimerede gzip CSV-filer tog 7 gange længere tid at indlæse) og kompatibiliteten med vores arbejdsprocesser. Jeg kan genoverveje min beslutning, hvis R let kan indlæse Parquet-filer (eller Arrow) uden byrden af Spark. I vores laboratorium bruger alle R, og hvis jeg skal omdanne data til et andet format, har jeg stadig de rå tekstdata, så jeg kan bare køre pipeline igen.
Opdeling af arbejdet
Hvad jeg har lært: forsøg ikke at optimere opgaver manuelt, lad computeren gøre det.
Jeg har justeret arbejdsflowet på én kromosom, nu skal alle de andre data behandles.
Jeg ønskede at starte flere EC2-instanser til konvertering, men samtidig var jeg bange for at få en ekstremt ubalanceret belastning mellem de forskellige behandlinger (på samme måde som Spark led under ubalancerede partitioner). Desuden var jeg ikke begejstret for at starte én instans pr. kromosom, fordi der er en standardgrænse på 10 instanser for AWS-konti.
Så besluttede jeg at skrive et R-script til optimering af behandlingsopgaver.
Først bad jeg S3 om at beregne, hvor meget plads hver kromosom optager i lageret.
bibliotek(aws.s3)
library(tidyverse)

chr_sizes %
  mutate(Size = as.numeric(Size)) %>%
  filter(Size != 0) %>%
  mutate(
    # Uddrag kromosom fra filnavnet
    chr = str_extract(Key, 'chr.{1,4}.csv') %>%
             str_remove_all('chr|.csv')
  ) %>%
  group_by(chr) %>%
  summarise(total_size = sum(Size)/1e+9) # Divider for at få værdi i GB


# En tibble: 27 x 2
   chr   total_size

 1 0           163.
 2 1           967.
 3 10          541.
 4 11          611.
 5 12          542.
 6 13          364.
 7 14          375.
 8 15          372.
 9 16          434.
10 17          443.
# … med 17 flere rækker
Derefter skrev jeg en funktion, der tager den samlede størrelse, blander rækkefølgen af kromosomer og deler dem op i grupper. num_jobs og rapporterer, hvor meget størrelserne på alle behandlingsopgaver varierer.
num_jobs <- 7
# Hvor stor ville hver opgave være, hvis de blev perfekt opdelt?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
    sample_frac() %>%
    mutate(
      cum_size = cumsum(total_size),
      job_num = ceiling(cum_size/job_size)
    ) %>%
    group_by(job_num) %>%
    summarise(
      job_chrs = paste(chr, collapse = ','),
      total_job_size = sum(total_size)
    ) %>%
    mutate(sd = sd(total_job_size)) %>%
    nest(-sd)
}

shuffle_job(1)


# En tibble: 1 x 2
     sd data

1  153.
Så kørte jeg tusind blandinger med purrr og valgte den bedste.
1:1000 %>%
  map_df(shuffle_job) %>%
  filter(sd == min(sd)) %>%
  pull(data) %>%
  pluck(1)
Så jeg fik et sæt opgaver med meget ens størrelser. Derefter var det bare at pakke mit tidligere Bash-script ind i en stor cirkel. til. At skrive denne optimering tog omkring 10 minutter. Og det er langt mindre, end jeg ville have brugt på manuelt at oprette opgaver i tilfælde af ubalance. Derfor mener jeg, at denne forudgående optimering ikke var en fejl.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Kode til behandling af et enkelt kromosom
fi
Til sidst tilføjer jeg en nedlukningskommando:
sudo shutdown -h now … og det hele fungerede! Ved hjælp af AWS CLI oprettede jeg instanser og gennem optionen user_data sendte jeg dem Bash-scripts til deres behandlingsopgaver. De blev udført og slukket automatisk, så jeg ikke betalte for overdreven computingkraft.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Pakker!
Hvad jeg har lært: API'en skal være enkel for enkelhedens og fleksibilitetens skyld.
Endelig fik jeg dataene på det ønskede sted og i den ønskede form. Det var tilbage at gøre processen med at bruge dataene så enkel som muligt, så mine kolleger havde det lettere. Jeg ønskede at lave et simpelt API til at oprette anmodninger. Hvis jeg beslutter mig for at skifte i fremtiden... .rds Når det gælder Parquet-filer, bør det være et problem for mig og ikke for mine kolleger. Derfor besluttede jeg mig for at lave et internt R-pakke.
Jeg har samlet og dokumenteret et meget enkelt pakke, der indeholder kun et par funktioner til adgang til data, som er bygget op omkring funktionen get_snp. Jeg har også lavet en hjemmeside til mine kolleger , så de nemt kan se eksempler og dokumentation.
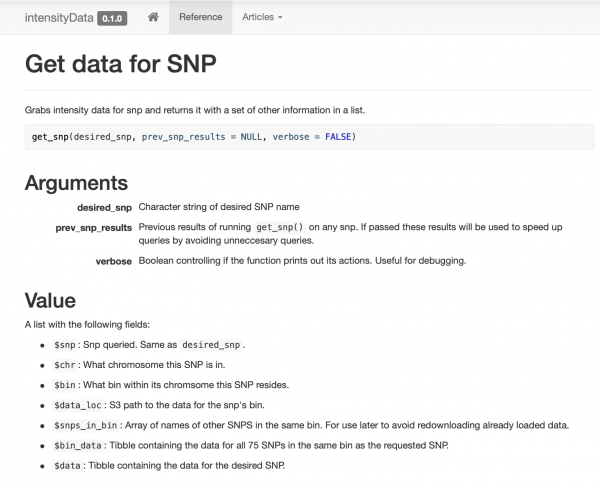
Intelligent caching
Hvad jeg har lært: hvis dine data er godt forberedt, vil caching være en leg!
Da en af de primære arbejdsprocesser anvendte den samme analysemodel på SNP-pakken, besluttede jeg mig for at bruge binning til min fordel. Når data sendes via SNP, vedhæftes al information fra gruppen (bin) til det returnerede objekt. Det vil sige, at gamle forespørgsler kan (teoretisk) fremskynde behandlingen af nye forespørgsler.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Under opbygningen af pakken kørte jeg mange benchmarks for at sammenligne hastigheden ved brug af forskellige metoder. Jeg anbefaler ikke at overse dette, da resultaterne nogle gange kan være overraskende. For eksempel, dplyr::filter var meget hurtigere end at hente rækker ved hjælp af indekseringsbaseret filtrering, og at hente en kolonne fra den filtrerede dataramme fungerede meget hurtigere end at anvende indeks-syntaksen.
Bemærk, at objektet prev_snp_results indeholder nøglen snps_in_bin. Dette er et array af alle unikke SNP i gruppen (bin), der gør det muligt hurtigt at kontrollere, om der allerede findes data fra den tidligere forespørgsel. Det forenkler også cykling gennem alle SNP i gruppen (bin) ved hjælp af denne kode:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Resultater
Nu kan vi (og er begyndt at gøre det seriøst) køre modeller og scenarier, som tidligere var utilgængelige for os. Det bedste er, at mine laboratoriekolleger ikke behøver at tænke på alle mulige komplikationer. De har bare en fungerende funktion.
Og selvom pakken fritager dem for detaljerne, forsøgte jeg at gøre dataformatet enkelt nok, så de kunne forstå det, hvis jeg pludselig forsvandt i morgen…
Hastigheden er steget mærkbart. Normalt skanner vi funktionelt betydningsfulde fragmenter af genomet. Tidligere kunne vi ikke gøre det (det blev for dyrt), men nu, takket være den binære struktur og caching, tager det i gennemsnit mindre end 0,1 sekund at forespørge en SNP, og databrugen er så lav, at omkostningerne til S3 er minimale.
For nylig blev jeg sat i charge af at håndtere 25+ TB rå genotypingsdata for mit laboratorium. Da jeg startede, tog det 8 minutter at bruge spark og kostede $20 at forespørge en SNP. Efter at have brugt AWK + til at behandle, tager det nu mindre end en tiendedel af et sekund og koster $0.00001. Min personlige sejr.
— Nick Strayer (@NicholasStrayer)
Konklusion
Denne artikel er slet ikke en vejledning. Løsningen blev individuel, og næsten helt sikkert ikke optimal. Snarere er det en fortælling om rejsen. Jeg ønsker, at andre skal forstå, at sådanne løsninger ikke opstår fuldt dannede i hovedet, men er resultatet af forsøg og fejl. Desuden, hvis du leder efter en dataanalytiker, så husk, at der kræves erfaring for effektivt at bruge disse værktøjer, og erfaring koster penge. Jeg er glad for, at jeg havde midlerne til at betale, men mange andre, der kan udføre det samme arbejde bedre end mig, vil aldrig have den mulighed på grund af mangel på penge selv til et forsøg.
Værktøjerne til store data er alsidige. Hvis du har tid, kan du næsten sikkert skrive en hurtigere løsning ved at anvende 'smart' datarensning, lager og ekstraktionsmetoder. I sidste ende handler det hele om en analyse af omkostninger og fordele.
Hvad jeg har lært:
- der findes ikke en billig måde at parse 25 TB på én gang;
- vær forsigtig med størrelsen af dine Parquet-filer og deres organisation;
- partitioner i Spark skal være afbalancerede;
- prøv aldrig at lave 2,5 millioner partitioner;
- sortering er stadig svært, lige som at konfigurere Spark;
- nogle gange kræver særlige data særlige løsninger;
- sammenlægning i Spark fungerer hurtigt, men partitionering er stadig dyrt;
- gør ikke noget andet, mens du lærer de grundlæggende; der er sikkert nogen, der allerede har løst dit problem tilbage i 1980'erne;
gnu parallel— det er en magisk ting, alle bør bruge det;- Spark elsker ukomprimerede data og kan ikke lide at kombinere partitioner;
- der er alt for meget overhead i Spark ved løsning af enkle opgaver;
- associative arrays i AWK er meget effektive;
- kan tilgås
stdinogstdoutfra R-scriptet, så det kan bruges i en pipeline; - takket være en smart implementering af S3-stier kan mange filer behandles;
- den vigtigste årsag til tidsforbrug er for tidlig optimering af din lagringsmetode;
- forsøg ikke at optimere opgaver manuelt, lad computeren gøre det;
- API'en skal være enkel for enkelhedens og brugerfleksibilitetens skyld;
- hvis dine data er godt forberedt, vil caching være let!
Kilde: habr.com
