

Hovedmålet med Patroni er at sikre høj tilgængelighed for PostgreSQL. Men Patroni er blot en skabelon og ikke et klart værktøj (som det faktisk er nævnt i dokumentationen). Ved første øjekast, når man opsætter Patroni i et testmiljø, kan man se, hvor nyttigt det er, og hvordan det nemt håndterer vores forsøg på at nedbryde klyngen. Men i praksis, i et produktionsmiljø, går det ikke altid så smukt og elegant, som i testmiljøet.
Lad mig fortælle lidt om mig selv. Jeg startede som systemadministrator. Jeg har arbejdet med webudvikling. Siden 2014 har jeg arbejdet hos Data Egret. Virksomheden beskæftiger sig med rådgivning inden for Postgres. Og vi betjener specifikt Postgres og arbejder med det hver dag, så vi har forskellig ekspertise forbundet med driften.
I slutningen af 2018 begyndte vi stille og roligt at bruge Patroni. Der er samlet erfaring, og vi har diagnosticeret det, finjusteret det og nået frem til vores bedste praksis. Og i denne præsentation vil jeg tale om dem.
Udover Postgres kan jeg også godt lide Linux. Jeg elsker at dykke ned i det og udforske det, jeg kan godt lide at kompilere kerner. Jeg elsker virtualisering, containere, Docker, Kubernetes. Alt dette interesserer mig, fordi det er præget af gamle administratorvaner. Jeg elsker at finde ud af noget om overvågning. Og jeg elsker Postgres-relaterede opgaver som administration, det vil sige replikation og backup. I min fritid skriver jeg i Go. Jeg er ikke softwareingeniør, men jeg skriver bare for min egen skyld i Go. Og jeg nyder det.
- Jeg tror, mange af jer ved, at der ikke er HA (høj tilgængelighed) i PostgreSQL som standard. For at få HA skal man installere noget, konfigurere det, lægge kræfter i det og opnå det.
- Der er flere værktøjer, og Patroni er et af dem, der løser HA på en ret cool og effektiv måde. Men når vi sætter det hele op i et testmiljø og starter det, kan vi se, at det fungerer, vi kan genskabe nogle problemer, se hvordan Patroni håndterer dem, og vi vil se, at det hele fungerer glimrende.
- Men i praksis har vi stødt på forskellige problemer. Og jeg vil tale om disse problemer.
- Jeg vil fortælle, hvordan vi diagnosticerede det, hvad vi justerede - hjalp det os eller ikke.
- Jeg vil ikke fortælle, hvordan man installerer Patroni, fordi man kan finde det på internettet, man kan se konfigurationsfilerne for at forstå, hvordan det hele startes og konfigureres. Man kan få indsigt i diagrammer og arkitekturer ved at finde information om dette online.
- Jeg vil ikke tale om andres erfaringer. Jeg vil kun fortælle om de problemer, som vi selv stod overfor.
- Jeg vil heller ikke tale om problemer, der ligger uden for Patroni og PostgreSQL. For eksempel, når vi har problemer med balancering, især hvis vores klynge falder fra hinanden, vil jeg ikke tale om det.
Og en lille disclaimer, inden jeg starter vores præsentation.
Alle de problemer, vi stod overfor, opstod i de første 6-7-8 måneder af driften. Med tiden udviklede vi vores interne best practices, og problemerne forsvandt. Så præsentationen blev planlagt for cirka et halvt år siden, da alt dette stadig var friskt i hukommelsen, og jeg huskede det klart.
Under forberedelsen til præsentationen kiggede jeg tilbage på gamle post-mortems og gennemgik logfilerne. Nogle detaljer kunne være glemt, eller nogle aspekter kunne være underforsket under analysen af problemerne, så i nogle tilfælde kan det virke, som om problemerne ikke er blevet fuldt ud behandlet, eller der mangler information. Jeg beder om tolmodighed med dette.
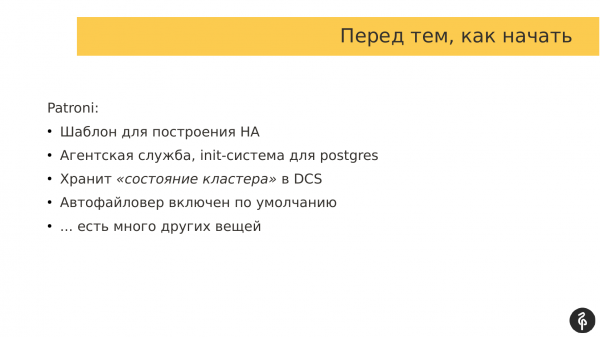
Hvad er Patroni?
- Det er en skabelon til opbygning af HA. Sådan står der i dokumentationen. Og fra mit synspunkt er det en meget korrekt præcisering. Patroni er ikke en sølvkugle, der vil løse alle dine problemer, dvs. det kræver en indsats for at få det til at fungere og bringe værdi.
- Det er en agenttjeneste, der installeres på hver tjeneste med en database, og som fungerer som en slags init-system for din Postgres. Den starter Postgres, stopper den, genstarter den, ændrer konfigurationen og ændrer topologien i din klynge.
- For at gemme tilstanden af klyngen, dens nuværende repræsentation af, hvordan den ser ud, er der brug for et lager. Fra denne synsvinkel har Patroni valgt at gemme tilstande i et eksternt system. Det er et system til distribueret konfiguration. Det kan være Etcd, Consul, ZooKeeper eller kubernetes' Etcd, altså en af disse muligheder.
- En af funktionerne ved Patroni er, at du får auto-failover direkte ud af boksen, så længe du konfigurerer det. I sammenligning med Repmgr, får du failover som en del af pakken. Med Repmgr får vi switchover, men hvis vi ønsker auto-failover, skal det konfigureres separat. Patroni har allerede auto-failover klar fra starten.
- Og der er mange andre ting. For eksempel håndtering af konfigurationer, tilføjelse af nye replikaer, sikkerhedskopiering osv. Men det ligger uden for denne præsentation, så jeg vil ikke tale om det.
Og en kort opsummering – den primære opgave for Patroni er at sikre en god og pålidelig auto-failover, så vores kluster forbliver operationelt, og applikationen ikke bemærker ændringer i klusterets topologi.
Men når vi begynder at bruge Patroni, bliver vores system en smule mere komplekst. Hvis vi tidligere havde Postgres, får vi nu både Patroni og et DCS, hvor tilstanden opbevares. Og alt dette skal fungere sammen. Hvad kan gå galt?
Her er hvad der kan gå galt:
- Postgres kan gå ned. Dette kan være enten master eller replika, en af dem kan fejle.
- Selve Patroni kan også gå ned.
- DCS kan gå ned, hvor tilstanden opbevares.
- Og netværket kan også fejle.
Jeg vil komme ind på alle disse punkter i præsentationen.
Jeg vil se på tilfælde i takt med, at de bliver mere komplekse, ikke ud fra, at sagen involverer mange komponenter. Men ud fra subjektive oplevelser, hvor nogle sager har været svære at analysere... og omvendt, hvor andre sager har været nemmere.
Og det første tilfælde er det enkleste. Det er når vi tager en database-kluster og på samme kluster implementerer vores DCS-lager. Dette er den mest almindelige fejl. Det er en arkitektonisk fejl, dvs. at kombinere forskellige komponenter på ét sted.
Så, der skete en failover, lad os finde ud af, hvad der var sket.
Og her er vi interesserede i, hvornår failoveren skete. Dvs. vi er interesserede i det øjeblik, hvor der skete en ændring i klusterets tilstand.
Men failover er ikke altid øjeblikkelig, d.v.s. det tager ikke en bestemt tid; det kan tage lidt længere, og det kan vare ved.
Derfor har det en starttid og en sluttid, dvs. det er en langvarig begivenhed. Vi opdeler alle begivenheder i tre intervaller: vi har tid før failover, under failover og efter failover. Dvs. vi ser på alle begivenheder på denne tidslinje.
Og det første, vi gør, når failover sker, er at finde årsagen, hvad der skete, der førte til failover.
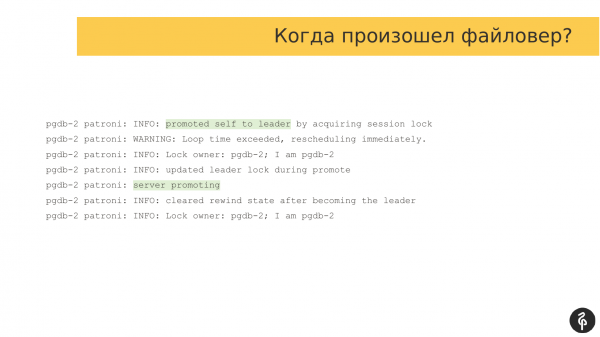
Hvis vi ser på loggene, vil det være de klassiske Patroni-logs. Her fortæller den os, at serveren blev master, og rollen som master blev overført til denne node. Dette er fremhævet.
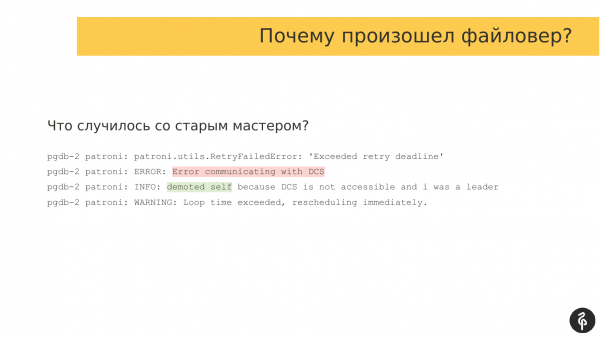
Dernæst skal vi forstå, hvorfor failover skete, dvs. hvilke begivenheder der fik rollen som master til at flytte fra en node til en anden. Og i dette tilfælde er det ret simpelt. Vi har en fejl i interaktionen med opbevaringssystemet. Masteren forstod, at den ikke kunne arbejde med DCS, dvs. der opstod et eller andet problem med interaktionen. Og den siger, at den ikke længere kan være master og fratræder sine beføjelser. Denne linje 'demoted self' siger netop dette.
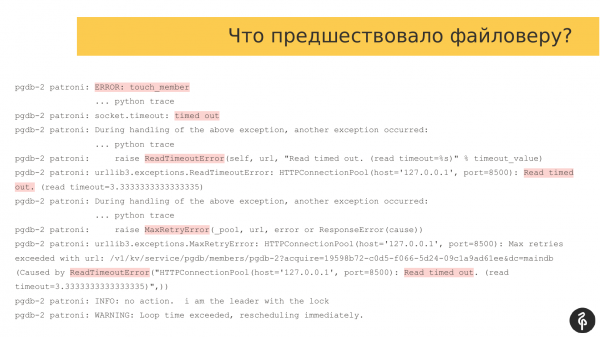
Hvis vi ser på de begivenheder, der gik forud for failover, kan vi se de samme årsager, der var problemet for fortsættelsen af masterens arbejde.
Hvis vi ser på Patroni-loggene, ser vi, at vi har en masse fejl, timeouts, dvs. Patroni-agenten kan ikke arbejde med DCS. I dette tilfælde er det Consul-agenten, som kommunikerer via port 8500.
Og problemet her er, at Patroni og databasen kører på samme vært. Og på denne node kørte også Consul-serverne. Ved at skabe belastning på serveren skabte vi problemer for servere Consul. De kunne ikke kommunikere ordentligt.
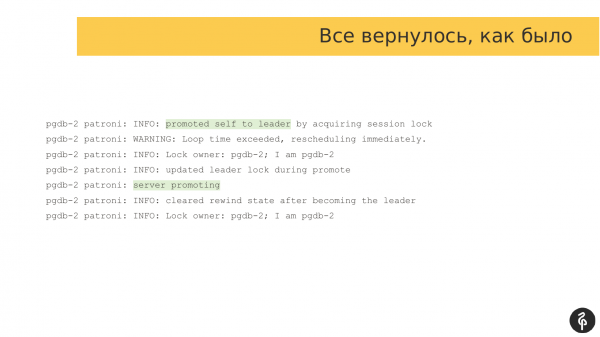
Efter lidt tid, når belastningen faldt, kunne vores Patroni igen kommunikere med agenterne. Den normale drift genoptog. Og den samme server Pgdb-2 blev igen master. Dvs. der var et lille flip, der fik noden til at fratræde sine masterbeføjelser, og derefter tog den dem tilbage, dvs. alt blev som før.
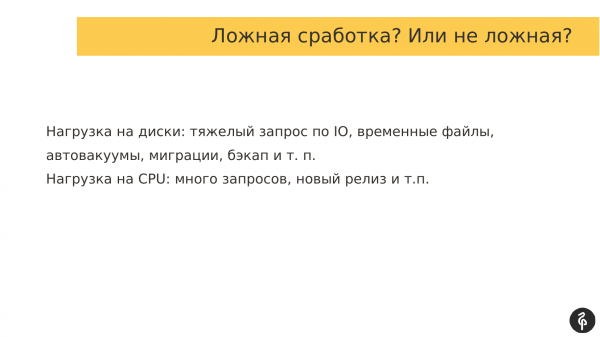
Og dette kan betragtes som en falsk udløser, eller det kan ses som om, at Patroni gjorde det rigtige. Dvs. den forstod, at den ikke kunne opretholde tilstanden i klyngen og fratrådte sine beføjelser.
Og problemet opstod, fordi Consul-serverne er på det samme udstyr som databaserne. Derfor påvirker enhver belastning, hvad enten det er belastning på diske eller processorer, også interaktionen med Consul-klusteret.
Og vi besluttede, at det ikke skulle være sammen, så vi oprettede et separat kluster til Consul. Patroni arbejdede allerede med en separat Consul, dvs. der var et separat Postgres-kluster og et separat Consul-kluster. Dette er en grundlæggende vejledning i, hvordan man skal adskille og holde disse ting, så de ikke lever sammen.
Som et alternativ kan man justere parametrene ttl, loop_wait, retry_timeout, dvs. forsøge at overleve de kortvarige belastningsspidser ved at øge disse parametre. Men det er ikke den mest hensigtsmæssige løsning, fordi denne belastning kan være langvarig. Og vi vil simpelthen overskride grænserne for disse parametre. Og det kan muligvis ikke hjælpe.
Det første problem, som du forstår, er simpelt. Vi lagde DCS sammen med databasen og fik dermed et problem.
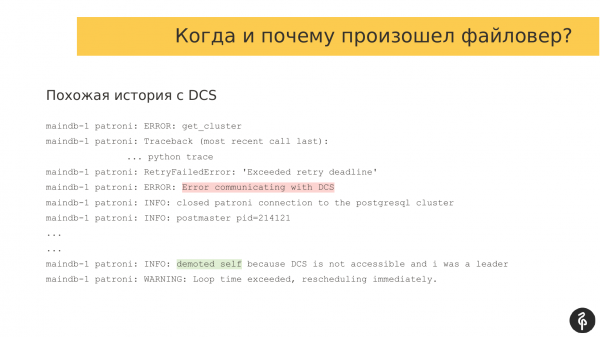
Det andet problem ligner det første. Det ligner ved, at vi endnu en gang har problemer med interaktionen med DCS-systemet.
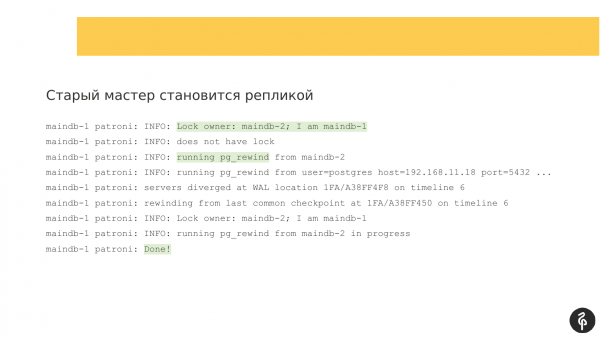
Hvis vi ser på loggene, vil vi se, at vi igen har en kommunikationsfejl. Og Patroni siger, at jeg ikke kan interagere med DCS, så den nuværende master skifter til replika-tilstand.
Den gamle master bliver en replika, her virker Patroni som forventet. Den kører pg_rewind for at spole transaktionsjournalen tilbage og derefter forbinder til den nye master og indhenter den nye master. Her fungerer Patroni som han skal.
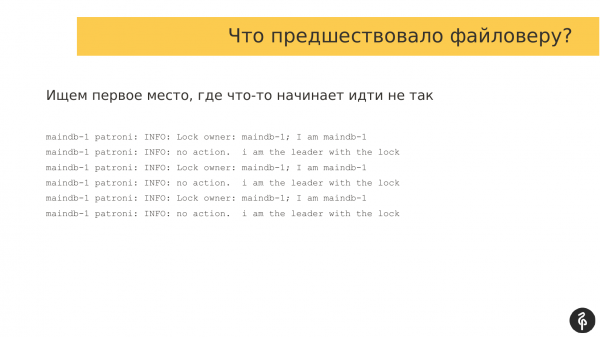
Her skal vi finde det sted, der forudgik filevågeren, dvs. de fejl, der forårsagede, at vi fik en filevåger. Og i den henseende er det ret nemt at arbejde med loggene i Patroni. Den skriver de samme meddelelser med bestemte intervaller. Og hvis vi begynder hurtigt at spole gennem disse logs, vil vi se i loggene, at loggene har ændret sig, hvilket betyder, at der er begyndt at opstå problemer. Vi går hurtigt tilbage til det sted, ser hvad der foregår.
Og i en normal situation ser loggene omtrent sådan ud. Ejeren af låsen tjekkes. Og hvis ejeren for eksempel er skiftet, kan der opstå nogle begivenheder, som Patroni skal reagere på. Men i dette tilfælde er alt i orden. Vi leder efter det sted, hvor fejlene begyndte.
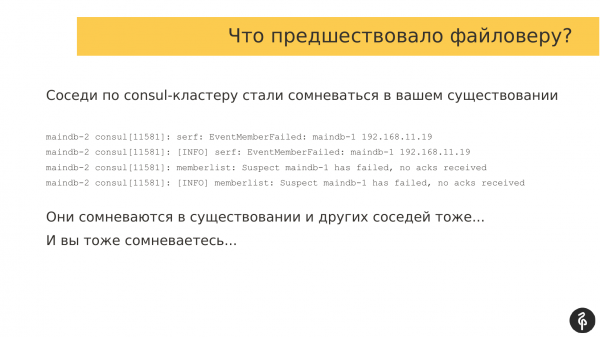
Og når vi ruller tilbage til det punkt, hvor fejlene begyndte at opstå, ser vi, at der skete en auto-failover. Da vores fejl var relateret til interaktionen med DCS, og i vores tilfælde brugte vi Consul, ser vi også i Consul-loggene, hvad der skete der.
Ved omtrent at matche tiden for failoveren med tiden i Consul-loggene ser vi, at vores naboer i Consul-klusteret begyndte at tvivle på eksistensen af andre medlemmer af Consul-klusteret.
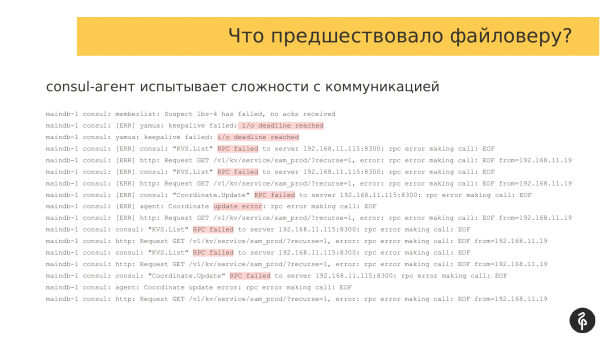
Og hvis vi kigger på loggene fra andre Consul-agenter, kan vi også se, at der sker en form for netværks-kollaps. Og alle medlemmer af Consul-klusteret tvivler på hinandens eksistens. Og dette var en katalysator for failoveren.
Hvis vi ser på, hvad der skete før disse fejl, kan vi se, at der har været forskellige fejl, for eksempel deadline og RPC fejl, det vil sige, der er tydeligvis et problem med interaktionen mellem medlemmerne af Consul-klusteret.
Det simpleste svar er at reparere netværket. Men for mig, som står på talerstolen, er det nemt at sige. Men forholdene er sådan, at kunden ikke altid har mulighed for at reparere netværket. De kan være i datacentret og have begrænsede muligheder for at reparere netværket eller påvirke udstyret. Så derfor er der behov for andre løsninger.
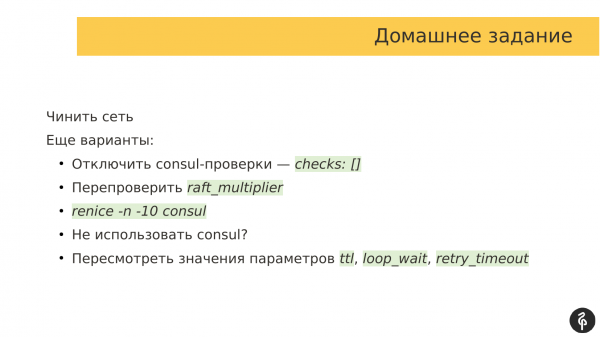
Der er muligheder:
- Den simpleste løsning, som endda er beskrevet i dokumentationen, er at deaktivere Consul-tjek, det vil sige simpelthen at sende et tomt array. Og vi beder Consul-agenten om ikke at bruge nogen tjek. Ved hjælp af disse tjek kan vi ignorere disse netværksstorme og undgå at initiere failover.
- En anden mulighed er at genchecke raft_multiplier. Dette er en parameter for selve Consul-serveren. Som standard er den sat til 5. Dette niveau anbefales i dokumentationen til staging-miljøer. I bund og grund påvirker det frekvensen af beskedudveksling mellem medlemmerne af Consul-netværket. Denne parameter påvirker i princippet hastigheden af kommunikation mellem medlemmerne af Consul-klusteret. Og for produktion anbefales det allerede at sænke det, så noderne oftere udveksler beskeder.
- En anden mulighed, vi er begyndt at bruge, er at øge prioriteten af Consul-processerne blandt de øvrige processer for operativsystemets procesplanlægger. Der er en parameter kaldet "nice", som netop definerer prioriteten for processerne, der tages i betragtning af OS-planlæggeren ved planlægning. Vi har sænket nice-værdien for Consul-agenterne, altså hævet prioriteten, så operativsystemet giver Consul-proceserne mere tid til at arbejde og udføre deres kode. I vores tilfælde løste det vores problem.
- En anden mulighed er ikke at bruge Consul. Jeg har en ven, der er stor tilhænger af Etcd. Og vi skændes regelmæssigt om, hvad der er bedre, Etcd eller Consul. Men når det kommer til hvad der er bedst, er vi normalt enige om, at Consul har en agent, der skal køre på hver node med databasen. Det vil sige, at interaktionen mellem Patroni og Consul-klusteret foregår gennem denne agent. Og denne agent bliver et flaskehals. Hvis der sker noget med agenten, kan Patroni ikke længere arbejde med Consul-klusteret. Og det er et problem. I forhold til Etcd er der ingen agent. Patroni kan arbejde direkte med listen af Etcd-servere og kommunikere med dem. På den måde, hvis I bruger Etcd i jeres virksomhed, vil Etcd nok være det bedste valg frem for Consul. Men hos vores kunder er vi altid begrænset af, hvad kunden har valgt at bruge. Og for det meste har alle kunder Consul.
- Og det sidste punkt er at gennemgå parameterne. Vi kan hæve disse parametre i en større retning i håbet om, at vores kortvarige netværksproblemer vil være korte og ikke overstige intervallet for disse parametre. På den måde kan vi mindske Patronis aggressivitet ved udførelsen af automatiserede failovers, hvis der opstår netværksproblemer.
Jeg tror, at mange, der bruger Patroni, er bekendt med denne kommando.
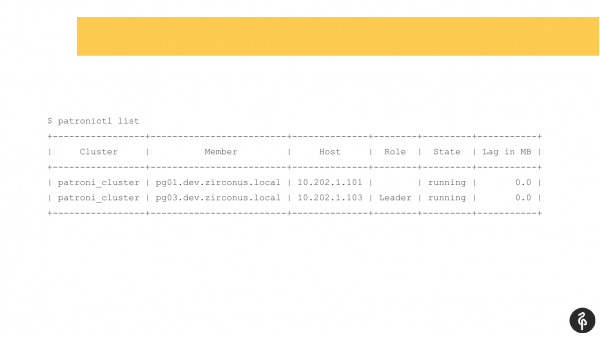
Denne kommando viser den aktuelle tilstand af klusteret. Og ved første øjekast kan dette billede se normalt ud. Vi har en master, vi har en replika, der er ingen replikationslag. Men dette billede er normalt kun indtil vi ved, at der skal være tre noder i dette kluster, ikke kun to.
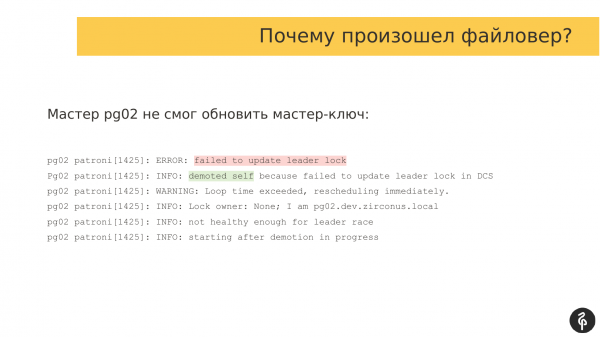
Derfor blev auto-failover aktiveret. Efter dette auto-failover mistede vi replikatet. Vi skal finde ud af, hvorfor det forsvandt, og få det tilbage, genskabe det. Vi går igen ind i loggene og kigger på, hvad der forårsagede auto-failover.
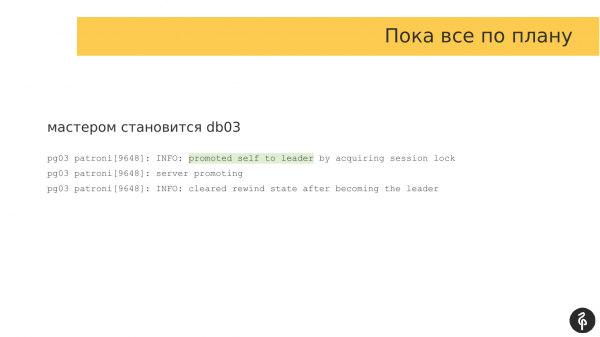
I dette tilfælde blev den anden replika master. Alt er i orden her.
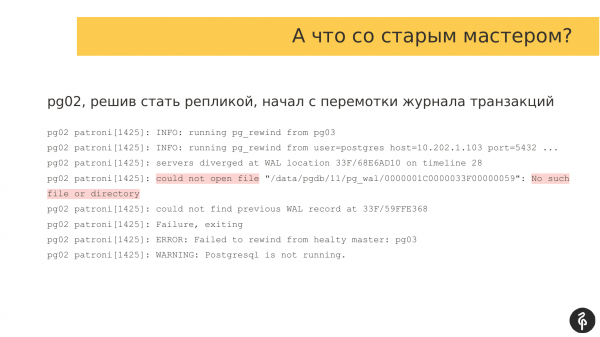
Vi skal se på replikaen, der er falmet, og som ikke er i klyngen. Vi åbner loggene fra Patroni og ser, at der opstod et problem i forbindelse med at tilslutte sig klyngen under pg_rewind. For at tilslutte sig klyngen skal vi spole transaktionsloggen tilbage, anmode om den nødvendige transaktionslog fra masteren og indhente masteren.
I dette tilfælde har vi ikke transaktionsloggen, og replikatet kan ikke starte. Derfor stopper vi Postgres med en fejl. Og derfor er den ikke i klyngen.
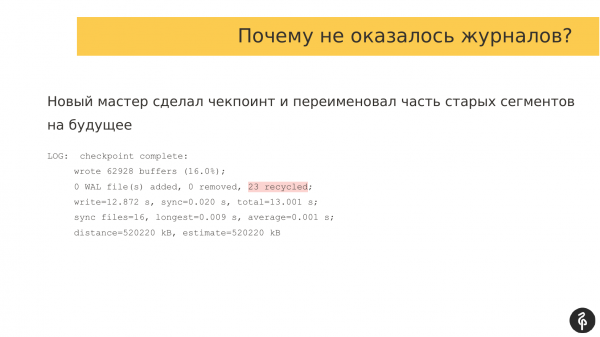
Vi skal forstå, hvorfor den ikke er i klyngen, og hvorfor der ikke var logs. Vi går til den nye master og ser, hvad der er i dens logs. Det viser sig, at da pg_rewind blev udført, opstod der et checkpoint. Og nogle af de gamle transaktionslogs blev simpelthen omdøbt. Da den gamle master forsøgte at tilslutte sig den nye master og anmode om disse logs, var de allerede blevet omdøbt, de var simpelthen ikke tilgængelige.
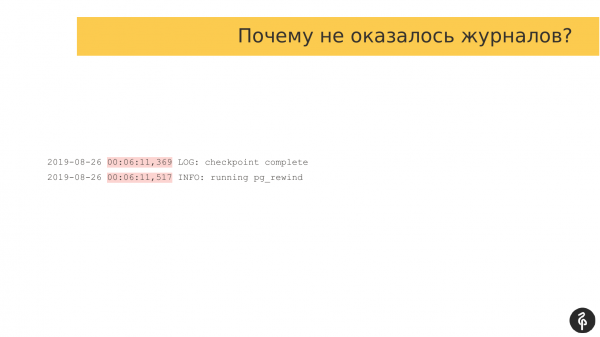
Jeg har sammenlignet tidsstempler, da disse begivenheder fandt sted. Der var kun 150 millisekunders forskel, dvs. checkpointet blev afsluttet på 369 millisekunder, og WAL-segmenterne blev omdøbt. Og blot 517 millisekunder senere, efter 150 millisekunder, blev rewind startet på den gamle replika. Dvs. vi havde bogstaveligt talt brug for 150 millisekunder for at sikre, at replikatet ikke kunne tilslutte sig og komme i gang.
Den dyreste og mest omfattende løsning er Redis-Enterprise. Dette er en pakkeløsning med fuld teknisk support. Selvom det ser ideelt ud fra en teknisk synsvinkel, var det ikke passende for os af ideologiske årsager.
Vi brugte oprindeligt replikationsslots. Vi troede, det var godt. Selvom vi i den første fase af driften deaktiverede slots. Vi troede, at hvis slots skulle samle mange WAL-segmenter, kunne vi bringe masteren ned. Den ville falde. Vi kæmpede et stykke tid uden slots. Og vi indså, at vi havde brug for slots, så vi genoptog dem.
Men der er et problem: når masteren går over til replikaen, sletter den slots, og sammen med slots sletter den WAL-segmenter. For at undgå dette problem besluttede vi at hæve parameteren wal_keep_segments. Den er som standard 8 segmenter. Vi hævede den til 1.000 og så på, hvor meget ledig plads vi havde. Og vi gav 16 gigabyte til wal_keep_segments. Dvs. ved omstilling har vi altid en buffer på 16 gigabyte transaktionslogs på alle noder.
Og desuden – det er også relevant for længere vedligeholdelsesopgaver. Antag, at vi skal opdatere en af replikaerne. Og vi vil gerne slukke den. Vi skal opdatere softwaren, måske operativsystemet, noget andet. Og når vi slukker replikaen, slettes også slotten for denne replika. Og hvis vi bruger en lille wal_keep_segments, så når replikaen er fraværende i længere tid, vil transaktionslogfilerne blive afspillet. Vi genstarter replikaen, den vil anmode om de transaktionslogs, hvor den stoppede, men de kan være utilgængelige på masteren. Og replikaen vil heller ikke kunne tilslutte sig. Derfor holder vi en stor buffer af logs.
Vi har en produktionsdatabase. Der arbejder projekter allerede.
Der skete en filfejl. Vi gik ind og så – alt er i orden, replikaerne er på plads, der er ingen replikeringslag. Der er heller ingen fejl i logs, alt er i orden.
Produktteamet siger, at der tilsyneladende skulle være nogle data, men vi ser dem kun i en kilde, og i databasen kan vi ikke se dem. Og vi skal finde ud af, hvad der skete med dem.
Det er klart, at pg_rewind overskrev dem. Det forstod vi straks, men vi gik for at se, hvad der skete.
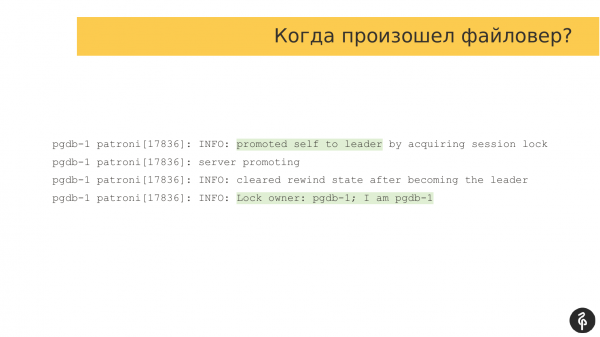
I logs kan vi altid finde ud af, hvornår filfejlen skete, hvem der blev master, og vi kan bestemme, hvem den gamle master var, og hvornår den ønskede at blive replika, dvs. vi har brug for disse logs for at afklare, hvor meget af transaktionslogs der gik tabt.
Vores gamle master genstartede. Og i autostarten blev Patroni angivet. Patroni startede. Han startede derefter Postgres. Forud for starten af Postgres og før han gjorde det til en replika, startede Patroni processen pg_rewind. Derfor slettede han en del af transaktionslogs, hentede nye og tilsluttede sig. Her arbejdede Patroni fremragende, dvs. som det skulle. Vores klynge blev gendannet. Vi havde 3 noder, efter filfejlen 3 noder – alt er fantastisk.
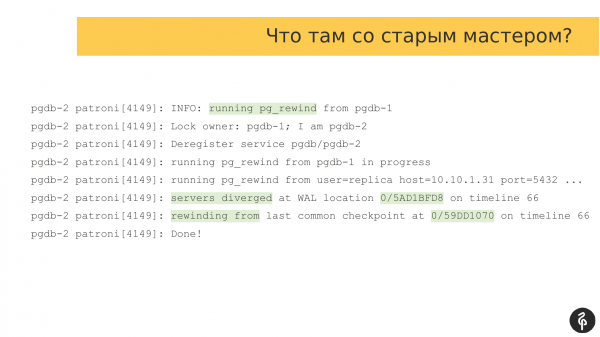
Vi har mistet en del data, og vi skal forstå, hvor meget vi har mistet. Vi leder efter det præcise tidspunkt, hvor vi havde rewind. Vi kan finde det ud fra disse logposter. Rewind blev startet, gjorde noget, og blev afsluttet.
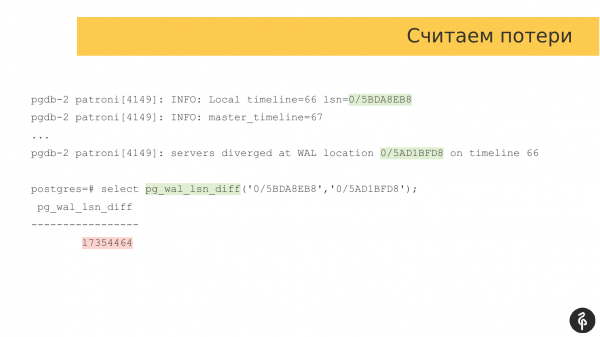
Vi skal finde den position i transaktionsloggen, hvor den gamle master stoppede. I dette tilfælde er det denne markering. Og vi har brug for den anden markering, dvs. den afstand, som adskiller den gamle master fra den nye.
Vi bruger den almindelige pg_wal_lsn_diff og sammenligner disse to markeringer. Og i dette tilfælde får vi 17 megabyte. Om det er meget eller lidt, bestemmer hver for sig. Fordi for nogen er 17 megabyte lidt, for andre er det meget og uacceptabelt. Det afhænger helt af forretningens behov.
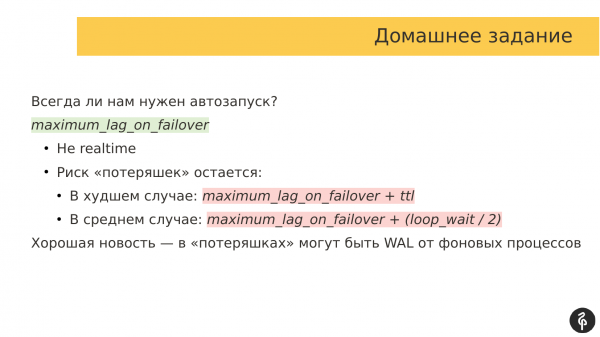
Men hvad har vi konstateret for os selv?
For det første skal vi afgøre, om vi altid har brug for automatisk opstart af Patroni efter systemgenstart. Ofte er det sådan, at vi skal tilgå den gamle master, se hvor langt den er kommet. Måske inspicere segmenterne i transaktionsloggen, se hvad der er der. Og forstå, om vi kan miste disse data, eller om vi skal starte den gamle master i standalone-tilstand for at hente disse data.
Og først derefter skal vi træffe beslutning om, hvorvidt vi kan lade disse data gå, eller om vi kan genoprette dem og tilslutte denne node som en replika i vores klynge.
Derudover er der parameteren «maximum_lag_on_failover». Som standard, hvis jeg husker korrekt, har denne parameter værdien 1 megabyte.
Hvordan fungerer det? Hvis vores replika er forsinket med 1 megabyte data i replikationslag, deltager denne replika ikke i valgene. Og hvis der pludselig sker en failover, ser Patroni på, hvilke replikas der er forsinkede. Hvis de er forsinkede med et stort antal transaktionsloger, kan de ikke blive master. Det er en meget god beskyttelsesfunktion, der forhindrer, at vi mister mange data.
Men der er et problem, at replikationslaget i Patroni-klyngen og DCS opdateres med et bestemt interval. hvis jeg ikke tager fejl, er standard ttl-værdien 30 sekunder.
Der kan være situationer, hvor replikationslag for replikaer i DCS er ét, men den faktiske lag kan være helt anderledes eller måske overhovedet ikke eksisterer, dvs. dette er ikke realtime. Og den afspejler ikke altid det virkelige billede. Det er derfor ikke værd at basere kompliceret logik på denne.
Og risikoen for datatab er altid til stede. I værste fald anvendes én formel, mens en anden formel anvendes i gennemsnitlige tilfælde. Dvs. når vi planlægger implementeringen af Patroni og vurderer, hvor mange data vi kan miste, er vi nødt til at tage højde for disse formler og have en idé om, hvor meget data vi kan miste.
Og der er gode nyheder. Når den gamle master skrider fremad, kan dette ske på grund af nogle baggrundsprocesser. Dvs. der var en autovakuum, der skrev data og gemte dem i transaktionsloggen. Disse data kan vi blot ignorere og miste. Der er ikke noget problem i det.
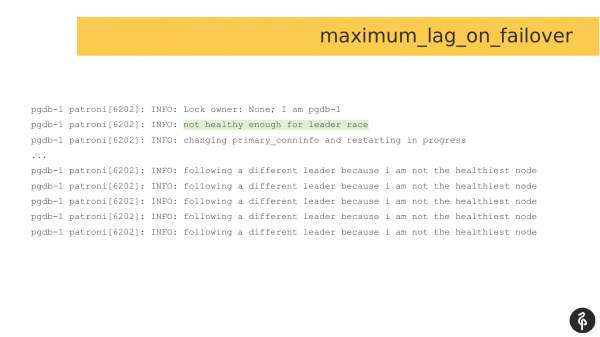
Og sådan ser loggene ud, hvis maximum_lag_on_failover er indstillet, og der er sket en failover, og det er nødvendigt at vælge en ny master. Replikatet vurderer sig selv som ude af stand til at deltage i valget. Og det nægter at deltage i kapløbet om lederskabet. Og det venter på, at en ny master bliver valgt, så det kan oprette forbindelse til denne. Dette er et yderligere skridt for at undgå datatab.
Her har vores produktteam skrevet, at deres produkt har problemer med at arbejde med Postgres. På samme tid kan man ikke tilgå selve masteren, fordi den ikke er tilgængelig via SSH. Og der sker heller ikke nogen auto-failover.
Denne host blev tvangsgenstartet. På grund af genstarten skete der en auto-failover, selvom der også kunne have været lavet en manuel auto-failover, som jeg forstår nu. Og efter genstarten går vi allerede for at se, hvad der er sket med den nuværende master.
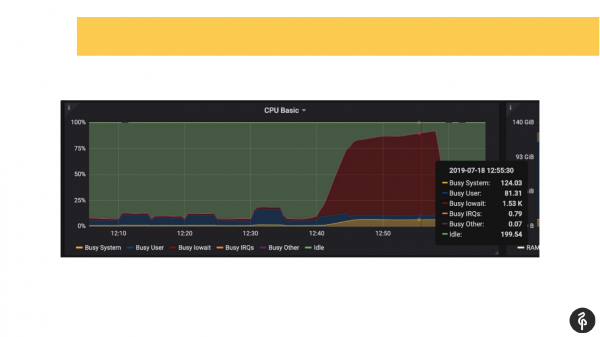
På samme tid vidste vi på forhånd, at vi havde problemer med diskene, dvs. vi vidste allerede fra overvågningen, hvor vi skulle grabe, og hvad vi skulle lede efter.
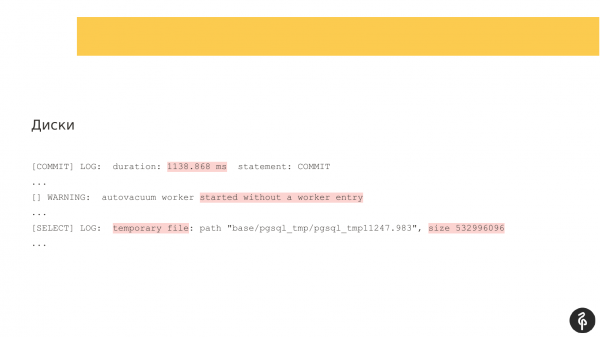
Vi gik ind i Postgres-loggen og begyndte at se, hvad der skete der. Vi så transaktioner, der tog en til tre sekunder, hvilket ikke er normalt. Vi så, at vores autovakuum startede meget langsomt og mærkeligt. Og vi så temporære filer på disken. Dvs. dette er alle indikatorer på problemer med diskene.
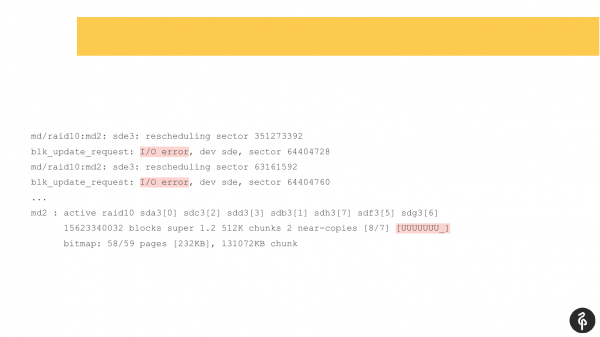
Vi kiggede i systemets dmesg (i kernel loggen). Og så, at vi har problemer med en af diske. Disk subsystemet var en software RAID. Vi kiggede i /proc/mdstat og så, at vi manglede en disk. Altså, her er der en RAID med 8 diske, og vi mangler en. Hvis man ser nærmere på slidset, kan man se, at sde mangler. Så at sige, vi har mistet en disk. Dette udløste diskproblemer, og applikationerne oplevede også problemer ved arbejdet med Postgres-klyngen.
Og i dette tilfælde ville Patroni ikke have hjulpet, fordi Patroni ikke har til opgave at overvåge serverens tilstand, diskens tilstand. Og vi skal overvåge sådanne situationer med ekstern overvågning. Vi har til den eksterne overvågning hurtigt tilføjet diskovervågning.
Og der var en tanke – kunne fencing eller en software watchdog hjælpe os? Vi mente, at det næppe ville hjælpe os i dette tilfælde, fordi under problemer fortsatte Patroni med at interagere med DCS-klyngen og så ingen problemer. Altså, fra DCS og Patronis synspunkt var alt godt med klyngen, selvom der reelt var diskproblemer og tilgængelighedsproblemer med databasen.
Efter min mening er dette et af de mærkeligste problemer, som jeg har undersøgt i lang tid, læst mange logs igennem, og jeg kaldte det klynge-simulatoren.
Problemet var, at den gamle master ikke kunne blive en normal replika, således at Patroni startede den, og Patroni viste, at denne node var til stede som replika, men samtidig var den ikke en normal replika. Nu vil du se, hvorfor. Dette har jeg gemt fra analysen af det problem.
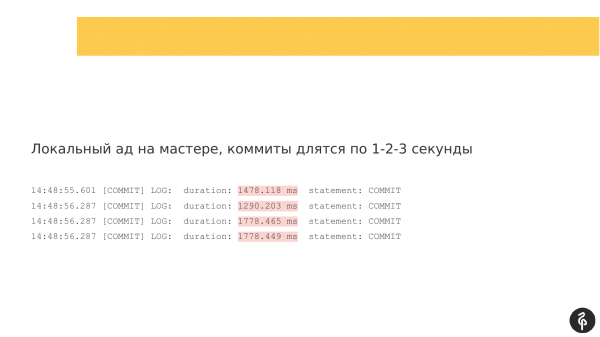
Og hvordan begyndte det hele? Det begyndte, som ved det tidligere problem, med disknedsænkninger. Vi havde kommitteringer på en eller to pr. sekund.
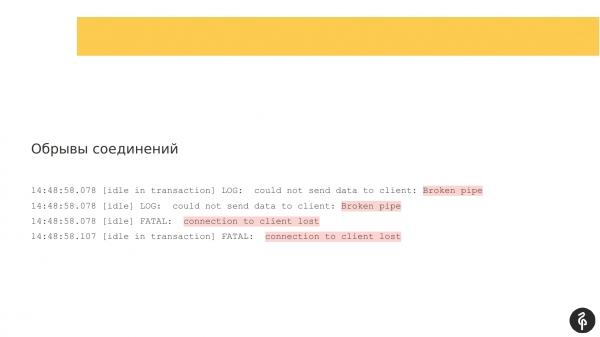
Der var forbindelsestab, dvs. klienterne blev afbrudt.
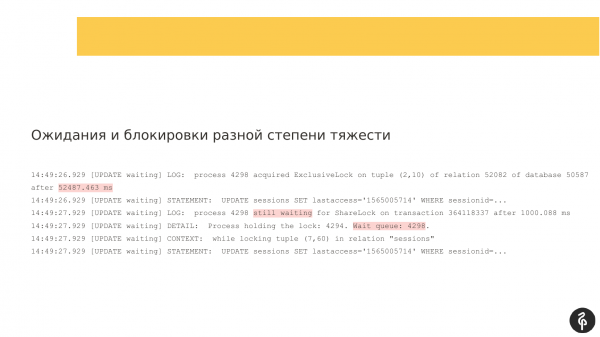
Der var låsninger af forskellig sværhedsgrad.
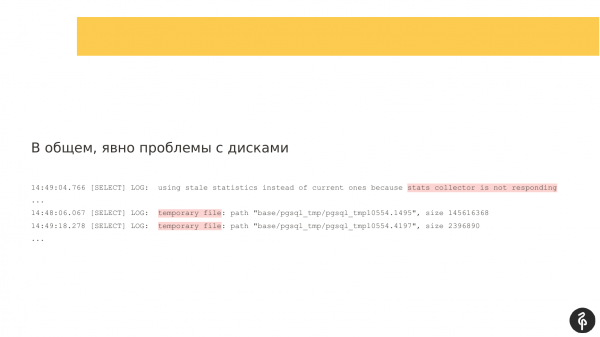
Og således var disk subsystemet ikke særlig responsivt.
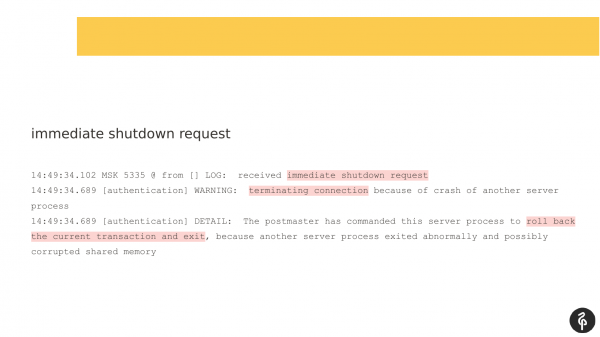
Og det mest mystiske for mig er den ankomne immediate shutdown request. Postgres har tre slukkeramode:
- Der er graceful, hvor vi venter på, at alle klienter afslutter sig selv.
- Der er fast, hvor vi tvinger klienterne til at afslutte, fordi vi går til slukning.
- Og immediate. I dette tilfælde informerer immediate ikke engang kunderne om, at de skal logge af, det logger bare af uden varsel. Alle kunder får til gengæld en meddelelse fra operativsystemet RST (TCP-meddelelse om, at forbindelsen er blevet afbrudt, og kunden ikke har noget at fange).
Hvem sendte dette signal? Baggrundsprocesserne Postgres sender ikke sådanne signaler til hinanden, dvs. dette er kill-9. De sender ikke sådanne signaler til hinanden, de reagerer kun på det, dvs. dette er en nødgenstart af Postgres. Hvem der sendte det, ved jeg ikke.
Jeg kiggede på kommandoen 'last' og så, at der var en person, der også loggede ind på denne server sammen med os, men jeg var for genert til at stille spørgsmålet. Det kunne muligvis have været kill -9. Jeg ville have set kill -9 i loggene, da Postgres skriver, at den har modtaget kill -9, men jeg så ikke dette i loggene.
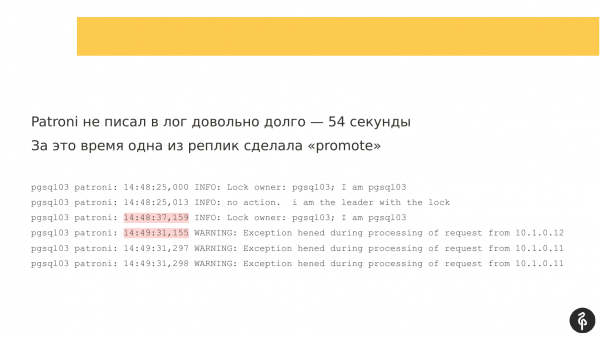
Da jeg fortsatte med at undersøge, så jeg, at Patroni ikke havde skrevet til loggen i lang tid – 54 sekunder. Og hvis man sammenligner to tidsstempler, var der her cirka 54 sekunder uden meddelelser.
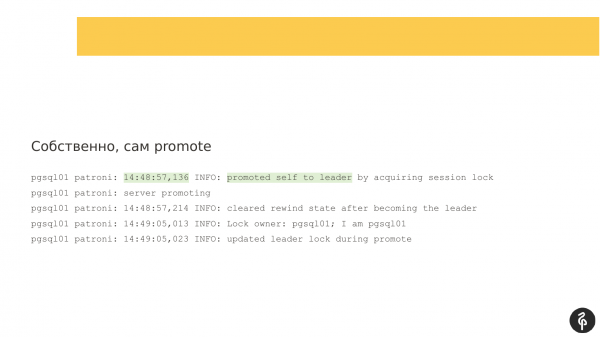
Og i denne tid skete der en auto-failover. Patroni fungerede igen perfekt. Vores gamle master var utilgængelig, noget skete der med den. Og der begyndte valg af en ny master. Her fungerede alt godt. Vores pgsql01 blev den nye leder.
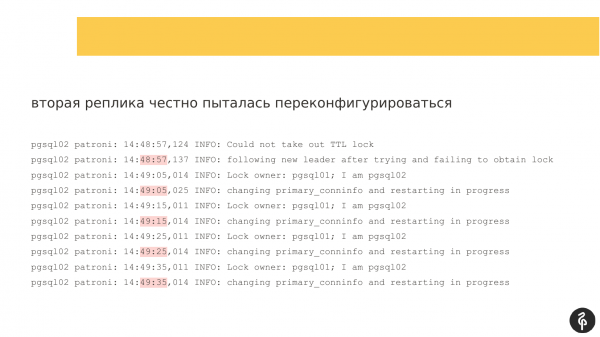
Vi har en replika, der blev master. Og der er en anden replika. Og med den anden replika var der netop problemer. Den forsøgte at genkonfigurere sig selv. Så vidt jeg forstår, forsøgte den at ændre recovery.conf, genstarte Postgres og forbinde til den nye master. Den skriver til hver 10. sekund beskeder om, at den prøver, men det lykkes ikke for den.
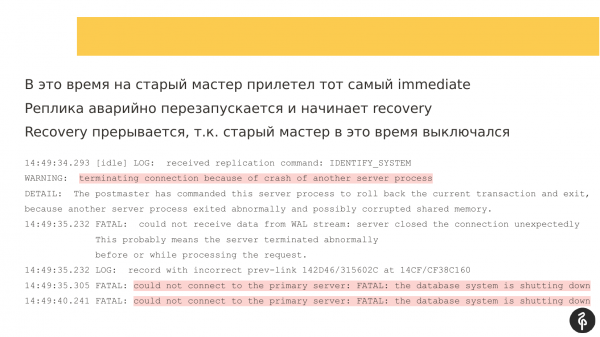
Og under disse forsøg modtager den gamle master et immediate-shutdown signal. Masteren genstarter. Og genopretningen stopper også, fordi den gamle master går i genstart. Dvs. replikaen kan ikke oprette forbindelse til den, fordi den er i slukningsmodus.
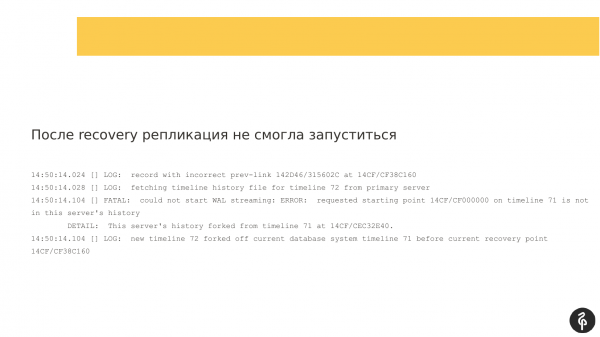
I et eller andet øjeblik begyndte den at fungere, men replikationen startede ikke.
Jeg har en eneste hypotese, at der i recovery.conf var adressen til den gamle master. Og da den nye master opstod, forsøgte den anden replika stadig at oprette forbindelse til den gamle master.
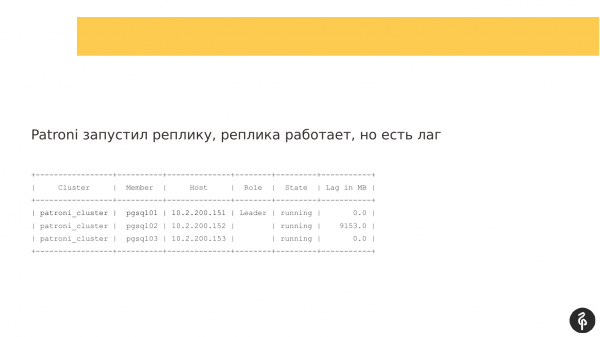
Da Patroni startede på den anden replika, startede noden, men kunne ikke oprette forbindelse til replikationen. Og der opstod et replikationslag, som så omtrent sådan ud. Dvs. alle tre noder var til stede, men den anden node var bagud.
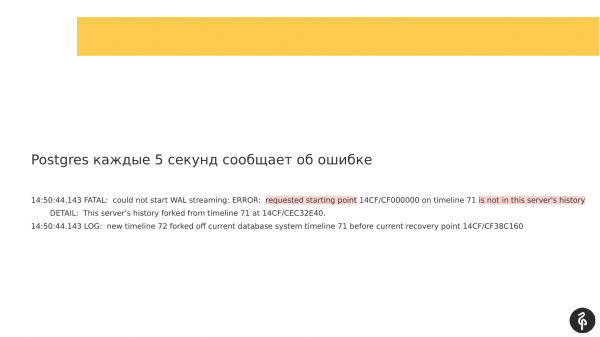
Når man kigger på de logfiler, der blev skrevet, kunne man se, at replikationen ikke kunne starte, fordi transaktionsregistrene var forskellige. Og de transaktionsregistre, som masteren tilbød, som var angivet i recovery.conf, passede simpelthen ikke til vores nuværende node.
Og her begik jeg en fejl. Jeg skulle have kigget på, hvad der stod i recovery.conf, for at tjekke min hypotese om, at vi ikke tilsluttede os den rigtige master. Men jeg var stadig ved at forstå det, og det faldt ikke mig ind, eller jeg så, at replikationen var forsinket, og at den skulle genindlæses, dvs. jeg arbejdede lidt sløset. Det var min fejl.
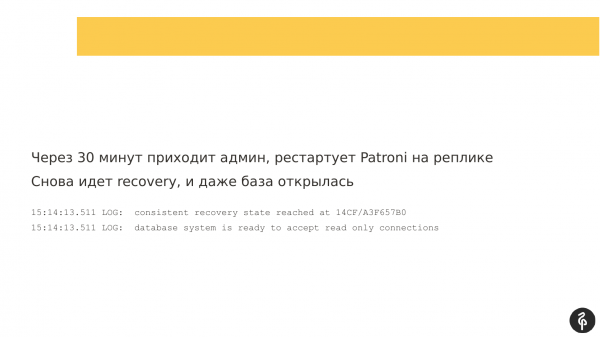
Efter 30 minutter kom admin allerede ind, dvs. jeg genstartede Patroni på replikationen. Jeg havde allerede opgivet den, jeg troede, den skulle genindlæses. Og jeg tænkte – jeg genstarter Patroni, måske vil det gøre noget godt. Recovery startede, og databasen åbnede endda, den var klar til at modtage forbindelser.
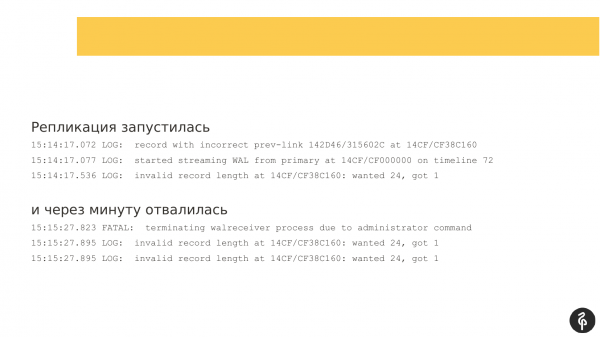
Replikationen blev startet. Men efter et minut gik den ned med en fejl, fordi transaktionsregistrene ikke passede.
Jeg tænkte, jeg ville genstarte en gang til. Jeg genstartede Patroni én gang til, og jeg genstartede ikke Postgres, men jeg genstartede netop Patroni i håbet om, at den på magisk vis ville starte databasen.
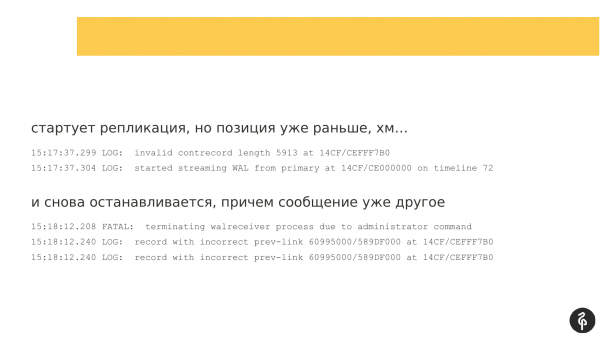
Replikationen blev startet igen, men posterne i transaktionsregistrene var forskellige; de var ikke de samme, som de var ved det tidligere forsøg på at starte op. Replikationen stoppede igen. Og beskeden var allerede en smule anderledes. Og den var ikke særlig informativ for mig.
Og pludselig kom tanken til mig – hvad hvis jeg genstarter Postgres og samtidig laver et checkpoint på den nuværende master for at flytte punktet i transaktionsregistrene lidt længere frem, så recovery kan starte fra et andet punkt? Plus vi havde også nogle WAL-reserver.
Jeg genstartede Patroni, lavede et par checkpoints på masteren, et par restart-punkter på replikationen, da den åbnede. Og det hjalp. Jeg tænkte længe over, hvorfor det hjalp, og hvordan det fungerede. Og replikationen startede. Og replikationen brød ikke længere ned.
Et sådant problem er for mig et af de mere gådefulde, som jeg stadig grublede over, hvad der egentlig skete.
Hvilke konklusioner kan vi drage herfra? Patroni kan fungere som designet, uden fejl. Men det er ikke en 100 % garanti for, at alt er i orden. En replika kan starte, men den kan være i en semi-funktionel tilstand, og applikationen skal ikke arbejde med en sådan replika, da den vil indeholde gamle data.
Og efter en failover er det altid vigtigt at kontrollere, at alt er i orden med klyngen, dvs. at der er det nødvendige antal replikater, og at der ikke er nogen replikationslag.
Og mens vi gennemgår disse problemer, vil jeg formulere anbefalinger. Jeg har forsøgt at samle dem i to slides. Sandsynligvis kunne alle historierne samles i to slides og kun blive fortalt.
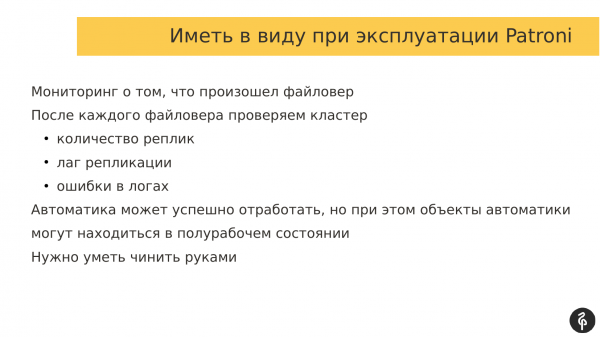
Når du bruger Patroni, skal du have overvågning. Du skal altid vide, hvornår en auto-failover har fundet sted, for hvis du ikke ved, at du har haft en auto-failover, kontrollerer du ikke klyngen. Og det er skidt.
Efter hver failover skal vi altid manuelt kontrollere klyngen. Vi skal sikre, at vi altid har det aktuelle antal replikater, at der ikke er nogen replikationslag, og at der ikke er fejl relateret til streamingreplikation, Patroni eller DCS-systemet i loggene.
Automatikken kan fungere succesfuldt; Patroni er et meget godt værktøj. Det kan fungere, men det vil ikke bringe klyngen til den ønskede tilstand. Og hvis vi ikke finder ud af dette, vil vi få problemer.
Og Patroni er ikke en sølvkugle. Vi skal stadig have en forståelse af, hvordan Postgres fungerer, hvordan replikation fungerer, og hvordan Patroni arbejder med Postgres og sikrer interaktionen mellem noderne. Dette er nødvendigt for at kunne løse de opståede problemer manuelt.
Hvordan nærmer jeg mig diagnostik? Det er sådan, at vi arbejder med forskellige kunder, og ingen har en ELK-stack, så vi må sortere i loggene ved at åbne 6 konsoller og 2 faner. I den ene fane er loggene fra Patroni for hver node, mens den anden fane indeholder loggene fra Consul eller Postgres om nødvendigt. Det er meget svært at diagnosticere.
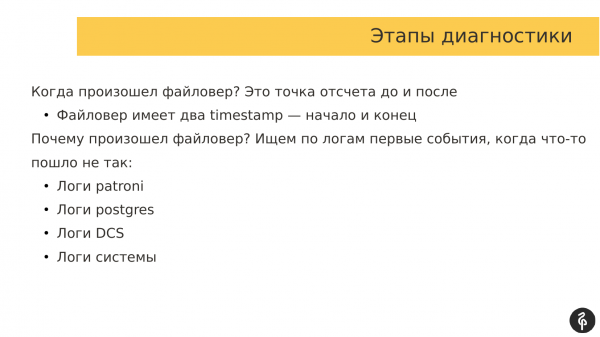
Hvilke tilgange har jeg udviklet? For det første ser jeg altid, hvornår failoveren indtræf. Og for mig er dette et skillepunkt. Jeg ser, hvad der skete før failoveren, under failoveren og efter failoveren. Failoveren har to tidspunkter: start- og sluttid.
Derefter ser jeg i loggene på begivenhederne op til failoveren, hvad der gik forud for failoveren, dvs. jeg søger efter årsagerne til, hvorfor failoveren skete.
Og det giver et billede af, hvad der skete, og hvad der kan gøres i fremtiden for at undgå sådanne omstændigheder (og dermed undgå en failover).
Og hvor ser vi normalt? Jeg ser:
- Først i loggene fra Patroni.
- Derefter ser jeg Postgres-loggene eller DCS-loggene afhængigt af hvad der er fundet i loggene fra Patroni.
- Og systemloggene giver nogle gange også indsigt i, hvad der var årsagen til failoveren.
Hvordan ser jeg på Patroni? Jeg ser meget positivt på Patroni. Efter min mening er det det bedste, der findes i dag. Jeg kender mange andre produkter. Dette er Stolon, Repmgr, Pg_auto_failover, PAF. 4 værktøjer. Jeg har prøvet dem alle. Patroni har jeg bedre kendt mig med.
Hvis man spørger mig: "Anbefaler jeg Patroni?". Jeg siger ja, fordi jeg kan lide Patroni. Og jeg føler, at jeg har lært at bruge det.
Hvis du er interesseret i at se, hvilke andre problemer der kan være med Patroni, udover dem, jeg har nævnt, kan du altid besøge siden på GitHub. Der er mange forskellige historier, og der diskuteres mange interessante problemer. Og i sidste ende har nogle fejl blevet registreret og løst, dvs. det er interessant læsning.
Der er interessante historier om, hvordan folk skyder sig selv i foden. Meget lærerigt. Du læser og forstår, at man ikke skal gøre sådan. Man sætter sig selv en checkmark.
Og jeg vil gerne give en stor tak til Zalando for at de udvikler dette projekt, især til Alexander Kukushkin og Alexey Klyukin. Alexey Klyukin er en af medforfatterne, han arbejder ikke længere hos Zalando, men det er to personer, der begyndte at arbejde med dette produkt.
Og jeg mener, at Patroni er en virkelig cool ting. Jeg er glad for, at den findes, det er spændende. Og en stor tak til alle bidragsydere, der skriver patches til Patroni. Jeg håber, at Patroni med tiden bliver mere modnet, cool og fungerende. Den fungerer allerede, men jeg håber, at den bliver endnu bedre. Så hvis du planlægger at bruge Patroni, så vær ikke bange. Det er en god løsning, det kan implementeres og bruges.
Det var alt. Hvis du har spørgsmål, så spørg endelig.
Spørgsmål
Tak for præsentationen! Hvis vi stadig skal se meget grundigt efter en failover, hvorfor har vi så en automatisk failover?
Fordi det er en ny ting. Vi har arbejdet med det i kun et år. Det er bedre at være forsigtig. Vi ønsker at gå ind og se, om alt virkelig har fungeret som det skal. Det er et niveau af voksent mistillid – det er bedre at efterkontrollere og se.
For eksempel, vi gik ind om morgenen og kiggede, ikke?
Ikke om morgenen, vi får normalt besked om auto-failover næsten med det samme. Vi modtager notifikationer, vi ser, at auto-failoveren fandt sted. Vi går næsten med det samme ind og kigger. Men alle disse tjek skal overgås til overvågningsniveauet. Hvis man henvender sig til Patroni via REST API, er der en historie. Ud fra historien kan man se tidsstempler for, hvornår failoveren skete. Baseret på dette kan man lave overvågning. Man kan se historien og hvor mange hændelser der har været. Hvis vi har fået flere hændelser, betyder det, at der har været en auto-failover. Man kan gå ind og tjekke. Eller vores automatisering i overvågningen har tjekket, at alle vores repliker er på plads, der ikke er nogen lag, og alt er i orden.
Tak!
Tusind tak for den fremragende præsentation! Hvis vi flyttede DCS-klienten langt væk fra Postgres-klienten, skal denne klient så også vedligeholdes periodisk? Hvilke best practices er der for, hvilke dele af DCS-klienten der skal slukkes, hvad der skal gøres osv.? Hvordan fungerer hele denne struktur under sådanne omstændigheder? Og hvordan skal disse ting gøres?
For én virksomhed var det nødvendigt at lave en problemmatrix for, hvad der sker, hvis en eller flere komponenter fejler. Baseret på denne matrix gennemgår vi systematisk alle komponenter og skaber scenarier i tilfælde af, at disse komponenter svigter. Hver fejlscenarie kan derfor have en handlingsplan for genopretning. Og for DCS er det en del af standardinfrastrukturen. Administratoren administrerer det, og vi stoler allerede på administratorer, der styrer dette, og deres evne til at reparere det i tilfælde af en nødsituation. Hvis DCS slet ikke findes, er det os, der implementerer det, men vi følger ikke nøje med, fordi vi ikke har ansvaret for infrastrukturen, men giver anbefalinger til, hvad og hvordan der skal overvåges.
Dvs. har jeg forstået korrekt, at man skal deaktivere Patroni, deaktivere failoveren, deaktivere alt, før man gør noget med værterne?
Det afhænger af, hvor mange knuder vi har i DCS-klusteret. Hvis der er mange knuder, og hvis vi kun tager én knude (replica) ud af drift, så er der stadig quorum i klusteret. Og Patroni forbliver funktionsdygtig. Og der trigges ikke noget. Hvis vi har nogle komplekse operationer, der involverer flere knuder, hvis fravær kan bryde quorum, så ja, det kan give mening at sætte Patroni på pause. Han har en tilsvarende kommando – patronictl pause, patronictl resume. Vi sætter bare på pause, og autofailover aktiveres ikke i denne periode. Vi udfører vedligeholdelse på DCS-klusteret, og derefter fjerner vi pausen og fortsætter med at køre.
Mange tak!
Tusind tak for præsentationen! Hvordan forholder produktteamet sig til, at data kan gå tabt?
Produktteamet er ligeglade, men teamlederne er bekymrede.
Hvilke garantier findes der?
Det er meget svært med garantier. Der er et foredrag af Alexander Kukushkin "Hvordan man beregner RPO og RTO", altså genopretningstid og hvor meget data vi kan miste. Jeg tror, vi skal finde disse slides og studere dem. Så vidt jeg husker, er der konkrete trin til, hvordan man beregner disse ting. Hvor mange transaktioner vi kan miste, hvor meget data vi kan miste. Som en mulighed kan vi bruge synkron replikation på Patroni-niveau, men det er en tveægget sværd: vi har enten dataintegritet eller taber i hastighed. Der er synkron replikation, men den garanterer heller ikke 100% beskyttelse mod datatab.
Alexey, tak for en fantastisk præsentation! Har du erfaring med at bruge Patroni til zero level protection? Altså i kombination med synkron standby? Det er det første spørgsmål. Det andet spørgsmål. I har brugt forskellige løsninger. Vi har brugt Repmgr, men uden autofailover og planlægger nu at tilføje autofailover. Vi overvejer Patroni som en alternativ løsning. Hvad kan du sige er fordelene i forhold til Repmgr?
Det første spørgsmål om synkrone replikater var. Ingen bruger synkron replikation, fordi alle er bange for det (Flere kunder bruger det allerede, og har ikke bemærket problemer med ydeevnen — Noter fra præsentøren). Men vi har lavet en regel for os selv om, at der skal være mindst tre noder i en synkron replikationsklynge, fordi hvis vi har to noder, og hvis master eller replika går ned, så overfører Patroni denne node til Standalone-tilstand, så applikationen fortsat kan køre. I dette tilfælde er der risici for datatab.
Vedrørende det andet spørgsmål, har vi brugt Repmgr og bruger det stadig hos nogle af vores kunder af historiske grunde. Hvad kan vi sige? I Patroni kommer auto-failover som standard, mens auto-failover i Repmgr kommer som en ekstra funktion, der skal aktiveres. Vi skal starte Repmgr daemon på hver node, og så kan vi konfigurere auto-failover.
Repmgr tjekker, om Postgres-noderne er i live. Repmgr-processerne tjekker for hinandens eksistens, hvilket ikke er en særlig effektiv tilgang, da der kan opstå komplekse tilfælde af netværksisolering, hvor en stor Repmgr-klynge kan splittes op i flere små og fortsætte med at fungere. Jeg har ikke fulgt med i Repmgr i lang tid, måske har de fikset det ... eller måske ikke. Men det at flytte information om klyngens tilstand til DCS, som Stolon og Patroni gør, er den mest levedygtige løsning.
Alexey, jeg har et spørgsmål, måske et naivt. I et af de første eksempler tog I DCS ud fra den lokale maskine og over til en fjern node. Vi forstår, at netværket er noget, der har sine egne særegenheder, det lever sit eget liv. Hvad sker der, hvis DCS-klyngen bliver utilgængelig af en eller anden grund? Jeg vil ikke nævne årsagerne, der kan være mange: fra dårligt arbejde af netværksteknikere til reelle problemer.
Jeg nævnte ikke højt, men DCS-klyngen skal også være fejlbestandig, dvs. det skal være et ulige antal noder, så kvorum kan samles. Hvad sker der, hvis DCS-klyngen bliver utilgængelig, eller ikke kan samle et kvorum, dvs. en form for netværks-split eller nedbrud af noder? I dette tilfælde går Patroni-klyngen over i read only-tilstand. Patroni-klyngen kan ikke bestemme status for klyngen og hvad den skal gøre. Den kan ikke kontakte DCS og gemme den nye status for klyngen, derfor går hele klyngen ind i read only. Den venter enten på manuel indgriben fra operatøren eller på at DCS bliver genoprettet.
Groft sagt bliver DCS for os en tjeneste, der er ligeså vigtig som selve databasen?
Ja ja. I mange moderne virksomheder er Service Discovery en uundgåelig del af infrastrukturen. Det implementeres ofte før databasen i infrastrukturen overhovedet er til stede. For at sige det på en anden måde, når infrastrukturen er startet op, og datacenteret er bygget, så har vi automatisk Service Discovery. Hvis det er Consul, kan DNS også bygges på det. Hvis det er Etcd, kan det være en del af Kubernetes-klyngen, hvor alt andet allerede vil blive implementeret. Jeg mener, at Service Discovery allerede er en uundgåelig del af moderne infrastrukturer, og man tænker på det meget tidligere end databaser.
Tak!
Kilde: habr.com
