

For tre år siden præsenterede Viktor Taranovsky og Alexey Milovidov fra Yandex på scenen HighLoad++ , hvor fantastisk ClickHouse er, og hvordan det ikke bremser. På den nærliggende scene var Alexander Zaitsev med om flytningen til ClickHouse en anden analytisk database, og konklusionen var, at ClickHouse, selvfølgelig er den god, men ikke særlig brugervenlig. Da virksomheden i 2016 LifeStreet, hvor Alexander dengang arbejdede, oversatte en multipetabyte analytisk system til ClickHouse, var det en spændende 'vej med gule mursten', fuld af uventede farer — ClickHouse dengang mindede det om et minefelt.
Tre år senere ClickHouse er blevet meget bedre — i mellemtiden har Alexander grundlagt virksomheden Altinity, som ikke blot hjælper med at flytte til ClickHouse flere projekter, men også forbedrer selve produktet sammen med kollegerne fra Yandex. Nu ClickHouse er det stadig ikke en sorgløs tur, men heller ikke et minefelt.
Alexander har arbejdet med distribuerede systemer siden 2003 og har udviklet store projekter i MySQL, Oracle og Vertica. På den forgangne HighLoad++ 2019 fortalte Alexander, en af pionererne inden for brugen af ClickHouse, hvad denne database står for i dag. Vi lærer om de vigtigste egenskaber ClickHouse: hvad der adskiller den fra andre systemer, og under hvilke omstændigheder den er mere effektiv at bruge. Vi vil gennemgå nye og afprøvede praksisser baseret på projekter med ClickHouse.
Retrospektiv: hvad der skete for 3 år siden
For tre år siden oversatte vi virksomheden LifeStreet og få en fungerende kommando. ClickHouse fra en anden analytisk database, og migrationen af data fra reklamesystemet så således ud:
- Juni 2016. I OpenSource opdateret med ClickHouse startede vores projekt;
- August. Proof Of Concept: et stort reklamenetværk, infrastruktur og 200-300 terabyte data;
- Oktober. Første produktionsdata;
- December. Fuld produktbelastning — 10-50 milliarder hændelser om dagen.
- Juni 2017. Vellykket flytning af brugere til ClickHouse, 2,5 petabyte data på et cluster af 60 servere.
Under migrationsprocessen voksede forståelsen af, at ClickHouse — det er et godt system, som man kan lide at arbejde med, men det er et internt projekt hos Yandex. Derfor er der nuancer: Yandex skal først fokusere på sine egne interne kunder og først derefter på samfundet og behovene hos eksterne brugere, og ClickHouse nåede ikke dengang op på enterprise-niveau på mange funktionelle områder. Derfor grundlagde vi i marts 2017 virksomheden Altinity for at gøre ClickHouse hurtigere og mere bekvemt, ikke kun for Yandex, men også for andre brugere. Og nu gør vi:
- Vi træner og hjælper med at bygge løsninger på ClickHouse måder, så kunderne ikke støder på problemer, og så løsningen fungerer i sidste ende;
- Vi leverer 24/7 support ClickHouse-installationer;
- Vi udvikler vores egne økosystemprojekter;
- Vi bidrager aktivt til selve ClickHouse, som svarer på brugernes anmodninger om at se bestemte funktioner.
Og selvfølgelig hjælper vi med at migrere til ClickHouse med MySQL, Vertica, Oracle, Greenplum, Redshift og andre systemer. Vi har deltaget i mange forskellige migrationer, og de har alle været succesfulde.
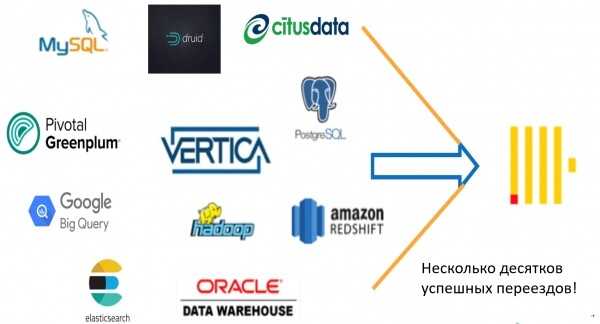
Hvorfor overhovedet migrere til ClickHouse
Det hænger ikke! Det er hovedårsagen. ClickHouse — en meget hurtig database til forskellige scenarier:
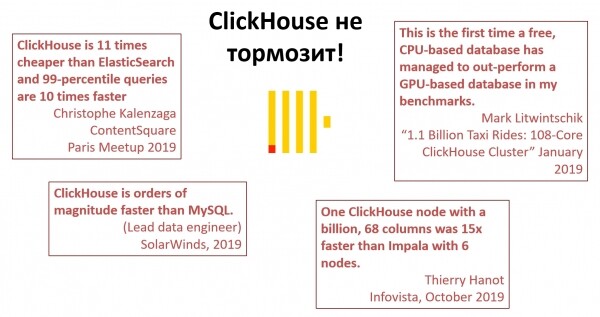
Tilfældige citater fra folk, der har arbejdet længe med ClickHouse.
Skalerbarhed. Med en anden DB kan man opnå rimelig ydelse på én maskine, men ClickHouse kan skaleres ikke kun vertikalt, men også horisontalt ved blot at tilføje servere. Det fungerer ikke altid så glat, som man kunne ønske sig, men det fungerer. Systemet kan vokse sammen med virksomheden. Det er vigtigt, at vi ikke er begrænset af løsningen nu og altid har potentiale for udvikling.
Portabilitet. Der er ingen binding til noget specifikt. For eksempel er det svært at migrere fra Amazon Redshift . Men ClickHouse kan installeres på din laptop, server, implementeres i skyen, gå til Kubernetes — der er ingen begrænsninger for infrastrukturen. Det er praktisk for alle, og det er en stor fordel, som mange andre lignende databaser ikke kan prale af.
Fleksibilitet. ClickHouse stopper ikke ved én ting, som Yandex.Metrica, men udvikler sig og bruges i et stigende antal forskellige projekter og industrier. Det kan udvides ved at tilføje nye funktioner til at løse nye opgaver. For eksempel anses det for at være forkert at gemme logs i en DB, så der blev udviklet Elasticsearch. Men takket være fleksibiliteten i ClickHouse, kan logs også gemmes der, og ofte er det endda bedre end i Elasticsearch — i ClickHouse det kræver 10 gange mindre hardware.
Gratis Open Source. Der er ikke behov for at betale for noget. Du skal ikke forhandle om tilladelse til at installere systemet på din laptop eller server. Der er ingen skjulte omkostninger. Desuden kan ingen anden Open Source databasteknologi konkurrere med hastigheden af ClickHouse. MySQL, MariaDB, Greenplum — de er alle meget langsommere.
Fællesskabet, drivkraften og sjov. ClickHouse et fremragende fællesskab: meetups, chats, og Alexey Milovidov, som oplader os alle med sin energi og optimisme.
Flytning til ClickHouse
For at skifte til ClickHouse noget andet, er der kun tre ting, man har brug for:
- At forstå begrænsningerne ClickHouse og hvornår det ikke passer.
- At udnytte fordelene ved teknologien og dens stærkeste sider.
- At eksperimentere. Selvom man forstår, hvordan det fungerer ClickHouse, er det ikke altid muligt at forudsige, hvornår det er hurtigere, hvornår langsommere, hvornår bedre, og hvornår værre. Så prøv.
Problemet ved flytningen
Der er kun én "men": hvis du flytter til ClickHouse fra noget andet, går det normalt ikke glat. Vi er vant til bestemte praksisser og ting, der fungerer i vores elskede database. For eksempel mener enhver, der arbejder med SQL-databaser, at følgende funktioner er essentielle:
- transaktioner;
- constraints;
- consistency;
- indekser;
- UPDATE/DELETE;
- NULLs;
- millisekunder;
- automatiske typeomdannelser;
- flere joins;
- vilkårlige partitioner;
- værktøjer til cluster management.
Kraven er essentiel, men for tre år siden havde ClickHouse ingen af disse funktioner! I dag er der mindre end halvdelen af det, der ikke er implementeret tilbage: transaktioner, constraints, consistency, millisekunder og typeomdannelser.
Og vigtigst af alt, nogle standardpraksisser og tilgange fungerer ikke eller fungerer ikke som vi er vant til. Alt, hvad der kommer i ClickHouse , overholder " ClickHouseClickHouse way", dvs. funktionerne adskiller sig fra andre databaser. For eksempel:Indekser vælges ikke, men overspringes.
- er ikke synkrone, men asynkrone.
- UPDATE/DELETE Flere joins er til stede, men der er ingen forespørgselsplanlægger. Hvordan de så udføres er ikke særlig klart for folk fra databaseverdenen.
- ClickHouse-scenarier
I 1960 skrev den amerikanske matematiker med ungarsk oprindelse
Wigner E. P. en artikel " The unreasonable effectiveness of mathematics in the natural sciences" om, at den omgivende verden på en eller anden måde beskrives godt ved matematiske love. Matematik er en abstrakt videnskab, og de fysiske love, udtrykt i matematisk form, er ikke trivielle, ogunderstreger, at det er meget underligt. en artikel " Fra mit synspunkt,
er der samme underlighed. Omformuleret fra Wigner kan man sige: den uforklarlige effektivitet ClickHouse i de mest forskellige analytiske applikationer! ClickHouse For eksempel, lad os tage
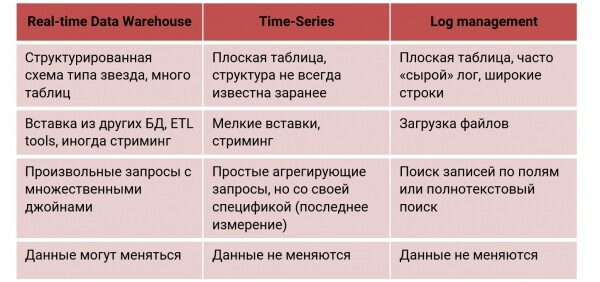
Real-Time Data Warehouse Data Warehouse i realtid, hvor data næsten kontinuerligt indlæses. Vi ønsker at modtage forespørgsler fra det med et sekunds forsinkelse. Venligst - vi bruger ClickHouse, fordi det var designet til dette scenarie. ClickHouse netop sådan bruges det ikke kun i web, men også i marketing- og finansanalyse, AdTech, samt i svindeldetektion. I Real-time Data Warehouse bruges en kompleks struktureret stjerneschema eller snefnugschema, mange tabeller med JOIN (nogle gange flere), og data opbevares og ændres typisk i forskellige systemer.
Lad os tage et andet scenarie - Tidsserie: overvågning af enheder, netværk, brugstatistik, internet of things. Her møder vi ordnede tidsmæssige begivenheder, som er ganske simple. ClickHouse det var ikke oprindeligt designet til dette, men det har vist sig effektivt, så store virksomheder bruger ClickHouse som et lager til overvågningsinformation. For at vurdere, om ClickHouse er egnet til tidsserier, lavede vi en benchmark baseret på metoden og resultaterne InfluxDB og TimescaleDB — specialiserede tidsserie databaser. , at ClickHouse, selv uden optimering til sådanne opgaver, klarer sig godt på fremmed grund:
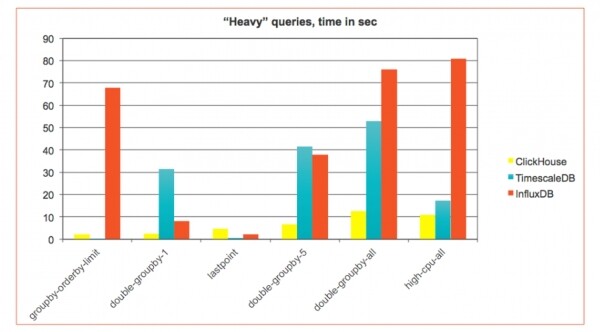
I tidsserie der anvendes normalt en smal tabel - et par små kolonner. Der kan komme meget data fra overvågning - millioner af poster per sekund - og de ankommer normalt i små indsættelser (real-time streaming). Derfor er der brug for et andet indsætningsscenarie, og forespørgslerne har deres egen specifikke karakter.
Log Management. At samle logs i en database er normalt dårligt, men i ClickHouse kan det gøres med nogle forbehold, som beskrevet ovenfor. Mange virksomheder bruger ClickHouse netop til dette. I dette tilfælde anvendes en flad bred tabel, hvor vi opbevarer logs i sin helhed (f.eks. i form af JSON), eller vi skærer dem i dele. Data indlæses normalt i store batches (filer), og vi søger i et bestemt felt.
Til hver af disse funktioner anvendes der normalt specialiserede databaser. ClickHouse én kan gøre alt dette så godt, at det overgår dem i ydelse. Lad os nu se nærmere på tidsserie scenariet, og hvordan man korrekt "forbereder" ClickHouse til dette scenarie.
Tidsserie
I øjeblikket er dette det primære scenarie, for hvilket ClickHouse anses for at være en standardløsning. Tidsserie — er en rækkefølge af begivenheder, der foregår over tid og repræsenterer ændringer i en proces. For eksempel kan det være hjerterytmen i løbet af en dag eller antallet af processer i systemet. Alt, der giver tidsmæssige tjek med målinger, er tidsserie:
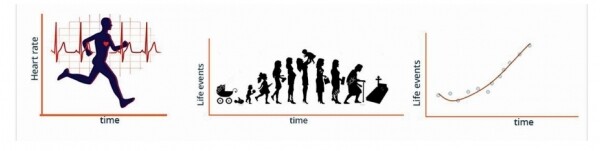
De fleste af denne type begivenheder kommer fra overvågning. Dette kan ikke kun være web-overvågning, men også reelle enheder: biler, industrielle systemer, IoT, produktioner eller droner, hvori Yandex allerede nu lægger ClickHouse-server.
For eksempel er der virksomheder, der indsamler data fra skibe. Hver et par sekunder sender sensorer fra containerskibet hundredevis af forskellige målinger. Ingeniørerne studerer dem, bygger modeller og forsøger at forstå, hvor effektivt skibet anvendes, fordi containerskibet ikke må stå stille et sekund. Enhver inaktivitet er et tab af penge, så det er vigtigt at forudsige ruten, så stoppene er minimale.
Der er i øjeblikket en stigning i specialiserede databaser, der måler tidsserie. På websitet DB-Engines på en eller anden måde rangerer forskellige databaser, og de kan ses efter typer:
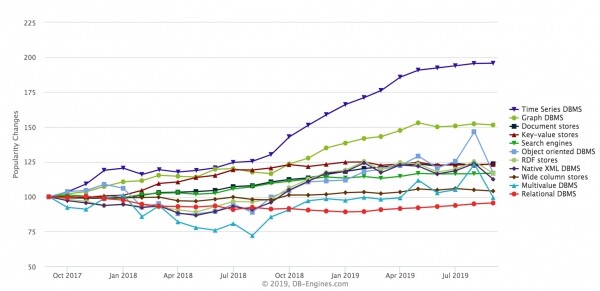
Den hurtigst voksende type er time-serier.Grafdatabaser vokser også, men time-serier.vokser hurtigere i de seneste år. Typiske repræsentanter for databaser i denne familie er InfluxDB, Prometheus, KDB, TimescaleDB (opbygget på PostgreSQL), løsninger fra Amazon. ClickHouse kan også bruges her, og det bruges. Jeg vil nævne nogle offentlige eksempler.
En af pionererne er virksomheden CloudFlare (CDN-udbyder). De overvåger deres CDN gennem ClickHouse (DNS-forespørgsler, HTTP-forespørgsler) med enorm belastning — 6 millioner begivenheder per sekund. Alt går gennem Kafka, sendes til ClickHouse, som giver mulighed for at se dashboardet for begivenheder i systemet i realtid.
Comcast — en af de førende telekommunikationsudbydere i USA: internet, digital tv, telefoni. De skabte et tilsvarende system til håndtering af CDN i rammerne af Open Source projektet Apache Traffic Control til at arbejde med deres enorme data. ClickHouse bruges som backend til analyse.
Percona integrerede ClickHouse ind i deres PMM, for at gemme overvågning af forskellige MySQL.
Specifikke krav
Til time-series databaser er der specifikke krav.
- Hurtig indsættelse fra mange agenter.Vi skal meget hurtigt indsætte data fra mange strømme. ClickHouse gør det godt, fordi alle dens indsættelser er ikke-blokerende. Enhver insert — dette er en ny fil på disken, og små indsatser kan buffes på den ene eller anden måde. I ClickHouse bedre at indsætte data i store pakker, ikke enkeltvis.
- Fleksibel skema. I tidsserie vi ved som regel ikke datakonstruktionen helt. Man kan bygge et overvågningssystem for en bestemt applikation, men så er det svært at bruge det til en anden applikation. Til det kræves der et mere fleksibelt skema. ClickHouse, tillader det, selvom det er en strengt typet database.
- Effektiv opbevaring og 'glemmelse' af data. Som regel i tidsserie et kæmpe datamængde, derfor skal de opbevares så effektivt som muligt. For eksempel, hos InfluxDB god komprimering — det er dens vigtigste funktion. Men ud over opbevaring skal man også kunne 'glemme' gamle data og lave en eller anden form for downsampling — automatisk beregning af aggregationer.
- Hurtige forespørgsler om aggregerede data. Nogle gange er det interessant at se de sidste 5 minutter med millisekunders præcision, men på månedsdata er minut- eller sekundgranularitet måske ikke nødvendig — generel statistik er tilstrækkelig. Støtte til den slags er nødvendig, ellers vil en forespørgsel for 3 måneder tage meget lang tid, selv i ClickHouse.
- Forespørgsler som 'last point, as of». Dette er typiske for tidsserie forespørgsler: vi ser den seneste måling eller systemets tilstand på et bestemt tidspunkt t. For databaser er dette ikke særlig behagelige forespørgsler, men de skal også kunne udføres.
- 'Sammenkædning' af tidsserier. Tidsserie — det er en tidsserie. Hvis der er to tidsserier, skal de ofte forbindes og korreleres. Det er ikke altid nemt at gøre i alle databaser, især med ikke-justerede tidsserier: her er der — nogle tidsstempler, der — er andre. Man kan beregne gennemsnit, men hvad nu hvis der stadig er et hul, derfor er det uklart.
Lad os se på, hvordan disse krav opfyldes i ClickHouse.
Diagram
I ClickHouse skemaet for tidsserie kan laves på forskellige måder, afhængigt af datanormalitetens grad. Man kan bygge et system på regelmæssige data, når vi kender alle metrikker på forhånd. For eksempel gjorde CloudFlare med overvågningen CDN — det er et veloptimeret system. Man kan bygge et mere generelt system, der overvåger hele infrastrukturen, forskellige tjenester. I tilfælde af uregelmæssige data ved vi ikke på forhånd, hvad vi overvåger — og det er sandsynligvis det mest generelle tilfælde.
Regelmæssige data. Kolonner. Skemaet er enkelt – kolonner med de nødvendige typer:
Opret tabel cpu (
  created_date Dato STANDARD today(),
  created_at DatoTid STANDARD now(),
  time String,
  tags_id UInt32,
  /* join til dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Dette er en almindelig tabel, der overvåger en eller anden aktivitet relateret til systembelastning (user, system, idle, nice). Enkelt og praktisk, men ikke fleksibelt. Hvis vi ønsker en mere fleksibel skema, kan vi bruge arrays.
Uregelmæssige data. Arrays:
Opret tabel cpu_alc (
  created_date Dato,
  created_at DatoTid,
  time String,
  tags_id UInt32,
  metrics Næstet(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FRA ...
Struktur Næstet — det er to arrays: metrics.name og metrics.value. Her kan man gemme sådanne vilkårlige overvågningsdata som et array af navne og et array af målinger ved hver hændelse. Til videre optimering kan man i stedet for en sådan struktur lave flere. For eksempel, én til float-værdi, en anden til int-værdi, fordi int man ønsker at gemme mere effektivt.
Men det er sværere at tilgå sådan en struktur. Man skal bruge en særlig konstruktion, gennem specielle funktioner trække værdier først fra indekset, og derefter arrayet:
SELECT max(metrics.value[indexOf(metrics.name,'usage_user')]) FRA ...Men det fungerer stadig ret hurtigt. En anden måde at gemme uregelmæssige data – er pr. række.
Uregelmæssige data. Rækker. I denne traditionelle metode uden arrays gemmes straks navne og værdier. Hvis der kommer 5.000 målinger fra en enhed – genereres 5.000 rækker i databasen:
Opret tabel cpu_rlc (
  created_date Dato,
  created_at DatoTid,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


SELECT
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
FRA cpu_r
HVOR metric_name IN ('usage_user', ...)
ClickHouse dette klarede — den har særlige udvidelser ClickHouse SQL. For eksempel, maxIf — en særlig funktion, der beregner maksimummetrikken under opfyldelsen af en bestemt betingelse. Man kan skrive flere sådanne udtryk i én forespørgsel og straks beregne værdien for flere metrikker.
Lad os sammenligne tre tilgange:
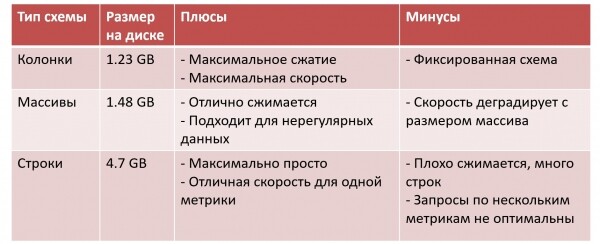
Her har jeg tilføjet «Diskdata størrelse» for et testdatasæt. For kolonner har vi den mindste datastørrelse: maksimal kompression, maksimal forespørgsels hastighed, men vi betaler ved at være nødt til at fastlåse alt på én gang.
Når det kommer til arrays, er situationen lidt værre. Data komprimeres stadig godt, og man kan gemme en uregelmæssig skema. Men ClickHouse — er en kolonnebaseret database, og når vi begynder at gemme alt i arrays, bliver den til en strømlinet type, og vi betaler for fleksibiliteten med effektivitet. For hver operation skal hele arrayet læses ind i hukommelsen, og derefter finde det ønskede element — og hvis arrayet vokser, er hastigheden ikke så god.
I et af de virksomheder, der bruger denne tilgang (f.eks. ), skæres arrays i bidder på 128 elementer. Data fra flere tusinde metrics på 200 TB data/dag opbevares ikke i et enkelt array, men i 10 eller 30 arrays med speciel logik til opbevaring.
Den enkleste tilgang er med strenge. Men data komprimeres dårligt, tabellen bliver stor, og når forespørgsler går over flere metrics, fungerer ClickHouse ikke optimalt.
Hybrid skema
Lad os antage, at vi har valgt et skema med arrays. Men hvis vi ved, at de fleste af vores dashboards kun viser metrics for user og system, kan vi yderligere materialisere disse metrics fra arrayet på tabelniveau ved at gøre følgende:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Ved indsat ClickHouse vil den automatisk beregne dem. På denne måde kan man kombinere det behagelige med det nyttige: skemaet er fleksibelt og generelt, men de mest brugte kolonner er blevet udtrukket. Jeg bemærker, at dette ikke krævede ændringer i indsættelsen og ETL, som fortsætter med at indsætte arrays i tabellen. Vi gjorde bare ALTER TABLE, tilføjede et par kolonner, og der opstod et hybrid og hurtigere skema, som man straks kan begynde at bruge.
Codecs og kompression
For tidsserie det er vigtigt, hvor godt du pakker dataene, fordi informationsmængden kan være meget stor. I ClickHouse der er et sæt værktøjer til at opnå en komprimeringseffekt på 1:10, 1:20, og nogle gange endnu mere. Det betyder, at udpakkede data på 1 TB på disken kun optager 50-100 GB. En mindre størrelse er en fordel, da dataene kan læses og behandles hurtigere.
For at opnå et højt niveau af komprimering, ClickHouse understøtter følgende codecs:
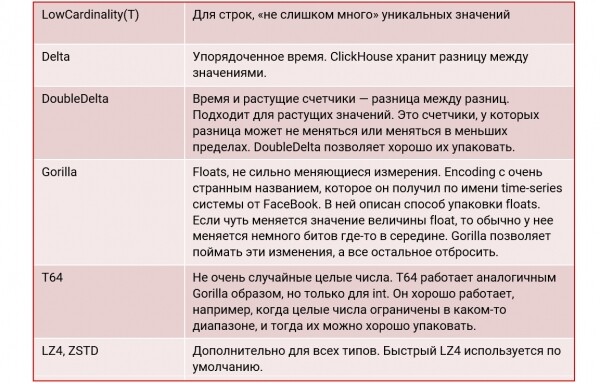
Eksempel tabel:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Her definerer vi codec'en DoubleDelta i det ene tilfælde, i det andet — Gorilla, og vi skal selvfølgelig også tilføje LZ4 komprimering. Som et resultat bliver datastørrelsen på disken betydeligt reduceret:
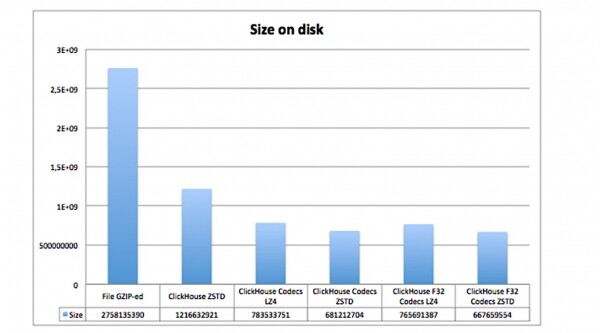
Her vises, hvor meget plads de samme data optager, men ved brug af forskellige codecs og komprimeringer:
- i en GZIP-komprimeret fil på disken;
- i ClickHouse uden codecs, men med ZSTD-komprimering;
- i ClickHouse med codecs og komprimeringen LZ4 og ZSTD.
Det kan ses, at tabeller med codecs optager betydeligt mindre plads.
Size matters
Det er lige så vigtigt den rigtige datatype:
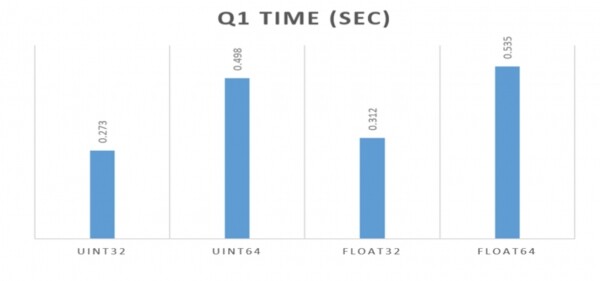
I alle ovenstående eksempler har jeg brugt Float64. Men hvis vi havde valgt Float32, ville det endda have været bedre. Dette blev godt demonstreret af folkene fra Percona i artiklen i linket ovenfor. Det er vigtigt at bruge den mest kompakte datatype, der passer til opgaven: selv i mindre grad for størrelsen på disken end for hastigheden af forespørgsler. ClickHouse er det meget følsomt over for.
Hvis du kan bruge int32 i stedet for int64, så forvent næsten en fordobling af ydeevnen. Dataene optager mindre hukommelse, og al 'aritmetik' fungerer meget hurtigere. ClickHouse indeni er det et meget strengt typet system, som maksimerer alle muligheder, som moderne systemer tilbyder.
Aggregation og Materialized Views
Aggregation og materialiserede visninger giver mulighed for at lave aggregeringer til forskellige situationer:
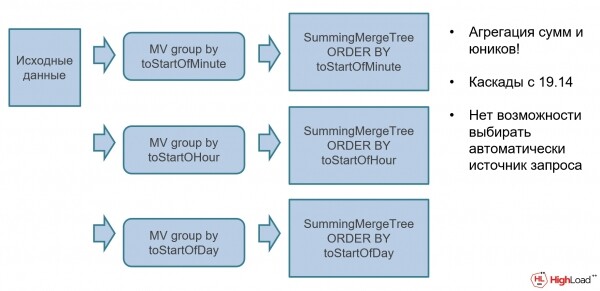
For eksempel kan du have uaggreggerede rådata, og du kan tilføje forskellige materialiserede visninger med automatisk summering via den specielle engine SummingMergeTree (SMT). SMT — det er en specialiseret aggregationsdatastruktur, der automatisk beregner aggregater. Rådata indsættes i databasen, de aggregeres automatisk, og dashboards kan straks bruge dem.
TTL — "glemmer" gamle data
Hvordan "glemmer" man data, der ikke længere er nødvendige? ClickHouse kan gøre dette. Ved oprettelse af tabeller kan man angive TTL udtryk: for eksempel at minutdata opbevares i en dag, dagsdata i 30 dage, mens uge- eller månedlige data aldrig berøres:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…
/* no TTL */
Multi-tier — vi opdeler data på tværs af diske
Ved at udvikle denne idé kan data opbevares i ClickHouse forskellige steder. Lad os antage, at vi vil opbevare varme data fra den seneste uge på en meget hurtig lokal SSD, mens mere historiske data lagres et andet sted. I ClickHouse er dette nu muligt:
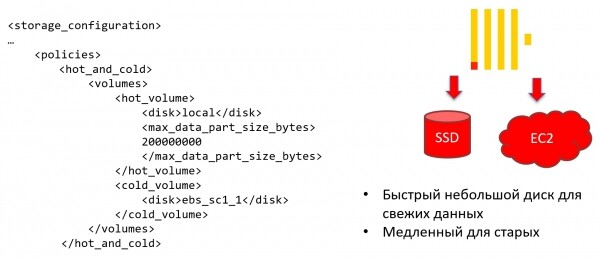
Man kan konfigurere en opbevaringspolitik (storage policy) således at ClickHouse automatisk vil flytte data til en anden opbevaringsenhed, når visse betingelser er opfyldt.
Men det er ikke alt. På niveauet for en specifik tabel kan man definere regler for, hvornår data præcist overgår til kold opbevaring over tid. For eksempel ligger data i 7 dage på en meget hurtig disk, mens alt over dette flyttes til en langsom disk. Dette er godt, da det holder systemet på maksimal ydeevne, samtidig med at det kontrollerer omkostningerne og ikke bruger penge på kolde data:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Unikke muligheder ClickHouse
Næsten alt i ClickHouse har sådanne "specialiteter", men de neutraliseres af eksklusiviteten—noget, der ikke findes i andre databaser. For eksempel er her nogle af de unikke funktioner ClickHouse:
- Arrays. I ClickHouse meget god støtte til arrays, samt muligheden for at udføre komplekse beregninger på dem.
- Aggregationsdatastrukturer. Det er en af "killer-features" ClickHouse. Selvom drengene fra Yandex siger, at vi ikke ønsker at aggregere data, så gør alle det i ClickHouse, fordi det er hurtigt og praktisk.
- Materialiserede visninger. Sammen med aggregationsdatastrukturer tillader materialiserede visninger en bekvemmelighed i real-time aggregation.
- ClickHouse SQL. Det er en udvidelse af sproget SQL med nogle ekstra og eksklusive funktioner, der kun findes i ClickHouse. Tidligere var det ligesom en udvidelse på den ene side, men en mangel på den anden side. Nu har vi fjernet næsten alle mangler i forhold til SQL 92 . Det er nu kun en udvidelse.
- Lambda–udtryk. Findes de også i andre databaser?
- ML-support. Dette findes i forskellige databaser, nogle er bedre end andre.
- Åben kildekode. Vi kan udvide ClickHouse sammen. Der er nu omkring 500 bidragsydere, og dette tal vokser konstant. ClickHouse Snedige forespørgsler
der er mange forskellige måder at gøre det samme på. For eksempel kan man returnere den seneste værdi fra en tabel på tre forskellige måder for
I ClickHouse (der er også en fjerde, men den er endnu mere eksotisk). CPU Den første viser, hvor praktisk det er at lave forespørgsler, når du vil tjekke, om
tuplen ClickHouse er indeholdt i en underforespørgsel. Det er noget, jeg personligt har savnet i andre databaser. Hvis jeg vil sammenligne noget med en underforespørgsel, kan jeg i andre databaser kun sammenligne med en skalær, og for flere kolonner skal jeg skrive jeg kan bruge tupler: SELECT * FROM cpu WHERE (tags_id, created_at) IN (SELECT tags_id, max(created_at) FROM cpu GROUP BY tags_id) JOIN. I ClickHouse Den anden metode gør det samme, men bruger en aggregatfunktion
argMaxSELECT argMax(usage_user), created_at), argMax(usage_system), created_at), ... FROM cpu der er flere dusin aggregatfunktioner, og hvis man bruger kombinatorer, vil der efter kombinatorikkens love være omkring tusind.:
ArgMax I ClickHouse — en af funktionerne, der beregner den maksimale værdi: forespørgslen returnerer værdien usage_user , hvor den maksimale værdi nås SELECT now() as created_at, cpu.* FROM (SELECT DISTINCT tags_id from cpu) base ASOF LEFT JOIN cpu USING (tags_id, created_at)ASOF JOIN created_at:
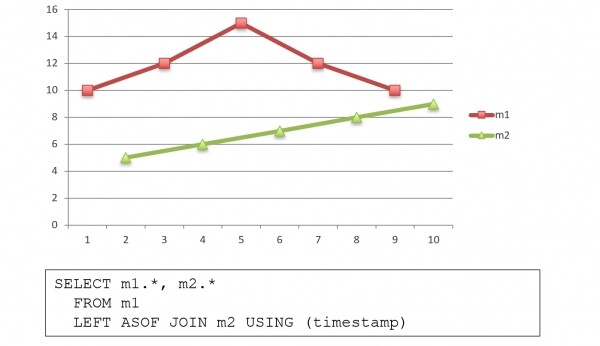
— 'samling' af rækker med forskelligt tidsstempel.
Dette er en unik funktion for databaser, som kun findes i kdb+ . Hvis der er to tidsserier med forskellige tidspunkter, tillader den at forskyde og samle dem i en forespørgsel. For hver værdi i en tidsserie findes nærmeste værdi i den anden, og de returneres på samme linje:Analytiske funktioner Dette er en unik funktion for databaser, som kun findes i I standarden
SQL-2003
kan man skrive således: SELECT origin, timestamp, timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration, timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration, ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence, COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb FROM mytable ORDER BY origin, timestamp; det kan man ikke — det understøtter ikke standarden
og vil nok aldrig gøre det. I stedet i
I ClickHouse det kan man ikke — det understøtter ikke standarden SELECT origin, timestamp, timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration, timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration, ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence, COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb FROM mytable ORDER BY origin, timestamp; og vil sandsynligvis aldrig gøre det. I stedet for ClickHouse det er almindeligt at skrive sådan:
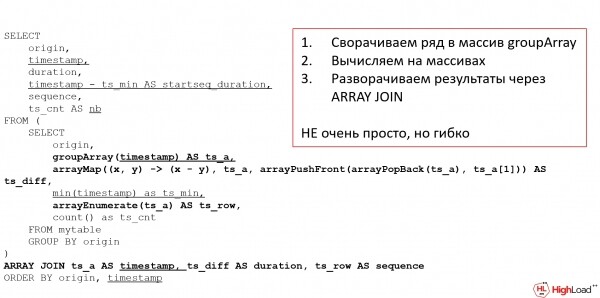
Jeg lovede lambdas – her er de!
Det er analogt til en analytisk forespørgsel i standarden SELECT origin, timestamp, timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration, timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration, ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence, COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb FROM mytable ORDER BY origin, timestamp;: det beregner forskellen mellem to timestamp, varighed, rækkenummer – alt, hvad vi normalt betragter som analytiske funktioner. I ClickHouse betyder vi dem gennem arrays: vi komprimerer først dataene til et array, hvorefter vi kan gøre alt, hvad vi vil på arrayet, og derefter udpakke det igen. Det er ikke særlig praktisk, kræver kærlighed til funktionel programmering, men det er meget fleksibelt.
Særlige funktioner
Derudover er der i ClickHouse mange specialiserede funktioner. For eksempel, hvordan bestemmer man, hvor mange sessioner der kører samtidig? En typisk opgave til overvågning – at bestemme den maksimale belastning med én forespørgsel. I ClickHouse er der en særlig funktion til dette formål:
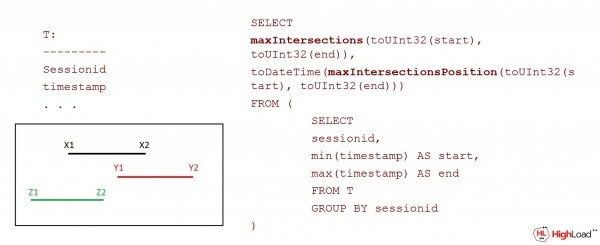
Generelt er der mange særlige funktioner i ClickHouse:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
Dette er ikke en komplet liste over funktioner, der i alt er 500-600. Hint: alle funktioner i ClickHouse er i systemtabellen (ikke alle er dokumenteret, men alle er interessante):
select * from system.functions order by nameClickHouse selv gemmer mange oplysninger om sig selv, herunder logtabeller, query_log, sporingslog, log over operationer med datablokke (part_log), log for metrikker og systemlog, som normalt skrives til disk. Metrikloggen er tidsserie i ClickHouse i virkeligheden ClickHouse: databasen selv kan spille rollen som tidsserie databaser, dermed 'spiser' den sig selv.
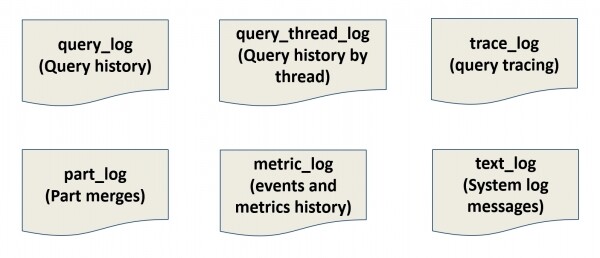
Dette er også en unik ting – når vi gør et godt stykke arbejde for tidsserie, hvorfor skulle vi ikke kunne gemme alt, hvad der er nødvendigt, i os selv? Vi har ikke brug for Prometheus, vi gemmer alt i os selv. Vi har tilsluttet Grafana og overvåger os selv. Men hvis ClickHouse falder, ser vi ikke, hvorfor, – derfor gør man normalt ikke sådan.
En stor klynge eller mange små ClickHouse
Hvad er bedre – én stor klynge eller mange små ClickHouse? Den traditionelle tilgang til DWH er en stor klynge, hvor der er tildelt skemaer til hver applikation. Vi gik til databaseadministrator – giv os et skema, og vi fik det:
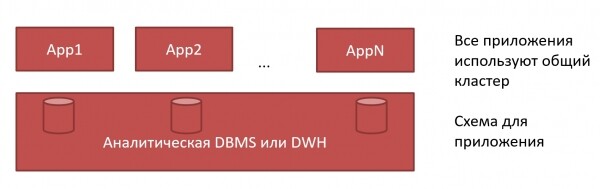
I ClickHouse man kan gøre det anderledes. Hver applikation kan have sit eget ClickHouse:
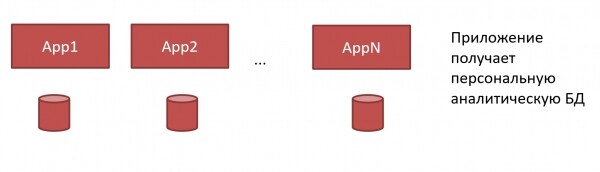
Vi har ikke længere brug for store monstrøse DWH og vanskelige administratorer. Vi kan give hver applikation sit eget ClickHouse, og udvikleren kan selv gøre det, da ClickHouse meget nemt at installere og kræver ikke kompliceret administration:
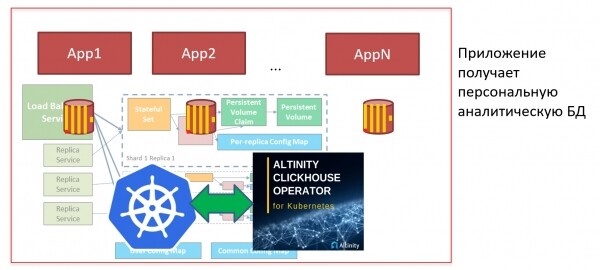
Men hvis vi har mange ClickHouse, og ofte skal installere det, så ønsker man at automatisere denne proces. Til dette kan vi for eksempel bruge Kubernetes og clickhouse-operatøren. I Kubernetes ClickHouse kan vi installere «med et klik»: jeg kan trykke på en knap, starte manifestet, og databasen er klar. Man kan straks oprette et skema, begynde at indlæse metrics, og efter 5 minutter har jeg allerede et dashboard klar Grafana. Alt er så nemt!
Hvad ender vi med?
Så, ClickHouse – det er:
- Hurtigt. Det er velkendt.
- Simpelt. Lidt kontroversielt, men jeg mener, at hård træning gør let kamp. Forstår man, hvordan ClickHouse det fungerer, så er alt meget enkelt.
- Universelt. Det passer til forskellige scenarier: DWH, tidsserier, logopbevaring. Men dette er ikke OLTP databasen, så prøv ikke at lave korte indskud og læsninger der.
- Interressant. Nok har den, der arbejder med ClickHouse, oplevet mange interessante øjeblikke, både gode og dårlige. For eksempel kom der en ny udgivelse, og alt stoppede med at fungere. Eller når du har kæmpet med et problem i to dage, men efter et spørgsmål i Telegram-chatten blev det løst på to minutter. Eller hvordan der på konferencen, ved Aleksey Milovidovs præsentation, et screenshot fra ClickHouse brød livestreamen HighLoad++. Denne slags ting sker hele tiden og gør vores liv med ClickHouse livligt og interessant!
Præsentationen kan ses .
Den længe ventede samling af udviklere af højbelastede systemer på finder sted den 9. og 10. november i Skolkovo. Endelig bliver det en offline-konference (selvom med overholdelse af alle sikkerhedsforanstaltninger), da energien fra HighLoad++ ikke kan pakkes ind online.
Til konferencen finder vi og viser jer cases om de maksimale muligheder for teknologier: HighLoad++ har været, er og vil altid være det eneste sted, hvor man på to dage kan finde ud af, hvordan Facebook, Yandex, Vkontakte, Google og Amazon fungerer.
Vi har afholdt vores møder uden pauser siden 2007, og i år mødes vi for 14. gang. I løbet af denne tid er konferencen vokset 10 gange, sidste år samlede nøglebegivenheden i branchen 3339 deltagere, 165 talere af oplæg og meetups, og der blev samtidig afholdt 16 spor.
Sidste år sørgede vi for 20 busser, 5280 liter te og kaffe, 1650 liter frugtdrikke og 10200 flasker vand. Og desuden 2640 kilogram mad, 16000 tallerkener og 25000 kopper. Forresten, for pengene, der blev tjent på genanvendt papir, plantede vi 100 egetræer 🙂Billetter kan købes , få nyheder om konferencen — , men at tale — i alle sociale medier: , , og .
Kilde: habr.com
