

I denne artikel vil jeg fortælle om, hvordan det projekt, jeg arbejder på, har udviklet sig fra en stor monolit til et sæt af mikrotjenester.
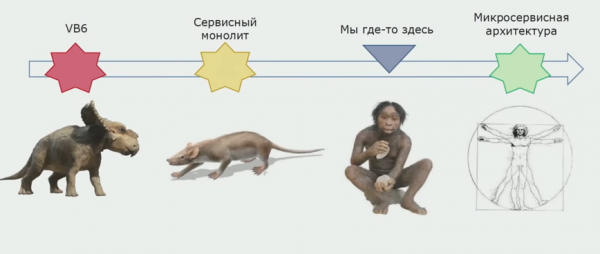
Projektet begyndte sin historie for mange år siden, i begyndelsen af 2000-tallet. De første versioner blev skrevet i Visual Basic 6. Med tiden blev det klart, at udviklingen i dette sprog ville blive vanskelig at understøtte i fremtiden, da IDE'en og selve sproget udviklede sig langsomt. I slutningen af 2000'erne blev det besluttet at skifte til det mere lovende C#. Den nye version blev skrevet parallelt med forbedringerne af den gamle, og gradvist blev der brugt mere og mere .NET kode. Backend i C# var oprindeligt orienteret mod en servicearkitektur, men under udviklingen blev der anvendt fælles biblioteker med logik, og tjenesterne blev kørt i én enkelt proces. Resultatet var en applikation, som vi kaldte "service monolit".
En af de få fordele ved denne sammenkobling var muligheden for, at tjenesterne kunne kalde hinanden via et eksternt API. Der var klare forudsætninger for at overgå til en mere korrekt servicearkitektur, og på længere sigt til en mikrotjenestearkitektur.
Vi begyndte vores arbejde med dekomponering omkring 2015. Selvom vi endnu ikke har nået den ideelle tilstand - der er stadig dele af det store projekt, som allerede er svære at kalde monolitter, men som heller ikke ligner mikrotjenester. Ikke desto mindre er fremskridtene betydelige.
Om det vil jeg fortælle i artiklen.
Indhold
Arkitektur og problemer med den nuværende løsning
Den oprindelige arkitektur så således ud: UI - en separat applikation, den monolitiske del var skrevet i Visual Basic 6, applikationen på .NET var et sæt af relaterede tjenester, der arbejdede med en ganske stor database.
Ulemper ved den tidligere løsning
Enkeltpunkt for fejl
Vi havde et enkelt fejlopunkt: applikationen på .NET kørte i én proces. Hvis der opstod en fejl i en af modulerne, fejlede hele applikationen, og vi måtte genstarte den. Da vi automatiserer et stort antal processer for forskellige brugere, kunne alle ikke arbejde i et stykke tid på grund af en fejl i en af dem. Selv en programmeringsfejl hjalp backup ikke.
Kø af ændringer
Denne ulempe er snarere organisatorisk. I vores applikation er der mange kunder, og de ønsker alle at få deres ændringer gjort så hurtigt som muligt. Tidligere var det umuligt at gøre dette parallelt, og alle kunderne måtte stille sig i kø. Denne proces skabte negativitet hos forretningen, da de skulle bevise, at deres opgave havde værdi. Og udviklingsteamet brugte tid på at organisere denne kø. Det tog meget tid og kræfter, og produktet kunne derfor ikke ændre sig så hurtigt, som de ønskede.
Suboptimal ressourceudnyttelse
Når vi havde services i én proces, kopierede vi altid konfigurationen fuldstændigt fra server til server. Vi ønskede at placere de mest belastede services separat for ikke at spilde ressourcer og for at få mere fleksibel kontrol over vores implementeringsskema.
Svært at implementere moderne teknologi
Et velkendt problem for alle udviklere: der er et ønske om at implementere moderne teknologi i projektet, men der er ingen mulighed. Med en stor monolitisk løsning bliver enhver opdatering af den nuværende bibliotek, for ikke at nævne overgangen til en ny, en temmelig kompleks opgave. Man skal i lang tid overbevise teamlederen om, at det vil give flere fordele end de stressede nerver.
Sværhed ved at udgive ændringer
Det var det mest alvorlige problem — vi udgav opdateringer hver anden måned.
Hver opdatering blev til en rigtig katastrofe for banken, på trods af testning og udviklernes bestræbelser. Forretningen forstod, at de i begyndelsen af ugen ikke ville have en del af funktionaliteten til rådighed. Udviklerne forstod, at de ville stå over for en uge med alvorlige hændelser.
Alle ønskede at ændre situationen.
Forventninger til mikrotjenester
Udgivelse af komponenter efterhånden som de er klar. Udgivelse af komponenter i takt med deres færdiggørelse takket være dekomponering af løsningen og adskillelse af forskellige processer.
Små produktteams. Dette er vigtigt, fordi det er svært at styre et stort team, der arbejder på et gammelt monolitisk system. Et sådant team bliver tvunget til at følge en striks proces, mens der ønskes mere kreativitet og uafhængighed. Det kunne kun lade sig gøre med små teams.
Isolering af systemer i separate processer. Ideelt set ville vi gerne isolere i containere, men et stort antal services skrevet på .NET Framework kører kun på Windows. Nu dukker der services op på .NET Core, men de er stadig få.
Fleksibilitet i deployment. Vi ønskede at kombinere services, som vi har behov for, i stedet for som koden tvinger os til.
Brug af nye teknologier. Dette interesserer enhver programmør.
Problemer ved overgangen
Selvfølgelig, hvis det bare var let at dele monolitten op i mikrotjenester, ville vi ikke behøve at tale om det på konferencer og skrive artikler. Der er mange faldgruber i denne proces, og jeg vil beskrive de vigtigste, der har hindret os.
Det første problem er typisk for de fleste monolitter: koblingen af forretningslogik. Når vi skriver en monolit, ønsker vi at genbruge vores klasser for at undgå at skrive overflødig kode. Men ved overgangen til mikrotjenester bliver dette et problem: al koden er temmelig stramt knyttet sammen, og det er svært at adskille services.
På tidspunktet for opstarten var der mere end 500 projekter i repository og over 700.000 linjer kode. Det er en temmelig stor løsning, og det andet problemvar, at det bare var umuligt at opdele det i mikrotjenester.
Det tredje problem er manglen på den nødvendige infrastruktur. Faktisk arbejdede vi med manuel kopiering af kildekoden til serverne.
Hvordan man går fra monolit til mikrotjenester
Opdeling af mikrotjenester
For det første afgør vi fra starten, at opdelingen af mikrotjenester er en iterativ proces. Vi blev altid bedt om at udvikle forretningsopgaver parallelt. Hvordan vi teknisk vil gøre dette, er allerede vores problem. Derfor forberedte vi os på en iterativ proces. Det vil ikke fungere anderledes, hvis du har en stor applikation, og den ikke oprindeligt er klar til at blive omskrevet.
Hvilke metoder bruger vi til at adskille mikrotjenester?
Den første metode — at udskille eksisterende moduler som tjenester. I denne henseende var vi heldige: der var allerede etablerede tjenester, der arbejdede via WCF-protokollen. De var opdelt i separate assemblys. Vi flyttede dem individuelt og tilføjede en lille opstartsmodule til hver assembly. Den blev skrevet ved hjælp af det fantastiske bibliotek Topshelf, som gør det muligt at køre applikationen både som en tjeneste og som en konsol. Det er praktisk til fejlfinding, da der ikke kræves yderligere projekter i løsningen.
Tjenesterne var knyttet sammen gennem forretningslogik, da de brugte fælles assemblys og arbejdede med en fælles database. De var svære at kalde mikrotjenester i ren forstand. Ikke desto mindre kunne vi udgive disse tjenester separat, i forskellige processer. Dette reducerede allerede deres indflydelse på hinanden, hvilket mindskede problemet med parallel udvikling og en enkelt fejlpunkt.
Assemblyen med værten er kun én linje kode i Program-klassen. Vi skjulte arbejdet med Topshelf i en hjælpeklasse.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
Den anden metode til udskillelse af mikrotjenester: er at oprette dem til at løse nye opgaver. Hvis monolitten ikke vokser i den proces, er det allerede fantastisk, hvilket betyder, at vi bevæger os i den rigtige retning. For at løse nye opgaver forsøgte vi at lave separate tjenester. Hvis der var mulighed for det, skabte vi mere "kanoniske" tjenester, som fuldt ud styrer deres datamodel, med en separat database.
Vi, ligesom mange andre, begyndte med autentifikations- og autorisationstjenester. De egner sig perfekt til dette formål. De er uafhængige, og som regel har de en separat datamodel. De interagerer ikke selv med monolitten; det er kun monolitten, der henvender sig til dem for at løse nogle opgaver. På disse tjenester kan vi begynde overgangen til en ny arkitektur, fejlfinde infrastrukturen, afprøve nogle tilgange relateret til netværksbiblioteker osv. I vores organisation er der ikke nogen teams, der ikke har kunnet lave en autentifikationstjeneste.
Den tredje metode til udskillelse af mikrotjenester, som vi bruger, er lidt specifik for os. Det handler om at flytte forretningslogik ud af UI-laget. Vores primære UI-applikation er desktopbaseret, og den er ligesom backend skrevet i C#. Udviklerne lavede jævnligt fejl og placerede logik i UI, som burde have eksisteret i backend og genbruges.
Hvis man ser på et konkret eksempel fra UI-koden, er det tydeligt, at en stor del af denne løsning indeholder ægte forretningslogik, der er nyttig i andre processer, ikke kun til at opbygge UI-formularer.
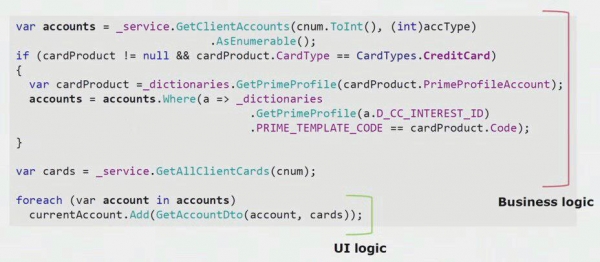
Der er kun reelle UI-logikker i de sidste par linjer. Vi har flyttet det til serveren for at kunne genbruge det og dermed reducere UI og opnå den rigtige arkitektur.
Den fjerde og vigtigste måde at выделение на микросервисы, som gør det muligt at reducere monolitten, er at trække eksisterende tjenester ud med omarbejdning. Når vi trækker eksisterende moduler ud, som de er, kan resultatet ikke altid tilfredsstille udviklerne, og forretningsprocessen kan være blevet forældet siden funktionaliteten blev skabt. Gennem refactoring kan vi understøtte den nye forretningsproces, fordi forretningskravene konstant ændrer sig. Vi kan forbedre kildekoden, fjerne kendte fejl og skabe en mere kvalitetsfuld datamodel. Der opnås mange fordele.
Adskillelse af tjenester med omarbejdning er uadskilleligt forbundet med begrebet begrænset kontekst. Dette er et begreb fra domæneorienteret design. Det betyder et område af domænemodellen, hvor alle termer i et fælles sprog er entydigt defineret. Lad os tage et eksempel med konteksterne for forsikringer og konti. Vi har en monolitisk applikation, og vi skal arbejde med kontoen i forbindelse med forsikringer. Vi forventer, at udvikleren finder en eksisterende klasse 'Konto' i en anden samling, laver et link til den fra klassen 'Forsikring', og vi får fungerende kode. DRY-princippet vil blive overholdt, og opgaven vil blive udført hurtigere ved at bruge eksisterende kode.
Det viser sig, at konteksterne for regninger og forsikringer er relaterede. Når nye krav opstår, vil denne forbindelse forstyrre udviklingen, hvilket øger kompleksiteten i en allerede kompleks forretningslogik. For at løse dette problem er det nødvendigt at finde grænserne mellem konteksterne i koden og fjerne deres overtrædelser. For eksempel vil forsikringskonteksten muligvis være tilstrækkelig med et 20-cifret konto-nummer fra centralbanken og datoen for kontoens oprettelse.
For at adskille disse begrænsede kontekster fra hinanden og starte processen med at udskille mikrotjenester fra den monolitiske løsning, anvendte vi en tilgang som at skabe eksterne API'er inde i applikationen. Hvis vi vidste, at en bestemt modul skulle blive til en mikrotjeneste, eller ændres i behandlingen, så lavede vi straks opkald til logik, der tilhørte en anden begrænset kontekst, gennem eksterne opkald. For eksempel via REST eller WCF.
Vi har besluttet, at vi ikke vil undgå kode, der kræver at lave distribuerede transaktioner. I vores tilfælde viste det sig at være ganske let at overholde denne regel. Indtil nu er der ikke opstået situationer, hvor der virkelig er behov for hårde distribuerede transaktioner - det er tilstrækkeligt med den endelige konsistens mellem modulerne.
Lad os overveje et konkret eksempel. Vi har begrebet en orkestrator - en pipeline, der behandler enheden 'anmodning'. Den skaber sekventielt en kunde, en konto og et betalingskort. Hvis kunden og kontoen er oprettet med succes, men oprettelsen af kortet mislykkes, går anmodningen ikke over i status 'succesfuld' og forbliver i status 'kort ikke oprettet'. I fremtiden vil baggrundsaktiviteten opsnappe den og afslutte den. Systemet er i nogen tid i en tilstand af inkonsistens, men det generelt tilfredsstiller os.
I tilfælde af at der faktisk opstår en situation, hvor det bliver nødvendigt at gemme en del af dataene konsistent, vil vi sandsynligvis gå i retning af at konsolidere servicen for at behandle det i én proces.
Lad os overveje et eksempel på udskillelse af en mikrotjeneste. Hvordan kan vi forholdsvis sikkert bringe den til produktion? I dette eksempel har vi en separat del af systemet - modulet til lønadministration, hvor en del af koden, vi gerne vil gøre mikrotjeneste-baseret, befinder sig.
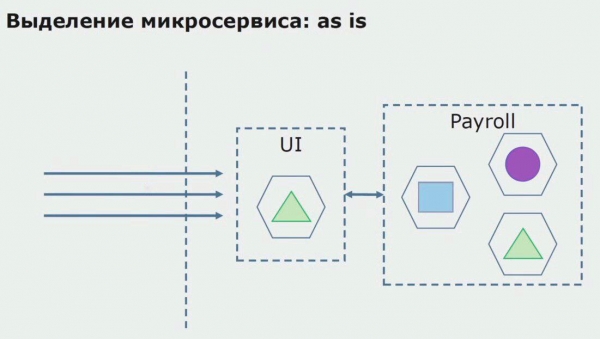
Først opretter vi en mikrotjeneste ved at omskrive koden. Vi forbedrer nogle aspekter, som vi ikke var tilfredse med. Vi implementerer nye forretningskrav fra kunden. Vi tilføjer et API Gateway i forbindelsen mellem UI og backend, som vil sørge for at videresende opkald.
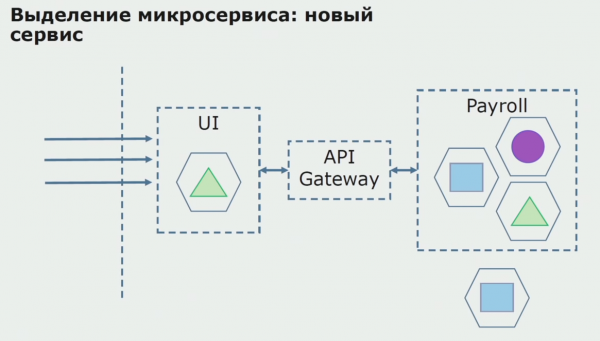
Derefter frigiver vi denne konfiguration til drift, men i pilottilstand. De fleste brugere arbejder stadig med de gamle forretningsprocesser. For nye brugere udvikler vi en ny version af den monolitiske applikation, som ikke længere indeholder denne proces. I praksis har vi en hybridmodel med monitoret og mikrotjenesten, der kører som pilot.
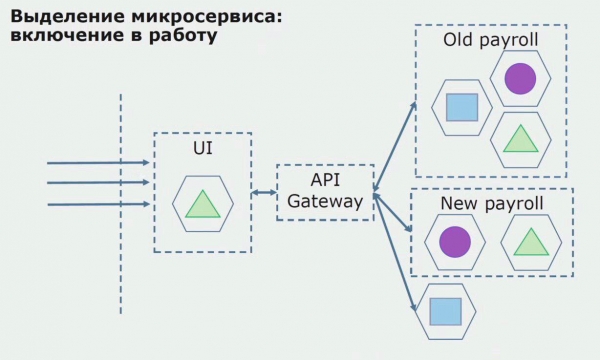
Ved en vellykket pilotforløb forstår vi, at den nye konfiguration faktisk fungerer og kan fjerne den gamle monolit fra ligningen og lade den nye konfiguration erstatte den gamle løsning.
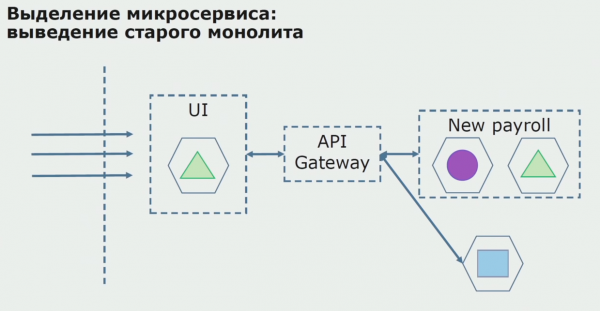
Alt i alt benytter vi stort set alle eksisterende metoder til at opdele kildekoden fra monolitten. Alle disse metoder gør det muligt for os at reducere størrelsen på applikationens dele og overføre dem til nye biblioteker, hvilket skaber en mere kvalitativ kildekode.
Arbejdet med databasen
Vores database er sværere at opdele end kildekoden, da den indeholder ikke kun den nuværende skema, men også akkumulerede historiske data.
Vores database, ligesom mange andre, havde en anden vigtig ulempe - dens enorme størrelse. Denne database blev designet i henhold til den komplekse forretningslogik i monolitten, og der er opstået forbindelser mellem tabeller i forskellige afgrænsede kontekster.
I vores tilfælde, som et endeligt problem (stor database, mange forbindelser, nogle gange uklare grænser mellem tabeller), opstod der et problem, der ses i mange store projekter: brugen af skabelonen shared database. Data blev hentet fra tabeller via views, gennem replikation og blev lastet op til andre systemer, hvor denne replikation var nødvendig. Som følge heraf kunne vi ikke adskille tabellerne i en separat skema, fordi de blev brugt aktivt.
I opdelingen hjælper den nævnte opdeling i afgrænsede kontekster os i koden. Det giver os generelt et ret godt indtryk af, hvordan vi opdele data på databasens niveau. Vi forstår, hvilke tabeller der tilhører en given afgrænset kontekst, og hvilke der tilhører en anden.
Vi har anvendt to globale metoder til at adskille databasen: adskillelse af eksisterende tabeller og adskillelse med omarbejdning.
Adskillelse af eksisterende tabeller er en metode, der er god at anvende, når datakonstruktionen er af høj kvalitet, opfylder forretningskravene og tilfredsstiller alle parter. I dette tilfælde kan vi isolere de eksisterende tabeller i et separat skema.
Adskillelse med omarbejdning er nødvendig, når forretningsmodellen har ændret sig markant, og tabellerne ikke længere tilfredsstiller vores behov.
Adskillelse af eksisterende tabeller. Vi skal definere, hvad vi vil adskille. Uden denne viden kan vi ikke komme videre, og her kan vi få hjælp fra opdeling af begrænsede kontekster i koden. Som regel, hvis vi kan forstå grænserne for kontekster i kildekoden, bliver det klart, hvilke tabeller der skal inkluderes i adskillelseslisten.
Forestil dig, at vi har en løsning, hvor to moduler af monolitten interagerer med én database. Vi skal sørge for, at kun én modul interagerer med de adskilte tabeller, mens det andet begynder at interagere med den via API. For nu er det tilstrækkeligt, at der kun sker skrivning gennem API'en. Dette er en nødvendig betingelse for, at vi kan tale om mikroservices' uafhængighed. Læsninger kan forblive, så længe der ikke er store problemer med det.
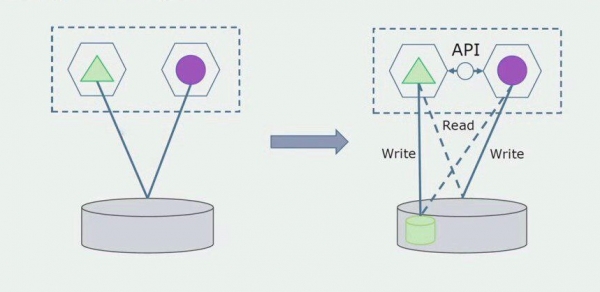
I næste skridt kan vi allerede isolere den kode, der arbejder med de adskilte tabeller, med eller uden omarbejdning, i en separat mikroservice og køre den i en separat proces eller container. Det vil være en selvstændig service med forbindelse til monolitens database og de tabeller, der ikke direkte relaterer sig til den. Monolitten interagerer stadig med den adskilte del på læsesiden.
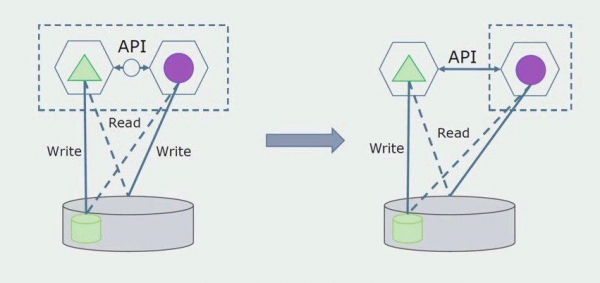
Senere vil vi fjerne denne forbindelse, hvilket betyder, at læsning af data fra monolitapplikationen fra de adskilte tabeller også vil blive overført til API.
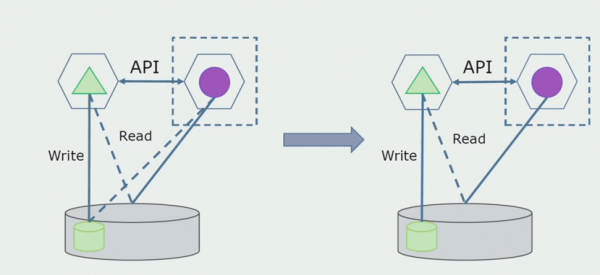
Dernæst vil vi isolere de tabeller fra den samlede database, som kun den nye mikroservice arbejder med. Vi kan flytte tabellerne til et separat skema eller endda til en separat fysisk database. Der er stadig en læseforbindelse mellem mikroservicen og monolitens database, men der er intet galt i det, og i denne konfiguration kan den eksistere i lang tid.
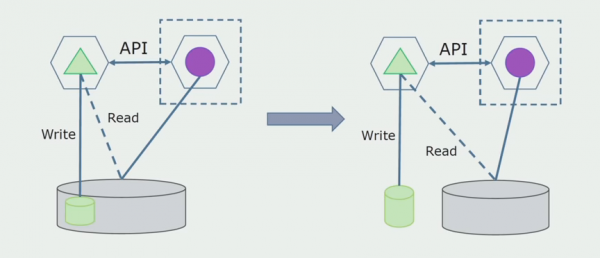
Det sidste skridt er at fjerne alle forbindelser helt. I denne forbindelse kan det være, at vi har brug for datamigrering fra hoveddatabasen. Nogle gange ønsker vi at genbruge nogle replicerede data eller registre fra eksterne systemer i flere databaser. Dette sker periodisk hos os.
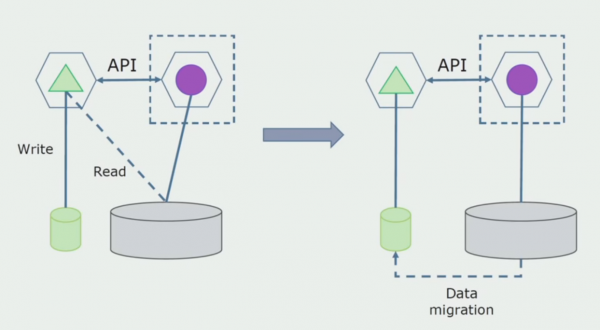
Afdeling med omarbejdning. Denne metode ligner meget den første, blot i omvendt rækkefølge. Vi opretter straks en ny database og en ny mikrotjeneste, som interagerer med monolitten via API. Men der forbliver et sæt databaser, som vi på sigt ønsker at fjerne. Vi behøver det ikke længere, vi har erstattet det i den nye model.
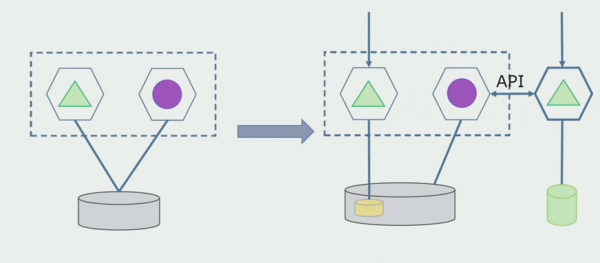
For at denne ordning kan fungere, har vi sandsynligvis brug for en overgangsperiode.
Dernæst er der to mulige tilgange.
Første: vi duplikerer alle data i den nye og gamle database. I dette tilfælde opstår der datadublering, og der kan opstå synkroniseringsproblemer. Men vi kan tage to forskellige kunder. Den ene arbejder med den nye version, den anden med den gamle.
Anden: vi opdeler data efter et forretningskriterium. For eksempel havde vi 5 produkter i systemet, der blev opbevaret i den gamle database. Den sjette placerer vi i den nye database i forbindelse med en ny forretningsopgave. Men vi har brug for en API Gateway, der synkroniserer disse data og viser kunden, hvor og hvad de skal hente.
Begge tilgange er anvendelige, vælg afhængigt af situationen.
Når vi er sikre på, at alt fungerer, kan den del af monolitten, der arbejder med de gamle database- strukturer, slukkes.
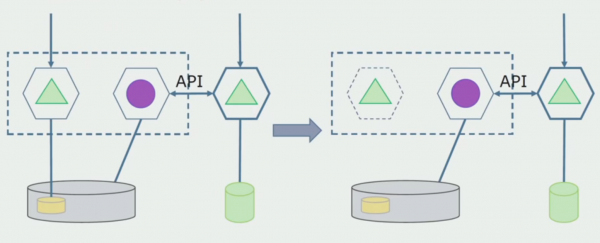
Det sidste skridt bliver at fjerne de gamle datastrukturer.
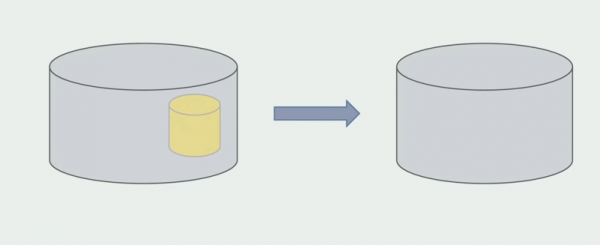
Sammenfattende kan man sige, at vi står over for problemer med databaserne: det er sværere at arbejde med dem i forhold til kildekoden, sværere at dele op, men det kan og skal gøres. Vi har fundet nogle metoder, der gør det muligt at gøre det forholdsvis sikkert; det er stadig lettere at lave fejl med data end med kildekode.
Arbejdet med kildekoden
Sådan så skemaet for kildekoden ud, da vi begyndte at analysere det monolitiske projekt.
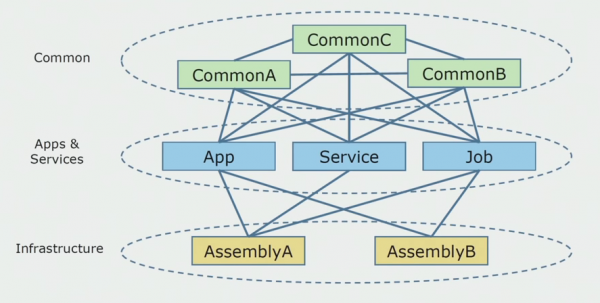
Den kan betragtes som opdelt i tre lag. Det er laget af kørende moduler, plugins, tjenester og individuelle aktiviteter. Faktisk var det indgangspunkter inden for den monolitiske løsning. Alle var fast forbundet med laget Common. Her var der forretningslogik, som blev delt af tjenesterne, samt mange forbindelser. Hver tjeneste og plugin brugte op til 10 og flere common-samlinger, afhængigt af deres størrelse og udviklernes integritet.
Vi var heldige at have infrastrukturbiblioteker, som kunne bruges separat.
Nogle gange opstod der situationer, hvor visse Common-objekter faktisk ikke tilhørte dette lag, men var infrastrukturbiblioteker. Dette blev løst ved omdøbning.
De mest bekymrende var begrænsede kontekster. Nogle gange blev 3-4 kontekster blandet i én Common-samling og brugte hinanden inden for de samme forretningsfunktioner. Det var nødvendigt at forstå, hvor de kunne opdeles, hvilke grænser der skulle bruges, og hvad der skulle gøres videre med mappingen af denne opdeling til kildekode-samlingerne.
Vi formulerede nogle regler for kodeopdelingsprocessen.
Først: vi ønskede ikke længere at dele forretningslogik mellem tjenester, aktiviteter og plugins. Vi ønskede at gøre forretningslogikken uafhængig inden for mikrotjenester. På den anden side betragtes mikrotjenester, ideelt set, som tjenester, der eksisterer fuldstændigt uafhængigt. Jeg mener, at denne tilgang er noget spild af ressourcer, og det er svært at nå, da tjenester i C# alligevel vil være forbundet med standardbiblioteket. Vores system er skrevet i C#, og vi har ikke haft brug for at anvende andre teknologier. Derfor besluttede vi, at vi kunne tillade os at bruge fælles tekniske samlinger. Det vigtigste er, at der ikke er nogen fragmenter af forretningslogik i dem. Hvis du har en praktisk indpakning til ORM, som du bruger, så er det meget dyrt at kopiere den fra tjeneste til tjeneste.
Vores team er tilhængere af domænespecifik design, så "løgarkitektur" er en perfekt pasform for os. Grundlaget for vores tjenester blev ikke data access layer, men en samling med domænelogik, som kun indeholder forretningslogik og er fri for forbindelser til infrastrukturen. På den måde kan vi uafhængigt videreudvikle domænesamlingen for at løse problemer relateret til rammerne.
På dette stadium stødte vi på det første alvorlige problem. Tjenesten skulle referere til en domænesamling, mens vi ønskede at gøre logikken uafhængig, og DRY-princippet kom os i vejen. Udviklerne ønskede at genbruge klasser fra nærliggende samlinger for at undgå duplicering, hvilket førte til, at domænerne igen begyndte at binde sig til hinanden. Vi analyserede resultaterne og besluttede, at problemet måske også lå i strukturen af kildekoden. Vi havde et stort repository, hvor alle kilderne lå. Det var meget svært at samle løsningen for hele projektet på en lokal maskine. Derfor blev der oprettet separate små løsninger for dele af projektet, og ingen forhindrede os i at tilføje en common- eller domænesamling og genbruge den. Det eneste værktøj, der ikke tillod os dette, var kodegennemgang. Men nogle gange svigtede det også.
Så vi begyndte at skifte til en model med separate repositories. Forretningslogikken stoppede med at flyde fra tjeneste til tjeneste, og domænerne blev virkelig uafhængige. Afgrænsede kontekster understøttes mere klart. Hvordan genbruger vi de infrastrukturelle biblioteker? Vi adskilte dem i et separat repository, og derefter placerede vi dem i Nuget-pakker, som vi lagde i Artifactory. Ved enhver ændring sker samling og offentliggørelse automatisk.
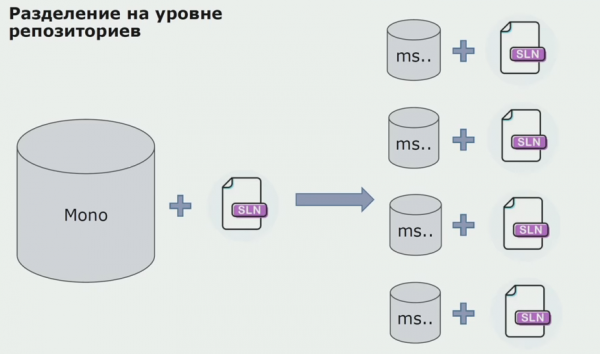
Vores tjenester begyndte at referere til interne infrastrukturelle pakker præcis ligesom eksterne. Vi downloader eksterne biblioteker fra Nuget. For at arbejde med Artifactory, hvor vi lagde disse pakker, anvendte vi to pakkehåndteringssystemer. I små repositories brugte vi også Nuget. I repositories med flere tjenester brugte vi Paket, som sikrer mere konsistens i versioner mellem moduler.
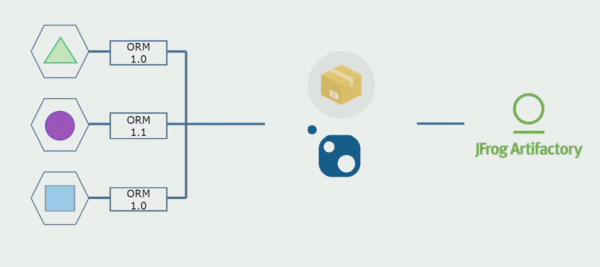
Der arbejdet med kildekoden, ved at ændre arkitekturen lidt og adskille repository'er, gør vi vores tjenester mere uafhængige.
Problemer med infrastrukturen
De fleste ulemper ved overgangen til mikroservices er relateret til infrastrukturen. Du vil få brug for automatiseret implementering og nye biblioteker til at styre infrastrukturen.
Håndinstallation i miljøer
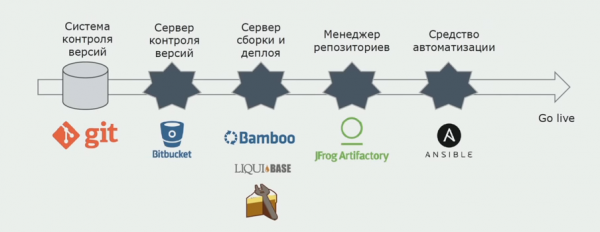
Oprindeligt installerede vi løsningen manuelt. For at automatisere denne proces oprettede vi en CI/CD-pipeline. Vi valgte en continuous delivery-proces, fordi continuous deployment endnu ikke er acceptabelt for os i forhold til forretningsprocesserne. Derfor sker implementeringen ved et klik, mens testen sker automatisk.
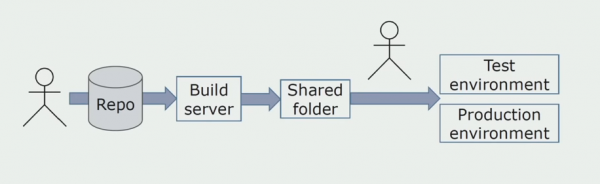
Vi bruger Atlassian, Bitbucket til opbevaring af kildekoder og Bamboo til bygninger. Vi kan lide at skrive build-scripts i Cake, fordi det er det samme som C#. I Artifactory kommer klar pakkede versioner, og Ansible overfører automatisk til testserverne, hvorefter de kan testes med det samme.
Separat logning
Engang var en af idéerne ved monolitten at sikre fælles logning. Vi skulle også finde ud af, hvad vi skulle gøre med de enkelte logs, der ligger på diske. Logs skrives til tekstfiler. Vi besluttede at bruge det standard ELK-stack. Vi valgte ikke at skrive direkte til ELK gennem udbyderne, men besluttede, at vi ville forbedre tekstlogs og registrere sporings-ID'er som identifikatorer, ved at tilføje tjenestens navn, så vi senere kunne analysere disse logs.
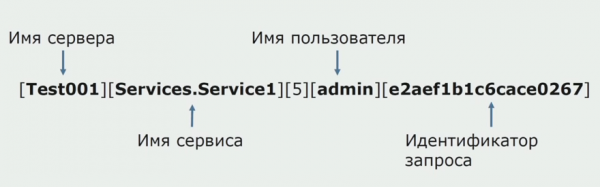
Ved hjælp af Filebeat får vi mulighed for at indsamle vores logs fra servere, og derefter konvertere dem, bruge Kibana til at opbygge forespørgsler i UI og se, hvordan kaldet skete mellem tjenesterne. Dette hjælper meget med sporings-ID'et.
Test og fejlfinding af relaterede tjenester
Oprindeligt forstod vi ikke helt, hvordan vi skulle debugge de udviklede tjenester. Det var simpelt med monolitten, vi kørte den på den lokale maskine. Vi forsøgte først også at gøre det med mikrotjenester, men nogle gange kræver en fuldstændig lancering af en mikrotjeneste, at flere andre også startes, hvilket er lidt besværligt. Vi indså, at vi var nødt til at skifte til en model, hvor vi kun efterlader den tjeneste eller de tjenester, vi vil debugge, på den lokale maskine. Resten af tjenesterne bruges fra servere, der matcher konfigurationen med produktion. Efter debugging, ved testning, udleveres kun de ændrede tjenester til testserveren for hver opgave. På den måde testes løsningen i den form, som den i fremtiden vil være i produktion.
Der er servere, hvor kun produktionsversionerne af tjenesterne er installeret. Disse servere er nødvendige i tilfælde af hændelser, til kontrol af leverancer før deployment og til intern træning.
Vi har introduceret en proces for automatisk testning ved hjælp af det populære bibliotek Specflow. Tests udføres automatisk med NUnit lige efter implementeringen fra Ansible. Hvis dækningen for en opgave er helt automatisk, er der ikke behov for manuel testning. Selvom der nogle gange stadig kræves yderligere manuel testning. For at bestemme, hvilke tests der skal køres for en given opgave, bruger vi tags i Jira.
Derudover er behovet for belastningstestning steget; det blev tidligere kun udført sjældent. Til at køre testene bruger vi JMeter, til opbevaring InfluxDB, og til at opbygge grafer over processen Grafana.
Hvad har vi opnået?
For det første har vi fjernet begrebet 'release'. Der er ikke længere to-måneders kolossale releases, hvor denne kolos blev implementeret i produktionsmiljøet og midlertidigt brød forretningsprocesserne. Nu implementerer vi tjenester i gennemsnit hver 1,5 dag, grupperet, fordi de træder i kraft efter godkendelse.
I vores system er der ingen fatale fejl. Hvis vi udgiver en mikrotjeneste med en fejl, vil den tilknyttede funktionalitet være brudt, mens al anden funktionalitet ikke vil blive påvirket. Dette forbedrer brugeroplevelsen betydeligt.
Vi kan styre implementeringsskemaet. Det er muligt at adskille grupper af tjenester fra resten af løsningen, hvis der er behov for det.
Derudover har vi betydeligt minimeret problemet med lange ventelister til forbedringer. Vi har fået separate produktteams, der arbejder med nogle af tjenesterne uafhængigt. Her passer Scrum-processen godt. Et konkret team kan have en separat produktejer, som sætter opgaver for dem.
CV
- Mikrotjenester er velegnede til dekomponering af komplekse systemer. I processen begynder vi at forstå, hvad der findes i vores system, hvilke begrænsede kontekster der er, hvor deres grænser ligger. Dette gør det muligt at fordele forbedringer korrekt blandt modulerne og undgå kodeforvirring.
- Mikrotjenester giver organisatoriske fordele. De omtales ofte kun som en arkitektur, men enhver arkitektur er nødvendig for at imødekomme forretningsbehov, ikke af sig selv. Derfor kan vi sige, at mikrotjenester er velegnede til at løse opgaver med små teams, især nu hvor Scrum er meget populært.
- Adskillelse er en iterativ proces. Man kan ikke tage en applikation og simpelthen opdele den i mikrotjenester. Det resulterende produkt vil næppe være funktionelt. Ved at opdele mikrotjenester er det fordelagtigt at omskrive eksisterende legacy, dvs. at omdanne det til kode, som vi kan lide, og som bedre opfylder forretningens krav til funktionalitet og hastighed.
En lille advarsel: omkostningerne ved at overgå til mikrotjenester er betydelige. Der gik meget tid på at løse infrastrukturproblemet. Så hvis du har en lille applikation, der ikke kræver specifik skalering, hvis der ikke er mange kunder, der kæmper om opmærksomheden og tiden fra dit team, så er mikrotjenester måske ikke det, du har brug for i dag. Det er ret dyrt. Hvis man starter processen med mikrotjenester, vil omkostningerne i starten være højere end hvis det samme projekt startes med udviklingen af et monolit.
P.S. En mere følelsesladet fortælling (som om det var personligt til dig) – ved .
Her er den fulde version af rapporten.
Kilde: habr.com
