

For nylig fortalte jeg, hvordan man kan bruge standardopskrifter fra PostgreSQL-databasen. I dag vil jeg tale om, hvordan man kan gøre skriveoperationer i databasen mere effektive uden at bruge nogen "drejeknapper" i konfigurationen - blot ved at organisere datastreams korrekt.
#1. Секционирование
Artiklen handler om, hvordan og hvorfor man bør organisere har allerede været, men her vil jeg tale om praksis med at anvende nogle tilgange inden for vores .
"Det var engang..."
Oprindeligt, som ethvert MVP, startede vores projekt under en relativt lille belastning - overvågning blev kun udført for et dusin af de mest kritiske servere, og alle tabeller var relativt kompakte... Men tiden gik, antallet af overvågede værter voksede, og da vi endnu en gang forsøgte at gøre noget med en af tabellerne på 1,5 TB, indså vi, at det var muligt at leve sådan, men meget besværligt.
Tiderne var næsten mytologiske, forskellige versioner af PostgreSQL 9.x var aktuelle, så al partitionering måtte gøres "manuelt" - gennem tabelarv og triggere ruting med dynamisk EXECUTE.
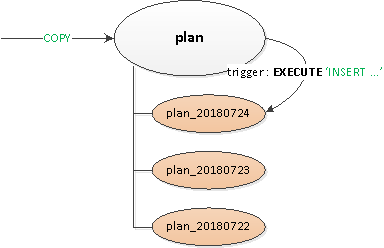
Den resulterende løsning viste sig at være tilstrækkelig alsidig til at kunne overføres til alle tabeller:
- Der blev erklæret en tom "overskridende" forælder tabel, hvor alle nødvendige indekser og triggere blev beskrevet..
- Skrivning fra klientens perspektiv blev foretaget i den "rodnede" tabel, og indeni blev det med hjælp fra routing-triggeren
BEFORE INSERTfysisk indsat i den nødvendige sektion. Hvis en sådan ikke eksisterede endnu - fangede vi en undtagelse og … - … hjalp ved at ifølge skabelonen for forælder-tabellen blev der oprettet en sektion med en begrænsning på den nødvendige dato, så ved dataudtrækning blev læsningen kun udført i den.
PG10: første forsøg
Men partitioneringen gennem arv har historisk set ikke været særlig godt egnet til arbejdet med aktiv skriveflow eller et stort antal sektioner som afkom. For eksempel kan vi huske, at algoritmen til valg af den nødvendige sektion havde kvadratisk kompleksitet, hvilket ved 100+ sektioner fungerer, som man kan forstå...
I PG10 blev denne situation betydeligt optimeret ved at implementere understøttelse af Derfor prøvede vi straks at anvende det efter migrationen af lageret, men…
Som det viste sig efter at have gennemgået manualen, understøtter den natively sektionerede tabel i denne version:
- understøtter ikke beskrivelse af indekser
- understøtter ikke triggere
- kan ikke være nogen 'efterkommer'
- understøtter ikke
INSERT ... ON CONFLICT - kan ikke generere sektion automatisk
Efter at have fået en god ordre med en rake i hovedet, indså vi, at vi ikke kunne undgå at modificere appen, og vi udskød yderligere undersøgelser i et halvår.
PG10: en ny chance
Så vi begyndte at løse de opståede problemer én ad gangen:
- Da triggere og
ON CONFLICTviste sig at være nødvendige et par steder, lavede vi en midlertidig proxy-tabel. - Vi fjernede 'routing' i triggere – hvilket vil sige
EXECUTE. - Vi udspecificerede skabelon-tabellen med alle indekser, så de ikke engang var til stede på proxy-tabellen.
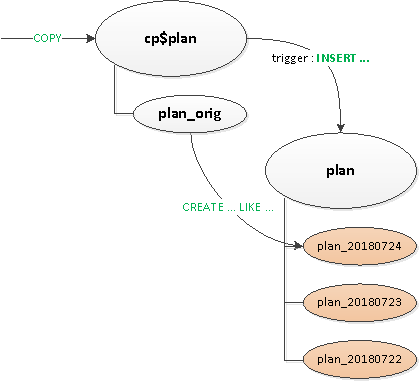
Endelig, efter alt dette, lavede vi natively en sektion af hovedtabellen. Oprettelsen af en ny sektion forblev stadig på applikationens samvittighed.
Vi 'skærer' domæner
Som i ethvert analytisk system havde vi også fakta og dimensioner (domæner). I vores tilfælde var det for eksempel ensartede langsomme forespørgsler eller selve forespørgslen.
Fakta havde vi allerede sektioneret efter dage i lang tid, så vi kunne roligt slette forældede sektioner, hvilket ikke generede os (logs jo!). Men med domænerne opstod der problemer…
Det er ikke, at der var så mange af dem, men omkring for 100TB 'fakta' havde vi et domæne på 2.5TB.Fra sådan en tabel er det nemt ikke at kunne slette noget, ikke at kunne komprimere det på en rimelig tid, og indsendelse til det blev gradvist langsommere.
Det ser ud til, at domænet... hver post skal præsenteres præcist én gang… og det er rigtigt, men!.. Ingen forhindrer os i at have et separat domæne for hver dag! Ja, det giver en vis redundans, men det gør det muligt at:
- skrive/læse hurtigere på grund af den mindre størrelse af sektionen
- forbruge mindre hukommelse ved at arbejde med mere kompakte indekser
- opbevare færre data ved at kunne hurtigt slette forældede
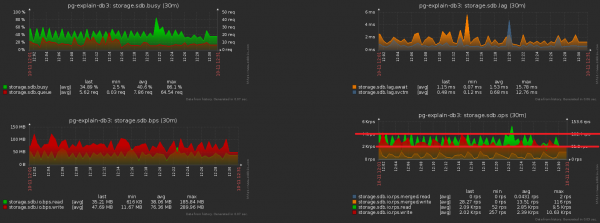
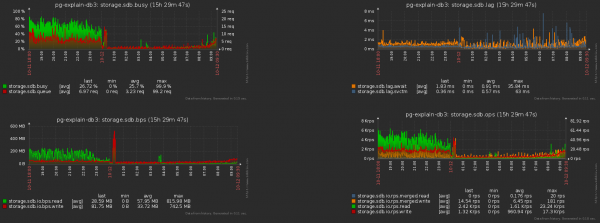
Som et resultat af hele denne proces blev CPU-belastningen reduceret med ca. 30%, mens diskbelastningen faldt med ca. 50%:
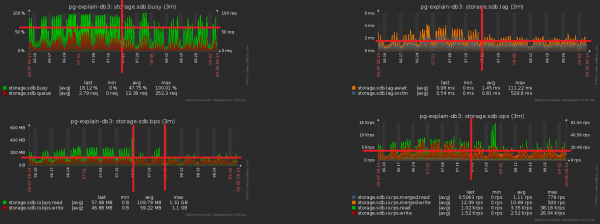
Samtidig fortsatte vi med at skrive nøjagtig det samme til databasen, blot med mindre belastning.
#2. Эволюция и рефакторинг БД
Så vi stoppede ved det punkt, at vi har en sektion for hver dag med data. Rent faktisk, CHECK (dt = '2018-10-12'::date) — og det er partitioneringsnøglen og betingelsen for at placere posten i den specifikke sektion.
Da alle rapporter i vores service opbygges i forhold til en specifik dato, så var indeksene allerede fra de "upartitionerede tider" alle af typen (Server, Dato, Skabelonplan), (Server, Dato, Plan node), (Dato, Fejlkode, Server),…
Men nu bor der på hver sektion sine egne instanser af hver af disse indekser… Og inden for hver sektion er datoen en konstant… Så nu skriver vi simpelthen konstanten ind i hvert sådant indeks som et af felterne, hvilket øger både dets volumen og søgetid, men ikke bringer nogen resultater. Vi har gjort tingene sværere for os selv, ups… Retningen for optimeringen er åbenlys — vi fjerner blot
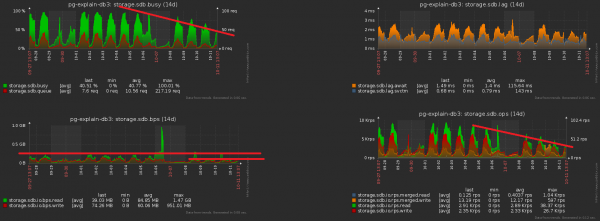
feltet med datoen fra alle indekser på partitionerede tabeller. Med vores volumer er besparelsen omkring 1TB/uge Og nu lad os bemærke, at denne terabyte endnu skal skrives. Altså skal vi også!
belaste disken mindre nu ! På dette billede er den opnåede effekt fra den rensning, som vi dedikerede en uge til, godt synlig:En af de store problemer i belastede systemer er
#3. «Размазываем» пиковую нагрузку
overflødig synkronisering af operationer, som ikke kræver det. Nogle gange "fordi vi ikke lagde mærke til det", nogle gange "fordi det var lettere", men før eller siden må vi slippe af med den. Vi nærmer os det forrige billede — og ser, at disken her
"trækker" med en belastning med dobbelt amplitude mellem nærliggende målinger, hvilket åbenlyst ikke burde være "statistisk" givet det antal operationer: Det er ret enkelt at opnå. Vi havde allerede registreret
næsten 1000 servere , hver behandles af en separat logisk strøm, og hver strøm sender den samlede information til databasen med en bestemt frekvens, omtrent sådan:setInterval(sendToDB, interval)
Problemet ligger lige præcis i, atalle strømme starter omtrent samtidig , så sendetidspunkterne næsten altid falder sammen "til punktet". Ups nr. 2…Heldigvis er det relativt let at rette,
ved at tilføje en "tilfældig" forskydning i tid: setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Den tredje traditionelle highload-problem er manglende cache der, hvor det kunne bør være.
For eksempel har vi lavet muligheden for at analysere efter planens noder (alle disse Seq Scan on users), men at tænke på, at de stort set er ens – glemte vi.
Nej, selvfølgelig skrives der ikke noget tilbage til databasen, det lukker triggeren med INSERT ... ON CONFLICT DO NOTHING. Men dataene når alligevel databasen, og der er også unødvendig læsning til konfliktkontrol man bliver nødt til at lave. Ups nr. 3…
Forskellen i antallet af registreringer sendt til databasen før/efter aktivering af caching er tydelig:
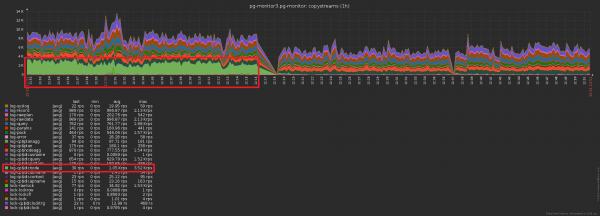
Og dette er det ledsagende fald i belastningen på lageret:
I alt
«Terabyte-per-dag» lyder skræmmende. Hvis du gør alt rigtigt, er det bare 2^40 bytes / 86400 sekunder = ~12.5MB/s, hvilket selv desktop IDE-hukommelsesenheder kunne håndtere. 🙂
Og hvis vi taler seriøst, så kan du selv med en ti gange "skæv” belastning i løbet af dagen nemt holde dig inden for mulighederne for moderne SSD'er.
Kilde: habr.com
