

I de dage, hvor Kubernetes stadigvæk var v1.0.0, fandtes der plugins til volumener. De blev brugt til at tilslutte Kubernetes til systemer til opbevaring af persistente data fra containere. Antallet var begrænset, og blandt de første var lagerudbydere som GCE PD, Ceph, AWS EBS og andre.
Plugins blev leveret sammen med Kubernetes, og derfor fik de navnet in-tree. Men mange fandt det eksisterende udvalg utilstrækkeligt. Håndværkere tilføjede enkle plugins til Kubernetes-kernen via patches, hvorefter de samlede deres egen version af Kubernetes og installerede den på deres servere. Men med tiden indså udviklerne af Kubernetes, at problemet ikke kan løses. Folk har brug for en fiskestang . Og i frigivelsen af Kubernetes v1.2.0 dukkede den op…Flexvolume-plugin: en simpel fiskestang
Udviklerne af Kubernetes skabte FlexVolume-plugin'et, der var en logisk indpakning af variable og metoder til at arbejde med de af eksterne udviklere implementerede Flexvolume-drivere.
Lad os stoppe op og se nærmere på, hvad FlexVolume-driveren er. Det er en form for
eksekverbar fil (binær fil, Python-script, Bash-script, osv.), der ved udførelse tager arguments fra kommandolinjen og returnerer en besked med på forhånd kendte felter i JSON-format. Den første argument i kommandolinjen er ifølge konvention altid metoden, mens de øvrige argumenter er dens parametre. Schemaet for tilslutning af CIFS Shares i OpenShift. Flexvolume-driveren er lige i centrum
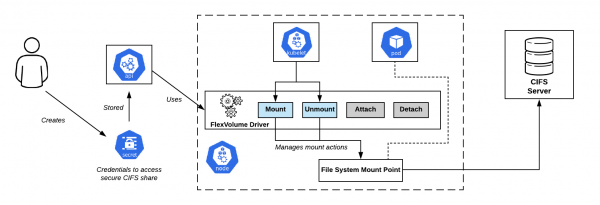
Minimumsudvalget af metoder
flexvolume_driver mount # ansvarlig for at knytte volumen til pod'en # Format for den returnerede besked: { "status": "Success"/"Failure"/"Not supported", "message": "Hvorfor denne status blev returneret", }flexvolume_driver unmount # ansvarlig for at fjerne volumen fra pod'en # Format for den returnerede besked: { "status": "Success"/"Failure"/"Not supported", "message": "Hvorfor denne status blev returneret", }flexvolume_driver init # ansvarlig for at initialisere plugin'et # Format for den returnerede besked: { "status": "Success"/"Failure"/"Not supported", "message": "Hvorfor denne status blev returneret", // Angiver om driveren bruger metoderne attach/detach "capabilities": {"attach": True/False} } ser sådan ud:
Brugen af metoderne attach detach og vil bestemme scenariet, som kubelet i fremtiden vil handle efter, når driveren kaldes. Der findes også særlige metoder expandvolume expandfs og udvidfs, der ansvarer for dynamisk ændring af volumestørrelsen.
Som et eksempel på de ændringer, som metoden tilføjer expandfs, og sammen med det — muligheden for at ændre størrelsen på volumener i realtid, kan du se nærmere på i Rook Ceph Operator.
Her er et eksempel på implementering af Flexvolume-driveren til arbejde med NFS:
usage() {
    err "Ugyldig brug. Brug: "
    err "t$0 init"
    err "t$0 mount <mount dir> <json params>"
    err "t$0 unmount <mount dir>"
    exit 1
}

err() {
    echo -ne $* 1>&2
}

log() {
    echo -ne $* >&1
}

ismounted() {
    MOUNT=`findmnt -n ${MNTPATH} 2>\/dev\/null | cut -d' ' -f1`
    if [ "${MOUNT}" == "${MNTPATH}" ]; then
        echo "1"
    else
        echo "0"
    fi
}

domount() {
    MNTPATH=$1

    NFS_SERVER=$(echo $2 | jq -r '.server')
    SHARE=$(echo $2 | jq -r '.share')

    if [ $(ismounted) -eq 1 ] ; then
        log '{"status": "Success"}'
        exit 0
    fi

    mkdir -p ${MNTPATH} &> \/dev\/null

    mount -t nfs ${NFS_SERVER}:\/\${SHARE} ${MNTPATH} &> \/dev\/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Failure", "message": "Kunne ikke montere ${NFS_SERVER}:${SHARE} på ${MNTPATH}"}"
        exit 1
    fi
    log '{"status": "Success"}'
    exit 0
}

unmount() {
    MNTPATH=$1
    if [ $(ismounted) -eq 0 ] ; then
        log '{"status": "Success"}'
        exit 0
    fi

    umount ${MNTPATH} &> \/dev\/null
    if [ $? -ne 0 ]; then
        err "{ "status": "Failed", "message": "Kunne ikke afmontere volumen på ${MNTPATH}"}"
        exit 1
    fi

    log '{"status": "Success"}'
    exit 0
}

op=$1

if [ "$op" = "init" ]; then
    log '{"status": "Success", "capabilities": {"attach": false}}'
    exit 0
fi

if [ $# -lt 2 ]; then
    usage
fi

shift

case "$op" in
    mount)
        domount $*
        ;;
    unmount)
        unmount $*
        ;;
    *)
        log '{"status": "Not supported"}'
        exit 0
esac

exit 1
Så efter forberedelsen af den eksekverbare fil er det nødvendigt at udrulle driveren i Kubernetes-klyngen.Driveren skal befinde sig på hver node i klyngen i henhold til en forudbestemt sti. Som standard er der valgt:
/usr/libexec/kubernetes/kubelet-plugins/volume/exec/имя_поставщика_хранилища~имя_драйвера/
… men ved brug af forskellige distributioner af Kubernetes (OpenShift, Rancher…) kan stien være anderledes.
Flexvolume-problemer: hvordan får man ruten ud?
At udrulle Flexvolume-driveren på nodene i klyngen viste sig at være en udfordrende opgave. Efter at have udført operationen én gang manuelt, risikerer man hurtigt, at der opstår nye noder i klyngen: på grund af tilføjelse af en ny node, automatisk horisontal skalering eller — hvad der er værre — udskiftning af en node på grund af fejl. I dette tilfælde er det nødvendigt at arbejde med lager på disse noder, ikke er muligt, indtil du manuelt tilføjer Flexvolume-driveren til dem.
Løsningen på dette problem var en af Kubernetes' primitive — DaemonSet. Når en ny node vises i klyngen, vil en pod fra vores DaemonSet automatisk blive placeret på den, og en lokal volumen vil blive tilknyttet stien for at finde Flexvolume-driverne. Ved en vellykket oprettelse kopierer pod'en de nødvendige filer til driverens drift på disken.
Her er et eksempel på et sådant DaemonSet til distribution af Flexvolume-plugin:
apiVersion: extensions/v1beta1
kind: DaemonSet
metadata:
  name: flex-set
spec:
  template:
    metadata:
      name: flex-deploy
      labels:
        app: flex-deploy
    spec:
      containers:
        - image:
          name: flex-deploy
          securityContext:
              privileged: true
          volumeMounts:
            - mountPath: /flexmnt
              name: flexvolume-mount
      volumes:
        - name: flexvolume-mount
          hostPath:
            path:
… og et eksempel på et Bash-script til distribution af Flexvolume-driveren:
#!/bin/sh

set -o errexit
set -o pipefail

VENDOR=k8s.io
DRIVER=nfs

driver_dir=$VENDOR${VENDOR:+"~"}${DRIVER}
if [ ! -d "/flexmnt/$driver_dir" ]; then
  mkdir "/flexmnt/$driver_dir"
fi

cp "/$DRIVER" "/flexmnt/$driver_dir/.$DRIVER"
mv -f "/flexmnt/$driver_dir/.$DRIVER" "/flexmnt/$driver_dir/$DRIVER"

while : ; do
  sleep 3600
done
Det er vigtigt ikke at glemme, at kopieringsoperationen ikke er atomar. Der er en stor sandsynlighed for, at kubelet vil begynde at bruge driveren, før forberedelsesprocessen er færdiggjort, hvilket vil medføre en fejl i systemets drift. En korrekt tilgang vil være først at kopiere driverens filer under et andet navn, hvorefter man anvender en atomar omdøbningsoperation.
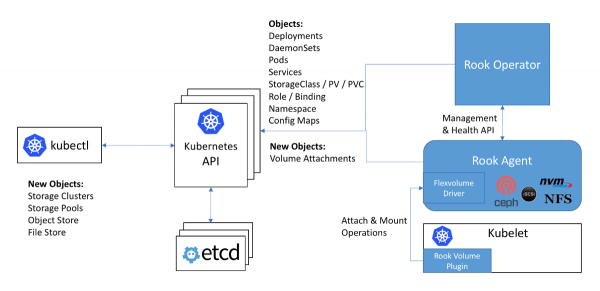
Arbejdsdiagram for Ceph i Rook-operatøren: Flexvolume-driveren er vist i diagrammet inden for Rook-agenten
Et andet problem ved brug af Flexvolume-drivere er, at for de fleste opbevaringsløsninger på noden i klyngen den nødvendige software skal være installeret (for eksempel ceph-common-pakken til Ceph). Oprindeligt var Flexvolume-plugin'en ikke designet til så komplekse systemer.
Den originale løsning på dette problem kan ses i implementeringen af Flexvolume-driveren i Rook-operatøren:
Selve driveren er implementeret som en RPC-klient. IPC-socketen til kommunikation ligger i samme mappe som selve driveren. Vi husker, at det ville være godt at bruge en DaemonSet til at kopiere driverens filer, som tilknytter en mappe med driveren som volumen. Efter at have kopieret de nødvendige driverfiler lever rook den pod ikke længere, men tilslutter sig IPC-socketen via det tilknyttede volumen som en fuldbyrdet RPC-server. Ceph-common-pakken er allerede installeret inde i pod'ens container. IPC-socketen sikrer, at kubelet vil kommunikere netop med den pod, der er på samme node som den. Alt genialt er enkelt!..
Farvel, vores kære… in-tree plugins!
Kubernetes-udviklerne har opdaget, at antallet af plugins til lagringssystemer inde i kernen er tyve. Enhver ændring i dem gennemgår en fuld frigivelsescyklus af Kubernetes.
For at bruge den nye version af lagringspluginet, skal hele klyngen opdateres. Derudover kan det overraske dig, at den nye version af Kubernetes pludselig bliver inkompatibel med den anvendte Linux-kerne… Så du tørrer dine tårer og, mens du knurrer tænderne, koordinerer du med ledelsen og brugerne hvornår opdateringen af Linux-kernen og Kubernetes-klyngen skal finde sted. Med muligheden for nedetid i tjenesteydelserne.
Situationen er mere end komisk, hvad synes du? Det blev klart for hele samfundet, at tilgangen ikke fungerer. Med beslutsomhed erklærer Kubernetes-udviklerne, at nye plugins til lagringssystemer ikke længere vil blive accepteret i kernen. Og for øvrigt, som vi allerede ved, blev der i implementeringen af Flexvolume-pluginet identificeret flere mangler…
Den nyeste tilføjelse til spørgsmålet om persistente datalagringer var pluginet til volumener i Kubernetes – CSI. Dets alfaversion, mere præcist omtalt som Out-of-Tree CSI Volume Plugins, blev annonceret i frigivelsen .
Container Storage Interface, eller spinning CSI 3000!
Først vil jeg gerne påpege, at CSI ikke blot er et volume plugin, men en sand til at oprette brugerdefinerede komponenter til datalagringssystemer. Det var meningen, at containerorkestreringssystemer, såsom Kubernetes og Mesos, skulle 'lære' at arbejde med komponenter implementeret efter denne standard. Og nu har Kubernetes allerede lært.
Hvordan fungerer CSI-pluginet i Kubernetes? CSI-pluginet arbejder med specielle drivere (CSI-drivere), der er skrevet af tredjepartsudviklere. En CSI-driver i Kubernetes skal minimalt bestå af to komponenter (pods):
- Controller — administrerer eksterne persistente lagringssystemer. Udgives i form af en gRPC-server, hvor den primitive
StatefulSet. - Node — håndterer montering af persistente lagringssystemer til klyngeknude. Også implementeret som en gRPC-server, men for den anvendes den primitive
DaemonSet.
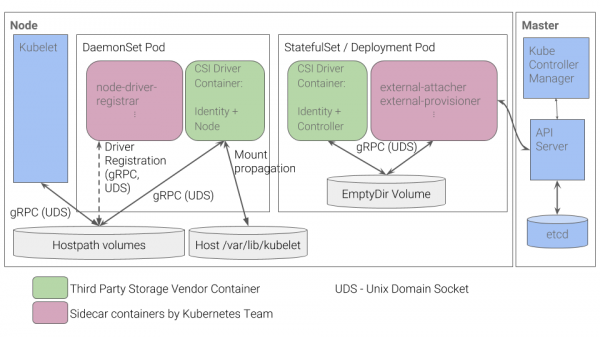
Arbejdsschemaet for CSI-pluginet i Kubernetes
Du kan finde ud af nogle andre detaljer om CSI's funktion, eksempelvis fra artiklen «», vi offentliggjorde for et år siden.
Fordele ved en sådan implementering
- For basic tasks — such as registering a driver for a node — Kubernetes developers have implemented a set of containers. There's no need to manually create a JSON response with capabilities, as was done for the Flexvolume plugin.
- Instead of 'injecting' executable files onto nodes, we now deploy pods into the cluster. This is what we initially expect from Kubernetes: all processes occur within containers deployed using Kubernetes primitives.
- To implement complex drivers, there is no longer a need to develop an RPC server and RPC client. The Kubernetes developers have already implemented the client for us.
- Passing arguments for operation via the gRPC protocol is much more convenient, flexible, and reliable than passing them via command-line arguments. To understand how to add metric support for volume usage in CSI by adding a standardized gRPC method, you can refer to for the vsphere-csi driver.
- Communication occurs through IPC sockets, so there's no confusion about which pod kubelet sent the request to.
Does this list remind you of anything? The advantages of CSI are the very solutions to the problemsthat were not considered during the development of the Flexvolume plugin.
Konklusioner
CSI as a standard for implementing custom plugins for interacting with data storage has been warmly received by the community. Moreover, due to its advantages and versatility, CSI drivers are being created even for storage solutions such as Ceph or AWS EBS, whose plugins were added back in the very first version of Kubernetes.
In early 2019, in-tree plugins . Support for the Flexvolume plugin is planned to continue, but no new features will be developed for it.
We already have experience using ceph-csi, vsphere-csi, and are ready to expand this list! So far, CSI is handling the tasks assigned to it remarkably well, and we will see how it goes from here.
Remember, all new is well-rethought old!
P.S.
Læs også på vores blog:
- «»;
- «»;
- «».
Kilde: habr.com
