

Hello, Habr!
I denne artikel vil vi begynde at fortælle om, hvordan det er indvendigt og hvilke teknologier der anvendes i dens udvikling.
Hvorfor mener vi, at dette er interessant? For det første, fordi platformen '1C:Enterprise 8' er en stor (mere end 10 millioner kode-linjer) applikation skrevet i C++ (klient, server osv.), JavaScript (webklient) og, for nylig, også . Store projekter er interessante blot på grund af deres omfang, da spørgsmål, der er usynlige i en lille kodebase, træder fuldt frem i sådanne projekter. For det andet er '1C:Enterprise' et massedistribueret, 'boks'-produkt, og der er meget få artikler om sådanne udviklinger på Habr. Og det er også altid interessant at finde ud af, hvordan andre teams og firmaer arbejder.
Så lad os komme i gang. I denne artikel vil vi give en oversigt over nogle af de teknologier, der anvendes i platformen, og skitsere landskabet uden at dykke dybt ned i implementeringen. For mange mekanismer vil en detaljeret beskrivelse kræve en særskilt artikel, og for nogle endda en hel bog!
For at starte med, skal vi definere nogle grundlæggende ting - hvad er platformen '1C:Enterprise' og hvilke komponenter består den af. Svaret på dette spørgsmål er ikke så simpelt, for under termen 'Platform' (for korthed vil vi kalde den således) forstås både et udviklingsværktøj til forretningsapplikationer, en køremiljø og administrationsværktøjer. Man kan groft sagt skelne mellem følgende komponenter:
- serverklynge
- 'tynd' klient, der kan oprette forbindelse til serveren via http og et eget binært protokol
- klient til arbejde i en to-lags arkitektur med en database, der er placeret på en harddisk eller netværksmappe
- webklient
- administrationsværktøjer til applikationsserveren
- udviklingsmiljø (kendt som Konfigurator)
- køremiljø til iOS, Android og Windows Phone (mobil platform for 1C)
Alle disse dele, bortset fra webklienten, er skrevet i C++. Derudover er der for nylig blevet annonceret , skrevet i Java.
Native applikationer
C++03 anvendes til udvikling af native applikationer. På Windows bruges Microsoft Visual C++ 12 (profil kompatibel med Windows XP) som kompilator, mens gcc 4.8 bruges til Linux og Android, og clang 5.0 til iOS. Den standardbibliotek, der anvendes, er ens for alle operativsystemer og kompilatorer — STLPort. Denne løsning reducerer sandsynligheden for fejl, der er specifik for STL-implementeringen. Vi planlægger nu overgangen til STL-implementeringen, der leveres med CLang, da STLPort har stoppet sin udvikling og ikke er kompatibelt med den aktiverede C++11 understøttelse i gcc.
Serverens kodebase er generelt 99% fælles, mens klientens er 95%. Desuden bruger selv mobilplatformen den samme C++-kode som den 'store' version, selvom graden af enhed der er noget lavere.
Som de fleste C++-brugere gør vi ikke krav på at udnytte 100% af sprog- og biblioteksfunktionerne. For eksempel anvender vi næsten ikke Boost, og blandt sprogfeatures er det dynamisk typecasting, vi sjældent bruger. Vi anvender dog aktivt:
- STL (især strenge, containere og algoritmer)
- flersidig arv, herunder flersidig arv af implementering
- skabeloner
- undtagelser
- smarte pointere (egen implementering)
Ved at anvende flersidig arv af interfaces (fuldstændigt abstrakte klasser) bliver en komponentmodel mulig, som vil blive beskrevet senere.
Komponenter
For at sikre modularitet er al funktion delt op i komponenter, som er dynamiske biblioteker (*.dll til Windows, *.so til Linux). I alt er der mere end 150 komponenter, vi vil give beskrivelser af nogle af dem:
backend
Indeholder 'motoren' for platformens metadata.
accnt
Objekterne, som applikationsudviklere bruger til at opbygge regnskab (kontoplaner og regnskabsregistre)
bsl
Motoren for udførelse af det indbyggede sprog.
nuke
Egen implementering af hukommelsesallokatoren.
dbeng8
Motoren for filbasen. En simpel fil-server database maskine baseret på ISAM, som også inkluderer en simpel SQL-proces.
wbase
Indeholder grundlæggende klasser og funktioner til realisering af Windows-brugerfladen — vinduesklasser, adgang til GDI osv.
Opdelingen i mange komponenter er nyttig ud fra flere perspektiver:
- Opdelingen fremmer bedre design, specielt en bedre isolering af koden.
- Fra komponenterne kan forskellige leveringsmuligheder sammensættes fleksibelt:
- For eksempel vil installationen af en tynd klient indeholde wbase, men ikke backend.
- og på serveren vil wbase omvendt ikke være til stede.
- Begge varianter vil naturligvis indeholde nuke og bsl.
Alle nødvendige komponenter til denne kørselsvariant indlæses ved programmets start. Dette er blandt andet nødvendigt for registreringen af SCOM-klasser, som der vil blive talt om nedenfor.
SCOM
Til dekomponering på et lavere niveau anvendes SCOM-systemet, som er ideologisk lig ATL-biblioteket. For dem, der ikke har arbejdet med ATL, nævnes nogle af hovedfunktionerne og egenskaberne kort.
For den specielt designede SCOM-klasse:
- Tilvejebringer fabriksmetoder, der muliggør skabelse af en klasse fra en anden komponent ved kun at kende dens navn (uden at afsløre implementeringen).
- Tilvejebringer infrastrukturen for smarte pegepinde med referencezælling. Der er ikke behov for manuelt at overvåge livscyklussen for SCOM-klassen.
- Muliggør at finde ud af, om et objekt implementerer en specifik grænseflade, og automatisk konvertere en pegepind til objektet til en pegepind til grænsefladen.
- Oprette en service-objekt, der altid er tilgængelig via metoden get_service osv.
For eksempel kan man i komponenten json.dll beskrive en klasse til læsning af JSON (for eksempel JSONStreamReader).
Klasser og instanser, der kan oprettes fra andre komponenter, skal registreres i SCOM-maskinen:
SCOM_CLASS_ENTRY(JSONStreamReader)
Denne makro vil beskrive en speciel statisk klasse-registrator, hvis konstruktor vil blive kaldt ved indlæsning af komponenten i hukommelsen.
Derefter kan der oprettes en instans i en anden komponent:
IJSONStreamReaderPtr jsonReader = create_instance<IJSONStreamReader>(SCOM_CLSIDOF(JSONStreamReader));
For at understøtte tjenester tilbyder SCOM en ekstra, ganske kompleks infrastruktur. Centralt i denne infrastruktur findes begrebet SCOM-proces, der fungerer som container for de kørte tjenester (dvs. fungerer som Service Locator) samt indeholder bindingen til lokaliserede ressourcer. SCOM-processen bindes til OS-tråden. Dette gør det muligt at få tjenester på følgende måde inden for applikationen:
SCOM_Process* process = core::current_process();
if (process)
         return get_service<IMyService>(process);
Desuden, ved at skifte mellem logiske (SCOM) processer knyttet til strømmen, kan man opnå praktisk uafhængige applikationer med hensyn til informationsrum, der kører inden for én strøm. Sådan er vores tynde klient designet, som arbejder med en filbaseret database – inden for én OS-proces er der to SCOM-processer, én knyttet til klienten og den anden til serveren. Denne tilgang muliggør en ensartet kodning, der fungerer både med lokalt filsystem og i en "ægte" klient-server version. Prisen for sådan ensartethed er overhead, men erfaring viser, at det er det værd.
På baggrund af den komponentbaserede model SCOM er både forretningslogikken og brugerfladedelen af 1C: Enterprise implementeret.
Brugergrænseflade
For øvrigt, hvad angår brugerflader. Vi bruger ikke standard Windows-kontroller; vores betjeningselementer er direkte implementeret på Windows API. Til Linux-versionen er der lavet et lag, der arbejder gennem wxWidgets-biblioteket.
Biblioteket af kontrolelementer er uafhængigt af andre dele af "1C: Enterprise" og bruges af os i flere små interne værktøjer.
Gennem årene har udseendet af kontrollerne ændret sig, men der skete kun én væsentlig ændring af principperne, nemlig i 2009 med udgivelsen af version 8.2 og introduktionen af "styrede formularer". Udover ændringer i udseendet blev principperne for formularlayouts fundamentalt ændret – der blev opgivet pixel-for-pixel placering af elementer til fordel for flow-layout af elementer. Desuden arbejder kontrolelementerne i den nye model ikke direkte med domæneobjekter, men med særlige DTO ().
Disse ændringer har gjort det muligt at skabe webklienten til "1C: Enterprise", som gentager C++ logikken af kontrollerne på JavaScript. Vi stræber efter at opretholde funktionel ækvivalens mellem den tynde og den webbaserede klient. I de tilfælde, hvor dette ikke er muligt, for eksempel på grund af begrænsningerne i det tilgængelige JavaScript API (f.eks. er muligheden for at arbejde med filer meget begrænset), implementerer vi ofte den nødvendige funktionalitet ved hjælp af browserudvidelser skrevet i C++. På nuværende tidspunkt understøtter vi Internet Explorer og Microsoft Edge (Windows), Google Chrome (Windows), Firefox (Windows og Linux) og Safari (MacOS).
Derudover bruges teknologien til styrede formularer til at skabe grænsefladen til mobilapplikationer på 1C-platformen. På mobile enheder tegnes kontrollerne ved hjælp af 'native' teknologier til operativsystemet, men for logikken i layoutet af formularerne og grænsefladens reaktion bruges den samme kode som på den 'store' platform '1C:Enterprise'.
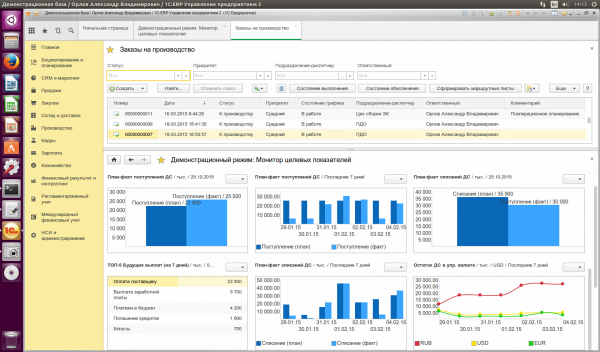
1C-grænseflade på Linux
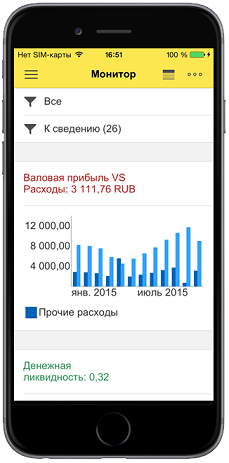
1C-grænseflade på mobile enheder
1C-grænseflade på andre platforme 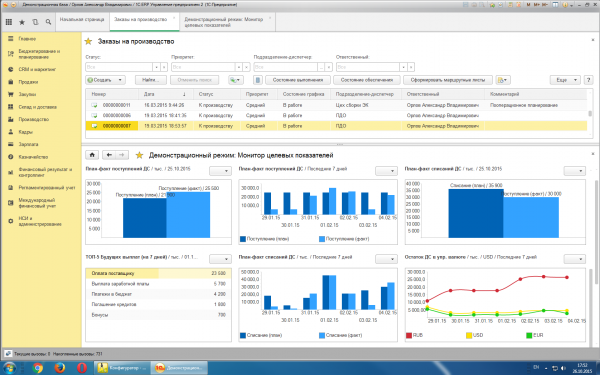
1C-grænseflade på Windows
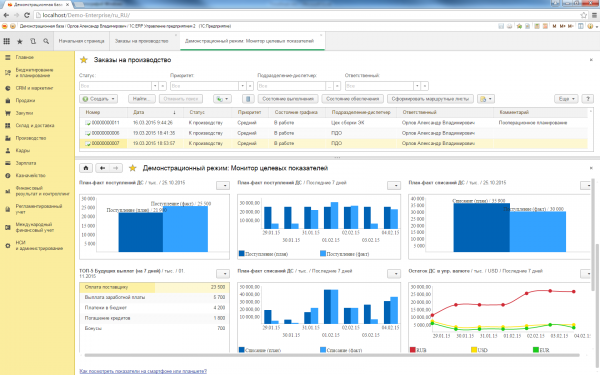
1C - webklient
Open source
Selvom vi ikke bruger de standardbiblioteker, som en C++-udvikler ville anvende under Windows (MFC, kontroller fra WinAPI), er vi ikke ansvarlige for at skrive alle komponenter selv. Biblioteket , og vi bruger også:
- til arbejde med HTTP og FTP.
- til arbejde med kryptografi og etablering af TLS-forbindelser
- til parsing af XML
- til arbejde med e-mailprotokoller (POP3, SMTP, IMAP)
- til parsing af e-mailbeskeder
- til at opbevare brugernes aktivitetslogs
- til internationalisering
Listen kan fortsætte.
Derudover bruger vi en stærkt modificeret version af og til udvikling af unit tests.
Bibliotekerne krævede tilpasning for at være kompatible med SCOM-modellen af komponenter.
Udbredelsen af 1C gør platformen til en fremragende stress-test for de biblioteker, der bruges i den. Variation i brugere og scenarier afslører hurtigt fejl selv i de sjældent brugte dele af koden. Vi retter dem internt og forsøger at give dem tilbage til biblioteksforfatterne. Erfaringerne fra samarbejdet har været meget varierede.
Udviklere og reagerer hurtigt på pull-request, men en patch, for eksempel til fik vi aldrig sendt.
Konklusion
I artiklen berørte vi flere centrale aspekter af udviklingen af 1C-platformen. I artiklens begrænsede omfang berørte vi kun nogle interessante aspekter efter vores mening.
En generel beskrivelse af forskellige mekanismer på platformen kan findes .
Hvilke emner ville være interessante for dig i de næste artikler?
Hvordan er 1C mobilplatform implementeret?
Beskrivelse af webklientens interne struktur?
Eller er du måske interesseret i udvælgelsesprocessen for funktioner til nye versioner, udvikling og testning?
Skriv i kommentarerne!
Kilde: habr.com
