

Venligst hast ikke med konklusionerne baseret på overskriften! Vi har tungtvejende argumenter til at bekræfte dette, og vi har pakket dem så kompakt som muligt. Dette er et indlæg om konceptet og principperne for vores nye datalagringssystem, hvis release fandt sted i januar 2020.
Efter vores overbevisning er det netop den nævnte ydeevne og pålidelighed, der giver Dorado V6-serien dens primære konkurrencefordel. Ja, så simpelt er det, men hvordan opnåede vi denne 'simpelhed' ved hjælp af både geniale og mindre geniale løsninger, det vil vi tale om i dag.
For bedre at udnytte potentialet i de næste generations systemer, vil vi tale om de ældre repræsentanter i modelrækken (modellerne 8000, 18000). Medmindre andet er angivet, henvises der netop til dem.
Et par ord om markedet
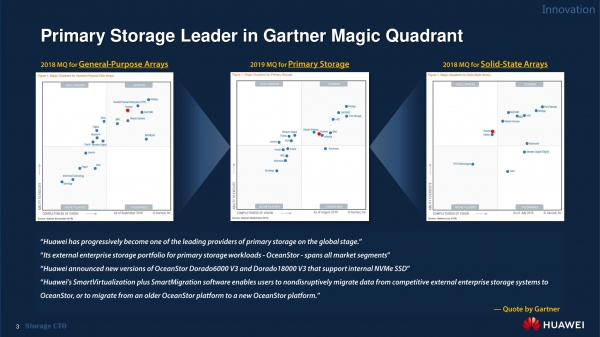
For bedre at forstå Huaweis løsninger på markedet, vil vi henvise til et velkendt mål — "" Gartner. For to år siden var vores virksomhed sikkert placeret i ledergruppen inden for segmentet for generelle diskarrays, kun overgået af NetApp og Hewlett Packard Enterprise. Huaweis position på markedet for solid state-lagringssystemer i 2018 blev karakteriseret som "outsider", men der var noget, der manglede for at nå lederpositionerne.
I 2019 samlede Gartner i sin undersøgelse de to førnævnte sektioner til én — "Primært lager". Som følge heraf befandt Huawei sig igen i lederkvadranten, side om side med leverandører som IBM, Hitachi Vantara og Infinidat.
For at få det fulde billede skal det bemærkes, at 80% af de data, som Gartner anvender til sin analyse, indsamles på det amerikanske marked, hvilket fører til en væsentlig skævhed til fordel for de virksomheder, der er godt repræsenteret netop i USA. I mellemtiden befinder leverandører, der er fokuseret på europæiske og asiatiske markeder, sig i en åbenlyst mindre fordelagtig position. Og alligevel, på trods af dette, indtog Huaweis produkter i sidste år en værdig plads i det øverste højre kvadrant, og ifølge Gartners dom "kan anbefales til brug".
Hvad er nyt i Dorado V6
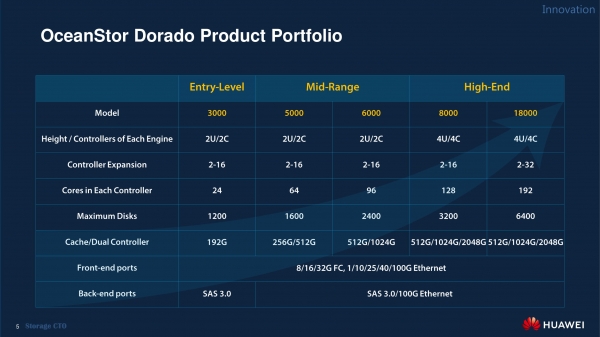
Produktlinjen Dorado V6, især systemerne i entry-level serien 3000, er præsenteret. Oprindeligt udstyret med to controllere kan de horisontalt udvides op til 16 controllere, 1200 diske og 192 GB cache. Systemet vil også være udstyret med eksterne Fibre Channel porte (8 / 16 / 32 Gbit/s) og Ethernet (1 / 10 / 25 / 40 / 100 Gbit/s).
Vi bemærker, at brugen af protokoller, der ikke har kommerciel succes, nu afsluttes, så vi har besluttet at undlade at støtte Fibre Channel over Ethernet (FCoE) og Infiniband (IB) ved lanceringen. De vil blive tilføjet i senere versioner af firmwaren. NVMe over Fabric (NVMe-oF) understøttes 'out of the box' over Fibre Channel. I den næste firmware, som er planlagt til udgivelse i juni, er der planlagt støtte til NVMe over Ethernet. Efter vores mening vil det nævnte sæt mere end dække behovene for de fleste Huawei-kunder.
Filadgang er ikke tilgængelig i den nuværende firmwareversion og vil komme i en af de følgende opdateringer nær slutningen af året. Implementeringen er planlagt på native niveau, styret af controllere med Ethernet-porte, uden brug af ekstra udstyr.
Den primære forskel mellem Dorado V6 modellen i serien 3000 og de ældre modeller er, at backend understøtter én protokol — SAS 3.0. Derfor kan lagermedierne kun bruge denne interface. Efter vores mening er den ydeevne, der opnås hermed, helt tilstrækkelig for en enhed af denne type.
Dorado systemerne i serierne V6 5000 og 6000 hører til mid-range løsninger. De er også designet i 2U formfaktor og udstyret med to controllere. De adskiller sig fra hinanden med hensyn til ydeevne, antal processorer, maksimalt antal diske og cache-størrelse. Arkitektonisk og ingeniørmæssigt er Dorado V6 5000 og 6000 identiske og ser ens ud.
Hi-end klassen omfatter Dorado V6 systemerne i serierne 8000 og 18000. Designet i 4U formfaktor har de standard en adskilt arkitektur, hvor controllere og lagermedier er opdelt. I den minimale konfiguration kan de også kun leveres med to controllere, selvom kunderne normalt beder om at få installeret fire eller flere.
Dorado V6 8000 kan skaleres horisontalt op til 16 controllere, mens Dorado V6 18000 kan skaleres op til 32. Disse systemer har forskellige processorer med forskelligt antal kerner og cache-størrelse. Identiteten af de ingeniørmæssige løsninger bevares dog fortsat, som i modellerne i mid-end klassen.
2U-hylder med drev tilsluttes via RDMA med en båndbredde på 100 Gbit/s. Backend'et i Dorado V6's højere serier understøtter også SAS 3.0, men mere som en mulighed, hvis SSD-drev med denne grænseflade falder kraftigt i pris. Så vil der være økonomisk fornuft i at bruge dem, selv med lavere ydeevne. I øjeblikket er prisforskellen mellem SSD'er med SAS- og NVMe-grænseflader så lille, at vi ikke er i stand til at anbefale en sådan løsning.
Inde i controlleren
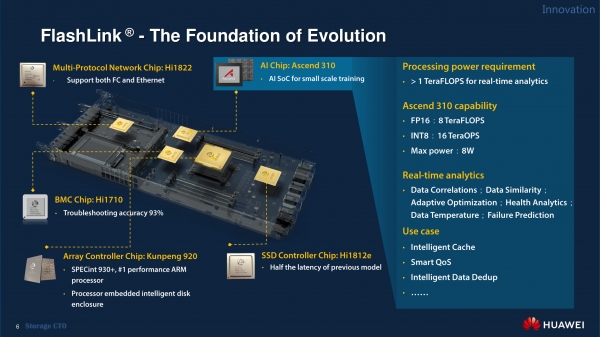
Controllerne i Dorado V6 er bygget på vores egen komponentbasis. Ingen processorer fra Intel, ingen ASIC'er fra Broadcom. Dermed er alle komponenter på bundkortet, ligesom selve bundkortet, helt beskyttet mod risici forbundet med sanctionspres fra amerikanske virksomheder. De, der har set noget af vores udstyr med egne øjne, har sikkert bemærket skilte med en rød stribe under logoet. Det indikerer, at produktet ikke indeholder amerikanske komponenter. Dette er Huaweis officielle kurs — overgangen til komponenter, der er produceret internt eller i hvert fald i lande, der ikke følger USA's politik.
Dette kan ses på selve controllerkortet.
- Universelt netværksinterface (Hisilicon 1822 chip), der er ansvarlig for tilslutning til Fibre Channel eller Ethernet.
- BMC-chip, nemlig Hisilicon 1710, der sikrer fjernadgang til systemet for fuld funktionsdygtig fjernstyring og overvågning af systemet. Lignende anvendes også i vores servere og i andre løsninger.
- Centralprocessor, som er en Huawei-produceret chip Kunpeng 920 baseret på ARM-arkitekturen. Den er vist på diagrammet ovenfor, selvom der i andre controllere kan være installeret andre modeller med forskelligt antal kerner, forskellige klokfrekvenser osv. Antallet af processorer i én controller kan også variere fra model til model. For eksempel har de højere serier i Dorado V6 fire på ét kort.
- SSD-controller (Hisilicon 1812e chip) that supports the connection of both SAS and NVMe drives. Additionally, Huawei produces SSDs in-house but does not manufacture the NAND cells themselves, opting instead to purchase them from the four largest global manufacturers in the form of uncut silicon wafers. The cutting, testing, and packaging into chips is done by Huawei, after which they are released under their own brand.
- Artificial intelligence chip — Ascend 310. By default, it is not included in the controller and is mounted via a separate card, which occupies one of the slots reserved for network adapters. The chip is used to ensure intelligent cache behavior, manage performance, or handle deduplication and compression processes. All these tasks can also be managed by the central processor, but the AI chip allows for much more efficient execution.
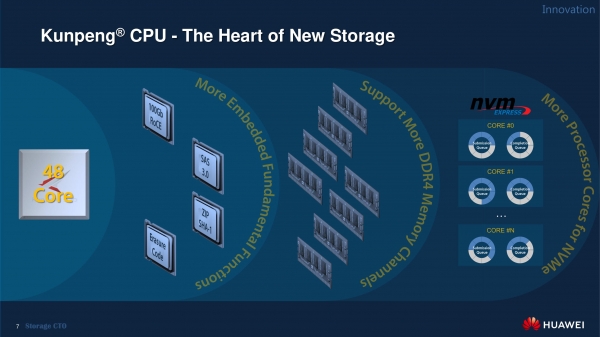
About Kunpeng processors
The Kunpeng processor represents a system on a chip (SoC), where alongside the computational block, there are hardware modules that accelerate various processes such as checksum calculations or performing erasure coding. It also features hardware support for SAS, Ethernet, DDR4 (ranging from six to eight channels), and more. This allows Huawei to create storage controllers that match the performance of classic Intel solutions.
Additionally, its own solutions based on ARM architecture give Huawei the ability to create complete server solutions and offer them to clients as an alternative to x86.
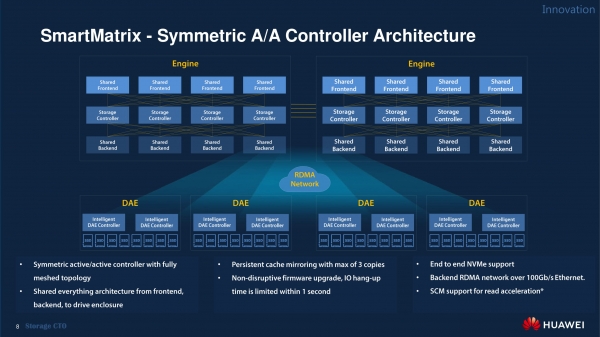
The new Dorado V6 architecture…
The internal architecture of the Dorado V6 storage system's upper series is represented by four main subdomains (factories).
The first factory serves as a common frontend (network interfaces responsible for communication with the SAN factory or hosts).
The second factory consists of a set of controllers, each of which can connect via the RDMA protocol to any network card of the frontend and to the adjacent 'engine', which is a box containing four controllers, along with shared power supply and cooling units. Currently, high-end Dorado V6 models can be equipped with two such 'engines' (thus, eight controllers).
Den tredje fabrik står for backend og består af RDMA 100G netværkskort.
Endelig er den fjerde fabrik "i hardwaren" repræsenteret ved tilsluttede intelligente hylder med lagringsenheder.
En sådan symmetrisk struktur afslører det fulde potentiale af NVMe-teknologien og sikrer høj ydeevne og pålidelighed. Ind- og uddata-processer maksimeres parallelt på processorer og kerner, hvilket gør det muligt at læse og skrive på mange strømme samtidig.
…og hvad det har givet os
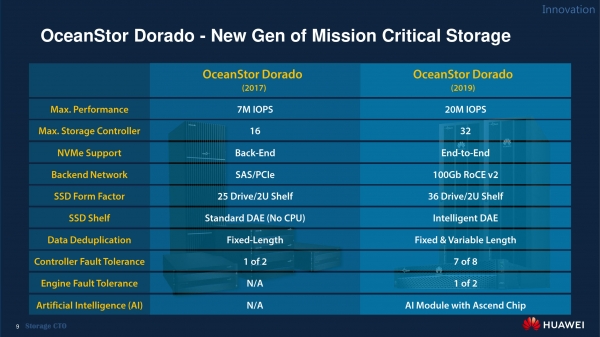
Den maksimale ydeevne for Dorado V6-løsningerne overgår cirka tre gange resultaterne fra forgængernes systemer (i samme klasse) og kan nå op på 20 millioner IOPS.
Dette skyldes, at i det tidligere generations udstyr var NVMe-understøttelse begrænset til tilsluttede hylder med lagringsenheder. Nu er der understøttelse på alle niveauer, fra vært til SSD. Backend-netværket har også gennemgået ændringer: SAS/PCIe er blevet erstattet af RoCEv2 med en båndbredde på 100 Gbit/s.
SSD-formfaktoren har også ændret sig. Hvis der tidligere var 25 lagringsdrev i en 2U-hylde, er den nu blevet opgraderet til 36 enheder af palm-sized fysisk format. Desuden er hylderne blevet "smartere". Hver hylde har nu et fejltolerant system med to controllere baseret på ARM-chips, som ligner dem, der er installeret i centrale controllere.
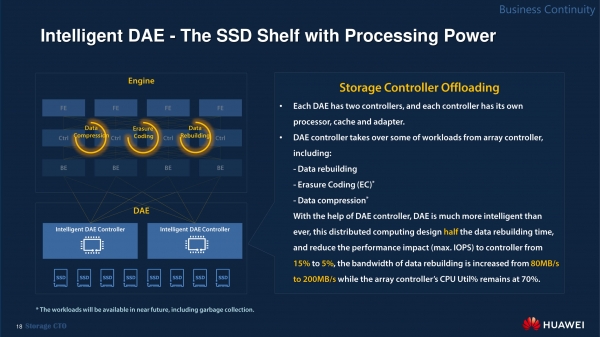
De arbejder i øjeblikket kun med dataorganisering, men med den kommende firmware vil der blive tilføjet kompression og erasure coding, hvilket vil reducere belastningen på de centrale controllere fra 15% til 5%. Flytning af nogle opgaver til hylden frigiver samtidig også båndbredden i det interne netværk. Alt dette øger betydeligt systemets skalerbarhed.
Kompression og deduplicering i det forrige generations SAN blev udført med faste blokke. Nu er der også tilføjet en tilstand for variabel længde blokke, som i øjeblikket skal aktiveres manuelt. Efterfølgende firmwares vil muligvis ændre dette.
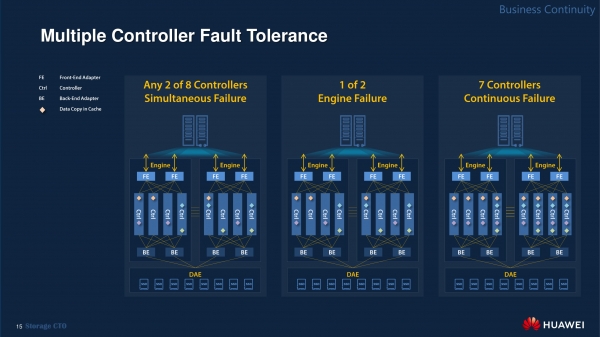
Også kort om fejltolerance. Dorado V3 bevarede funktionalitet, hvis én controller ud af to svigtede. Dorado V6 vil sikre data tilgængelighed, selvom op til syv controllere ud af otte fejler sekventielt eller fire fejler samtidigt i ét "motor".
Pålidelighed i økonomisk forstand
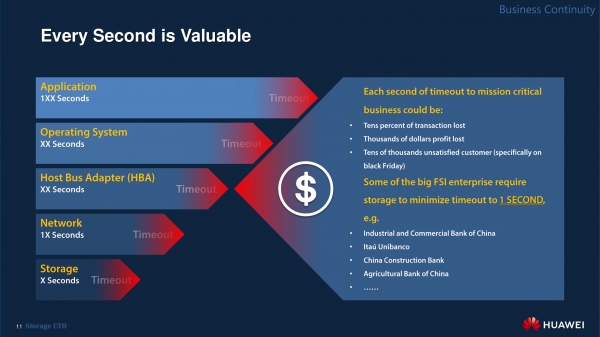
For nylig blev der blandt kunderne hos Huawei foretaget en undersøgelse om, hvilken nedetid for enkelte elementer i IT-infrastrukturen virksomheden finder acceptabel. Generelt havde respondenterne en rimelig tolerance over for den hypotetiske situation, hvor en applikation ikke reagerer i flere hundrede sekunder. For operativsystemer eller bus-adaptere var kritisk nedetid i sekunder (faktisk genstartstid). Endnu højere krav stiller kunderne til netværket: dets båndbredde må ikke falde i mere end 10–20 sekunder. Som man kunne forvente, betragter respondenterne svigt i lagringssystemer som de mest kritiske. Fra forretningsrepræsentanters synspunkt bør nedetid for SAN ikke overstige... et par sekunder om året!
Med andre ord, hvis en klients banksystem ikke reagerer i 100 sekunder, vil det sandsynligvis ikke have katastrofale konsekvenser. Men hvis et SAN ikke fungerer i samme tidsrum, kan det resultere i forretningsstop og betydelige økonomiske tab.
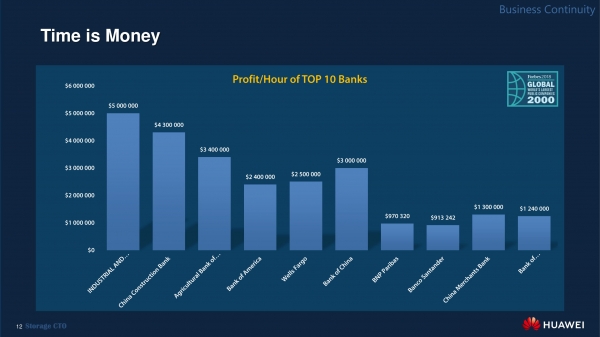
Diagrammet ovenfor viser omkostningerne for en times nedetid for de ti største banker (data fra Forbes 2017). Hvis din virksomhed nærmer sig størrelsen på de kinesiske banker, vil det ikke være svært at retfærdiggøre behovet for at investere flere millioner dollar i et SAN. Omvendt gælder det, at hvis enhver nedetid for virksomheden ikke medfører væsentlige tab, vil de næppe investere i et hi-end SAN. Under alle omstændigheder er det vigtigt at have en idé om, hvor stort et hul der kan opstå i din pengepung, mens systemadministratoren ordner det svigtende lagringssystem.
Sekund til nødskift
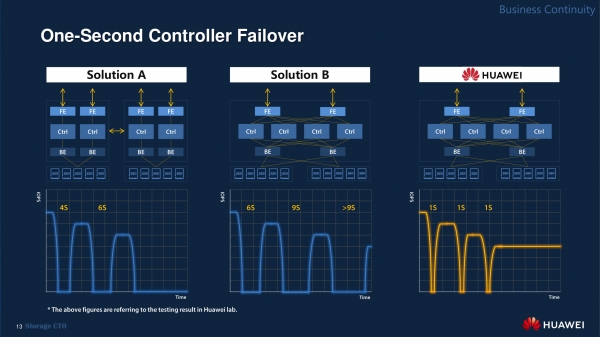
I Solution A på illustrationen ovenfor kan du se vores tidligere generations system Dorado V3. Dets fire controllere arbejder parvis, og cachekopierne opbevares kun i to controllere. Controllerene inden for et par kan omfordele belastningen. Samtidig, som du kan se, er der ingen "fabrikker" for frontend og backend, så hver hylde med lagringsenheder er tilsluttet et specifikt controllerpar.
Diagrammet for Solution B viser en løsning, der i øjeblikket er tilgængelig på markedet fra en anden leverandør (kendte du det?). Her er der allerede front-end og back-end fabrikker, og lagermedierne forbindes direkte til fire controllere. Faktisk er der dog nogle mindre åbenlyse nuancer i, hvordan systemets interne algoritmer fungerer.
Til højre præsenteres vores nuværende arkitektur for Dorado V6 storage systemet med et komplet sæt af interne elementer. Lad os se, hvordan disse systemer håndterer en typisk situation — fejlen på en controller.
I klassiske systemer, som Dorado V3 tilhører, kan den tid, der kræves for at omfordele belastningen ved fejl, nå op på fire sekunder. I løbet af denne tid stopper input-output helt. I Solution B fra vores kolleger, på trods af en mere moderne arkitektur, er nedetid ved fejl endnu længere — seks sekunder.
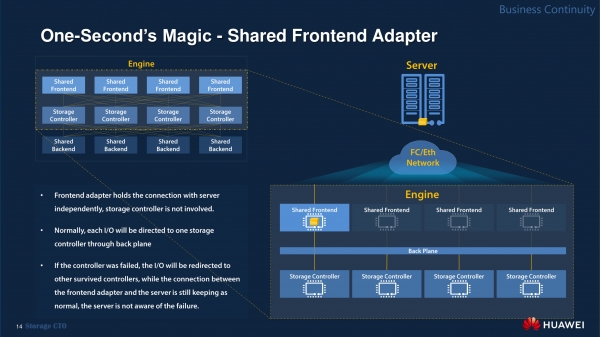
Dorado V6 gendanner sin funktion efter blot én sekund ved en fejl. Dette resultat opnås takket være en homogen intern RDMA-miljø, der gør det muligt for controllere at få adgang til 'fremmed' hukommelse. En anden vigtig faktor er tilstedeværelsen af en front-end fabrik, som sikrer, at stien for værten forbliver uændret. Porten forbliver den samme, og belastningen sendes blot til de fungerende controllere via multipassing drivere.
Fejlen på den anden controller i Dorado V6 håndteres på samme måde indenfor én sekund. For Dorado V3 tager dette cirka seks sekunder, mens det for en anden leverandørs løsning tager ni. For mange databasesystemer kan sådanne intervaller ikke længere betragtes som acceptable, da systemet i denne tid overgår til standby-tilstand og stopper med at fungere. Dette gælder især for databasesystemer, der består af mange partitioner.
Fejlen på den tredje controller i Solution A kan ikke overholdes. Dette skyldes ganske enkelt, at adgangen til en del af datadiskene forsvinder. På den anden side gendanner Solution B funktionaliteten i en sådan situation, hvilket tager som i det foregående tilfælde ni sekunder.
Hvad med Dorado V6? Én sekund.
Hvad kan man opnå på en sekund?
Næsten ingenting, men vi har heller ikke brug for det. Lad os gentage, at i Dorado V6 i hi-end klassen er frontend-fabrikken adskilt fra controllerfabrikken. Det betyder, at der ikke er hårdt tildelte porte, der tilhører en specifik controller. Omlægning ved fejl indebærer ikke søgning efter alternative ruter eller geninitialisering af multipass. Systemet fortsætter med at fungere som før.
Modstandsdygtighed over for mange fejl
De ældre modeller af Dorado V6 kan uden problemer overleve et samtidigt nedbrud af to vilkårlige (!) controllere inden for enhver "motor". Dette er blevet muligt, fordi løsningen nu gemmer tre kopier af cachen. Derfor findes der altid en intakt kopi, selv ved dobbeltfejl.
Synkronisering af nedbrud af alle fire controllere i en af "motorerne" vil heller ikke medføre fatale konsekvenser, da alle tre kopier af cachen på ethvert tidspunkt er fordelt mellem "motorerne". Systemet overvåger overholdelsen af denne logik.
Endelig er et scenarie, hvor syv controllere ud af otte går ned i rækkefølge, næsten usandsynligt. Den minimale tilladte tidsintervaller mellem individuelle nedbrud er 15 minutter. I løbet af denne tid får lagersystemet udført de nødvendige operationer til at migrere cachen.
Den sidste fungerende controller vil sikre drift af datalageret og opretholde cachen i fem dage (standardværdi, som nemt kan ændres i indstillingerne). Efter dette vil cachen blive deaktiveret, men lagersystemets drift vil fortsætte.
Ubesværet opdateringer
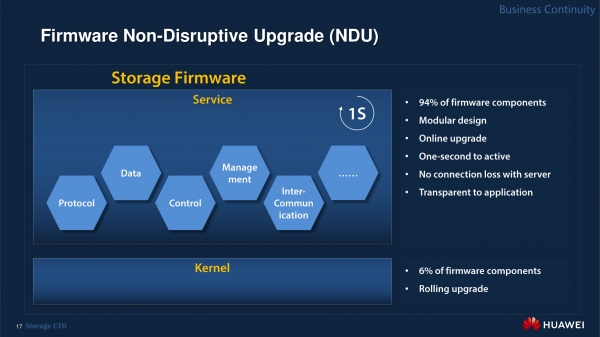
Det nye OS Dorado V6 tillader opdatering af fastwaren i lagersystemet uden genstart af controllerne.
Operativsystemet, ligesom i tilfælde med tidligere løsninger, er baseret på Linux, men mange af de operationelle processer er flyttet fra kernen til brugermodulet. De fleste funktioner, såsom dem der er ansvarlige for deduplikering og kompression, er nu almindelige dæmoner, der kører i baggrunden. Takket være dette er det ikke nødvendigt at ændre hele operativsystemet for at opdatere individuelle moduler. For eksempel vil der kun være behov for at slukke for det relevante softwaremodul og starte det nye for at tilføje support til en ny protokol.
Det er tydeligt, at spørgsmål om opdatering af systemet stadig eksisterer, da der også kan være elementer i kernen, der kræver opdatering. Men ifølge vores observationer er der mindre end 6 % af det samlede antal. Dette gør det muligt at genstarte controllere mange gange sjældnere end før.
Katastrofe-resistente løsninger og høj tilgængelighedsløsninger (HA/DR)
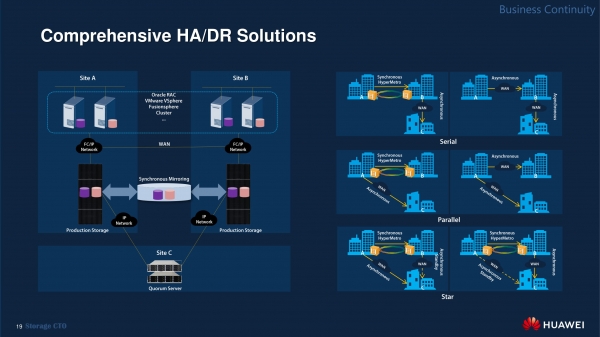
Dorado V6 er 'out of the box' klar til integration i geo-spredte løsninger, metro-klynger og 'triple' datacentre.
Til venstre på illustrationerne ovenfor er den allerede velkendte metro-klynge. To SAN'er arbejder i aktiv/aktiv tilstand på afstande op til 100 km fra hinanden. En sådan infrastruktur med en eller flere kvorumservere kan understøttes af løsninger fra forskellige virksomheder, inklusive vores cloud-operativsystem FusionSphere. Kanalernes egenskaber mellem placeringerne får særlig betydning i sådanne projekter. I vores tilfælde varetager HyperMetro-funktionen, som igen er 'out of the box'. Integration er mulig via Fibre Channel samt iSCSI i IP-netværk, hvis behovet opstår. Det er ikke længere nødvendigt med dedikeret 'dark' fiber, da systemet kan oprette forbindelse via eksisterende kanaler.
Når sådanne systemer opbygges, er det eneste hardwarekrav til SAN'en at frigive porte til replikation. Det er tilstrækkeligt at købe en licens, starte kvorumservere — fysiske eller virtuelle — og sikre IP-forbindelse til controllere (10 Mbit/s, 50 ms).
Denne arkitektur kan let overføres til et system med tre datacentre (se højre side af illustrationen). For eksempel, når to datacentre arbejder i metro-klynge-tilstand, mens den tredje placering, der ligger mere end 100 km væk, bruger asynkron replikation.
Systemet understøtter teknologisk forskellige forretningsscenarier, der vil blive implementeret i tilfælde af en omfattende hændelse.
Overlevelse af metro-klyngen ved flere fejlfunktioner
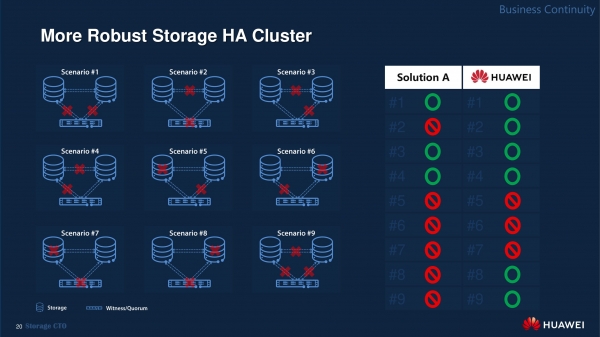
Ovenfor og nedenfor er der også vist en klassisk metro-klynge, bestående af to SAN'er og en kvorumserver. Som du kan se, vil vores infrastruktur bevare sin funktionalitet i seks ud af ni mulige scenarier med flere fejlfunktioner.
For example, in the second scenario, when the quorum server fails and synchronization between sites occurs, the system remains functional, as the second site stops working. This behavior is already embedded in the built-in algorithms.
Even after three failures, access to information can be retained if the interval between them was at least 15 seconds.
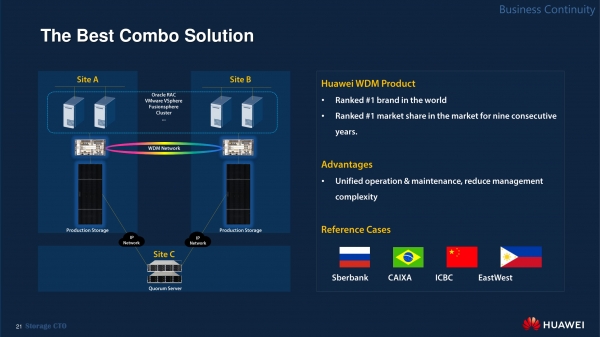
A familiar trump card up the sleeve
Recall that Huawei manufactures not only storage systems but also a complete range of network equipment. Whatever storage provider you choose, if a WDM network is used between the sites, in 90% of cases it will be based on solutions from our company. A reasonable question arises: why assemble a zoo of systems when all guaranteed compatible hardware can be obtained from one vendor?
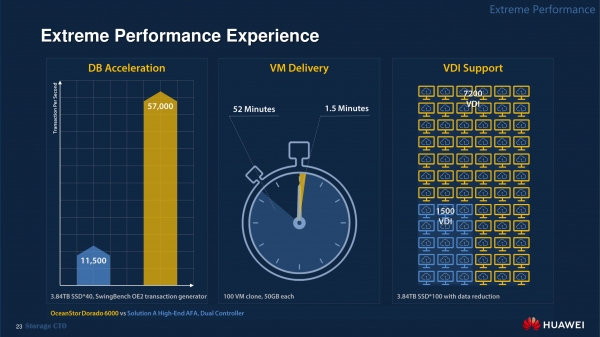
On the topic of performance
Probably, no one needs convincing that switching to All-Flash storage systems significantly reduces the costs of maintaining infrastructure, as all routine operations are performed much faster. All suppliers of such equipment testify to this. Meanwhile, many vendors begin to gloss over things when it comes to performance drops when different operating modes of storage systems are enabled.
In our industry, it is common practice to issue storage systems for test operation for one or two days. The supplier runs a 20-minute test on an empty system, obtaining astronomical performance figures. However, in real operation, hidden pitfalls quickly surface. After just one day, the beautiful IOPS values drop to half or a third, and if the storage system is filled to 80%, they become even lower. Enabling RAID 5 instead of RAID 10 incurs an additional 10-15% loss, and in metro-cluster mode, performance is halved again.
Everything mentioned above does not apply to Dorado V6. Our customers have the opportunity to run a performance test over the weekend or at least overnight. This reveals garbage collection behavior, as well as how the activation of various options — like snapshots and replication — affects the achieved IOPS.
I Dorado V6 påvirker snapshots og RAID med paritet næsten ikke ydeevnen (3–5 % i stedet for 10-15 %). Affaldssamling (udfyldning af lagerskaber med nuller), komprimering, deduplication på et SAN, der er fyldt op til 80 %, vil altid påvirke den samlede forespørgselsbehandlingstid. Men det, der gør Dorado V6 interessant, er, at uanset hvilken kombination af funktioner og beskyttelsesmekanismer du aktiverer, vil den endelige ydeevne af SAN ikke falde under 80 % af det niveau, der opnås uden belastning.
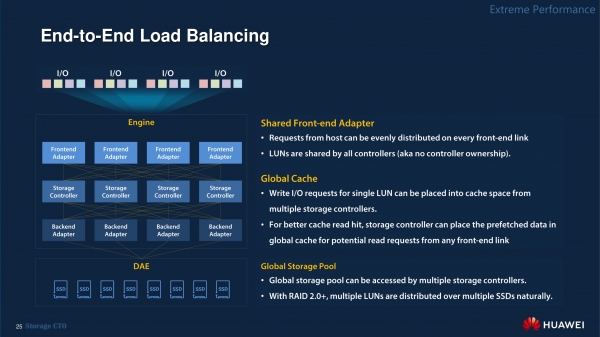
Load Balancing
Den høje ydeevne af Dorado V6 opnås gennem belastningsbalancering på hvert trin, nemlig:
- multi-passing;
- brug af flere forbindelser fra én vært;
- tilstedeværelse af en frontend-fabrik;
- parallelisering af controllerenes arbejde i SAN;
- fordeling af belastningen på alle lagringsenheder på RAID-niveau 2.0+.
I princippet er dette en almindelig praksis. I dag er der få, der opbevarer alle data på én LUN: alle stræber efter at have otte, fyrre, eller endda flere. Dette er en åbenlys og korrekt tilgang, som vi deler. Men hvis dit behov kun kræver én LUN, der er lettere at vedligeholde, tillader vores arkitektoniske løsninger at opnå en ydeevne på 80 % af det, der er tilgængeligt ved brug af flere LUN.
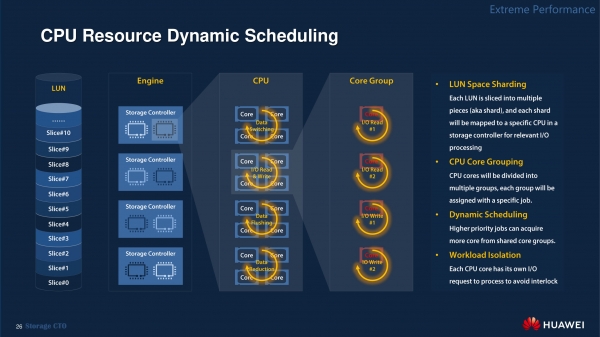
Dynamisk planlægning af belastningen af processorerne
Belastningsfordelingen på processorerne ved brug af én LUN implementeres på følgende måde: opgaver opdeles allerede på LUN-niveau i separate små 'sharder', hvor hver af dem er strengt knyttet til en specifik controller i 'motoren'. Dette gøres for at sikre, at systemet ikke mister ydeevne, mens det 'hopper' med denne databit gennem forskellige controllere.
Endnu en mekanisme til at bevare høj ydeevne er dynamisk scheduling, hvor forskellige processorkerner kan tildeles forskellige opgavepuljer. For eksempel, hvis systemet lige nu er inaktivt på niveauet for deduplication og komprimering, kan nogle kerner gå ind i processen for dataind- og -udgang. Eller omvendt. Alt dette sker automatisk og er gennemsigtigt for brugeren.
Oplysninger om den nuværende belastning på hver af kernerne i Dorado V6 vises ikke i det grafiske interface, men man kan tilgå controllerens OS via kommandolinjen og bruge den almindelige Linux-kommando top.
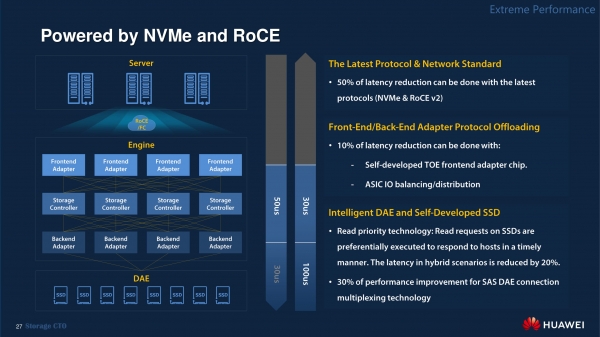
Understøttelse af NVMe og RoCE
Som nævnt understøtter Dorado V6 i øjeblikket NVMe over Fibre Channel "out of the box" og kræver ingen licenser. I midten af året vil der komme understøttelse af NVMe over Ethernet. For at kunne bruge dette fuldt ud er der brug for Ethernet med direkte hukommelsestilgang (DMA) version v2.0, både fra selve SAN'en og fra switche og netværksadaptere. For eksempel sådanne som Mellanox ConnectX-4 eller ConnectX-5. Man kan også bruge netværkskort baseret på vores chips. Derudover skal understøttelsen af RoCE implementeres på operativsystemniveau.
Generelt betragter vi Dorado V6 som et NVMe-orienteret system. På trods af den eksisterende støtte til Fibre Channel og iSCSI planlægges der i fremtiden at overgå til højhastigheds Ethernet med RDMA.
En smule marketing
Takket være den høje fejltolerance i Dorado V6-systemet, dets gode horisontale skalering og understøttelse af forskellige migrationsmetoder, realiserer den økonomiske gevinst ved at anskaffe systemet sig tydeligt, så snart intensiv brug af SAN'en begynder. Vi vil fortsætte med at gøre ejerskabet af systemet så økonomisk fordelagtigt som muligt, selvom dette ikke er åbenlyst i starten.
Specifikt har vi skabt programmet FLASH EVER, relateret til forlængelse af livscyklussen for SAN'en, som er designet til at lette byrden for kunden, når der udføres opgraderinger.
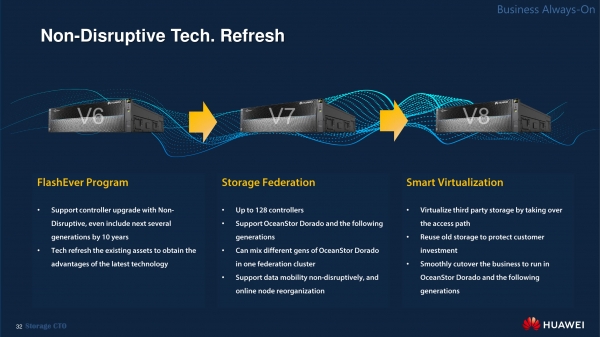
Dette program omfatter en række tiltag:
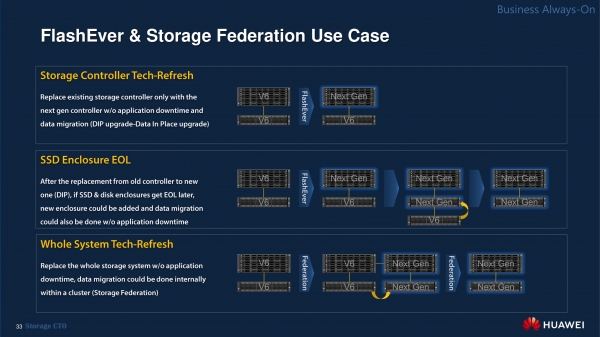
- mulighed for gradvis udskiftning af controllere og diskhylder med nye versioner uden at skulle udskifte hele udstyret (for Dorado V6-systemer i hi-end klassen);
- mulighed for federativ lagring (sammenlægning af forskellige versioner af Dorado i et hybrid SAN-kluster);
- intelligent virtualisering (mulighed for at bruge tredjepartsudstyr som en del af Dorado-løsningen).
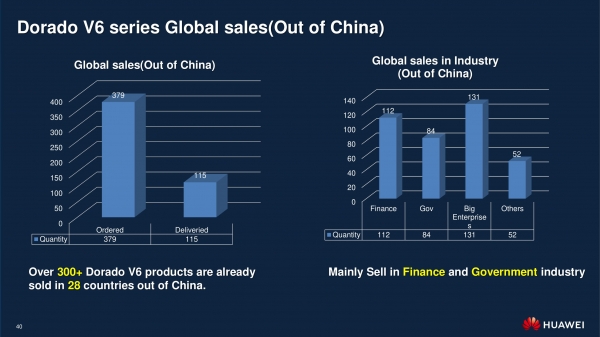
Det skal bemærkes, at den vanskelige situation i verden har haft en begrænset indvirkning på de kommercielle udsigter for det nye system. Selvom den officielle lancering af Dorado V6 først fandt sted i januar, ser vi en betydelig efterspørgsel efter det i Kina, samt stor interesse fra både russiske og internationale partnere fra finanssektoren og regeringsstrukturer.
Derudover, i forbindelse med pandemien, uanset hvor lang tid den måtte vare, bliver spørgsmålet om at forsyne remote medarbejdere med virtuelle arbejdspladser særligt presserende. I denne proces kunne Dorado V6 også afhjælpe mange problemstillinger. Vi gør alle nødvendige bestræbelser for dette, herunder næsten at have aftalt at inkludere det nye system i VMware's kompatibilitetsliste.
***
Og glem ikke vores mange webinarer, der ikke kun afholdes i det russisktalende segment, men også på globalt niveau. Listen over webinarer for april er tilgængelig på .
Kilde: habr.com
