

TL;DR: For fire år siden forlod jeg Google med ideen om et nyt værktøj til serverovervågning. Ideen var at samle normalt isolerede funktioner i én tjeneste, og analyse af logs, indsamling af metrics, og et kontrolpanel. Et af principperne er, at tjenesten skal være virkelig hurtig, hvilket giver devops mulighed for en let, interaktiv og behagelig arbejdsoplevelse. Dette kræver behandling af datasæt på flere gigabyte på brøkdele af et sekund uden at overskride budgettet. Eksisterende logbehandlingsværktøjer er ofte langsomme og klodsede, så vi står over for en god udfordring: at udvikle et værktøj, der giver brugerne nye oplevelser.
I denne artikel beskriver vi, hvordan vi i Scalyr løste dette problem ved at anvende metoder fra den gamle skole, en brute force tilgang, fjerne unødvendige lag og undgå komplekse datastrukturer. Disse lektioner kan du anvende på dine egne ingeniøropgaver.
Den gamle skoles styrke
Loganalyse begynder typisk med søgning: at finde alle meddelelser, der matcher et bestemt mønster. I Scalyr er det titusinder eller hundredevis af gigabyte logs fra mange servere. Moderne tilgange indebærer ofte at bygge en eller anden kompleks datastruktur, der er optimeret til søgning. Jeg har selvfølgelig set dette i Google, hvor de er ret dygtige til sådanne ting. Men vi valgte en meget mere grov tilgang: lineær scanning af logs. Og det virkede — vi tilbyder et interface med en søgefunktion, der er på en helt anden hastighed end vores konkurrenter (se animationen i slutningen).
Den vigtigste indsigt var, at moderne processorer faktisk er meget hurtige ved enkle, ligefremme operationer. Dette er let at overse i komplekse, lagdelte systemer, der er afhængige af I/O-hastighed og netværksoperationer, og sådanne systemer er meget udbredte i dag. Derfor udviklede vi et design, der minimerer antallet af lag og unødvendigt rod. Med flere processorer og servere kører søgehastigheden op til 1 TB i sekundet.
Vigtige konklusioner fra denne artikel:
- Grov søgning er en helt levedygtig tilgang til at løse reelle, skalerbare problemer.
- Brute force er en designmetode, ikke en måde at undgå arbejde på. Som enhver teknik er den bedre egnet til visse problemer end andre, og den kan implementeres dårligt eller godt.
- Brute force er især god til at opnå stadium) løsning ydelse.
- Effektiv brug af brute force kræver optimering af koden og rettidig anvendelse af tilstrækkelige ressourcer. Det er passende, hvis dine servere er under stort belastning, der ikke er relateret til brugere, mens brugeroperationer forbliver prioriterede.
- Ydelsen afhænger af designet af hele systemet, ikke kun af algoritmen for den indre cyklus.
(Denne artikel beskriver datagenerering i hukommelsen. I de fleste tilfælde, når en bruger søger i logfiler, har Scalyr-serverne allerede cachet dem. I den næste artikel vil vi diskutere søgning i uncacherede logfiler. De samme principper gælder: effektiv kode, brute force-metoden med store beregningsressourcer).
Brute force-metoden
Traditionelt udføres søgning i et stort datasæt ved hjælp af nøgleordsindekser. I forhold til serverlogfiler betyder det at søge efter hvert unikt ord i journalen. For hvert ord skal der laves en liste over alle forekomster. Dette gør det nemt at finde alle meddelelser med dette ord, såsom 'fejl', 'firefox' eller 'transaction_16851951' - vi ser simpelthen i indekset.
Jeg brugte denne tilgang i Google, og det fungerede godt. Men i Scalyr søger vi i logfiler byte for byte.
Hvorfor? Fra et abstrakt algoritmisk synspunkt er nøgleordsindekser meget mere effektive end brute force-søgning. Men vi sælger ikke algoritmer, vi sælger ydeevne. Og ydeevne er ikke kun algoritmer, men også systemteknik. Vi skal tage højde for alt: datastørrelse, søgetype, tilgængeligt udstyr og programkontekst. Vi har besluttet, at en løsning som 'grep' passer bedre til vores specifikke problem end indeksering.
Indekser er fremragende, men de har begrænsninger. At finde et enkelt ord er let. Men at søge efter meddelelser med flere ord, som 'googlebot' og '404', er meget sværere. At søge efter en sætning som 'uncaught exception' kræver et mere omfattende indeks, der registrerer ikke kun alle meddelelser med dette ord, men også den specifikke placering af ordet.
Den virkelige udfordring opstår, når du ikke søger på ord. Antag, du vil se, hvor meget trafik der kommer fra bots. Den første tanke er at søge i loggene efter ordet 'bot'. På den måde finder du nogle bots: Googlebot, Bingbot og mange andre. Men her er 'bot' ikke et ord, men en del af et ord. Hvis du søger 'bot' i indekset, finder vi ikke indlæg med ordet 'Googlebot'. Hvis vi tjekker hvert ord i indekset og derefter scanner indekset efter de fundne nøgleord, vil søgningen blive betydeligt langsommere. Som resultat tillader nogle loghåndteringsprogrammer ikke delordssøgninger eller (i bedste fald) giver mulighed for at bruge speciel syntaks med lavere ydeevne. Vi ønsker at undgå dette.
En anden udfordring er tegnsætningen. Vil du finde alle forespørgsler fra 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Endelig elsker ingeniører kraftige værktøjer, og nogle gange kan et problem kun løses med regulære udtryk. Nøgleordsindekset er ikke særlig velegnet til dette.
Derudover er indeksene komplekse. Hver besked skal tilføjes til flere nøgleordslister. Disse lister skal konstant holdes i et søgbar format. Forespørgsler med sætninger, dele af ord eller regulære udtryk skal oversættes til operationer med flere lister, og resultaterne skal scannes og kombineres for at opnå den endelige samling. I konteksten af en storstilet flerbruger-tjeneste skaber sådan kompleksitet ydeevneproblemer, der ikke er synlige, når man analyserer algoritmer.
Nøgleordsindekser fylder også meget, og lagerpladsen er en stor omkostning i loghåndteringssystemet.
På den anden side kan der bruges meget computerkraft til hver søgning. Vore brugere værdsætter hurtig søgning på unikke forespørgsler, men sådanne forespørgsler laves relativt sjældent. For typiske søgeforespørgsler, eksempelvis til overvågningspanelet, anvender vi specielle teknikker (som vi vil beskrive i den næste artikel). Andre forespørgsler er ret sjældne, så vi behøver sjældent at behandle mere end en ad gangen. Men det betyder ikke, at vores servere ikke er optaget: de er belastet med at modtage, analysere og komprimere nye meddelelser, vurdere varsler, komprimere gamle data osv. Sådan set har vi en ganske betydelig reserve af processorer, som kan anvendes til at udføre forespørgsler.
Brute force fungerer, hvis du har et brute problem (og meget kraft)
Brute force fungerer bedst på enkle opgaver med små interne løkker. Ofte kan du optimere den interne løkke til at køre med meget høje hastigheder. Hvis koden er kompleks, er det meget vanskeligere at optimere den.
Oprindeligt havde vores søgekode en ret stor intern løkke. Vi opbevarer meddelelser på sider på 4K; hver side indeholder nogle meddelelser (i UTF-8) og metadata for hver meddelelse. Metadata er en struktur, hvor længden af værdien, den interne ID for meddelelsen og andre felter er kodet. Søgeløkken så således ud:
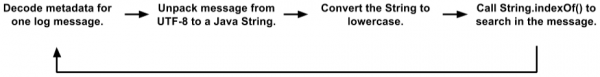
Dette er en forenklet version i forhold til den faktiske kode. Men selv her kan man se adskillige placeringer af objekter, data kopier og funktionsopkald. JVM optimerer ret godt funktionsopkald og tildeler kortvarige objekter, så denne kode fungerede bedre, end vi havde fortjent. Under testningen brugte kunderne den med stor succes. Men til sidst gik vi over til et nyt niveau.
Du kan spørge, hvorfor vi gemmer meddelelser i et format med 4K-sider, tekst og metadata i stedet for at arbejde direkte med logfiler. Der er mange grunde, der i bund og grund går ud på, at Scalyrs interne motor minder mere om en distribueret database end om et filsystem. Tekstsøgning kombineres ofte med database-lignende filtre på felter efter parsing af logfiler. Vi kan søge samtidig i mange tusinde logfiler ad gangen, og almindelige tekstfiler er ikke egnede til vores transaktionelle, replikerede, distribuerede datastyring.
Det så i starten ud til, at en sådan kode ikke var særlig velegnet til optimering ved hjælp af brute force-metoden. "Det rigtige arbejde" i String.indexOf() dominerede endda ikke i CPU-profilen. Det vil sige, at optimering af kun denne metode ikke ville have haft en betydelig effekt.
Det viste sig, at vi gemmer metadata i starten af hver side, mens teksten til alle meddelelser er pakket i UTF-8 i den anden ende. Ved at drage fordel af dette har vi omskrevet løkken til at søge over hele siden:
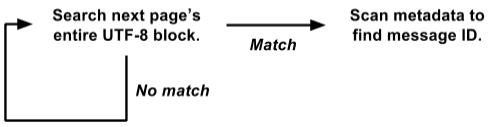
Denne version arbejder direkte med repræsentationen af raw byte[] og udfører søgningen af alle meddelelser på hele 4K-siden på én gang.
Det er meget lettere at optimere til brute force-metoden. Den interne søgeløkke kaldes samtidig for hele 4K-siden, ikke individuelt for hver meddelelse. Der er hverken kopiering af data eller tildeling af objekter. Endda mere komplekse operationer med metadata kaldes kun ved positive resultater, ikke for hver meddelelse. På den måde har vi elimineret en masse overhead, og den resterende belastning er koncentreret i en lille intern søgeløkke, der er velegnet til yderligere optimering.
Vores faktiske søgealgoritme er baseret på . Den ligner Boyer–Moore-algoritmen med et spring svarende til længden af søgestrengen ved hvert trin. Hovedforskellen er, at den tjekker to bytes ad gangen for at minimere falske positive fund.
Vores implementering kræver, at der skal oprettes en søgetabel på 64K for hver søgning, men det er peanuts i forhold til de gigabyte data, vi søger i. Den interne loop behandler flere gigabyte per sekund på en enkelt kerne. I praksis er den stabile ydeevne omkring 1,25 GB per sekund på hver kerne, og der er potentiale for forbedring. Nogle overhead kan fjernes uden for den interne loop, og vi planlægger at eksperimentere med den interne loop i C i stedet for Java.
Anvend kraften
Vi har diskuteret, at søgning i logs kan implementeres 'groft', men hvor meget 'kraft' har vi? Ganske meget.
1 kerne: når den bruges korrekt, er en kerne i en moderne processor ret kraftfuld i sig selv.
8 kerner: i øjeblikket arbejder vi på Amazon-servere hi1.4xlarge og i2.4xlarge SSD, hvor hver har 8 kerner (16 tråde). Som nævnt tidligere er disse kerner normalt optaget af baggrundsoperationer. Når en bruger udfører en søgning, suspenders baggrundsoperationerne, hvilket frigør alle 8 kerner til søgningen. Søgningen afsluttes normalt på en brøkdel af et sekund, hvorefter baggrundsarbejdet genoptages (regulatorprogrammet sikrer, at strømmen af søgninger ikke forstyrrer vigtigt baggrundsarbejde).
16 kerner: for at sikre pålidelighed organiserer vi serverne i grupper af master/slave. Hver master har en SSD og en EBS underordnet. Hvis den primære server fejler, tager SSD-serveren straks dens plads. Master og slave kører næsten hele tiden normalt, så hver datablok er tilgængelig for søgning på to forskellige servere (den underordnede EBS-server har en svag processor, så vi ser ikke på den). Vi deler opgaven mellem dem, så vi har i alt 16 kerner til rådighed.
Mange kerner: i den nærmeste fremtid vil vi fordele data på serverne, så alle deltager i behandlingen af hver ikke-triviel forespørgsel. Hver kerne vil arbejde. [Bemærk: vi har implementeret planen og øget søgehastigheden til 1 TB/s, se bemærkningen i slutningen af artiklen].
Simplicitet sikrer pålidelighed
Endnu et fordel ved metoden med rå styrke er den ret stabile ydeevne. Generelt er søgningen ikke særlig sensitiv over for detaljerne i opgaven og datasættet (jeg tror, det er derfor, den kaldes 'groft').
Indekset for nøgleord giver nogle gange en utrolig hurtig resultat, mens det i andre tilfælde ikke gør. Antag, at du har 50 GB logfiler, hvor termen 'customer_5987235982' optræder nøjagtigt tre gange. Søgningen efter denne term beregner direkte fra indekset tre placeringer og afsluttes øjeblikkeligt. Men en kompleks søgning med wildcard-tegn kan scanne tusindvis af nøgleord og tage lang tid.
På den anden side udføres brute force-søgning for enhver forespørgsel med mere eller mindre samme hastighed. Søgningen efter lange ord er bedre, men selv søgningen efter et enkelt tegn sker relativt hurtigt.
Simpliciteten ved brute force-metoden betyder, at dens ydeevne er tæt på det teoretiske maksimum. Her er der færre muligheder for uventet diskoverbelastning, låsekonflikter, pointer-jag og tusind andre årsager til fejl. Jeg kiggede lige på forespørgslerne, som brugere af Scalyr lavede i sidste uge på vores mest belastede server. Der var 14.000 forespørgsler. Præcist otte af dem tog mere end et sekund; 99% blev udført inden for 111 millisekunder (hvis du ikke har brugt loganalyseværktøjer, så tro mig: det er hurtigt).
Stabil, pålidelig ydeevne er vigtig for bekvemmeligheden ved at bruge tjenesten. Hvis den periodisk hakker, vil brugerne opfatte den som upålidelig og være uvillige til at bruge den.
Log-søgning i aktion
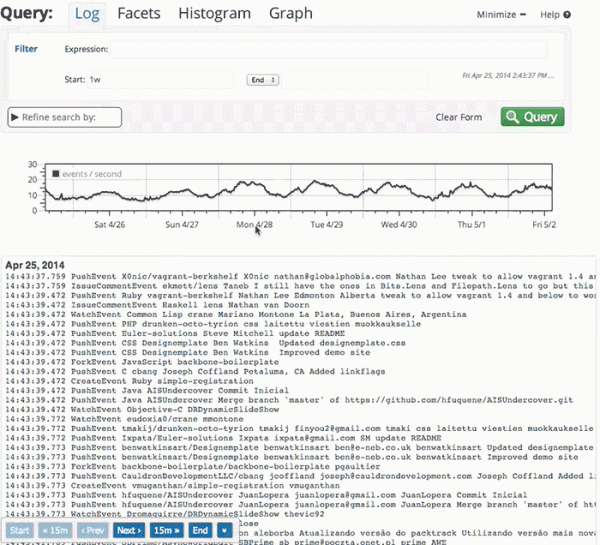
Her er en lille animation, der viser Scalyr-søgningen i aktion. Vi har en demo-konto, hvor vi importerer hver begivenhed fra hvert offentligt GitHub-repository. I denne demonstration analyserer jeg data fra en uge: cirka 600 MB ubehandlede logfiler.
Videoen er optaget live, uden forberedelse, på min desktop (cirka 5000 kilometer fra serveren). Ydeevnen, du vil se, skyldes i høj grad , samt en hurtig og pålidelig backend. Hver gang der opstår en pause uden en 'loading'-indikator, gør jeg en pause, så du kan nå at læse, hvad jeg er ved at trykke på.
Afslutningsvis
Når man arbejder med store datamængder, er det vigtigt at vælge en god algoritme, men "god" betyder ikke "kompliceret". Tænk over, hvordan din kode vil fungere i praksis. Nogle faktorer, der kan være afgørende i den virkelige verden, falder uden for den teoretiske analyse af algoritmer. Simpelthen algoritmer er lettere at optimere og mere stabile under grænsetilstande.
Overvej også konteksten, hvor koden vil blive udført. I vores tilfælde er der behov for tilstrækkeligt kraftige servere til at håndtere baggrundsopgaver. Brugerne initierer relativt sjældent søgningen, så vi kan låne en hel gruppe servere i den korte periode, der er nødvendig for at udføre hver søgning.
Ved hjælp af brute force har vi implementeret en hurtig, pålidelig, og fleksibel søgning i et sæt logger. Vi håber, at disse ideer vil være nyttige til jeres projekter.
Redigering: Titel og tekst er ændret fra "Søgning med hastighed på 20 GB i sekundet" til "Søgning med hastighed på 1 TB i sekundet" for at afspejle den forbedrede ydeevne de seneste år. Denne hastighedsforøgelse er primært relateret til ændringer i typen og antallet af EC2-servere, som vi i dag opsætter for at servicere den voksende kundebase. Snart forventes der ændringer, der vil give en yderligere kraftig forbedring af effektiviteten, og vi ser frem til at kunne meddele mere om det.
Kilde: habr.com
