

God fredag til alle! Der er mindre tid tilbage til lanceringen af kurset , derfor deler vi i dag oversættelsen af endnu et nyttigt materiale om emnet.
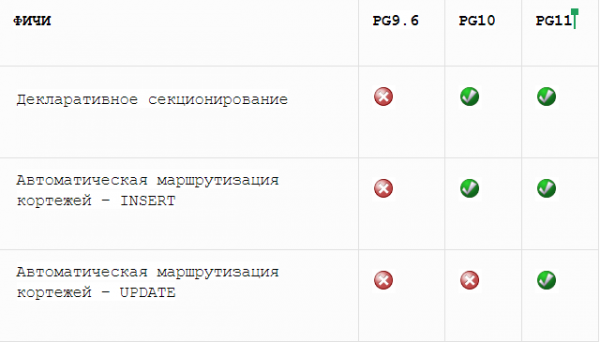
I udviklingsprocessen blev der udført et imponerende stykke arbejde med at forbedre partitioneringen af tabeller. Partitionering af tabeller — det er en funktion, der har eksisteret i PostgreSQL i lang tid, men som, hvis man kan sige det sådan, reelt ikke eksisterede før version 10, hvor den blev en temmelig nyttig funktion. Tidligere har vi påstået, at tabelarv er vores implementering af partitionering, og det er sandt. Men denne metode tvang dig til at udføre det meste af arbejdet manuelt. For eksempel, hvis du ønskede, at rækker skulle indsættes i sektioner under INSERTs, skulle du konfigurere triggere til at gøre det for dig. Partitionering ved hjælp af arv var meget langsom og besværlig at udvikle ekstra funktioner ovenpå.
I PostgreSQL 10 så vi fødslen af "deklaraiv partitionering" — en funktion designet til at løse mange af de problemer, der var uløselige ved brug af den gamle metode med arv. Dette førte til en langt mere kraftfuld værktøj, der gør det muligt for os at opdele data horisontalt!
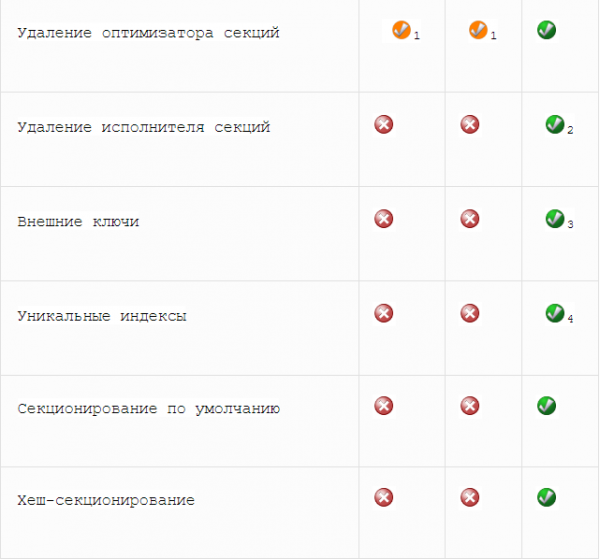
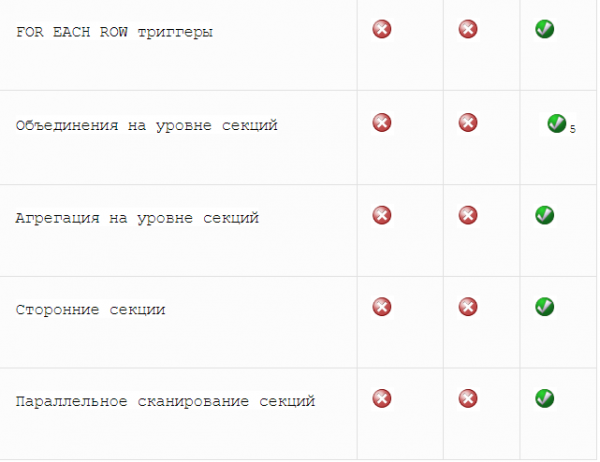
Sammenligning af funktioner
I PostgreSQL 11 kom der et imponerende sæt nye funktioner, der hjælper med at øge ydeevnen og gøre partitionerede tabeller mere gennemsigtige for applikationer.
1. Brug af begrænsende undtagelser
2. Tilføjer kun noder
3. Kun for partitionerede tabeller, der henviser til ikke-partitionerede
4. Indekser skal indeholde alle nøglekolonner i sektionen
5. Begrundelse for sektionen på begge sider skal være ens
Ydeevne
Her har vi også gode nyheder! En ny metode . Denne nye algoritme kan bestemme passende sektioner ved at gennemgå forespørgselsbetingelsen HVOR. Den tidligere algoritme kontrollerede derimod hver sektion for at afgøre, om den kunne overholde betingelsen HVOR. Det førte til en yderligere stigning i planlægningstiden, efterhånden som antallet af sektioner voksede.
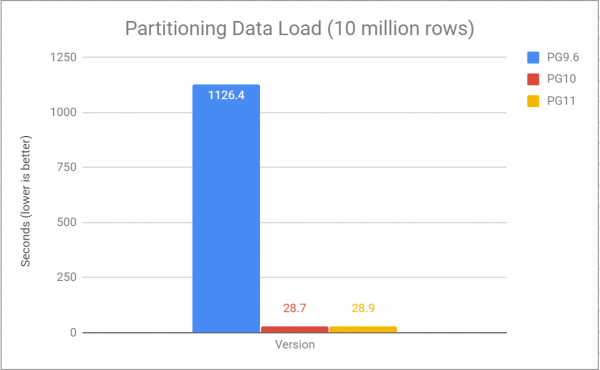
I version 9.6, med sektionering ved hjælp af arv, blev ruting af tuples i sektionen normalt udført ved at skrive en triggerfunktion, der indeholdt en række IF-operatorer til at indsætte tuple i den rigtige sektion. Disse funktioner kunne være meget langsomme at udføre. Med deklarativ sektionering, der blev tilføjet i version 10, fungerede det meget hurtigere.
Ved at bruge en sektioneret tabel med 100 sektioner kan vi vurdere ydeevnen ved at indlæse 10 millioner rækker i en tabel fra 1 BIGINT-kolonne og 5 INT-kolonner.
Ydeevnen af forespørgslen til denne tabel for at finde en indekseret post og udføre DML for at manipulere en post (ved kun at bruge 1 processor):
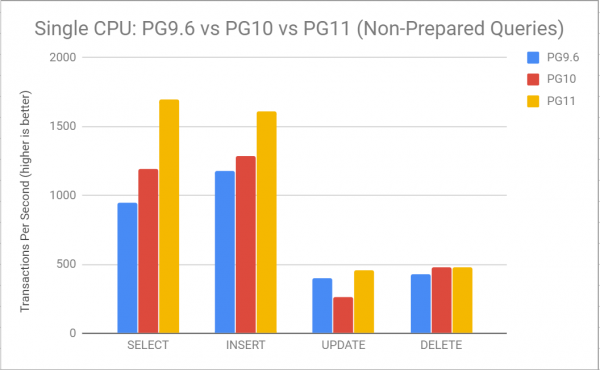
Her ser vi, at ydeevnen af hver operation er steget betydeligt efter PG 9.6. Forespørgsler SELECT ser meget bedre ud, især dem, der kan ekskludere mange sektioner under forespørgselsplanlægning. Det betyder, at planlæggeren kan springe det meste af arbejdet over, som det skulle have gjort tidligere. For eksempel bliver der ikke længere bygget stier til unødvendige sektioner.
Konklusion
Sektionering af tabeller begynder at blive en meget kraftfuld funktion i PostgreSQL. Det gør det muligt at hurtigt levere data online og overføre dem offline uden at vente på afslutningen af langsomme massive DML-operationer.Det betyder også, at relaterede data kan opbevares sammen, hvilket gør det muligt at få adgang til de nødvendige data langt mere effektivt. Forbedringerne, der blev lavet i denne version, ville ikke have været mulige uden udviklerne, anmelderne og committerne, der utrætteligt arbejdede på alle disse funktioner.
Tak til dem alle! PostgreSQL 11 ser simpelthen fantastisk ud!
Her er en kort, men temmelig interessant artikel. Del gerne kommentarer, og glem ikke at tilmelde dig , hvor programmet for kurset vil blive præsenteret i detaljer.
Kilde: habr.com
