

— en meget kraftfuld og praktisk mekanisme, hvis de samme handlinger udføres "nedad" på sammenkoblede data. Men ukontrolleret rekursion er en ondskab, der kan føre til uendelig udførelse af processen, eller (som oftere forekommer) til at "udnytte" al tilgængelig hukommelse.
Database management systemer fungerer i denne forbindelse efter de samme principper — "sagde, at jeg skulle grave, så jeg graver". Din forespørgsel kan ikke kun bremse nærliggende processer, ved konstant at optage CPU-ressourcer, men også "falde" hele databasen, ved at "spise" al den tilgængelige hukommelse. Derfor er beskyttelse mod uendelig rekursion udviklerens ansvar.
I PostgreSQL blev muligheden for at bruge rekursive forespørgsler introduceret tilbage i de gode gamle dage med version 8.4, men man kan stadig jævnligt støde på potentielt sårbare "forsvarsløse" forespørgsler. Hvordan kan man undgå problemer af denne art? Ikke at skrive rekursive forespørgsler
Men at skrive ikke-rekursive. Med venlig hilsen, Din K.O.
Faktisk tilbyder PostgreSQL et betydeligt antal funktioner, som man kan drage fordel af for at
anvende rekursion. ikke Brug en principielt anderledes tilgang til opgaven
Nogle gange kan man simpelthen se på opgaven "fra den anden side". Et eksempel på en sådan situation gav jeg i artiklen
"SQL HowTo: 1000 og én måde at aggregere på" WITH RECURSIVE src AS ( SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr ) , T(i, val) AS ( SELECT 1::bigint , 1 UNION ALL SELECT i + 1 , val * arr[i] FROM T , src WHERE i <= array_length(arr, 1) ) SELECT val FROM T ORDER BY -- udvælgelse af det endelige resultat i DESC LIMIT 1;
Denne forespørgsel kan erstattes med en variant fra matematikere:WITH src AS ( SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime ) SELECT exp(sum(ln(prime)))::integer val FROM src;
Bruge generate_series i stedet for loopsLad os sige, at vi står over for udfordringen med at generere alle mulige præfikser for strengen
'abcdefgh' WITH RECURSIVE T AS ( SELECT 'abcdefgh' str UNION ALL SELECT substr(str, 1, length(str) - 1) FROM T WHERE length(str) > 1 ) TABLE T;:
Er der virkelig brug for rekursion her?.. Hvis man benytter LATERAL generate_series og , så vil der faktisk ikke være behov for CTE:SELECT substr(str, 1, ln) str FROM (VALUES('abcdefgh')) T(str) , LATERAL( SELECT generate_series(length(str), 1, -1) ln ) X;
Ændre databasens strukturFor eksempel har du en tabel med forumindlæg med relationer om, hvem der svarede til hvem, eller tråde i
For eksempel har du en tabel med forumindlæg, der viser forholdet mellem hvem der svarede til hvem, eller en tråd i :
OPRET TABEL message(
  message_id
    uuid
      FØRSTE NØGLE
, reply_to
    uuid
      REFERENCER message
, body
    tekst
);
OPRET INDEX PÅ message(reply_to); 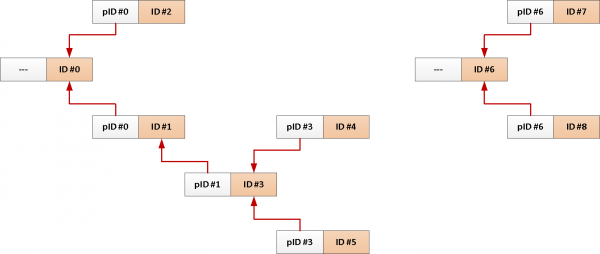
Den typiske forespørgsel for at hente alle beskeder om et emne ser omtrent sådan ud:
MED REKURSIV T SOM (
  VÆLG
    *
  FRA
    message
  HVOR
    message_id = $1
UNION ALL
  VÆLG
    m.*
  FRA
    T
  JOIN
    message m
      ON m.reply_to = T.message_id
)
TABEL T;
Men da vi altid har brug for hele emnet fra den oprindelige besked, hvorfor skulle vi så ikke tilføje dens identifikator til hver post automatisk?
-- lad os tilføje et felt med den fælles tema-id og en indeks på det
ALTER TABEL message
  TILFØJ KOLONNE theme_id uuid;
OPRET INDEX PÅ message(theme_id);

-- initialiser tema-id'en i triggeren ved indsættelse
OPRET ELLER ERSTAT FUNKTION ins() RETURNE TRIGGER AS $$
BEGIN
  NY.theme_id = CASO
    NÅR NY.reply_to ER NULL SÅ NY.message_id -- tag fra start-beskeden
    ELLERS ( -- eller fra beskeden, vi svarer på
      VÆLG
        theme_id
      FRA
        message
      HVOR
        message_id = NY.reply_to
    )
  END;
  RETURNE NY;
END;
$$ SPROG plpgsql;

OPRET TRIGGER ins FØR INDTSÆTNING
  PÅ message
    FOR HVER RÆKKE
UDFØR PROCEDURE ins(); 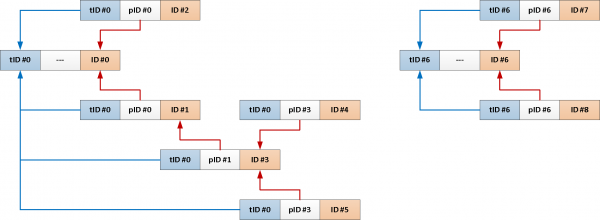
Nu kan hele vores rekursive forespørgsel reduceres til blot dette:
VÆLG
  *
FRA
  message
HVOR
  theme_id = $1;
Brug anvendelsesmæssige "afgrænsninger"
Hvis vi ikke kan ændre databasens struktur af en eller anden grund, lad os se, hvad vi kan støtte os til, så selv en fejl i dataene ikke fører til en uendelig rekursion.
Tæller for "dybde" af rekursion
Vi skal blot øge tælleren med én på hvert trin af rekursionen, indtil vi når en grænse, som vi anser for uacceptabel:
MED REKURSIV T SOM (
  VÆLG
    0 i
  ...
UNION ALL
  VÆLG
    i + 1
  ...
  HVOR
    T.i < 64 -- begrænsning
)
Pro: Ved forsøg på at skabe en uendelighed vil vi stadig ikke overskride det nævnte antal iterationer "ind i dybden".
Contra: Der er ingen garanti for, at vi ikke behandler den samme post flere gange — for eksempel på dybde 15 og 25, og så videre hvert +10. Ingen har lovet noget omkring "bredde" heller.
Formelt vil en sådan rekursion ikke være uendelig, men hvis antallet af poster stiger eksponentielt på hvert trin, ved vi alle, hvordan det ender...
Bevarer "vejen"
Vi tilføjer sekventielt alle identificerbare objekter, vi møder under rekursionens vej, til et array, der er den unikke "vej" til dem:
MED REKURSIV T SOM (
  VÆLG
    ARRAY[id] vej
  ...
UNION ALL
  VÆLG
    vej || id
  ...
  HVOR
    id  ALL(T.vej) -- matcher ikke nogen af
)
Pro: Hvis der er en cyklus i dataene, vil vi bestemt ikke behandle den samme post igen inden for den samme sti.
Contra: Men vi kan faktisk gennemgå alle poster uden at gentage os selv.
Begrænsning af stiens længde
For at undgå situationen med "vildledende" rekursion på en uklar dybde kan vi kombinere de to foregående metoder. Eller, hvis vi ikke ønsker at opretholde unødvendige felter, kan vi supplere betingelsen for fortsættelse af rekursionen med en vurdering af stiens længde:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) AND
    array_length(T.path, 1) < 10
)
Vælg den metode, du foretrækker!
Kilde: habr.com
