

I kraft af mit arbejde støder jeg ofte på situationer, hvor udvikleren skriver en forespørgsel og tænker "databasen er klog, den klarer det selv!"«
I nogle tilfælde (delvist på grund af manglende viden om databasen muligheder, delvist på grund af for tidlige optimeringer) fører en sådan tilgang til "Frankensteins".
Lad mig først give et eksempel på en sådan forespørgsel:
-- for hvert nøglepar finder vi associerede feltværdier
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- finder min/max værdier for hver første nøgle
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- binder efter første nøgle nøgleværdier og min/max-værdier
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
For at kunne vurdere kvaliteten af forespørgslen, lad os lave et vilkårligt datasæt:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
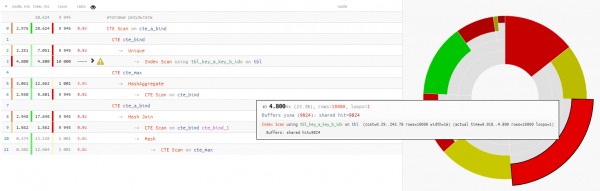
Det viser sig, at selve læse data tog mindre end en fjerdedel af den samlede tid til udførelsen af forespørgslen:
Lad os analysere det grundigt
Lad os kigge nærmere på forespørgslen og undre os:
- Hvorfor er der WITH RECURSIVE, når der ingen rekursive CTE'er er?
- Hvorfor gruppere min/max-værdier i en separat CTE, når de alligevel bindes til den originale forespørgsel?
+25% tid - Hvorfor bruge en gentagen startlæsning fra den tidligere CTE med den ubetingede ‘SELECT * FROM’ i slutningen?
+14% tid
I dette tilfælde var vi endda heldige, at der blev valgt Hash Join til forbindelsen i stedet for Nested Loop, eftersom det ville give os ikke én, men 10K! CTE Scan!
lidt om CTE ScanHer skal vi huske, at CTE Scan er det samme som Seq Scan — det vil sige ingen indeksering, kun en komplet søgning, som ville kræve 10K x 0.3ms = 3000ms ved loops gennem cte_max eller 1K x 1.5ms = 1500ms ved loops gennem cte_bind!
Så, hvad ønskede vi at opnå som resultat? Aha, normalt er det præcist det spørgsmål, der dukker op efter cirka 5 minutter med at analysere "tre-etagers" forespørgsler.
Vi ønskede for hver unik nøglepar at vise min/max fra gruppen efter key_a.
Så lad os bruge :
VÆLG DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FRA
	tbl
VINDUE
w SOM (PARTITION BY key_a); 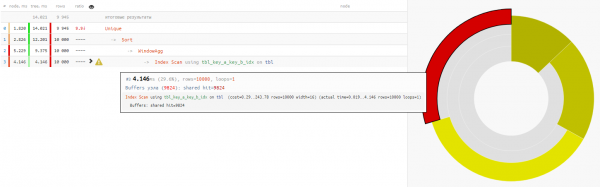
Da læsning af data i begge tilfælde tager omtrent 4-5 ms, er hele vores tidsgevinst -32% — ren belastning, der er fjernet fra CPU'en i databasen, hvis en sådan forespørgsel udføres tilstrækkeligt ofte.
Generelt bør man ikke tvinge databasen til at "bære det runde og rulle det firkantede."
Kilde: habr.com
