

I komplekse ERP-systemer har mange enheder en hierarkisk natur, når homogene objekter arrangeres i et træ af relationer «forælder — barn» — det inkluderer både organisationens struktur (alle disse filialer, afdelinger og arbejdsgrupper), varekataloget, arbejdsområderne, og geografi for salgssteder,…
Faktisk findes der ikke ét , hvor der ikke ville være noget hierarki som resultat. Men selv hvis du ikke arbejder 'i erhvervslivet', kan du stadig nemt støde på hierarkiske relationer. Egentlig, selv dit slægtstræ eller et etageplan i et indkøbscenter — er en lignende struktur.
Der er mange måder at opbevare et sådant træ i en DBMS, men i dag vil vi kun fokusere på én mulighed:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- lad os huske, at FK ikke indebærer automatisk oprettelse af indeks, i modsætning til PK
Og mens du kigger ind i dybden af hierarkiet, venter det tålmodigt på, hvor [u]effektive dine 'naive' metoder til at arbejde med en sådan struktur vil vise sig at være.
Lad os se på typiske opgaver, der opstår, deres implementering i SQL og forsøge at forbedre deres ydeevne.
#1. Насколько глубока кроличья нора?
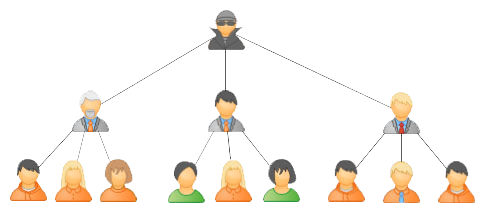
Lad os, for tydelighedens skyld, antage, at denne struktur vil afspejle afdelingers underordnede forhold i organisationen: afdelinger, divisioner, sektorer, filialer, arbejdsgrupper,… — uanset hvad vi kalder dem.
Lad os først generere vores 'træ' med 10K elementer
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Lad os starte med den mest enkle opgave — at finde alle medarbejdere, der arbejder inden for en bestemt sektor, eller i hierarkiets termer — finde alle efterkommere af en node. Og det ville også være godt at få 'dybden' af efterkommere… Alt dette kan være nødvendigt, for eksempel til at opbygge en slags .
Det ville ikke være noget, hvis der kun var et par niveauer af efterkommere og mængden var en håndfuld, men hvis niveauerne er flere end 5, og efterkommerne er i titusindvis — kan der opstå problemer. Lad os se på, hvordan traditionelle metoder til at søge "nedad i træet" skrives (og fungerer). Men først, lad os definere, hvilke noder der vil være mest interessante for vores forskning.
De mest dybe underniveauer:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...De mest brede underniveauer:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Til disse forespørgsler brugte vi en typisk rekursiv JOIN:
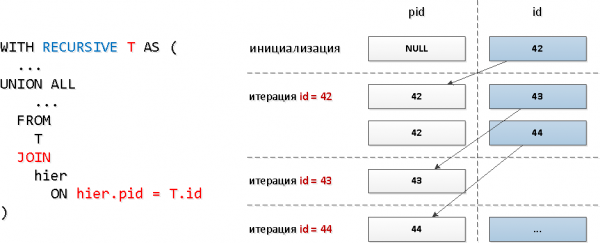
Det er tydeligt, at med denne forespørgselsmodel vil antallet af iterationer svare til det samlede antal efterkommere (og der er jo flere titusinde), og dette kan tage betydelige ressourcer, og dermed tid.
Lad os teste på det mest "brede" unodeniveau:
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 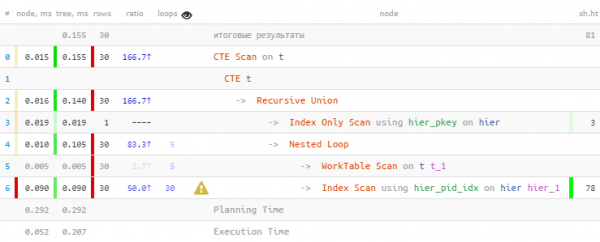
Som forventet har vi fundet alle 30 poster. Men det tog 60 % af den samlede tid — fordi vi i mellemtiden også lavede 30 søgninger i indekset. Men kan vi gøre det hurtigere?
Masser af læsning fra indekset
Og er det nødvendigt at lave separate forespørgsler til indekset for hver enkelt node? Det viser sig, at nej — vi kan læse fra indekset ved hjælp af med det samme ved flere nøgler i én anmodning.
= ANY(array) Og i hver sådan gruppe af identifikatorer kan vi tage alle de ID'er, der blev fundet i det foregående trin for "noderne". Det vil sige, at vi i hvert næste trin vil.
søge efter alle efterkommere på et bestemt niveau. Men her er problemet,i den rekursive forespørgsel kan man ikke referere til sig selv i den indlejrede forespørgsel, men vi skal jo have udvalgt præcist det, der blev fundet på det forrige niveau... Det viser sig, at man ikke kan lave en indlejret forespørgsel til hele udvalget — men til et specifikt felt af det — kan man. Og dette felt kan være et array — hvilket vi har brug for at bruge. ANY.
Det lyder lidt underligt, men på diagrammet er alt enkelt.
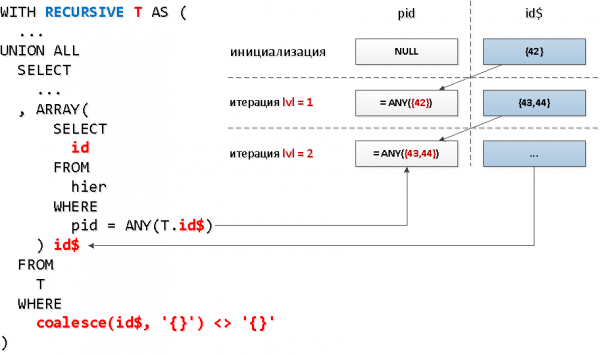
MED REKURSIV T SOM (
  VÆLG
    ARRAY[id] id$
  FRA
    hier
  HVOR
    id = 5300
UNION ALL
  VÆLG
    ARRAY(
      VÆLG
        id
      FRA
        hier
      HVOR
        pid = ANY(T.id$)
    ) id$
  FRA
    T
  HVOR
    coalesce(id$, '{}') <> '{}' -- betingelse for at forlade løkken - tomt array
)
VÆLG
  unnest(id$) id
FRA
T; 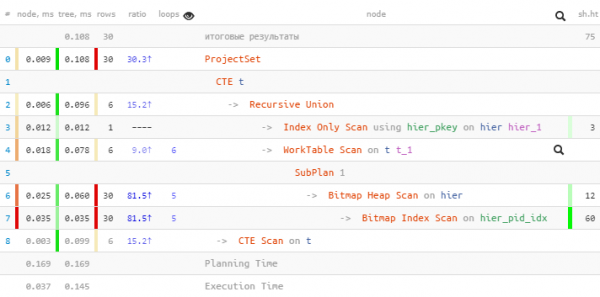
Og her er det vigtigste ikke engang gevinsten på 1,5 gange i tid, men at vi har læst færre buffers, da vi kun har 5 opslag til indekset i stedet for 30!
Et ekstra bonus er det faktum, at efter den endelige unnest vil identifikatorerne forblive sorteret efter "niveauer".
Kendetegn for node
Næste betragtning, som kan hjælpe med at forbedre ydeevnen — at "blade" ikke kan have børn, det vil sige, at der slet ikke er noget behov for at søge "nedad" for dem. I formuleringen af vores opgave betyder det, at hvis vi har bevæget os langs kæden af afdelinger og nået frem til en medarbejder, er der ikke længere nogen grund til at lede videre ned ad denne gren.
Lad os tilføje til vores tabel et ekstra boolean-felt, som straks vil fortælle os, om denne specifikke post i vores træ er en "node" — det vil sige, kan den overhovedet have efterkommere.
ALTER TABELL hier
  TILFØJ KOLONNE branch boolean;

OPDATER
  hier T
SÆT
  branch = TRUE
HVOR
  FINDES(
    VÆLG
      NULL
    FRA
      hier
    HVOR
      pid = T.id
    BEGRÆNS 1
);
-- Forespørgsel udført med succes: 3033 rækker ændret på 42 ms.
Fremragende! Det viser sig, at vi kun har lidt over 30% af alle elementer i træet med efterkommere.
Lad os nu anvende en lidt anden mekanik — forbindelser til den rekursive del via generate_series, hvilket gør det muligt for os straks at tilgå felterne i den rekursive "tabel", og vi bruger den aggregerede funktion med filtreringsbetingelse baseret på nodekendetegnet til at reducere sæt af nøgler:
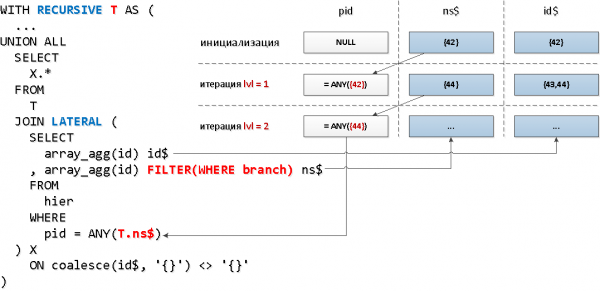
MED REKURSIV T SOM (
  VÆLG
    array_agg(id) id$
  , array_agg(id) FILTER(HVIS branch) ns$
  FRA
    hier
  HVOR
    id = 5300
UNION ALL
  VÆLG
    X.*
  FRA
    T
  JOIN LATERAL (
    VÆLG
      array_agg(id) id$
    , array_agg(id) FILTER(HVIS branch) ns$
    FRA
      hier
    HVOR
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}') <> '{}'
)
VÆLG
  unnest(id$) id
FRA
T; 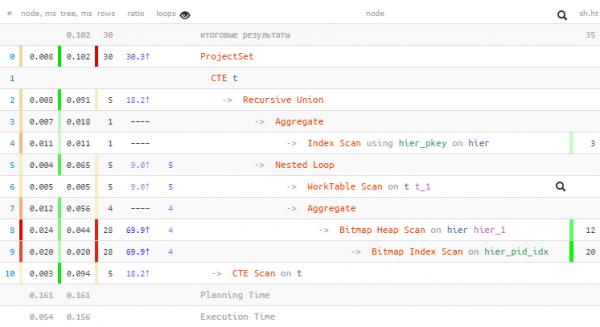
Vi kunne reducere endnu et opkald til indekset og fået mere end 2 gange besparelse i volumen der bliver læst.
#2. Вернемся к корням
Denne algoritme vil være nyttig, hvis du har brug for at samle poster for alle elementer "op i træet", mens du bevarer information om, hvilken oprindelig blad (og med hvilke indikatorer) der har ført til dets udvælgelse — for eksempel til at danne en opsummeringsrapport med aggregering på noder.
Det videre skal udelukkende betragtes som proof-of-concept, da forespørgslen bliver ret klodset. Men hvis den dominerer i din database, bør du overveje at anvende lignende metoder.
Lad os starte med et par enkle udsagn:
- Den samme post fra databasen er bedst at læse kun én gang.
- Poster fra databasen er mere effektive at læse "i bundter", end enkeltvis.
Lad os nu forsøge at konstruere den forespørgsel, vi har brug for.
Trin 1
Det er åbenlyst, at vi ved initialiseringen af rekursionen (hvor uden!) må læse optegnelserne af selve bladene ud fra det givne sæt af identifikatorer:
WITH RECURSIVE tree AS (
  SELECT
    rec -- dette er den komplette post i tabellen
  , id::text chld -- dette er "sættet" af de oprindelige blade, der førte hertil
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Hvis nogen fandt det underligt, at "sættet" opbevares som en streng og ikke som et array, så er der en simpel forklaring på dette. For strenge findes der en indbygget aggregerende "sammensluttende" funktion string_agg, men for arrays findes der ikke. Selvom det ikke er .
Trin 2
Nu skal vi finde sæt ID'er for de sektioner, der skal hentes videre. De vil næsten altid blive dupliceret i forskellige optegnelser fra den oprindelige samling — derfor skal vi gruppere dem, mens vi bevarer informationen om de kildematerialer, de kommer fra.
Men her venter tre problemer på os:
- "Under-rekursiv" del af forespørgslen kan ikke indeholde aggregatfunktioner med
GROUP BY. - Adgang til den rekursive "tabel" kan ikke være i en indlejret underforespørgsel.
- Forespørgslen i den rekursive del kan ikke indeholde CTE.
Heldigvis er alle disse problemer forholdsvis lette at omgå. Lad os starte fra slutningen.
CTE i den rekursive del
Sådan gør man ikke fungerer:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
Og sådan — fungerer det, parenteserne løser det!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Indlejret forespørgsel til den rekursive "tabel"
Hm… Adgang til den rekursive CTE kan ikke være i en indlejret forespørgsel. Men den kan være inden for CTE'en! Og den indlejrede forespørgsel kan allerede henvise til denne CTE!
GROUP BY inde i rekursionen
Ubehageligt, men… Vi har en enkel metode til at simulere GROUP BY ved hjælp af DISTINCT ON og vinduesfunktioner!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- fungerer ikke!
Men sådan — fungerer det!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Nu ser vi, hvorfor det numeriske ID blev til tekst — så de kan kædes sammen med komma!
Trin 3
Vi har kun lidt tilbage til finalen:
- vi gennemgår posterne for "afsnit" baseret på sættet af grupperede ID'er
- vi matcher de gennemgåede afsnit med "sætterne" af de oprindelige ark
- vi "udruller" række-sættet ved hjælp af
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 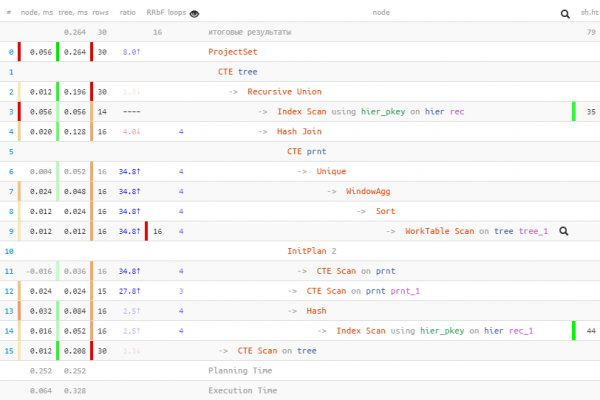
Kilde: habr.com
