

I dag vil der ikke være nogen komplekse tilfælde eller indviklede SQL-algoritmer. Alt vil være meget simpelt, på niveau med Captain Obvious — lad os gøre det. visning af hændelsesregisteret sorteret efter tid.
Det vil sige, der ligger en tabel i databasen events, og den har et felt ts — præcist det tidspunkt, hvorpå vi ønsker at vise disse poster i orden:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Det er tydeligt, at vi ikke kun vil have et par optegnelser, så vi får brug for en form for sideskiftning.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
Det er næsten ikke en joke — sjældent, men det sker i naturen. Nogle gange, efter at have arbejdet med ORM, er det svært at omstille sig til "direkte" arbejde med SQL.
Men lad os gå videre til mere almindelige og mindre åbenlyse problemer.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - poster på siden, $1 - start på siden
Hvorfor er tallet 26 her? Det er det omtrentlige antal poster, der skal udfylde én skærm. Mere præcist, 25 viste poster, plus 1, der signalerer, at der er flere poster at se, og det giver mening at fortsætte.
Selvfølgelig kan denne værdi ikke "indbygges" i forespørgslen, men gives som en parameter. Men i så fald vil PostgreSQL-planlæggeren ikke kunne læne sig op ad, at der kun bør være relativt få poster — og den vil nemt vælge en ineffektiv plan.
Og mens visningen af registeret i applikationens grænseflade implementeres som skift mellem visuelle "sider", bemærker ingen længe noget mistænksomt. Indtil øjeblikket, hvor der i kampen for UI/UX-behagelighed besluttes at redesignere grænsefladen til "uendelig scrolling" — altså at alle poster i registeret vises som én liste, som brugeren kan rulle op og ned.
Og i en ny testning fanger de dig på duplikerede optegnelser i registeret. Hvorfor, når der er en god indeks (ts), som din forespørgsel er baseret på?
Netop fordi du ikke har taget højde for, at ts ikke er en unik nøgle i denne tabel. Egentlig er værdierne ikke unikke, som med enhver "tid" i reelle forhold - derfor kan den samme post nemt "springe" fra side til side i to naboforespørgsler på grund af en anden endelig rækkefølge inden for sortering af samme nøgleværdi.
Der er faktisk skjult et andet problem her, som er meget sværere at opdage - nogle poster vil slet ikke blive vist overhovedet! For "dublerede" poster har taget nogen andres plads. En detaljeret forklaring med flotte billeder kan .
Udvid indekset
Den kloge udvikler forstår, at nøglen til indekset skal være unik, og den enkleste måde at gøre det på - er at udvide det med et forudbestemt unikt felt, som primærnøglen ville være et godt valg:
CREATE UNIQUE INDEX ON events(ts DESC, id DESC);Og forespørgslen muterer:
SELECT
  ...
ORDER BY
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Nogle tid senere kommer DBA'en til dig og "glæder" dig med, at dine forespørgsler , og generelt er det på tide at skifte til navigation fra den sidst viste værdi. Din forespørgsel muterer igen:
SELECT
  ...
WHERE
  (ts, id) < ($1, $2) -- de seneste værdier modtaget fra det forrige trin
ORDER BY
  ts DESC, id DESC
LIMIT 26;
Du sukkede lettet, indtil der skete...
#3. Чистка индексов
For engang læste din DBA og indså, at "ikke den nyeste" tidsstempel - det er ikke godt. Og han kom igen til dig - nu med tanken om, at det index alligevel burde vende tilbage til (ts DESC).
Men hvad skal man gøre med det oprindelige problem med "springende" poster mellem siderne?.. Det er simpelt - man skal vælge blokke med et ufast antal poster!
Generelt, hvem forbyder os at læse ikke "præcist 26", men "mindst 26"? For eksempel sådan, at næste blok vil have poster med klart andre værdier ts – så ville der ikke være problemer med "hoppen" af poster mellem blokke!
Her er, hvordan man opnår det:
SELECT
  ...
WHERE
  ts = coalesce((
    SELECT
      ts
    FROM
      events
    WHERE
      ts < $1
    ORDER BY
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-infinity')
ORDER BY
  ts DESC;
Hvad sker der her overhovedet?
- Vi skrider 25 poster "nedad" og får "grænseværdien"
ts. - Hvis der ikke er noget der, så ændrer vi NULL-værdien til
-infinity. - Vi trækker hele segmentet af værdier mellem den opnåede værdi
tsog den overførte parameter $1 (den tidligere "sidste" viste værdi). - Hvis blokken returnerer færre end 26 poster, er den den sidste.
Eller det samme som billede:
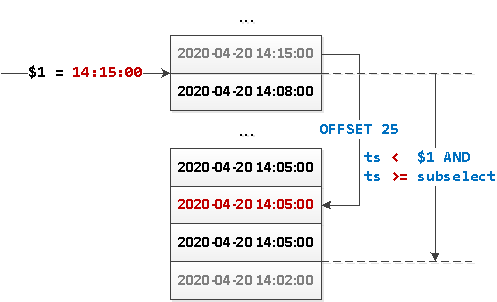
Da vi nu har udtagningen har ikke et bestemt 'startpunkt', så er der intet, der forhindrer os i at "udvide" denne forespørgsel baglæns og implementere dynamisk indlæsning af datablokke fra "referencepunktet" i begge retninger - både nedad og opad.
Bemærkning
- Ja, i så fald henvender vi os til indekset to gange, men alt er "rent efter indekset". Derfor vil den indlejrede forespørgsel kun føre til én ekstra Index Only Scan.
- Det er tydeligt, at denne metode kun kan anvendes, når du har værdier
tskun tilfældigt kan krydse hinanden og de er få. Hvis dit typiske tilfælde derimod er "en million poster på 00:00:00.000", er det ikke en god idé. Det vil sige, du bør ikke tillade et sådant tilfælde. Men hvis det sådan er sket, så brug varianten med det udvidede indeks.
Kilde: habr.com
