

Vi fortsætter serien af artikler, der fokuserer på at undersøge de lidt kendte metoder til at forbedre ydeevnen af "tilsyneladende simple" forespørgsler i PostgreSQL:
Tro ikke, at jeg ikke kan lide JOIN så meget… 🙂
Men ofte er forespørgslen mærkbart mere effektiv uden det. Derfor vil vi i dag prøve at frigøre os fra den ressourcekrævende JOIN — ved hjælp af et ordforråd.
Fra og med PostgreSQL 12 kan nogle af de nedenfor beskrevne situationer opføre sig lidt anderledes på grund af . Denne adfærd kan ændres tilbage til det tidligere ved at angive nøgleordet
MATERIALIZED.
Masser af "fakta" om et begrænset ordforråd
Lad os tage en helt konkret anvendelsessituation — vi skal vise en liste over eller aktive opgaver med afsendere:
25.01 | Ivanov I.I. | Forbered beskrivelsen af den nye algoritme.
22.01 | Ivanov I.I. | Skriv en artikel til Habr: liv uden JOIN.
20.01 | Petrov P.P. | Hjælp med at optimere forespørgslen.
18.01 | Ivanov I.I. | Skriv en artikel til Habr: JOIN med hensyntagen til datadistribution.
16.01 | Petrov P.P. | Hjælp med at optimere forespørgslen.
I en abstrakt verden burde opgaveforfatterne være jævnt fordelt blandt alle medarbejdere i vores organisation, men i virkeligheden kommer opgaver som regel fra et ret begrænset antal personer — "fra ledelsen" opad i hierarkiet eller "fra samarbejdspartnere" fra nærliggende afdelinger (analytikere, designere, marketing, …).
Lad os antage, at der i vores organisation af 1000 personer kun er 20 forfattere (oftere endnu færre), der stiller opgaver til hver enkelt medarbejder, og , for at accelerere den "traditionelle" forespørgsel.
Scriptskaber
-- ansatte
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- opgaver med den angivne fordeling
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Vis de sidste 100 opgaver for en specifik udfører:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 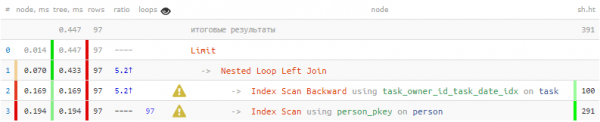
Det viser sig, at 1/3 af al tid og 3/4 af læsninger datasider blev lavet kun for at søge efter forfatteren 100 gange — for hver opgave, der vises. Men vi ved jo, at der blandt denne hundrede kun 20 forskellige — kan vi ikke bruge denne viden?
hstore-ordbog
Lad os bruge til at generere en "ordbog" med nøgle-værdi:
CREATE EXTENSION hstoreI ordbogen er det tilstrækkeligt at placere ID på forfatteren og hans navn, så vi senere kan hente det ved denne nøgle:
-- dannelse af den ønskede udvælgelse
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- dannelse af ordbog for unikke værdier
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- få de relaterede værdier fra ordbogen
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> nøgle
FROM
T; 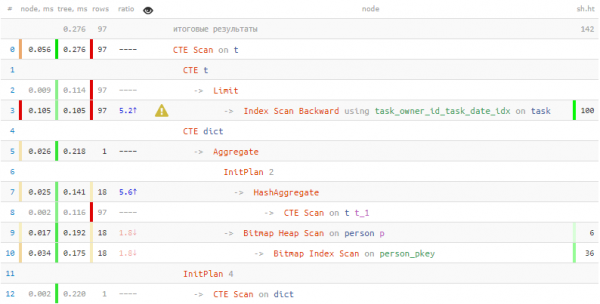
At hente information om personer tog 2 gange mindre tid og 7 gange mindre læsning af data! Udover "ordboggørelsen", hjalp disse resultater os også med at nå masseudtræk af poster fra tabellen i et enkelt gennemløb ved hjælp af = ANY(ARRAY(...)).
Tabelposter: serialisering og deserialisering
Men hvad skal vi gøre, hvis vi vil gemme ikke kun et tekstfelt i ordbogen, men en hel post? I dette tilfælde hjælper PostgreSQL os med at arbejde med en tabelpost som en enkelt værdi:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magi #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magi #2
FROM
  T;
Lad os se nærmere på, hvad der overhovedet skete her:
- Vi tog p som alias for den fulde post fra tabelen person og samlede dem i et array.
- Dette array af optegnelser er blevet typecastet til et array af tekststrenge (person[]::text[]), så det kan placeres i en hstore-ordbog som et array af værdier.
- Når vi modtager den relaterede optegnelse, trækker vi den ud af ordbogen ved hjælp af nøglen som en tekststreng.
- Vi skal omdanne teksten til en tabeltype-værdi person (for hver tabel oprettes en tilsvarende type automatisk).
- Vi "udviklede" den typede post til kolonner ved hjælp af
(...).*.
json-ordbog.
Men dette trick, som vi anvendte ovenfor, virker ikke, hvis der ikke er en relevant tabeltype til at udføre "typecastingen". Den samme situation vil opstå, hvis vi prøver at bruge en CTE-streng i stedet for en "rigtig" tabel.
I dette tilfælde vil :
...
, p AS ( -- dette er allerede en CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- nu er dette allerede json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- og indeni json for hver række
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- udtrukket fra ordbogen som json
      ) AS j(name text, birth_date date) -- fyldt ud i den struktur, vi har brug for
  ) j;
Det skal bemærkes, at når vi beskriver den ønskede struktur, kan vi kun liste de felter fra den oprindelige række, som vi rent faktisk har brug for. Hvis vi har en "oprindelig" tabel, er det bedre at bruge funktionen json_populate_record..
Adgangen til ordbogen foregår stadig engang, men omkostningerne ved json-[de]serialisering er ret store,, derfor er det fornuftigt kun at benytte denne metode i visse tilfælde, hvor en "ærlig" CTE Scan præsterer værre.
Vi tester ydeevnen.
Så vi har fået to måder at serialisere data i ordbogen på — hstore / json_object.Derudover kan vi også generere selve arrays af nøgler og værdier på to måder, med intern eller ekstern konvertering til tekst: array_agg(i::text) / array_agg(i)::text[]..
Lad os kontrollere effektiviteten af forskellige former for serialisering på et strengt syntetisk eksempel — vi serialiserer forskellige antal nøgler.:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Evaluering script: serialisering.
MED T SOM (
  VÆLG
    *
  , (
      VÆLG
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FRA
        (
          VÆLG
            array_agg(el) ea
          FRA
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              MED dict SOM (
                VÆLG
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FRA
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABEL dict
            $$) T(el text)
        ) T
    ) et
  FRA
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  BESTIL
    1, 2
)
VÆLG
  v
, avg(et)::numeric(32,3)
FRA
  T
GRUPPER EFTER
  1
BESTIL
1; 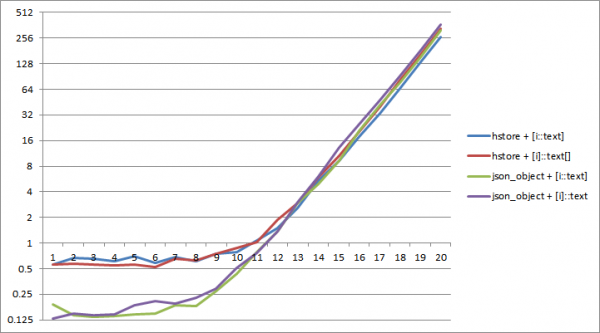
I PostgreSQL 11 op til en ordliste-størrelse på 2^12 nøgler serialisering til json kræver mindre tid. Den mest effektive kombination er json_object og "intern" datatype konvertering array_agg(i::text).
Lad os nu forsøge at læse værdien af hver nøgle 8 gange — for hvis man ikke henvender sig til ordlisten, hvad er så meningen?
Evalueringsscript : læsning fra ordlisten
MED T SOM (
  VÆLG
    *
  , (
      VÆLG
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FRA
        (
          VÆLG
            array_agg(el) ea
          FRA
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              MED dict SOM (
                VÆLG
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FRA
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              VÆLG
                (TABLE dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              FRA
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FRA
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  BESTIL
    1, 2
)
VÆLG
  v
, avg(et)::numeric(32,3)
FRA
  T
GRUPPER EFTER
  1
BESTIL
1; 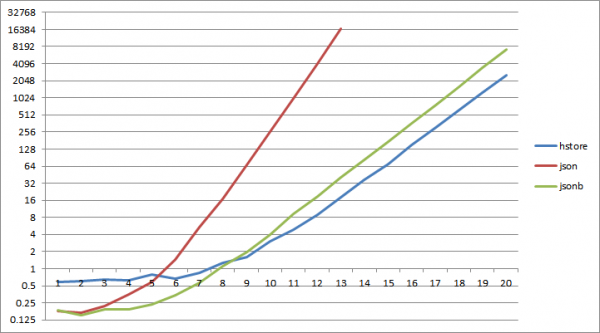
Og… omtrent ved 2^6 nøgler begynder læsning fra json-ordlisten at falde relativt set til læsningen fra hstore, det samme for jsonb sker ved 2^9.
De endelige konklusioner:
- hvis man skal udføre JOIN med gentagne poster — er det bedre at bruge "ordliste" fra tabellen
- hvis din ordliste forventes at være lille og du vil læse lidt fra den — kan du bruge json[b]
- i alle andre tilfælde hstore + array_agg(i::text) vil være mere effektivt
Kilde: habr.com
