

Jeg vil gerne invitere dig til at gennemgå transskriptionen af Vladimir Sitnikovs rapport fra begyndelsen af 2016 "PostgreSQL og JDBC - vi presser det hele ud"
Goddag! Mit navn er Vladimir Sitnikov. Jeg har arbejdet i 10 år hos NetCracker. Og jeg beskæftiger mig primært med ydeevne. Alt relateret til Java, alt relateret til SQL – det er det, jeg elsker.
Og i dag vil jeg fortælle om de udfordringer, vi stødte på i virksomheden, da vi begyndte at bruge PostgreSQL som database-server. Og vi arbejder primært med Java. Men det, jeg vil tale om i dag, relaterer sig ikke kun til Java. Som erfaringen har vist, opstår det også i andre sprog.
Vi vil tale om:
- dataudtræk.
- Databearbejdning.
- Og også om ydeevne.
- Og om de faldgruber, der ligger skjult.
Lad os starte med et simpelt spørgsmål. Vi henter en række fra tabellen efter det primære nøgle.
Databasen ligger på samme vært. Og hele dette system tager 20 millisekunder.
De 20 millisekunder er meget. Hvis du har 100 sådanne forespørgsler, bruger du tid i sekunder på at behandle disse forespørgsler, det vil sige spilder tid.
Vi kan ikke lide at gøre det og kigger på, hvad databasen tilbyder os til dette. Databasen tilbyder os to muligheder for at udføre forespørgsler.
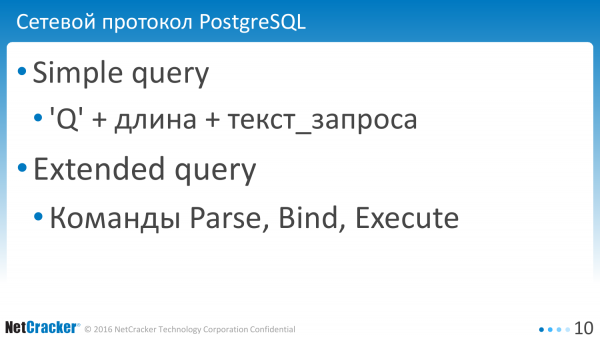
Den første mulighed er en simpel forespørgsel. Hvad er fordelen ved den? Den er god, fordi vi blot tager den og sender den uden mere.
Databasen har også en udvidet forespørgsel, som er mere usædvanlig, men mere funktionel. Man kan sende forespørgsler om parsing, udførelse, variabelbinding osv. separat.
Super udvidet forespørgsel – det vil vi ikke dække i den nuværende rapport. Måske ønsker vi noget fra databasen, og der er en liste over ønsker, som er blevet dannet på en eller anden måde, det vil sige, det er det, vi ønsker, men det er umuligt lige nu og inden for det næste år. Derfor skriver vi det ned og vil gå hen og ryste de vigtigste folk.
Det, vi kan gøre, er simpel forespørgsel og udvidet forespørgsel.
Hvad er særegenheden ved hver tilgang?
Simpel forespørgsel er godt at bruge til engangsudførelse. Udfør den én gang og glem den. Problemet er, at den ikke understøtter binært dataformat, det vil sige for nogle højtydende systemer er den ikke egnet.
Udvidet forespørgsel – sparer tid på parsing. Det er det, vi har gjort og begyndt at bruge. Det har hjulpet os ekstremt meget. Der er ikke kun besparelse på parsing. Der er også besparelse på dataoverførsel. At overføre data i binært format er meget mere effektivt.
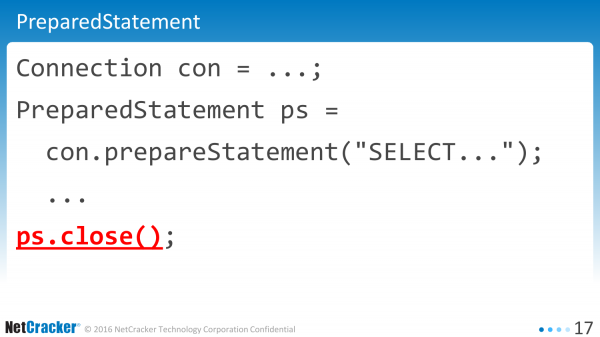
Lad os gå til praksis. Sådan ser en typisk applikation ud. Dette kan være Java osv.
Vi har oprettet en statement. Udført kommandoen. Oprettet en close. Hvor er fejlen her? Hvad er problemet? Der er ingen problemer. Sådan står der i alle bøger. Sådan skal man skrive. Hvis du ønsker maksimal ydeevne, så skriv således.
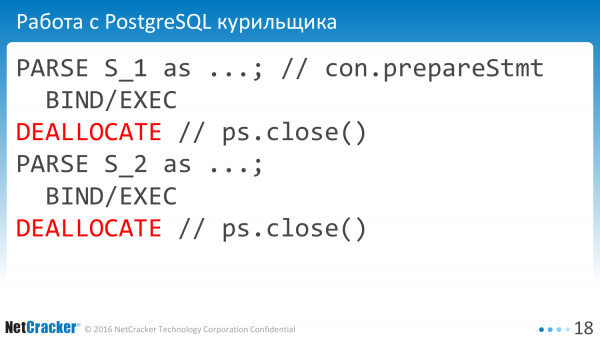
Men praksis har vist, at dette ikke virker. Hvorfor? Fordi vi har metoden «close». Og når vi gør sådan, så er det fra databasens synspunkt – det svarer til en ryger, der arbejder med databasen. Vi sagde «PARSE EXECUTE DEALLOCATE».
Hvorfor disse unødvendige oprettelser og eksport af statements? De er ikke nødvendige for nogen. Men normalt i PreparedStatement sker det, at når vi lukker dem, lukker de alt i databasen. Det er ikke det, vi ønsker.
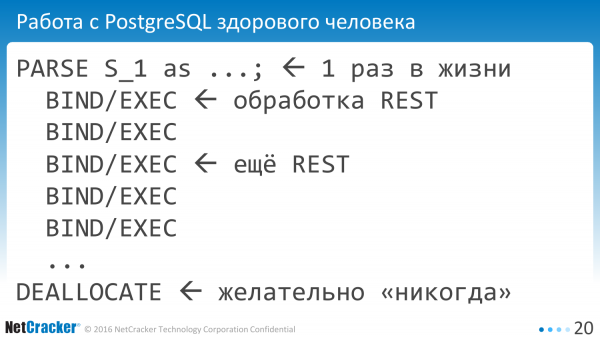
Vi ønsker, ligesom sunde mennesker, at arbejde med databasen. En gang tog vi og forberedte vores statement, og så udfører vi det mange gange. I virkeligheden mange gange – det er en gang i hele applikationens liv, vi har parseret. Og på forskellige REST bruger vi det samme statement id. Det er vores mål.
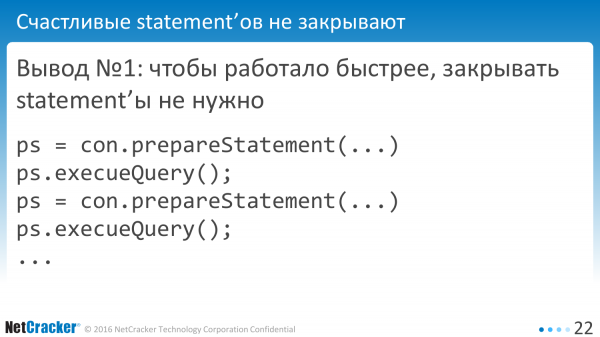
Hvordan kan vi nå dette?
Meget simpelt – vi skal ikke lukke statements. Vi skriver sådan: «prepare» «execute».
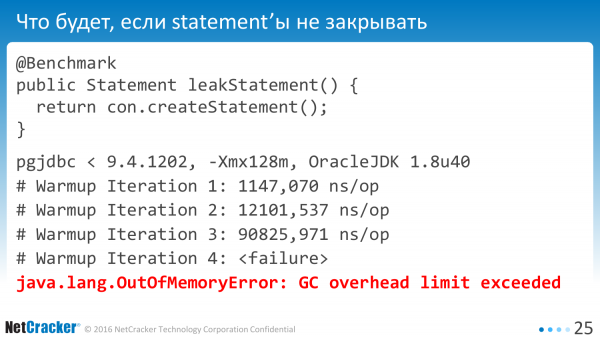
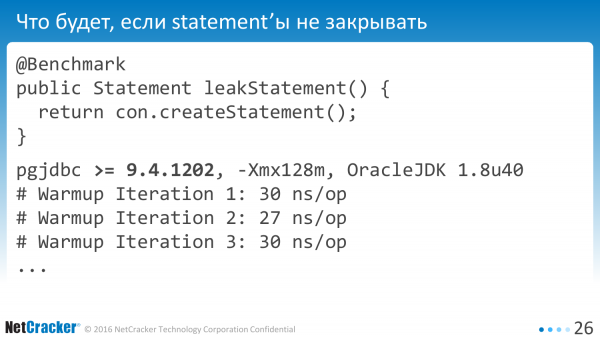
Hvis vi kører sådan noget, så er det klart, at et eller andet sted overfyldes. Hvis det ikke er klart, kan vi måle. Lad os tage og skrive en benchmark, hvor vi har en så simpel metode. Vi opretter en statement. Kører på en eller anden version af driveren og får, at den falder ret hurtigt med tab af al hukommelse, som vi har mistet.
Det er klart, at sådanne fejl let kan rettes. Jeg vil ikke tale om dem. Men jeg vil sige, at i den nye version fungerer det meget hurtigere. Metoden er meningsløs, men ikke desto mindre.
Hvordan arbejder man korrekt? Hvad skal vi gøre for dette?
I virkeligheden lukker applikationerne altid statements. I alle bøger skriver de, at man skal lukke dem, ellers lækker hukommelse.
Og PostgreSQL kan ikke cache forespørgsler. Hver session skal selv oprette denne cache.
Og vi vil heller ikke bruge tid på parsing.
Og som sædvanlig har vi to muligheder.
Den første mulighed er, at vi tager og siger, lad os pakke alt ind i PgSQL. Der er caching. Det cachen alt. Det vil blive fantastisk. Vi har kigget på det. Vi har 100500 forespørgsler. Det virker ikke. Vi er ikke enige – vi vil ikke håndtere forespørgsler manuelt. Nej-nej.
Vi har en anden mulighed – at tage og lave det selv. Vi åbner kildefilerne og begynder at kode. Koder, koder. Det viste sig, at det ikke er så svært at gøre.
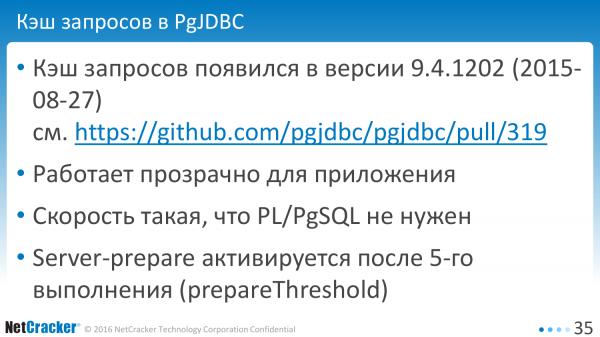
Dette kom frem i august 2015. Der er nu en mere moderne version. Og alt går fantastisk. Det fungerer så godt, at vi ikke ændrer noget i applikationen. Og vi er endda holdt op med at tænke i retning af PgSQL, dvs. det var nok til at reducere alle omkostninger til næsten nul.
Server-prepared statements aktiveres ved den femte udførelse for at undgå at bruge hukommelse i databasen til hver enkelt engangsforespørgsel.
Man kan spørge – hvor er tallene? Hvad får I? Og her kan jeg ikke give tal, fordi det er forskellige for hver forespørgsel.
Vores forespørgsler var sådan, at vi brugte omkring 20 millisekunder på parsing af OLTP-forespørgsler. Det var 0,5 millisekunder til udførelse, 20 millisekunder til parsing. Forespørgsel – 10 KiB tekst, 170 linjer plan. Dette er en OLTP-forespørgsel. Den anmoder om 1, 5, 10 linjer, nogle gange mere.
Men vi ønskede slet ikke at bruge 20 millisekunder. Vi reducerede det til 0. Alt er godt.
Hvad kan I tage med herfra? Hvis I bruger Java, så tager I den moderne version af driveren og er glade.
Hvis I bruger et andet sprog, så tænk – måske underminerer dette også jer? For set fra det endelige sprog, for eksempel, hvis PL 8 eller LibPQ, så er det ikke indlysende, at I bruger tid ikke på udførelsen, men på parsing, og det er værd at tjekke. Hvordan? Alt er gratis.
Undtagen at der er fejl og nogle særlige forhold. Og dem vil vi netop tale om nu. Størstedelen vil handle om industriel arkæologi, om hvad vi har fundet, og hvad vi er stødt på.
Hvis forespørgslen genereres dynamisk. Det sker nogle gange. Nogen klipper strenge sammen, og det bliver en SQL-forespørgsel.
Hvad er galt med det? Det er dårligt, fordi vi hver gang ender med en anden streng.
Og denne forskellige række skal beregne hashCode igen. Det er virkelig en CPU-opgave – at finde den lange forespørgsel i selv en eksisterende hash er ikke så let. Så konklusionen er simpel – generer ikke forespørgsler. Opbevar dem i en enkelt variabel. Og vær glad.
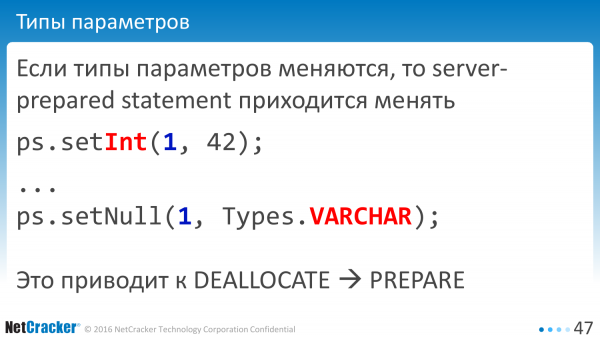
Næste problem. Datatyper er vigtige. Der findes ORM'er, der siger, at det ikke er vigtigt, hvilken NULL det er, lad det være en eller anden. Hvis det er Int, så siger vi setInt. Og hvis det er NULL, så lad det altid være VARCHAR. Og hvad gør det i sidste ende, hvilken NULL der er der? Databasen forstår det selv. Og sådan et billede fungerer ikke.
I praksis er databasen slet ikke ligeglad. Hvis du første gang sagde, at dette er et tal, og anden gang sagde, at det er VARCHAR, så er det umuligt at genbruge server-forberedte statements. Og i så fald må vi genskabe vores statement fra bunden.
Hvis du udfører den samme forespørgsel, så sørg for, at datatyperne i kolonnen ikke blandes. Du skal holde øje med NULL. Dette er en almindelig fejl, vi havde, efter vi begyndte at bruge PreparedStatements.
Okay, vi har aktiveret det. Måske brugte vi en driver. Og ydeevnen faldt. Alt blev dårligt.
Hvordan kan det ske? Er det en bug eller en funktion? Desværre kunne vi ikke forstå – om det var en bug eller en funktion. Men der er et ret enkelt reproduktionsscenarie for dette problem. Det overraskede os helt. Og det handler om at hente data fra bogstaveligt talt én tabel. Vi havde selvfølgelig flere af sådanne forespørgsler. De involverede normalt to-tre tabeller, men der er dette reproduktionsscenarie. Tag en hvilken som helst version af din database og reproducer det.
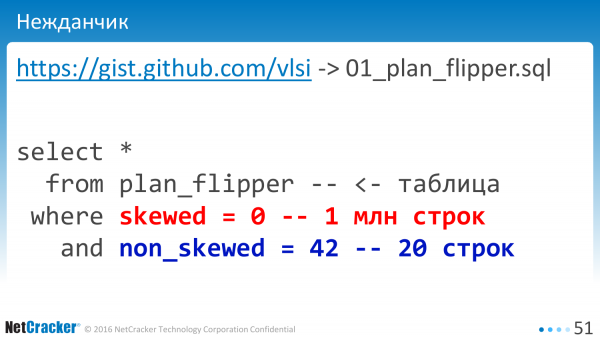
Essensen er, at vi har to kolonner, hver af dem indekseret. I den ene kolonne er der en million rækker med NULL-værdier. Og i den anden kolonne er der kun 20 rækker. Når vi udfører uden sammenkoblede variable, fungerer alt fint.
Hvis vi begynder at udføre med sammenkoblede variable, dvs. når vi bruger tegn «?» eller «$1» til vores forespørgsel, hvad får vi så i sidste ende?
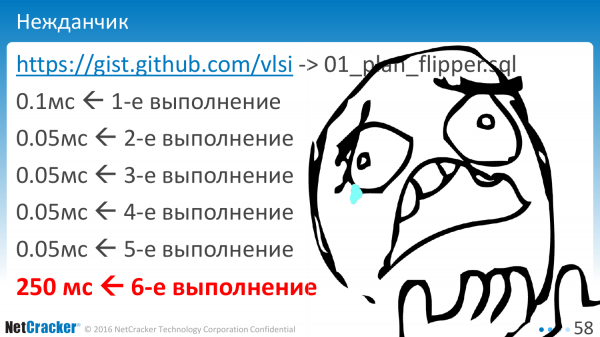
Den første udførelse – som det skal være. Den anden – lidt hurtigere. Noget blev cachet. Den tredje-fjerde-femte. Så bang – og sådan. Og det værste er, at det sker ved den sjette udførelse. Hvem vidste, at man skulle lave præcis seks udførelser for at finde ud af, hvad den egentlige eksekveringsplan var?
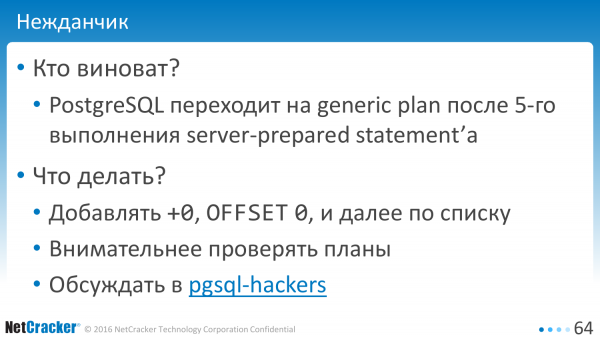
Hvem er skyld i det? Hvad skete der? Databasen indeholder en optimering. Og den er tilsyneladende optimeret til et generisk tilfælde. Og derfor, fra et bestemt punkt, overgår den til en generisk plan, som desværre kan vise sig at være en anden. Den kan enten være den samme eller en anden. Og der er en tærskelværdi, der fører til en sådan adfærd.
Hvad kan der gøres ved dette? Her er det selvfølgelig mere komplekst at spekulere. Der er en simpel løsning, som vi bruger. Det er +0, OFFSET 0. I er garanteret bekendt med sådanne løsninger. Vi tager bare og tilføjer «+0» i forespørgslen, og så er alt godt. Jeg vil vise det senere.
Og der er også en anden mulighed – at se nærmere på planerne. Udvikleren skal ikke kun skrive forespørgslen, men også sige «explain analyze» 6 gange. Hvis det er 5, så er det ikke tilstrækkeligt.
Og der er også en tredje mulighed – at skrive et brev til pgsql-hackers. Jeg har skrevet, men indtil videre er det ikke klart, om det er en fejl eller en funktion.
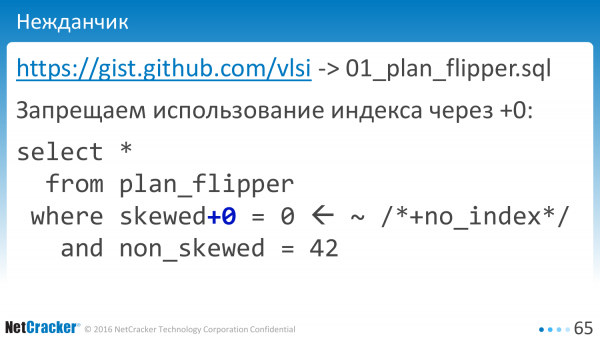
Mens vi tænker over, om det er en fejl eller en funktion, lad os rette det. Vi tager vores forespørgsel og tilføjer «+0». Alt er godt. To tegn, og vi skal ikke engang tænke over, hvordan det er. Meget enkelt. Vi har bare forbudt databasen at bruge indekset for denne kolonne. Vi har ikke noget indeks på kolonnen «+0», og derfor bruger databasen ikke indekset, det hele er i orden.
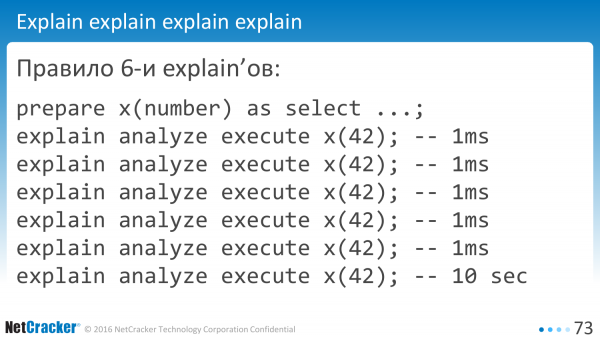
Dette er reglen om 6 explain-ordrer. I de nuværende versioner skal man gøre det 6 gange, hvis man har relaterede variabler. Hvis man ikke har relaterede variabler, så gør vi det på denne måde. Og i sidste ende falder netop denne forespørgsel. Det er ikke kompliceret.
Det kunne man mene, hvor længe kan det tage? Her er en fejl, der er en fejl der. Virkelig, der er fejl overalt.
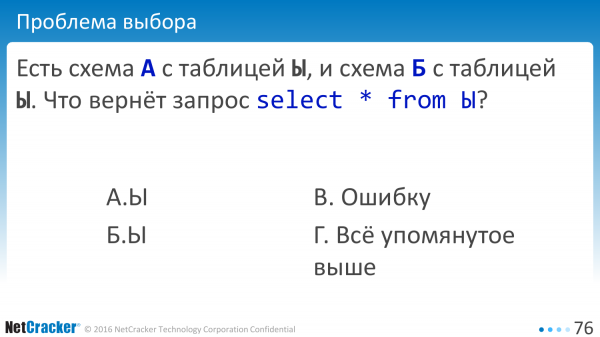
Lad os se nærmere på det. For eksempel har vi to skemaer. Skema A med tabel Y og skema B med tabel Y. Forespørgslen – at vælge data fra tabellen. Hvad vil der ske? Vi vil have en fejl. Vi vil have alt det ovenstående. Reglen er sådan – fejl overalt, vi vil have alt det nævnte.
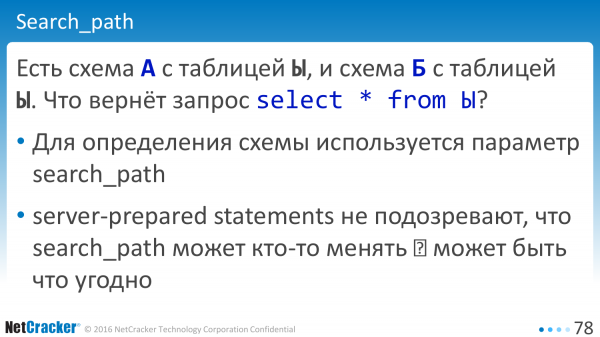
Nu et spørgsmål: «Hvorfor?». Det kunne synes, at der er dokumentation, der siger, at hvis vi har et skema, er der en variabel «search_path», der angiver, hvor tabellen skal søges. Det kunne synes, at variablen er der.
Hvad er problemet? Problemet er, at server-forberedte udsagn ikke har mistanke om, at søgebanen kan ændres af nogen. Denne værdi forbliver som en konstant for databasen. Og nogle dele kan miste de nye værdier.
Selvfølgelig afhænger det af den version, du tester. Det afhænger af, hvor meget dine tabeller adskiller sig. Og version 9.1 vil blot udføre de gamle forespørgsler. Nyere versioner kan opdage en fejl og sige, at der er en fejl.
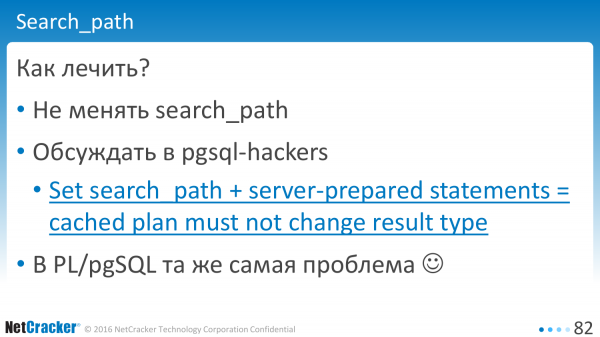
Hvordan løser man dette? Der er en simpel opskrift – gør ikke sådan. Du bør ikke ændre search_path under appens drift. Hvis du ændrer det, er det bedre at oprette en ny forbindelse.
Vi kan diskutere det, dvs. åbne det, diskutere det, tilføje til det. Måske kan vi overbevise databaseudviklerne om, at når nogen ændrer en værdi, skal databasen informere kunden: "Se, din værdi er blevet opdateret. Måske skal du nulstille eller genskabe udsagnene?" I øjeblikket opfører databasen sig skjult og informerer ikke om, at udsagnene er ændret indeni.
Og jeg vil igen understrege – dette er ikke typisk for Java. Vi vil se det samme i PL/pgSQL et til et. Men der vil det blive reproduceret.
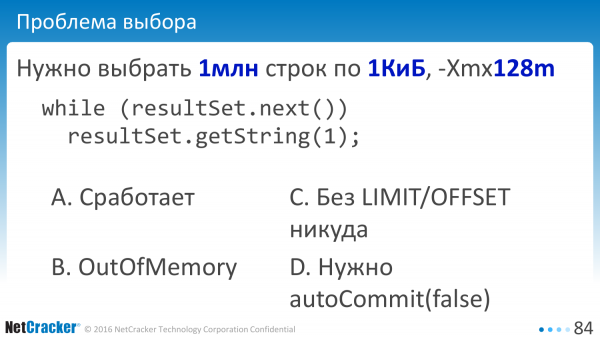
Lad os prøve at vælge data igen. Vi vælger og vælger. Vi har en tabel med en million rækker. Hver række er på en kilobyte. Cirka en gigabyte data. Og vi har en arbejdshukommelse i Java-maskinen på 128 megabyte.
Som anbefalet i alle bøger, bruger vi streamingbehandling. Dvs. vi åbner resultSet og læser derfra data lidt ad gangen. Vil det fungere? Vil der være nedbrud på grund af hukommelse? Vil vi læse lidt ad gangen? Lad os stole på databasen, lad os stole på Postgres. Vi stoler ikke. Vil vi få OutOfMemory? Hvem har oplevet OutOfMemory? Hvem har været i stand til at reparere det efterfølgende?
Hvis du har en million rækker, kan du ikke bare vælge. Du skal absolut bruge OFFSET/LIMIT. Hvem er for denne mulighed? Og hvem er for at lege med autoCommit?
Her viser det sig, som sædvanligt, at den mest uventede mulighed er den rigtige. Og hvis du slukker for autoCommit, vil det hjælpe. Hvorfor? Videnskaben ved ikke noget om det.
Men som standard vælger alle klienter, der forbinder til Postgres-databasen, data i sin helhed. PgJDBC er ikke en undtagelse i denne henseende, den vælger alle rækker.
Der er en variation af FetchSize, dvs. du kan på niveauet for et enkelt udsagn sige, at du gerne vil vælge data i portioner af 10, 50. Men det fungerer ikke, før du slukker for autoCommit. Når du slukker for autoCommit, begynder det at fungere.
Men at gå igennem koden og sætte setFetchSize overalt – det er ikke praktisk. Derfor har vi lavet en indstilling, som angiver standardværdien for hele forbindelsen.
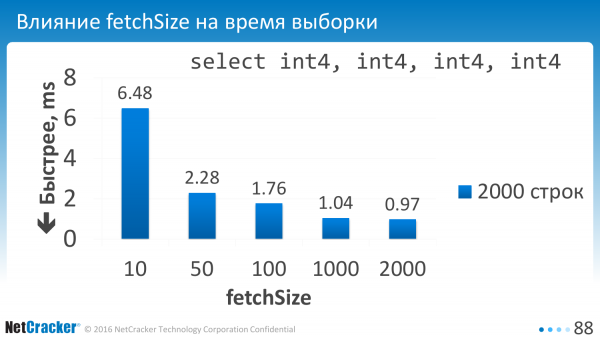
Her har vi sagt det. Vi har indstillet parameteren. Og hvad er resultatet? Hvis vi vælger lidt, f.eks. 10 rækker, så er der ganske store overhead omkostninger. Derfor skal denne værdi sættes til cirka hundrede.
Ideelt set skulle man selvfølgelig også lære at begrænse i bytes, men opskriften er sådan: sæt defaultRowFetchSize over hundrede og vær tilfreds.
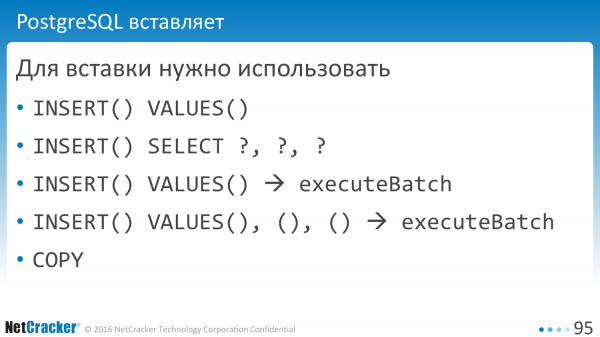
Lad os gå videre til indsættelse af data. Indsættelse er lettere, der er forskellige muligheder. For eksempel, INSERT, VALUES. Det er en god mulighed. Man kan også sige "INSERT SELECT". I praksis er det det samme. Der er ingen forskel i ydeevnen.
Bøger siger, at vi skal udføre batch statements, bøger siger, at man kan udføre mere komplekse kommandoer med flere parenteser. Og i Postgres er der en fantastisk funktion – man kan gøre COPY, dvs. gøre det hurtigere.

Hvis man måler, kan man igen lave flere interessante opdagelser. Hvordan vil vi have, at det fungerer? Vi ønsker ikke at parse og udføre unødvendige kommandoer.
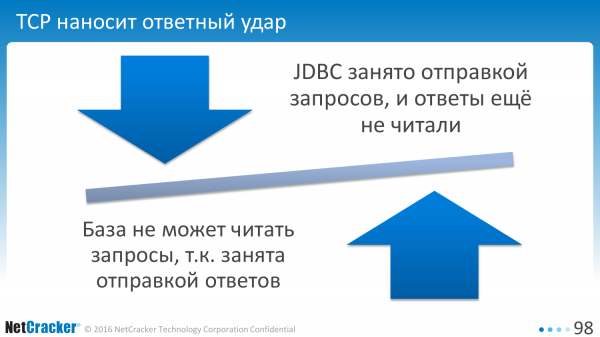
I praksis tillader TCP os ikke at gøre sådan. Hvis klienten er optaget af at sende en anmodning, læser databasen ikke anmodningerne i sine forsøg på at sende os svarene. Til sidst venter klienten på databasen, indtil den læser anmodningen, og databasen venter på klienten, indtil han læser svaret.
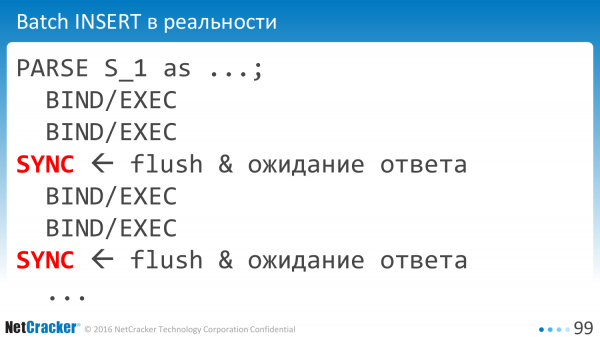
Og derfor er klienten nødt til at sende et synkroniseringspakke periodevis. Unødvendige netværk interaktioner, unødvendigt tidstab.
 Og jo flere vi tilføjer, desto værre bliver det. Driveren er meget pessimistisk og tilføjer dem ret ofte, cirka hver 200. række, afhængigt af størrelsen på rækkerne osv.
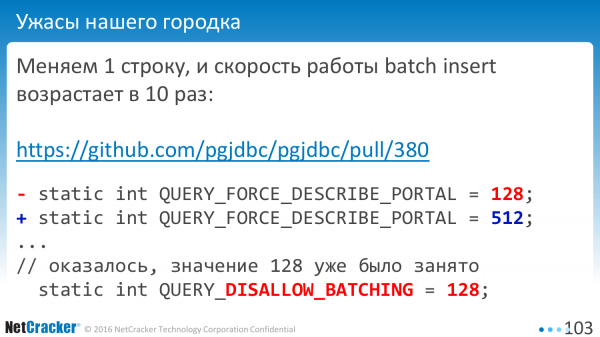
Nogle gange kan det være, at du kun retter en enkelt række, og så accelererer alt ti gange. Det sker. Hvorfor? Som sædvanlig er en konstant allerede blevet brugt et sted. Og værdien "128" var ment til – ikke at bruge batching.
Det er godt, at dette ikke kom med i den officielle version. Vi opdagede det, før vi begyndte at udgive en version. Alle de værdier, jeg nævner, er baseret på moderne versioner.
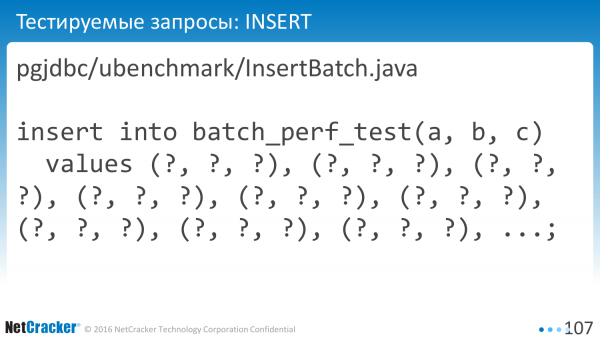
Lad os måle. Vi måler InsertBatch simpelt. Vi måler InsertBatch flere gange, dvs. det samme, men med mange values. En smart metode. Ikke alle kan gøre det, men det er en simpel metode, meget lettere end COPY.
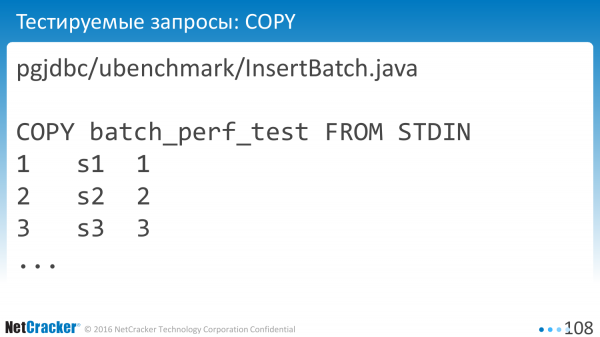
Man kan gøre COPY.
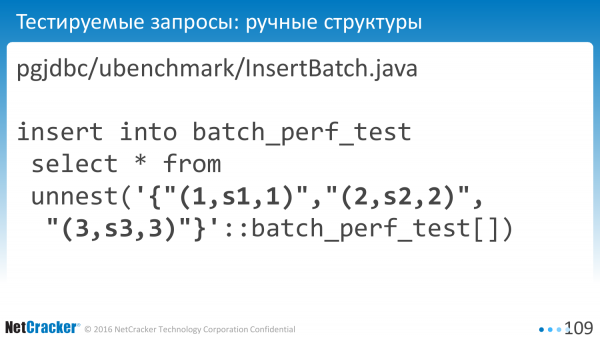
Og man kan gøre dette med strukturer. Deklarér User default type, overfør et array og INSERT direkte ind i tabellen.
Hvis du åbner linket: pgjdbc/ubenchmsrk/InsertBatch.java, så er denne kode tilgængelig på GitHub. Du kan se præcist, hvilke forespørgsler der genereres der. Det er ikke så vigtigt.
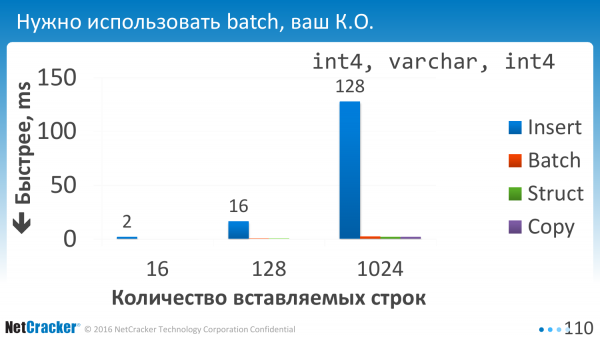
Vi har kørt den. Og det første, vi indså, var, at det er simpelthen umuligt ikke at bruge batch. Alle batching-varianter er lig med nul, dvs. udførelsestiden er næsten nul sammenlignet med en enkelt udførelse.
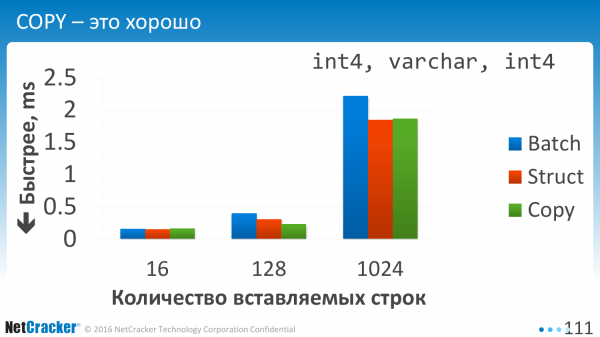
Vi indsætter data. Det er en temmelig simpel tabel. Tre kolonner. Og hvad ser vi her? Vi ser, at alle disse tre varianter er nogenlunde sammenlignelige. Og COPY er selvfølgelig bedst.
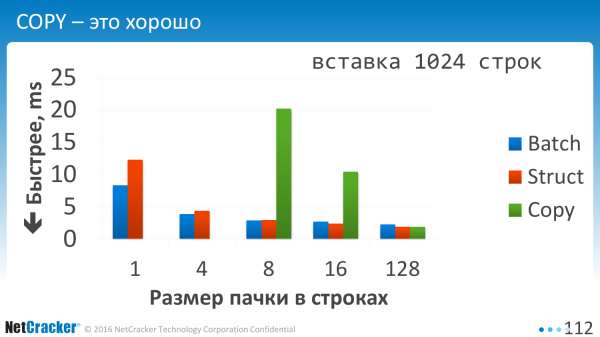
Det er, når vi indsætter data i portioner. Når vi sagde, at vi har ét værdien VALUES, to værdier VALUES, tre værdier VALUES, eller vi nævnte dem 10 adskilt af komma. Dette er præcist nu på tværs. 1, 2, 4, 128. Det er tydeligt, at batchindsættelse, som er tegnet med blåt, har det meget lettere. Dvs. når du indsætter én for én eller endda når du indsætter fire, så bliver det dobbelt så godt, bare fordi vi har fyldt lidt mere ind i VALUES. Færre EXECUTE-operationer.
At bruge COPY til små mængder er ekstremt uheldigt. Jeg tegnede ikke engang de første to. De går op i himlen, dvs. de grønne tal for COPY.
COPY skal bruges, når dit datasæt er større end hundrede rækker. Overheadet ved at åbne denne forbindelse er stort. Og for at være ærlig, har jeg ikke dykket ned i denne retning. Jeg har optimeret batching, men ikke COPY.
Hvad gør vi næste? Vi måler. Vi forstår, at vi skal bruge enten strukturer eller en smart batch, der samler flere værdier.
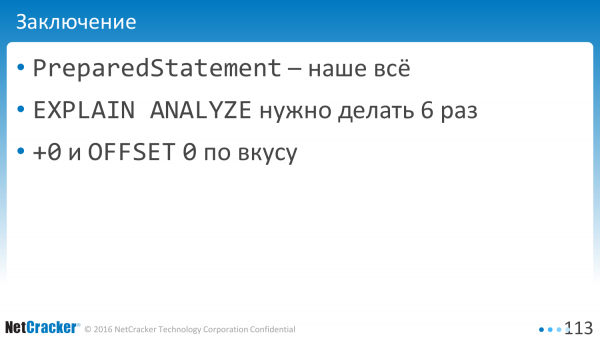
Hvad skal man tage med fra dagens rapport?
- PreparedStatement er alt for os. Det giver meget for ydeevnen. Det medfører en stor dunk af tjære.
- Og vi skal lave EXPLAIN ANALYZE 6 gange.
- Og vi skal blande OFFSET 0, og tricks som +0 for at justere den resterende procent af vores problematiske forespørgsler.
Kilde: habr.com
