

Introduktion
Da vi implementerede et nyt system, stødte vi på behovet for at håndtere en stor mængde forskellige logs. Som værktøj valgte vi ELK. Denne artikel handler om vores erfaringer med at konfigurere denne stak.
Vi har ikke til hensigt at beskrive alle dens muligheder, men ønsker at fokusere specifikt på løsningen af praktiske opgaver. Dette skyldes, at selvom der er en betragtelig mængde dokumentation og allerede færdige billeder, er der mange faldgruber, som vi har opdaget.
Vi deployerede stakken via docker-compose. Desuden havde vi en godt skrevet docker-compose.yml, som gjorde det muligt for os at opsætte stakken uden problemer. Vi troede, at sejren allerede var tæt på, nu skulle vi bare tilpasse det lidt til vores behov, og så var vi i mål.
Desværre var vores forsøg på at tilpasse systemet til at modtage og behandle logs fra vores applikation ikke umiddelbart en succes. Derfor besluttede vi at undersøge hver komponent separat, inden vi genbesøger deres forbindelser.
Så vi startede med logstash.
Miljø, deployment, kørsel af Logstash i en container
Vi bruger docker-compose til deployment, og eksperimenterne her blev gennemført på MacOS og Ubuntu 18.04.
Den logstash-billede, vi har defineret i vores oprindelige docker-compose.yml, er docker.elastic.co/logstash/logstash:6.3.2
Det vil vi bruge til vores eksperimenter.
For at starte logstash skrev vi en separat docker-compose.yml. Man kunne selvfølgelig starte billedet fra kommandolinjen, men vi havde jo en specifik opgave, hvor alt blev startet fra docker-compose.
Kort om konfigurationsfilerne
Som beskrevet kan logstash køre enten for en enkelt kanal, i hvilket tilfælde den skal have en *.conf fil, eller for flere kanaler, i hvilket tilfælde den skal have en pipelines.yml fil, som henviser til .conf filer for hver kanal.
Vi valgte den anden vej. Den syntes mere universel og skalerbar. Derfor oprettede vi pipelines.yml og lavede et bibliotek kaldet pipelines, hvor vi vil placere .conf filerne for hver kanal.
Inde i containeren er der også en anden konfigurationsfil — logstash.yml. Den rører vi ikke, vi bruger den som den er.
Så strukturen af vores kataloger:
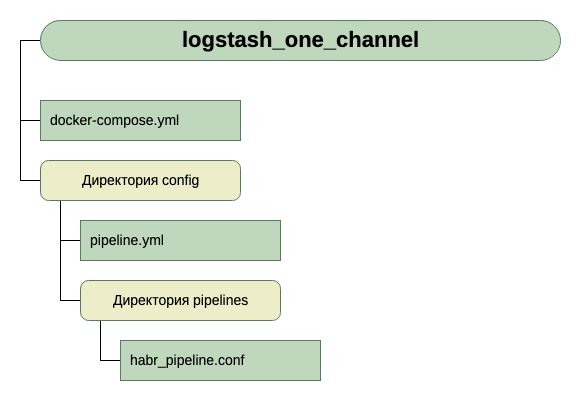
For at modtage inddata antager vi i øjeblikket, at det er tcp på port 5046, og til output vil vi bruge stdout.
Her er en simpel konfiguration til førstegangsopstart. For det er det primære mål at komme i gang.
Så vi har følgende docker-compose.yml
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      	- elk
    ports:
      	- 5046:5046
    volumes:
      	- ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
	- ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Hvad ser vi her?
- Networks og volumes er taget fra den oprindelige docker-compose.yml (den hvor hele stakken startes), og jeg tror ikke, de har en stor indvirkning på det samlede billede.
- Vi opretter en service (services) logstash, fra billedet docker.elastic.co/logstash/logstash:6.3.2 og navngiver den logstash_one_channel.
- Vi videresender port 5046 til den samme interne port i containeren.
- Vi mappede vores konfigurationsfil ./config/pipelines.yml til filen /usr/share/logstash/config/pipelines.yml i containeren, så logstash kan hente den, og vi gør den skrivebeskyttet, bare for en sikkerheds skyld.
- Vi mapper mappen ./config/pipelines, hvor vi har filer med kanalindstillinger, til mappen /usr/share/logstash/config/pipelines og gør også denne skrivebeskyttet.
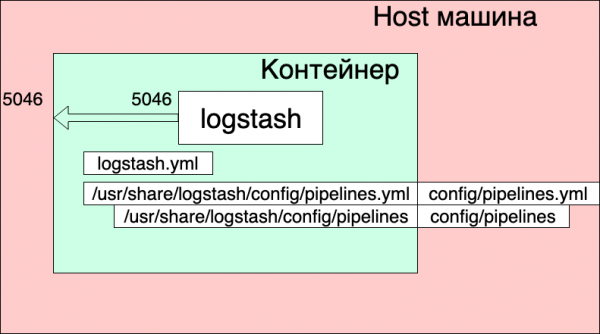
Filen pipelines.yml
- pipeline.id: HABR
  pipeline.workers: 1
  pipeline.batch.size: 1
  path.config: "./config/pipelines/habr_pipeline.conf"
Her beskrives en kanal med identifikatoren HABR og stien til dens konfigurationsfil.
Og endelig filen "./config/pipelines/habr_pipeline.conf"
input {
  tcp {
    port => "5046"
   }
  }
filter {
  mutate {
    add_field => [ "habra_field", "Hello Habr" ]
    }
  }
output {
  stdout {

    }
  }
Lad os ikke gå i dybden med dens beskrivelse endnu, lad os prøve at starte den:
docker-compose up
Hvad ser vi?
Containeren er startet. Vi kan tjekke, om den fungerer:
echo '13123123123123123123123213123213' | nc localhost 5046
Og vi ser svaret i containerens console:
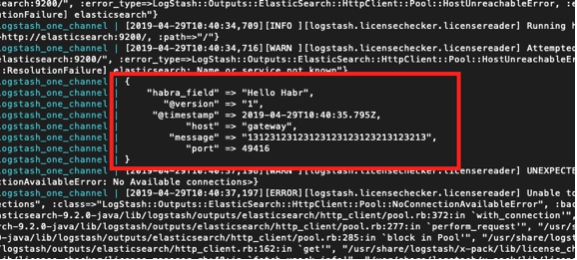
Men samtidig ser vi også:
logstash_one_channel | [2019-04-29T11:28:59,790][ERROR][logstash.licensechecker.licensereader] Kunne ikke hente licensoplysninger fra licensserveren {:message=>"Elasticsearch Uopnåelig: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch", …
logstash_one_channel | [2019-04-29T11:28:59,894][INFO ][logstash.pipeline ] Pipeline startet succesfuldt {:pipeline_id=>".monitoring-logstash", :thread=>"#"}
logstash_one_channel | [2019-04-29T11:28:59,988][INFO ][logstash.agent ] Pipelines kører {:count=>2, :running_pipelines=>[:HABR, :".monitoring-logstash"], :non_running_pipelines=>[]}
logstash_one_channel | [2019-04-29T11:29:00,015][ERROR][logstash.inputs.metrics ] X-Pack er installeret på Logstash, men ikke på Elasticsearch. Installer venligst X-Pack på Elasticsearch for at bruge overvågningsfunktionen. Andre funktioner kan være tilgængelige.
logstash_one_channel | [2019-04-29T11:29:00,526][INFO ][logstash.agent ] Logstash API endpoint startede succesfuldt {:port=>9600}
logstash_one_channel | [2019-04-29T11:29:04,478][INFO ][logstash.outputs.elasticsearch] Kører helbredstjek for at se, om en Elasticsearch-forbindelse fungerer {:healthcheck_url=>http://elasticsearch:9200/, :path=>"/"}
logstash_one_channel | [2019-04-29T11:29:04,487][WARN ][logstash.outputs.elasticsearch] Forsøgte at genoplive forbindelsen til døde ES-instans, men fik en fejl. {:url=>«:9200/», :error_type=>LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=>«Elasticsearch Uopnåelig: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch»}
logstash_one_channel | [2019-04-29T11:29:04,704][INFO ][logstash.licensechecker.licensereader] Kører sundhedstjek for at se, om en Elasticsearch-forbindelse virker {:healthcheck_url=>http://elasticsearch:9200/, :path=>"/"}
logstash_one_channel | [2019-04-29T11:29:04,710][WARN ][logstash.licensechecker.licensereader] Forsøgte at genoplive forbindelsen til døde ES-instans, men fik en fejl. {:url=>«:9200/», :error_type=>LogStash::Outputs::ElasticSearch::HttpClient::Pool::HostUnreachableError, :error=>«Elasticsearch Uopnåelig: [http://elasticsearch:9200/][Manticore::ResolutionFailure] elasticsearch»}
Og vores log stiger hele tiden.
Her har jeg fremhævet med grøn farve meddelelsen om, at pipeline er blevet startet med succes, rød — meddelelsen om en fejl, og gul — meddelelsen om forsøg på at kontakte :9200.
Dette sker, fordi der i logstash.conf, der er inkluderet i billedet, er en kontrol af tilgængeligheden af elasticsearch. Logstash antager, at det fungerer som en del af ELK-stakken, mens vi har adskilt det.
Det kan fungere, men det er ikke praktisk.
Løsningen er at deaktivere denne kontrol ved hjælp af miljøvariablen XPACK_MONITORING_ENABLED.
Vi foretager en ændring i docker-compose.yml og genstarter:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
Nu er alt i orden. Containeren er klar til eksperimenter.
Vi kan igen indtaste i den nærliggende konsol:
echo '13123123123123123123123213123213' | nc localhost 5046
Og se:
logstash_one_channel | {
logstash_one_channel |         "message" => "13123123123123123123123213123213",
logstash_one_channel |      "@timestamp" => 2019-04-29T11:43:44.582Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |            "host" => "gateway",
logstash_one_channel |            "port" => 49418
logstash_one_channel | }
Arbejder inden for én kanal
Så, vi er startet. Nu kan vi bruge tid på at konfigurere logstash direkte. Lad os ikke røre ved filen pipelines.yml for nu, men se hvad vi kan opnå med én kanal.
Det skal siges, at den generelle arbejdsmetode med kanalens konfigurationsfil er godt beskrevet i den officielle vejledning, her er
Hvis du ønsker at læse på dansk, har vi brugt denne (men forespørgselsyntaksen der er gammeldags, dette skal tages i betragtning).
Lad os gå systematisk til værks fra Input-sektionen. Arbejdet med tcp har vi allerede set. Hvad kan der ellers være interessant her?
Testbeskeder ved hjælp af heartbeat
Der er en interessant mulighed for at generere automatiske testbeskeder.
For dette skal pluginet heartbean inkluderes i input-sektionen.
input {
  heartbeat {
    message => "HeartBeat!"
   }
  }
Vi aktiverer det og begynder at modtage hvert minut.
logstash_one_channel | {
logstash_one_channel |      "@timestamp" => 2019-04-29T13:52:04.567Z,
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "HeartBeat!",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "host" => "a0667e5c57ec"
logstash_one_channel | }
Vi ønsker at modtage oftere, vi skal tilføje parameteren interval.
Sådan vil vi modtage beskeder hvert 10. sekund.
input {
  heartbeat {
    message => "HeartBeat!"
    interval => 10
   }
  }
Modtagelse af data fra fil
Vi har også besluttet at se på filtilstanden. Hvis det fungerer fint med filen, er det muligt, at vi slet ikke behøver en agent, i det mindste til lokal brug.
Ifølge beskrivelsen skal arbejdsmetoden være analog med tail -f, det vil sige læse nye linjer eller, som en mulighed, læse hele filen.
Så hvad vil vi opnå:
- Vi ønsker at modtage linjer, der tilføjes til en logfil.
- Vi ønsker at modtage data, der skrives til flere logfiler, samtidig med at vi har mulighed for at adskille, hvad der kommer hvorfra.
- Vi vil gerne kontrollere, at når logstash genstartes, får den ikke disse data igen.
- Vi ønsker at verificere, at hvis logstash deaktiveres, men data fortsætter med at blive skrevet til filerne, så når vi starter den igen, får vi disse data.
For at udføre eksperimentet tilføjer vi endnu en linje i docker-compose.yml ved at åbne den mappe, hvor vi placerer filerne.
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
Og vi ændrer input-sektionen i habr_pipeline.conf
input {
  file {
    path => "/usr/share/logstash/input/*.log"
   }
  }
Vi starter:
docker-compose up
For at oprette og skrive logfiler bruger vi kommandoen:
echo '1' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:53.876Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log"
logstash_one_channel | }
Aha, det virker!
Vi ser, at feltet path automatisk er blevet tilføjet. Det betyder, at vi senere kan filtrere posterne baseret på det.
Lad os prøve igen:
echo '2' >> logs/number1.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:28:59.906Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "2",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log"
logstash_one_channel | }
Og nu til en anden fil:
echo '1' >> logs/number2.log
{
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:29:26.061Z,
logstash_one_channel |        "@version" => "1",
logstash_one_channel |         "message" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number2.log"
logstash_one_channel | }
Perfekt! Filen blev opfanget, path blev korrekt angivet, alt er godt.
Lad os stoppe logstash og starte det igen. Vi venter. Stilhed. Dvs. Vi får ikke disse poster igen.
Og nu til det mest dristige eksperiment.
Vi stopper logstash og udfører:
echo '3' >> logs/number2.log
echo '4' >> logs/number1.log
Vi starter logstash igen og ser:
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "3",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number2.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.589Z
logstash_one_channel | }
logstash_one_channel | {
logstash_one_channel |            "host" => "ac2d4e3ef70f",
logstash_one_channel |     "habra_field" => "Hello Habr",
logstash_one_channel |         "message" => "4",
logstash_one_channel |        "@version" => "1",
logstash_one_channel |            "path" => "/usr/share/logstash/input/number1.log",
logstash_one_channel |      "@timestamp" => 2019-04-29T14:48:50.856Z
logstash_one_channel | }
Hurra! Alt blev opfanget.
Men jeg skal advare om følgende. Hvis containeren med logstash bliver slettet (docker stop logstash_one_channel && docker rm logstash_one_channel), så bliver intet opfanget. Inden i containeren blev positionen for den fil, der blev læst, gemt. Hvis man starter "fra bunden", vil det kun acceptere nye linjer.
Læsning af allerede eksisterende filer
Antag, at vi første gang starter logstash, men vi allerede har logs, og vi ønsker at behandle dem.
Hvis vi starter logstash med den input-sektion, vi brugte før, får vi ingenting. Kun nye linjer vil blive behandlet af logstash.
For at linjerne fra eksisterende filer skal kunne trækkes ind, skal vi tilføje en ekstra linje i input-sektionen:
input {
  file {
    start_position => "beginning"
    path => "/usr/share/logstash/input/*.log"
   }
  }
Der er en nuance; dette gælder kun for nye filer, som logstash endnu ikke har set. For de filer, der allerede har været i logstash's synsfelt, har den allerede gemt deres størrelse og vil derfor kun tage nye optegnelser deri.
Lad os fokusere på input-sektionen. Der er mange flere muligheder derovre, men for vores videre eksperimenter er det tilstrækkeligt for nu.
Routing og datatransformation
Lad os forsøge at løse følgende problem: Vi modtager meddelelser fra en kanal, hvoraf nogle er informationsmeldinger, og andre er fejlinformationer. De adskiller sig med deres tag. Nogle er INFO, og andre er ERROR.
Vi skal adskille dem i output. Dvs. i informationsmeddelelserne sender vi dem til én kanal, mens vi sender fejlinformationerne til en anden.
For dette formål går vi fra input-sektionen til filter og output.
Ved hjælp af filter-sektionen vil vi analysere den indkommende meddelelse, få et hash (nøgle-værdi-par), som vi kan arbejde med, dvs. analysere efter betingelser. Og i output-sektionen vil vi vælge meddelelserne og sende hver enkelt til sin egen kanal.
Analyse af meddelelser ved hjælp af grok
For at analysere tekststrenge og få et sæt felter ud af dem, findes der et special-plugin i filter-sektionen - grok.
Uden at have til hensigt at give en detaljeret beskrivelse heraf (henvises til ), vil jeg give mit simple eksempel.
For dette formål skal vi bestemme formatet for de indgående strenge. De ser sådan ud:
1 INFO message1
2 ERROR message2
Dvs. Identifikatoren er først, derefter INFO/ERROR, og til sidst et ord uden mellemrum.
Ikke svært, men for at forstå princippet er det tilstrækkeligt.
Så i filter-sektionen, i grok-pluginet, skal vi definere et mønster til at analysere vores strenge.
Det vil se sådan ud:
filter {
  grok {
    match => { "message" => ["%{INT:message_id} %{LOGLEVEL:message_type} %{WORD:message_text}"] }
   }
  }
I bund og grund er det et regulært udtryk. Der bruges allerede eksisterende mønstre som INT, LOGLEVEL, WORD. Deres beskrivelse og andre mønstre kan ses her
Nu vil vores streng, når den passerer gennem dette filter, blive til et hash med tre felter: message_id, message_type, message_text.
Disse vil blive vist i output-sektionen.
Routing af meddelelser i output-sektionen med if-kommandoen
I output-sektionen, som vi husker, havde vi til hensigt at opdele meddelelserne i to strømme. De, der er INFO, vil vi vise i konsollen, mens vi sender fejlmeddelelserne til en fil.
Hvordan deler vi disse meddelelser? Opgavens betingelse antyder allerede løsningen — vi har jo et dedikeret felt message_type, der kun kan tage to værdier: INFO og ERROR. Vi vil netop basere vores valg på dette ved hjælp af if-operatoren.
if [message_type] == "ERROR" {
        # Her skriver vi til fil
       } else
     {
      # Her skriver vi til stdout
    }
Du kan se beskrivelsen af arbejdet med felterne og operatorerne i denne sektion .
Nu, om selve outputtet.
Output til konsollen, her er alt klart — stdout {}
Men output til fil — vi husker, at vi kører alt dette fra en container, og for at filen, vi skriver resultatet til, skal være tilgængelig udenfor, er det nødvendigt at åbne denne mappe i docker-compose.yml.
I alt:
Sektionen output i vores fil ser sådan ud:
output {
  if [message_type] == "ERROR" {
    file {
          path => "/usr/share/logstash/output/test.log"
          codec => line { format => "custom format: %{message}"}
         }
    } else
     {stdout {
             }
     }
  }
I docker-compose.yml tilføjer vi endnu en volumen til output:
version: '3'

networks:
  elk:

volumes:
  elasticsearch:
    driver: local

services:

  logstash:
    container_name: logstash_one_channel
    image: docker.elastic.co/logstash/logstash:6.3.2
    networks:
      - elk
    environment:
      XPACK_MONITORING_ENABLED: "false"
    ports:
      - 5046:5046
   volumes:
      - ./config/pipelines.yml:/usr/share/logstash/config/pipelines.yml:ro
      - ./config/pipelines:/usr/share/logstash/config/pipelines:ro
      - ./logs:/usr/share/logstash/input
      - ./output:/usr/share/logstash/output
Vi starter, prøver, og ser opdelingen i to strømme.
Kilde: habr.com
