

Kære læsere, god dag!
Opgaven med at opbygge IT-platforme til indsamling og analyse af data opstår før eller siden for enhver virksomhed, hvis forretningsmodel er baseret på intellektuel servicelevering eller udvikling af teknisk komplekse produkter. At bygge analytiske platforme er en kompleks og tidskrævende opgave. Men enhver opgave kan forenkles. I denne artikel vil jeg dele erfaringer med brugen af low-code-værktøjer, der hjælper med at skabe analytiske løsninger. Denne erfaring er blevet erhvervet gennem implementeringen af en række projekter inden for Big Data Solutions hos NeoFlex. Big Data Solutions hos NeoFlex har siden 2005 arbejdet med opbygning af datalagre og data-søer, optimering af hastigheden af informationsbehandling og udvikling af metodologier til data governance.
Det er umuligt at undgå bevidst opsamling af svagt og/eller stærkt strukturerede data. Måske endda selv for små virksomheder. For når en lovende iværksætter skal skalere sin forretning, vil han eller hun støde på spørgsmål om udvikling af loyalitetsprogrammer, ønsker at analysere effektiviteten af salgssteder, overveje målrettet reklame og bekymre sig om efterspørgslen på supplerende produkter. I første omgang kan opgaven løses ad hoc. Men når virksomheden vokser, bliver det uundgåeligt at gå til en analytisk platform.
Men hvornår kan dataanalytikopgaver udvikle sig til opgaver, der kan karakteriseres som «Rocket Science»? Måske i det øjeblik, hvor der virkelig er tale om store datamængder.
For at forenkle opgaven «Rocket Science» kan man spise elefanten i bidder.
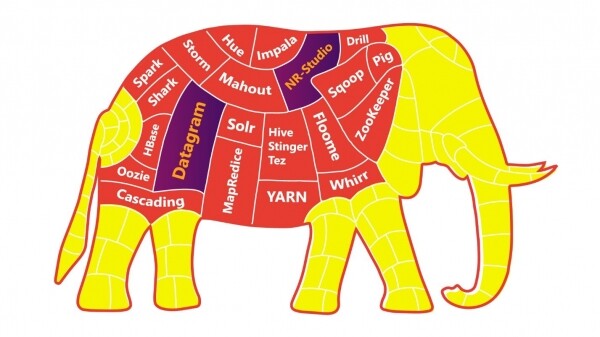
Jo større diskrethed og autonomi dine applikationer/tilbud/mikrotjenester har, desto lettere bliver det for dig, dine kolleger og hele virksomheden at håndtere elefanten.
Denne konklusion har næsten alle vores kunder nået, idet de har omstruktureret landskabet baseret på ingeniørpraksis fra DevOps-teams.
Men selv med en «adskilt, elefant-diæt» har vi stadig gode chancer for «overbelastning» af IT-landskabet. På dette tidspunkt er det værd at stoppe, tage en dyb indånding og se mod low-code engineering platform.
Mange udviklere er bange for udsigten til at ende i en karrieremæssig blindgyde ved at gå væk fra direkte kodning til at "trække" pilene i UI-interface i low-code-systemer. Men introduktionen af maskiner førte ikke til ingeniørernes forsvinden, men løftede deres arbejde til et nyt niveau!
Lad os finde ud af hvorfor.
Analyse af data inden for logistik, telekommunikationsindustrien, medieforskning og finanssektoren er altid forbundet med følgende spørgsmål:
- Hastigheden af automatiseret analyse;
- Muligheden for at udføre eksperimenter uden at påvirke hovedproduktionsstrømmen af data;
- Pålideligheden af de forberedte data;
- Sporing af ændringer og versionering;
- Data provenance, Data lineage, CDC;
- Hurtigheden ved at levere nye funktioner til produktionsmiljøet;
- Og den berygtede: omkostningerne ved udvikling og support.
Det vil sige, at ingeniørerne har et væld af højniveaufunktioner, som kun effektivt kan udføres ved at rense sindet for lave niveau udviklingsopgaver.
Forudsætningerne for udvikleres overgang til et nyt niveau er evolution og digitalisering af forretningen. Værdien af en udvikler ændrer sig også: der er en betydelig mangel på udviklere, der kan forstå essensen af de automatiserede forretningskoncepter.
Lad os lave en analogi mellem lavniveau- og høj-niveau programmeringssprog. Overgangen fra lavniveau-sprog til høj-niveau-sprog er et skifte fra at skrive "direkte direktiver på maskinsproget" til "direktiver på menneskesprog". Det vil sige, at der tilføjes et lag af abstraktion. I så fald er overgangen til low-code-platforme fra høj-niveau programmeringssprog et skifte fra "direktiver på menneskesprog" til "direktiver på forretningssprog". Hvis der er udviklere, der bliver kede af dette faktum, så har de måske været kede af det siden JavaScript kom til verden, hvor array-sorteringsfunktioner bruges. Og disse funktioner har naturligvis en programmatisk implementering bag kulisserne med de samme høj-niveau programmeringsmidler.
Derfor er low-code blot en yderligere form for abstraktion.
Anvendelsesmæssig erfaring med low-code
Low-code-temaen er ganske omfattende, men nu vil jeg gerne tale om anvendelsen af "low-code-koncepter" i et af vores projekter.
Big Data Solutions-afdelingen hos "Neoflex" specialiserer sig primært i den finansielle sektor, hvor de bygger datalagre og dataseer og automatiserer forskellige rapporteringer. I denne niche er brugen af low-code blevet en standard. Blandt andre low-code-værktøjer kan nævnes værktøjer til organisering af ETL-processer: Informatica Power Center, IBM Datastage, Pentaho Data Integration. Eller Oracle Apex, som fungerer som en hurtig udviklingsplatform til adgangs- og dataredigeringsinterfaces. Men anvendelsen af low-code-udviklingsværktøjer er ikke altid forbundet med at bygge specifikke applikationer på en kommerciel teknologistak med en tydelig afhængighed af en leverandør.
Med low-code-platforme kan man også organisere orkestrering af datastreams, skabe data science-platforme eller for eksempel moduler til kvalitetskontrol af data.
Et af de praktiske eksempler på brugen af low-code-udviklingsværktøjer er samarbejdet mellem "Neoflex" og Mediascope, en af de førende aktører på det russiske marked for medieforskning. En af virksomhedens opgaver er produktion af data, på baggrund af hvilke annoncører, onlineplatforme, tv-stationer, radiostationer, reklamebureauer og brands træffer beslutninger om indkøb af reklame og planlægger deres marketingkommunikation.
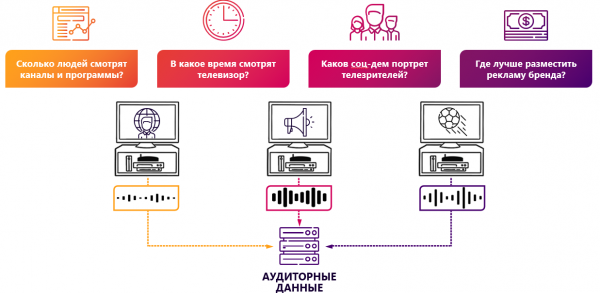
Medieforskning er et teknologisk intensivt område. Genkendelse af videomateriale, indsamling af data fra enheder, der analyserer visning, måling af aktivitet på webressourcer – alt dette kræver, at virksomheden har en stor IT-stab og colossalt erfaring med at bygge analytiske løsninger. Men den eksponentielle vækst i informationsmængden, antallet og mangfoldigheden af dens kilder kræver konstant udvikling af IT-databranchens industri. Den enkleste løsning til at skalere den allerede fungerende analytiske platform Mediascope kunne være at øge IT-staben. Men en langt mere effektiv løsning er at fremskynde udviklingsprocessen. Et af skridtene, der fører i denne retning, kunne være anvendelsen af low-code-platforme.
Ved projektets start havde virksomheden allerede en fungerende produktløsning. Implementeringen af løsningen på MSSQL kunne dog ikke leve op til forventningerne om skalerbarhed af funktionaliteten, samtidig med at omkostningerne til tilpasning skulle være acceptable.
Opgaven foran os var virkelig ambitiøs – «Neoflex» og Mediascope havde til opgave at skabe en industriel løsning på mindre end et år, med det krav at MVP skulle lanceres i løbet af første kvartal fra projektstart.
Som fundament for opbygningen af den nye dataplatform, baseret på low-code beregninger, blev tech-stakken Hadoop valgt. Standarden for datalagring blev HDFS med anvendelse af filformatet parquet. For at få adgang til dataene på platformen blev Hive brugt, hvor alle tilgængelige datavisninger præsenteres som eksterne tabeller. Dataindlæsningen i lageret blev gennemført ved hjælp af Kafka og Apache NiFi.
Low-code værktøjet i dette koncept blev anvendt til at optimere den mest arbejdskrævende opgave i opbygningen af den analytiske platform – databeskrivningsopgaven.
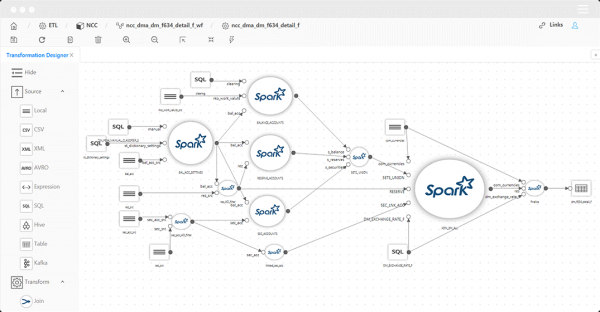
Det primære værktøj til datamapping blev low-code værktøjet Datagram. Neoflex Datagram – er et værktøj til udvikling af transformationer og datastreams.
Ved at anvende dette værktøj kan man undgå at skrive Scala-kode "manuelt". Scala-koden genereres automatisk ved hjælp af Model Driven Architecture-tilgangen.
Den åbenlyse fordel ved denne tilgang er, at udviklingsprocessen fremskyndes. Men udover hastigheden er der også følgende fordele:
- Visning af indholdet og strukturen af kilder/mål;
- Sporing af oprindelsen af objekter i datastreams ned til individuelle felter (lineage);
- Delvis udførelse af transformationer med visning af mellemliggende resultater;
- Visning af kildekoden og dens redigering før udførelse;
- Automatisk validering af transformationer;
- Automatisk indlæsning af data 1 til 1.
Indgangen til low-code-løsninger til generering af transformationer er relativt lav: udvikleren skal have kendskab til SQL og erfaring med ETL-værktøjer. Det skal bemærkes, at code-driven transformation generators ikke er ETL-værktøjer i den brede forstand af ordet. Low-code-værktøjer har muligvis ikke deres eget miljø til kørsel af kode. Det vil sige, at den genererede kode vil blive kørt i det miljø, der allerede eksisterede på klyngen før installationen af low-code-løsningen. Og det er måske endnu en fordel ved low-code. Da der kan arbejde et 'klassisk' team parallelt med low-code-teamet, der implementerer funktionalitet, for eksempel i ren Scala-kode. Integrationen af forbedringer fra begge teams til produktion vil være enkel og 'sømløs'.
Det er sikkert værd at bemærke, at udover low-code er der også no-code løsninger. Og i sin essens er dette forskellige ting. Low-code giver i højere grad udvikleren mulighed for at blande sig i den genererede kode. I tilfældet med Datagram er det muligt at se og redigere den genererede Scala-kode, mens no-code muligvis ikke tilbyder denne mulighed. Denne forskel er betydelig, ikke kun hvad angår løsningen fleksibilitet, men også med hensyn til komfort og motivation i arbejdet for dataingeniører.
Løsningsarkitektur
Lad os forsøge at forstå, hvordan low-code-værktøjet bidrager til at løse opgaven med at optimere hastigheden af udviklingen af databehandlingsfunktionalitet. Først skal vi se på systemets funktionsarkitektur. I dette tilfælde er eksemplet en datamodel til mediaforskning.
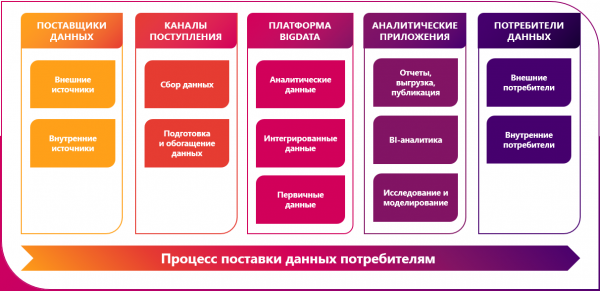
Datakilderne i vores tilfælde er meget forskellige og mangfoldige:
- Peoplemetre (TV-metres) er software- og hardware-enheder, der aflæser brugernes adfærd hos respondenterne i tv-panelet – hvem, hvornår og hvilken tv-kanal der blev set i husholdninger, der deltager i undersøgelsen. De leverede oplysninger er en strøm af seerintervaller knyttet til mediepakken og medieproduktet. Dataene under upload til Data Lake kan beriges med demografiske attributter, geografisk tilknytning, tidszone og andre oplysninger, der er nødvendige for at analysere tv-seing af et bestemt medieprodukt. De indsamlede målinger kan bruges til analyse eller planlægning af reklamekampagner, vurdering af publikums aktiviteter og præferencer, samt til at lave programoversigter;
- Data kan komme fra overvågningssystemer for streaming-tv og måling af visningen af indhold på videoressourcer på internettet;
- Måleinstrumenter i web-miljøet, herunder både site-centric og user-centric tællere. En dataleverandør til Data Lake kan være en browserudvidelse kaldet research bar og en mobilapplikation med indbygget; VPN.
- Data kan også komme fra platforme, der konsoliderer resultaterne af udfyldelse af online-undersøgelser og resultaterne af telefoninterviews i undersøgelsesfirmaerne;
- Yderligere berigelse af datalaget kan finde sted ved at uploade oplysninger fra logs fra partnerfirmaer.
Implementeringen af as is upload fra kildesystemer til primær staging af rådata kan organiseres på forskellige måder. Ved anvendelse af low-code til disse formål er det muligt at generere upload-scripts automatisk baseret på metadata. Her er der ikke behov for at gå ned på niveauet for udvikling af source to target mapping. For at realisere automatisk upload skal vi etablere forbindelse til kilden og derefter specificere i upload-grænsefladen listen over entiteter, der skal uploades. Oprettelse af katalogstrukturen i HDFS vil ske automatisk og vil svare til dataopbevaringsstrukturen i kildesystemet.
Dog har vi i forbindelse med dette projekt besluttet ikke at benytte denne mulighed for low-code-platformen, da virksomheden Mediascope allerede er begyndt at arbejde på at skabe en tilsvarende service med Nifi + Kafka.
Det er vigtigt at understrege, at disse værktøjer ikke er erstatninger for hinanden, men snarere supplerer hinanden. Nifi og Kafka kan arbejde i både direkte (Nifi -> Kafka) og omvendte (Kafka -> Nifi) forbindelser. Den første variant af forbindelsen blev anvendt til medieforskningsplatformen.
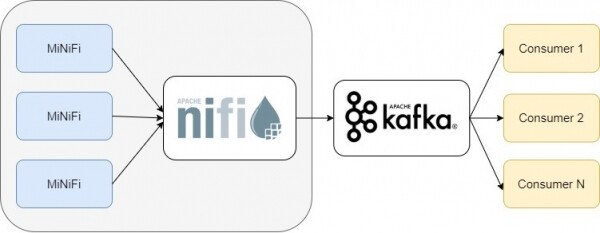
I vores tilfælde var det nødvendigt for Nifi at behandle forskellige datatyper fra kildesystemer og sende dem til Kafka-brokeren. Meddelelsesretningen til et bestemt Kafka-emne blev udført ved hjælp af Nifi-processorerne PublishKafka. Orkestreringen og vedligeholdelsen af disse pipelines udføres i det visuelle interface. Nifi-værktøjet og brugen af kombinationen Nifi + Kafka kan også kaldes en low-code-tilgang til udvikling, som har en lav indgangsbarriere til Big Data-teknologier og fremskynder udviklingsprocessen for applikationer.
Det næste skridt i projektets implementering var at bringe detaljerne til et ensartet semantisk lag. I tilfælde af at entiteten har historiske attributter, udføres beregningen i konteksten af den betragtede partition. Hvis entiteten ikke er historisk, er der valgfrit mulighed for enten at omberegne alt indholdet af objektet eller helt at undlade at omberegne dette objekt (pga. manglende ændringer). På dette stadium genereres nøgler for alle entiteter. Nøglerne gemmes i de relevante master-objekter i Hbase-referencer, som indeholder match mellem nøglerne i den analytiske platform og nøglerne fra kildesystemerne. Konsolideringen af atomære entiteter ledsages af berigelse med resultaterne af den forudgående beregning af de analytiske data. Frameworket til databehandling var Spark. Den beskrevne funktionalitet til at bringe data til ensartet semantik blev også implementeret baseret på mappingene af low-code-værktøjet Datagram.
I den målrettede arkitektur var det nødvendigt at sikre SQL-adgang til dataene for forretningsbrugere. Til denne mulighed blev Hive anvendt. Registreringen af objekter i Hive sker automatisk, når indstillingen "Registr Hive Table" aktiveres i low-code-værktøjet.
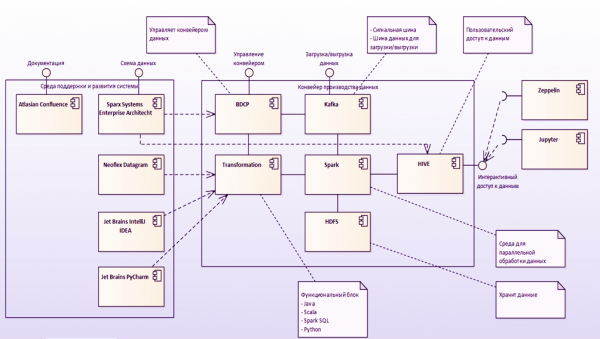
Håndtering af beregningsstrømmen
Datagram har et interface til at bygge workflow-designs. Kørsel af mappinger kan udføres ved hjælp af Oozie-planlæggeren. I udviklerens interface til workflows er det muligt at oprette skemaer for parallelle, sekventielle eller betingede datatransformationsprocesser. Der er support for shell scripts og java-programmer. Det er også muligt at bruge server Apache Livy. Apache Livy bruges til at køre applikationer direkte fra udviklingsmiljøet.
Hvis virksomheden allerede har sin egen procesorkestrator, er det muligt at bruge REST API til at integrere mappinger i den eksisterende strøm. For eksempel har vi haft en ret succesfuld erfaring med at integrere mappinger i Scala i orkestratorer skrevet i PLSQL og Kotlin. REST API til det lavkode-værktøj omfatter operationer som generering af kørsel i henhold til designet for mappingen, kald af mappingen, kald af sekvensen fra mappinger og naturligvis overførsel af URL-parametre til at starte mappingerne.
Sammen med Oozie kan der opstilles en beregningsstrøm ved hjælp af Airflow. Jeg vil ikke bruge alt for lang tid på at sammenligne Oozie og Airflow, men blot sige, at valget i forbindelse med arbejdet i medieforskningsprojektet faldt på Airflow. De vigtigste argumenter var et mere aktivt fællesskab, der udvikler produktet, samt et mere udviklet interface + API.
Airflow er også godt, fordi det bruger det meget elskede Python til at beskrive beregningsprocesser. Generelt er der ikke så mange open source workflow management platforme. Kørsel og overvågning af processer (herunder med Gantt-diagram) tilføjer kun flere points til Airflows karma.
Konfigurationsfilformatet til at køre mappinger i lavkode-løsningen blev spark-submit. Dette skete af to grunde. For det første tillader spark-submit at køre en jar-fil direkte fra konsollen. For det andet kan det indeholde alle nødvendige oplysninger til konfiguration af arbejdsgangen (hvilket gør det lettere at skrive scripts, der danner Dag).
Den hyppigst forekommende komponent i Airflow pipeline i vores tilfælde blev SparkSubmitOperator.
SparkSubmitOperator giver mulighed for at køre jar-filer - pakkede mappinger fra Datagram med foruddefinerede inddata.
Det skal nævnes, at hver Airflow-opgave udføres i en separat tråd og ikke har kendskab til andre opgaver. Derfor foregår interaktionen mellem opgaverne ved hjælp af kontroloperatorer som DummyOperator eller BranchPythonOperator.
Sammenhængen mellem brugen af low-code-løsningen Datagram og universaleringen af konfigurationsfilerne (som danner Dag) har ført til en betydelig forkortelse og forenkling af udviklingsprocessen for dataindlæsningsstrømme.
Beregning af vitrinene
Det mest intellektuelt krævende trin i produktionen af analytiske data er opbygningen af vitrinene. I konteksten af en dataudregningsstrøm i et forskningsfirma sker der på dette trin en tilpasning til den standardiserede oversættelse med hensyntagen til tidszonekorrektion i forhold til udsendelsesnettet. Der kan også være en justering for det lokale udsendelsesnet (lokale nyheder og reklame). Blandt andet udføres der på dette trin en opdeling af intervallerne for kontinuerlig visning af medieprodukter baseret på analyse af visningsintervaller. Her udføres der også en 'vægting' af visningsværdierne baseret på oplysninger om deres betydning (beregning af vægtkoefficienten).
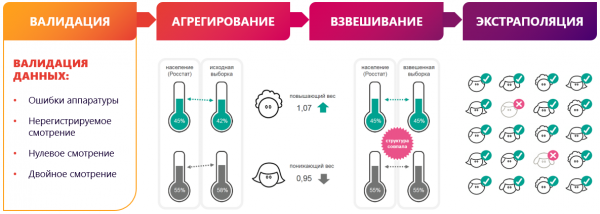
Et særskilt trin i forberedelsen af vitrinene er validering af dataene. Valideringsalgoritmen er knyttet til anvendelsen af en række matematiske science-modeller. Men brugen af en low-code-platform gør det muligt at opdele den komplekse algoritme i en række separate visuelt læselige mappinger. Hver mapping udfører en specifik opgave. Som følge heraf er det muligt med mellemdebugging, logføring og visualisering af datapræparationsstadierne.
Valideringsalgoritmen blev besluttet at blive diskretiseret i følgende deltræk:
- Opbygning af regressioner for visning af tv-netværk i regionen i forhold til visningen af alle netværk i regionen over 60 dage.
- Beregning af studenizerede rester (afvigelsen af de faktiske værdier fra de forudsagte værdier fra regressionsmodellen) for alle regressionspunkter og for den beregnede dag.
- Udvælgelse af anomale par region-tv-netværk, hvor det studenizerede reste for den beregnede dag overstiger normen (fastsat af operationens indstilling).
- Omregningen af den justerede studentiserede saldo for anomale par region-tele netværk for hver respondent, der så nettet i regionen med bestemmelse af denne respondents bidrag (ændringsstørrelse af den studentiserede saldo) ved at udelukke denne respondents visning fra stikprøven.
- Søgning efter kandidater, hvis udelukkelse bringer den studentiserede saldo for beregningsdagen tilbage til normalen.
Det ovenfor nævnte eksempel er en bekræftelse på hypotesen om, at en dataingeniør har alt for meget at tænke på... Og hvis det virkelig er en "ingeniør" og ikke en "koder", så bør frygten for professionel forringelse ved brug af low-code værktøjer endelig forsvinde.
Hvad mere kan low-code?
Anvendelsesområdet for low-code værktøjer til batch- og streambehandling af data uden behov for manuelt at skrive kode i Scala stopper ikke her.
Anvendelsen af low-code i udviklingen af datalakes er allerede blevet en standard for os. Man kan sikkert sige, at løsninger baseret på Hadoop-stakken følger udviklingsvejen for klassiske DWH, baseret på RDBMS. Low-code værktøjer på Hadoop-stakken kan håndtere både databehandlingsopgaver og opgaver vedrørende opbygning af slut-BI-grænseflader. Det skal bemærkes, at BI ikke kun kan forstås som repræsentation af data, men også som redigering udført af forretningsbrugere. Denne funktionalitet anvender vi ofte i opbygningen af analytiske platforme til den finansielle sektor.
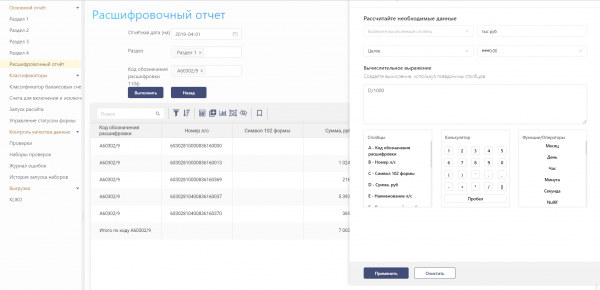
Bland andet kan opgaven med at spore oprindelsen af dataflowobjekter med atomaritet ned til enkelte felter (lineage) løses ved hjælp af low-code og specifikt Datagram. For dette er der implementeret en tilkobling til Apache Atlas og Cloudera Navigator i low-code værktøjet. I bund og grund skal udvikleren registrere et sæt objekter i Atlas' ordbøger og henvise til de registrerede objekter, når der bygges mapping. Mekanismen til at spore datters oprindelse eller analysere afhængigheder mellem objekter sparer en stor mængde tid, når der er behov for at foretage ændringer i beregningsalgoritmerne. For eksempel muliggør denne funktionalitet en mere komfortabel håndtering af ændringer i lovgivningen, når der udarbejdes finansielle rapporter. Jo bedre vi forstår den interformelle afhængighed af detaljerede lagobjekter, desto færre
Datakvalitet & Low-code
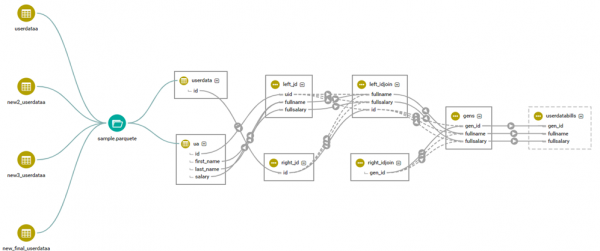
En anden opgave, der blev implementeret med et low-code værktøj i Mediascope's projekt, var Data Quality-klassens opgave. En særlig funktion ved implementeringen af datavalideringsstrømmen for det forskningsfirma-projekt var fraværet af indflydelse på funktionaliteten og hastigheden af de primære databehandlingsstrømme. For muligheden for at orkestrere uafhængige datavalideringsstrømme blev den velkendte Apache Airflow anvendt. I takt med at hvert trin i dataproduktionen var klart, blev en separat del af DQ-strømmen startet parallelt.
Det betragtes som en god praksis at overvåge datakvaliteten fra det øjeblik, de opstår i den analytiske platform. Med oplysninger om metadata kan vi allerede fra første lag af informationen begynde at kontrollere overholdelsen af de grundlæggende betingelser — not null, constraints, foreign keys. Denne funktionalitet er baseret på automatisk genererede mappings af data quality familien i Datagram. I Mediascope-projektet skete tilkoblingen til metadataene fra produktet Enterprise Architect.
Takket være tilkoblingen mellem low-code værktøjet og Enterprise Architect blev følgende kontroller automatisk genereret:
- Kontrol af tilstedeværelsen af "null" værdier i felter med "not null" modifikatoren;
- Kontrol af tilstedeværelsen af dubletter af primærnøglen;
- Kontrol af den eksterne nøgle i entiteten;
- Kontrol af unikke rækker baseret på et sæt felter.
For mere komplekse kontroller af tilgængelighed og validitet af data blev der oprettet en mapping med Scala Expression, der accepterer indgangskode for eksterne Spark SQL-kontroller, forberedt af analytikere i Zeppelin.
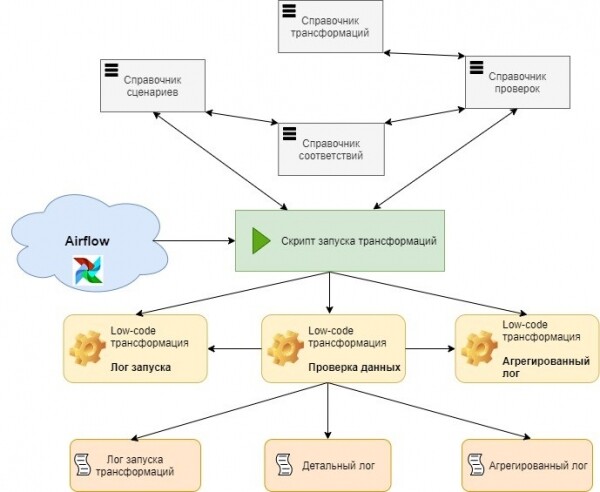
Selvfølgelig skal man gradvist overgå til automatisk generering af kontroller. I forbindelse med det beskrevne projekt gik der følgende trin forud:
- DQ implementeret i Zeppelin-notesbøger;
- DQ indbygget i mapping;
- DQ i form af separate massive mappings, der indeholder et helt sæt kontroller for en enkelt enhed;
- Universelle parametrede DQ-mappings, der accepterer oplysninger om metadata og forretningskontroller.
Måske er den største fordel ved at oprette en tjeneste med parameterede kontroller reduktion af tiden til levering af funktionalitet til produktionsmiljøet. Nye kvalitetskontroller kan omgå den klassiske kodeleveringsmønster gennem udviklings- og testmiljøer:
- Alle metadata kontroller genereres automatisk ved ændringer i model i EA;
- Kontroller af datatilgængelighed (bestemmelse af tilstedeværelsen af nogle data på et givet tidspunkt) kan genereres baseret på et register, der opbevarer den forventede timing for fremkomsten af en ny datamængde efter objekter;
- Forretningskontroller for datavaliditet oprettes af analytikere i Zeppelin-notesbøger. De sendes direkte til konfigurationstabellerne i DQ-modulet i produktionsmiljøet.
Risikoen ved direkte levering af scripts til produktion er ikke-eksisterende. Selv ved syntaksfejl er det maksimalt, hvad vi risikerer, ikke at udføre en kontrol, da dataudregningsstrømmen og kvalitetskontrolstrømmen er adskilt.
I princippet er DQ-tjenesten permanent aktiv i produktionsmiljøet og klar til at begynde sit arbejde ved ankomsten af en ny datamængde.
Afslutning
Fordelen ved at anvende low-code er indlysende. Udviklere behøver ikke at udvikle en applikation "fra bunden". En programmerer, der er frigjort fra ekstra opgaver, leverer resultater hurtigere. Hastigheden frigør i sin tur ekstra tidsressourcer til at løse optimeringsspørgsmål. Derfor kan man forvente en mere kvalitetsrig og hurtigere løsning i dette tilfælde.
Selvfølgelig er low-code ikke en universal løsning, og magien sker ikke af sig selv:
- Low-code-industrien gennemgår en fase med "styrkelse", og indtil videre er der ingen ensartede standarder inden for branchen;
- Mange low-code-løsninger er ikke gratis, og deres anskaffelse bør være et velovervejet skridt, som man bør tage, når man er helt sikker på den økonomiske gevinst ved deres anvendelse;
- Mange low-code-løsninger fungerer ikke altid godt sammen med GIT / SVN. Enten er de besværlige at bruge, hvis den genererede kode er skjult;
- Ved udvidelse af arkitekturen kan der være behov for tilpasning af low-code-løsningen – hvilket i sin tur kan medføre en effekt af "bundethed og afhængighed" af leverandøren af low-code-løsningen.
- Et passende sikkerhedsniveau er muligt, men det er meget arbejdskrævende og komplekst at implementere low-code-systemmotorer. Low-code-platforme bør vælges ikke kun ud fra ønsket om at finde fordele ved deres anvendelse. Ved valg bør man stille spørgsmål ved tilgængeligheden af funktionalitet til adgangsstyring og delegation/eskalering af identifikationsdata på tværs af hele IT-landskabet i organisationen.
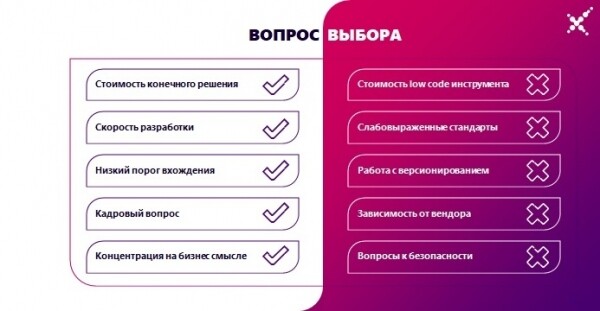
Men hvis alle ulemper ved det valgte system er kendte for dig, og fordelene ved dets brug trods alt er i overvældende flertal, så gå over til low-code uden frygt. Endda mere fordi overgangen er uundgåelig – ligesom enhver evolution.
Hvis én udvikler på en low-code platform kan udføre sit arbejde hurtigere end to udviklere uden low-code, giver det virksomheden en fordel på alle fronter. Indgangsbarrieren for low-code-løsninger er lavere end for 'traditionelle' teknologier, og det påvirker positivt spørgsmålet om mangel på arbejdskraft. Ved brug af low-code værktøjer er det muligt at accelerere samarbejdet mellem funktionelle teams og hurtigere træffe beslutninger om rigtigheden af den valgte retning inden for data science-forskning. Lavniveau platforme kan være årsagen til digital transformation i organisationen, da de løsninger, der produceres, kan være tilgængelige for forståelse af ikke-tekniske specialister (især forretningsbrugere).
Hvis du har stramme tidsfrister, en kompleks forretningslogik, mangel på teknisk ekspertise, og du har brug for at accelerere time to market, så er low-code en måde at imødekomme dine behov på.
Man kan ikke benægte betydningen af traditionelle udviklingsværktøjer, men i mange tilfælde er anvendelsen af low-code løsninger den bedste måde at øge effektiviteten af de opgaver, der skal løses.
Kilde: habr.com
