

Artiklen diskuterer problematikken omkring rydning af billeder, der ophobes i containerregistere (Docker Registry og lignende) i realiteten af moderne CI/CD-pipelines til cloud native-applikationer, der leveres til Kubernetes. Der gives en oversigt over de vigtigste kriterier for relevans af billeder og de følgende vanskeligheder ved automatisering af rydning, pladsering og opfyldelse af teamenes behov. Endelig vil vi på baggrund af et specifikt Open Source-projekt forklare, hvordan man kan overvinde disse vanskeligheder.
Introduktion
Antallet af billeder i containerregistret kan hurtigt vokse, hvilket optager mere plads i lageret og dermed øger omkostningerne betydeligt. For at kontrollere, begrænse eller opretholde en acceptabel vækst af den plads, der bruges i registreret, er det almindeligt at:
- bruge et fast antal tags til billeder;
- rydde billeder på en eller anden måde.
Den første begrænsning er nogle gange acceptabel for små teams. Hvis udviklerne klarer sig med faste tags (latest, main, test, boris og så videre), vil registret ikke vokse i størrelse, og man kan i lang tid slet ikke bekymre sig om rydning. For alle irrelevante billeder overskrives, så der for rydning simpelthen ikke er noget arbejde (alt gøres af den indbyggede affaldscollector).
Alligevel begrænser denne tilgang udviklingen betydeligt og er sjældent anvendelig i moderne CI/CD-oplevelser. En uundgåelig del af udviklingen er automatisering, som gør det muligt at teste, implementere og levere ny funktionalitet til brugerne meget hurtigere. For eksempel oprettes der i alle vores projekter automatisk en CI-pipeline ved hvert commit. Her samles et billede, testes, deployeres til forskellige Kubernetes-miljøer for fejlfinding og resterende checks, og hvis alt går godt, når ændringerne frem til den endelige bruger. Og det er ikke længere raketvidenskab, men en hverdag for mange – sandsynligvis også for dig, siden du læser denne artikel.
Da fejlrettelse og udvikling af ny funktionalitet foregår parallelt, og udgivelser kan finde sted flere gange om dagen, er det åbenlyst, at udviklingsprocessen ledsages af et væsentligt antal commits, og dermed – et stort antal billeder i registreret. Som resultat opstår der et presserende spørgsmål om, hvordan man effektivt organiserer rydning af registreret, dvs. sletning af irrelevante billeder.
Men hvordan bestemmer man overhovedet, om et billede er aktuelt?
Relevanskriterier for billeder
I langt de fleste tilfælde vil de primære kriterier være som følger:
1. Det første (det mest åbenlyse og det mest kritiske af alle) — er billederne, der er i øjeblikket i brug i Kubernetes. Fjernelse af disse billeder kan føre til alvorlige omkostninger på grund af nedetid i produktionen (for eksempel kan billederne være nødvendige ved replikation) eller aflyse bestræbelserne fra teamet, der arbejder med fejlfinding på en af konturerne. (Af denne grund har vi endda lavet en særlig , som overvåger fraværet af sådanne billeder i enhver Kubernetes-klynge.)
2. Det andet (mindre åbenlyse, men også meget vigtige og igen relaterer sig til driften) — er billederne, der er nødvendige for at rulle tilbage i tilfælde af alvorlige problemer i den nuværende version. For eksempel, i tilfælde af Helm er det billederne, der anvendes i de gemte versioner af udgivelsen. (Desuden, som standard i Helm er der en grænse på 256 revisioner, men sjældent vil nogen virkelig have brug for at bevare sådan et stort antal versioner?..) For netop det formål gemmer vi versioner, så de kan bruges senere, dvs. at "rulle tilbage" til dem ved behov.
3. Det tredje — udviklernes behov: alle billeder, der relaterer sig til deres aktuelle arbejde. For eksempel, hvis vi betragter en PR, giver det mening at beholde det billede, der svarer til den seneste commit samt den forrige commit: således kan udvikleren hurtigt vende tilbage til enhver opgave og arbejde med de seneste ændringer.
4. Det fjerde — billederne, der svarer til versionerne af vores applikation, dvs. er det endelige produkt: v1.0.0, 20.04.01, sierra osv.
NB: De kriterier, der er formuleret her, er baseret på erfaring fra samarbejdet med adskillige udviklingsteams fra forskellige virksomheder. Men selvfølgelig kan disse kriterier variere afhængigt af særegenhederne i udviklingsprocesserne og den anvendte infrastruktur (f.eks. hvis Kubernetes ikke bruges).
Overholdelse af kriterierne og eksisterende løsninger
Populære tjenester med container registry tilbyder som regel deres politikker for oprydning af billeder: i dem kan du definere betingelserne, under hvilke en tag fjernes fra registreringen. Men mulighederne for disse betingelser begrænses af parametre som navne, oprettelsestidspunkt og antal tags*.
* Afhænger af de konkrete implementeringer af container registry. Vi har overvejet mulighederne for følgende løsninger: Azure CR, Docker Hub, ECR, GCR, GitHub Packages, GitLab Container Registry, Harbor Registry, JFrog Artifactory, Quay.io — pr. september 2020.
Denne samling af parametre er helt tilstrækkelig til at opfylde det fjerde kriterium — det vil sige at vælge billeder, der svarer til versioner. Men for alle andre kriterier skal man finde en kompromisløsning (mere streng eller derimod gængs politik) — afhængigt af forventninger og økonomiske muligheder.
For eksempel kan det tredje kriterium — relateret til udviklernes behov — løses ved at organisere processer inden for teamerne: specifik navngivning af billeder, føring af specielle allow lists og interne aftaler. Men i sidste ende skal det stadig automatiseres. Hvis de eksisterende løsninger ikke er tilstrækkelige, er man nødt til at lave noget eget.
Det samme gælder de to første kriterier: de kan ikke opfyldes uden at modtage data fra et eksternt system — det system, hvor applikationer implementeres (i vores tilfælde er det Kubernetes).
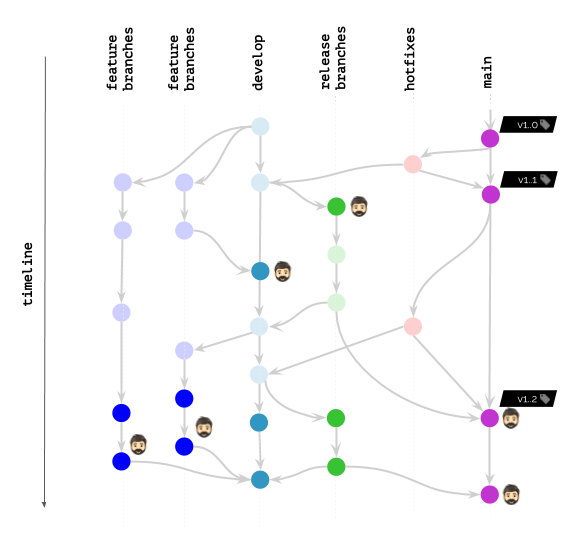
Illustration af workflow i Git
Lad os antage, at du arbejder efter denne skema i Git:
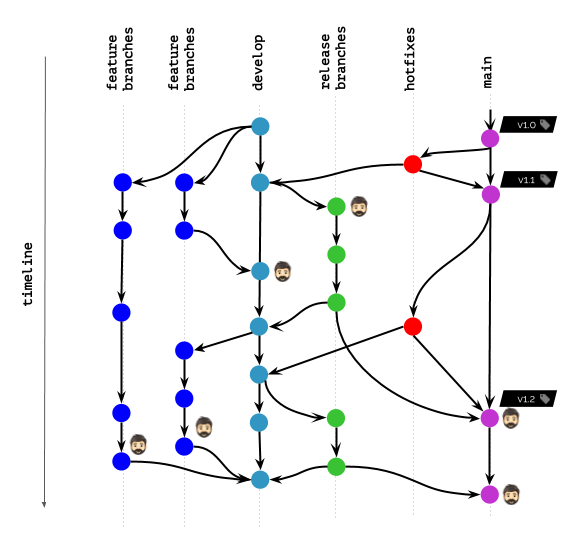
Ikonet med hovedet på skemaet markerer de containerbilleder, der i øjeblikket er implementeret i Kubernetes for nogle brugere (slutbrugere, testere, ledere osv.) eller bruges af udviklere til fejlsøgning og lignende formål.
Hvad sker der, hvis oprydningspolitikkerne tillader at efterlade (ikke slette) billeder kun i henhold til bestemte tag-navne?
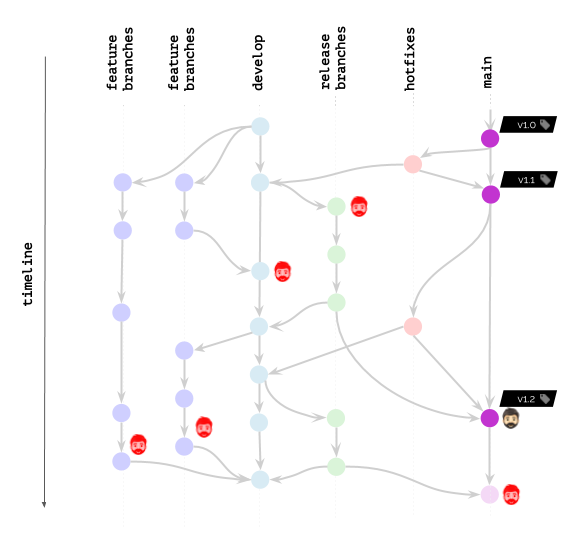
Åbenlyst, vil et sådant scenarie ikke glæde nogen.
Hvad ændrer sig, hvis politikkerne tillader ikke at slette billeder i henhold til et bestemt tidsinterval / antal seneste commits?
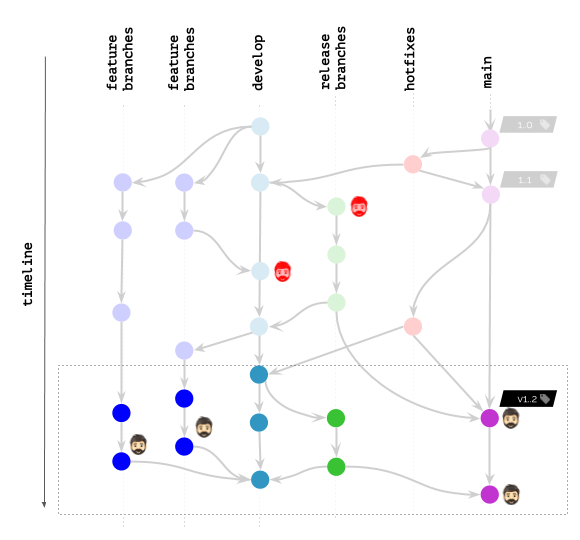
Resultatet er blevet markant bedre, men er stadig langt fra idealt. For vi har stadig udviklere, der har brug for billeder i registry (eller endda implementeret i K8s) til fejlsøgning af fejl…
For at opsummere den nuværende situation på markedet: de tilgængelige funktioner i containerregistrene tilbyder ikke tilstrækkelig fleksibilitet ved oprydning, og den hovedårsag er — manglen på mulighed for at interagere med den eksterne verden.. Det viser sig, at teams, der har brug for sådan fleksibilitet, er nødt til selv at implementere eliminering af billeder "udefra" ved at bruge Docker Registry API (eller det tilsvarende native API).
Men vi har ledt efter en universel løsning, der ville automatisere oprydningen af billeder for forskellige teams, der bruger forskellige registre…
Vores vej til universel oprydning af billeder
Hvorfor er der sådan et behov? Det skyldes, at vi ikke er en enkeltstående gruppe udviklere, men et team, der betjener adskillige sådanne grupper og hjælper med at løse CI/CD-udfordringer. Og det vigtigste tekniske værktøj til dette er en open source-utility. . Dens særligt ved at den ikke udfører en enkelt funktion, men understøtter processerne for kontinuerlig levering på alle trin: fra bygning til deployment.
Publicering af billeder i registre* (umiddelbart efter deres bygning) er en åbenlys funktion af en sådan utility. Og eftersom billederne placeres der for opbevaring, skal man, hvis dit lager ikke er ubegribelig, også stå til ansvar for deres efterfølgende oprydning. Hvordan vi har haft succes med dette, mens vi har opfyldt alle givne kriterier, vil blive beskrevet videre.
* Selvom selve registrene kan være forskellige (Docker Registry, GitLab Container Registry, Harbor osv.), står deres brugere over for de samme problemer. Den universelle løsning i vores tilfælde er uafhængig af registrets implementering, da den udføres uden for selve registrene og tilbyder ensartet adfærd for alle.
Selvom vi bruger werf som et eksempel på implementering, håber vi, at de anvendte metoder vil være nyttige for andre teams, der står over for lignende udfordringer.
Så vi tog fat på den eksterne implementering af mekanismen til oprydning af billeder — i stedet for de muligheder, der allerede er indbygget i registrene for containere. Det første skridt var at bruge Docker Registry API til at oprette de samme primitive politikker for antal tags og deres oprettelsestid (som nævnt ovenfor). Til disse blev der tilføjet en tilladelsesliste baseret på de billeder, der bruges i den udrullede infrastruktur, dvs. Kubernetes. For sidstnævnte var det tilstrækkeligt at iterere gennem alle udrullede ressourcer via Kubernetes API og få en liste over værdier. billede.
Denne trivielle løsning lukkede det mest kritiske problem (kriterium nr. 1), men var kun begyndelsen på vores vej til at forbedre rengøringsmekanismen. Næste - og en langt mere interessant - skridt var at finde en løsning at tilknytte de offentliggjorte billeder til historien i Git.
Tagging-schemer
For at starte valgte vi en tilgang, hvor det endelige billede skulle gemme den nødvendige information til rengøring, og vi opbyggede processen på tagging-schemer. Ved offentliggørelse af billedet valgte brugeren en bestemt tagging-option (git-branch, git-commit eller git-tag) og brugte den tilsvarende værdi. I CI-systemer blev indstillingen af disse værdier udført automatisk baseret på miljøvariabler. Grundlæggende blev det endelige billede knyttet til en bestemt Git-primitiv, der gemte de nødvendige data til rengøring i labels.
Inden for denne tilgang blev der skabt en række politikker, der gjorde det muligt at bruge Git som den eneste sandhedskilde:
- Når en gren/tag blev slettet i Git, blev de tilknyttede billeder i registry automatisk slettet.
- Antallet af billeder knyttet til Git-tags og commits kunne reguleres efter antallet af tags, der blev brugt i den valgte skema, og tidspunktet for oprettelsen af den tilknyttede commit.
Generelt opfyldte den opnåede implementering vores behov, men snart ventede der os en ny udfordring. Faktisk, i løbet af brugen af tagging-schemer baseret på Git-primitiver, stødte vi på en række ulemper. (Da beskrivelsen af dem ligger uden for rammerne af denne artikel, kan alle interesserede finde detaljerne .) Derfor, efter at have besluttet at skifte til en mere effektiv tilgang til tagging (content-based tagging), måtte vi genoverveje implementeringen af billedrensning.
Den nye algoritme
Hvorfor? Ved tagging inden for content-based kan hvert tag dække adskillige commits i Git. Ved rengøring af billeder kan man ikke længere basere kun sig på den commit, hvor det nye tag blev tilføjet til registry.
For den nye algoritme til rengøring blev det besluttet at forlade tagging-schemerne og opbygge processen på meta-billeder, som hver gemmer en kobling af:
- commit, hvor offentliggørelse blev udført (herunder er det ligegyldigt, om billedet er blevet tilføjet, ændret eller forblevet det samme i containerregistryen);
- og vores interne identifikator, der svarer til det samlede billede.
Med andre ord er forbindelsen mellem de publicerede tags og commits i Git blevet sikret. Den endelige konfiguration og den overordnede algoritme.
Brugerne fik adgang til politikker for konfiguration af oprydning, der bestemmer udvalget af aktuelle billeder. Hver sådan politik defineres af:
et sæt af references, dvs. Git-tags eller Git-grene, der anvendes under scanningen;
- og en grænse for antallet af søgte billeder for hver reference fra sættet.
- For at illustrere, her er hvordan konfigurationen af standardpolitikken ser ud:
cleanup: keepPolicies: - references: tag: /.*// limit: last: 10 - references: branch: /.*// limit: last: 10 in: 168h operator: And imagesPerReference: last: 2 in: 168h operator: And - references: branch: /^ (main|staging|production)$ / imagesPerReference: last: 10
Denne konfiguration indeholder tre politikker, som svarer til følgende regler:
Behold et billede for de 10 seneste Git-tags (baseret på tagens oprettelsesdato).
- Behold højst 2 billeder, der er publiceret i den sidste uge, for højst 10 grene med aktivitet i den sidste uge.
- Behold 10 billeder for grenene
- Den endelige algoritme reduceres til følgende trin:
main,stagingogproduction.
Indhentning af manifester fra container registry.
- Udelukkelse af billeder, der bruges i Kubernetes, da disse allerede er blevet udvalgt ved at forespørge K8s API.
- Scanning af Git-historik og udelukkelse af billeder i henhold til de fastsatte politikker.
- Sletning af de resterende billeder.
- Når vi vender tilbage til vores illustration, ser det sådan ud med werf:
Men selvom du ikke bruger werf, kan en lignende tilgang til avanceret oprydning af billeder anvendes — i en hvilken som helst implementering (i overensstemmelse med din foretrukne tilgang til tagging af billeder) — også i andre systemer/værktøjer. Det kræver blot at huske på de problemer, der opstår, og finde de muligheder i din stak, som muliggør en glat integration af deres løsning. Vi håber, at den vej, vi har taget, kan hjælpe dig med at se dit specifikke tilfælde med nye detaljer og perspektiver.
Tid eller senere støder de fleste teams på problemer med overbelægning i registreringen.
Konklusion
- Når du søger efter løsninger er det vigtigt først at definere kriterierne for relevans af billedet.
- Når man søger efter løsninger, er det vigtigt først at fastslå relevanskriterierne for billedet.
- Værktøjerne, der tilbydes af populære container registry-tjenester, muliggør en meget enkel oprydning, som ikke tager højde for den "ydre verden": billeder, der bruges i Kubernetes, og teamets arbejdsgange.
- En fleksibel og effektiv algoritme skal have en forståelse for CI/CD-processer og operere ikke kun med data fra Docker-billeder.
P.S.
Læs også på vores blog:
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
