

Bem. oversættelse: Dette er en oversættelse af et offentligt post-mortem fra virksomhedens ingeniørblog. . Den beskriver et problem med conntrack i Kubernetes-klyngen, som førte til delvis nedetid for visse produktionsservices.
Denne artikel kan være nyttig for dem, der ønsker at vide lidt mere om post-mortems eller forhindre visse potentielle problemer med DNS i fremtiden.
Det er ikke DNS
Det kan ikke være, at det er DNS
Det var DNS
Lidt om post-mortems og processerne i Preply
Post-mortem beskriver et svigt i driften eller en hændelse i produktionen. Post-mortem inkluderer en tidslinje over hændelser, påvirkningen på brugeren, årsagen, handlingerne og de lærte lektioner.
Ved de ugentlige møder med pizza, i kredsen af det tekniske team, deler vi forskellige oplysninger. En af de vigtigste dele af sådanne møder er post-mortems, som ofte ledsages af præsentation med dias og en dybere analyse af den hændelse, der er sket. Selvom vi ikke "klapper" efter post-mortems, forsøger vi at udvikle en "blameless" kultur (). Vi tror på, at skrivning og præsentation af post-mortems kan hjælpe os (og ikke kun os) med at forhindre lignende hændelser i fremtiden, derfor deler vi dem.
Personer involveret i hændelsen skal føle, at de kan fortælle om den i detaljer, uden at frygte for straf eller gengældelse. Ingen bebrejdelse! At skrive et post-mortem er ikke en straf, men en læringsmulighed for hele virksomheden.
DNS-problemer i Kubernetes. Post-mortem
Dato: 28.02.2020
Forfattere: Amet U., Andrey S., Igor K., Alexey P.
Status: Afsluttet
Kort sagt: Delvis utilgængelighed af DNS (26 min) for nogle tjenester i Kubernetes-klyngen
Påvirkning: 15000 begivenheder mistet for tjenesterne A, B og C
Årsag: Kube-proxy kunne ikke korrekt fjerne den gamle post fra conntrack-tabellen, så nogle tjenester forsøgte stadig at oprette forbindelse til ikke-eksisterende pods.
E0228 20:13:53.795782 1 proxier.go:610] Failed to delete kube-system/kube-dns:dns endpoint connections, error: error deleting conntrack entries for UDP peer {100.64.0.10, 100.110.33.231}, error: conntrack command returned: ...Trigger: På grund af den lave belastning i Kubernetes-klyngen reducerede CoreDNS-autoscaler antallet af pods i deployment fra tre til to.
Løsning: En ny deployment af applikationen har initieret oprettelsen af nye noder, og CoreDNS-autoscaler har tilføjet flere pods til at betjene clusteret, hvilket har forårsaget en overskrivning af conntrack-tabellen.
Opdagelse: Prometheus overvågning har opdaget et stort antal 5xx fejl for tjenesterne A, B og C og har triggeret et opkald til de vagthavende ingeniører.
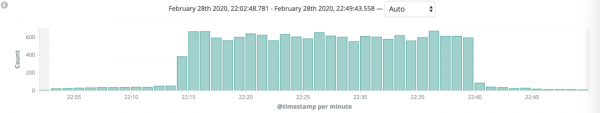
5xx fejl i Kibana
Handlinger
Handling
Type
Ansvarlig
Regler for godkendelse af merge-requests
Deaktiver autoscaler for CoreDNS
forebyg.
Amet U.
DEVOPS-695
Installér en cache DNS-server
reducer.
Max V.
DEVOPS-665
Konfigurer conntrack overvågning
forebyg.
Amet U.
DEVOPS-674
Lærte lektioner
Hvad gik godt:
- Overvågningen fungerede klart. Reaktionen var hurtig og organiseret.
- Vi nåede ikke nogen grænser på noderne.
Hvad gik galt:
- Den reelle årsag er stadig ukendt, ligner i conntrack.
- Alle handlinger retter kun konsekvenserne, ikke årsagen (bug).
- Vi vidste, at vi før eller senere kunne få problemer med DNS, men prioriterede ikke opgaverne.
Hvor vi var heldige:
- En ny deployment triggerede CoreDNS-autoscaleren, som overskrev conntrack-tabellen.
- Denne bug påvirkede kun en del af tjenesterne.
Tidslinje (EET)
Tid
Handling
22:13
CoreDNS-autoscaleren reducerede antallet af pods fra tre til to.
22:18
De vagthavende ingeniører begyndte at modtage opkald fra overvågningssystemet.
22:21
De vagthavende ingeniører begyndte at undersøge årsagen til fejlene.
22:39
De vagthavende ingeniører begyndte at rulle en af de seneste tjenester tilbage til den tidligere version.
22:40
5xx fejlene stoppede med at dukke op, situationen stabiliserede sig.
- Tid til opdagelse: 4 min
- Tid til handling: 21 min
- Tid til reparation: 1 min
Yderligere oplysninger
- CoreDNS logs:
I0228 20:13:53.507780 1 event.go:221] Event(v1.ObjectReference{Kind:"Deployment", Namespace:"kube-system", Name:"coredns", UID:"2493eb55-3dc0-11ea-b3a2-02bb48f8c230", APIVersion:"apps/v1", ResourceVersion:"132690686", FieldPath:""}): type: 'Normal' reason: 'ScalingReplicaSet' Skalerede replica sættet coredns-6cbb6646c9 ned til 2. - Links til Kibana (redigeret), Grafana (redigeret)
For at minimere CPU-brugen bruger Linux-kernen en funktion kaldet conntrack. Kort sagt er det et værktøj, der indeholder en liste over NAT-poster, som opbevares i en speciel tabel. Når den næste pakke kommer fra den samme pod til den samme pod som før, vil den endelige IP-adresse ikke blive beregnet igen, men hentes fra conntrack-tabellen.
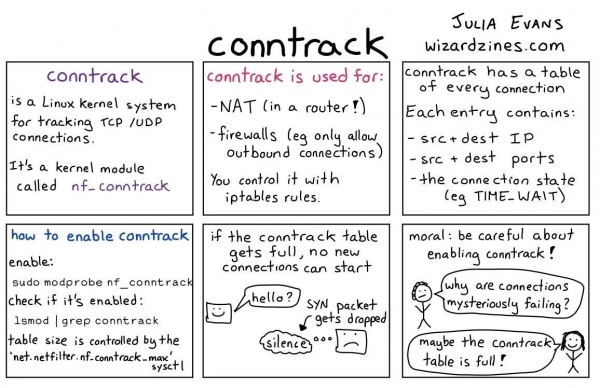
Hvordan conntrack fungerer
Resumé
Dette var et eksempel på et af vores postmortems med nogle nyttige links. I denne artikel deler vi oplysninger, der kan være nyttige for andre virksomheder. Derfor er vi ikke bange for at begå fejl, og derfor har vi gjort et af vores postmortems offentligt. Her er endnu et par interessante offentlige postmortems:
- GitLab:
- Dropbox:
- Spotify:
- Mange andre fra og repository
- Derudover offentligt postmortem med SRE Book
Kilde: habr.com
