

I dag skal vi tale om, hvordan vi bedst opbevarer data i en verden, hvor 5G-netværk, genomscannere og selvkørende biler genererer mere data på en dag, end hele menneskeheden har genereret siden den industrielle revolution.
Verden genererer stadig mere information. En del af den er flygtig og går tabt lige så hurtigt, som den samles. Andet skal opbevares i længere tid, og noget er endda designet til at vare "i århundreder" – i det mindste som vi ser det nu. Informationsstrømme akkumuleres i datacentre med en hastighed, der gør, at enhver ny tilgang, enhver teknologi, der skal imødekomme denne uendelige "efterspørgsel", hurtigt bliver forældet.
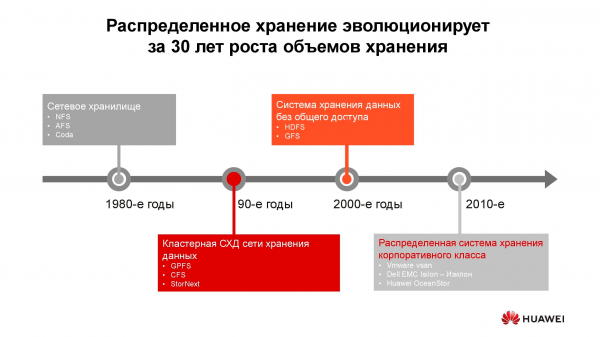
40 års udvikling af distribuerede Lagringssystemer
De første netværkslagre i den form, vi kender, dukkede op i 1980'erne. Mange af jer har stødt på NFS (Network File System), AFS (Andrew File System) eller Coda. Ti år senere ændrede mode og teknologi sig, og distribuerede filsystemer blev erstattet af klynge-Lagringssystemer baseret på GPFS (General Parallel File System), CFS (Clustered File Systems) og StorNext. Der blev brugt bloklagringssystemer af klassisk arkitektur som grundlag, ovenpå hvilke der blev oprettet et ensartet filsystem ved hjælp af et softwarelag. Disse og lignende løsninger anvendes stadig, besætter deres niche og er stadig eftertragtede.
Ved årtusindeskiftet ændrede paradigmet for distribuerede lagersystemer sig noget, og systemer med SN-arkitektur (Shared-Nothing) kom i front. Der skete et skifte fra klyngeopbevaring til opbevaring på separate enheder, som ofte var klassiske servere med software til pålidelig opbevaring; på sådanne principper er HDFS (Hadoop Distributed File System) og GFS (Global File System) opbygget.
Mod 2010'erne blev de koncepter, der ligger til grund for distribuerede lagersystemer, i stigende grad afspejlet i fuldt udviklede kommercielle produkter som VMware vSAN, Dell EMC Isilon og vores . Bag de nævnte platforme står ikke længere et samfund af entusiaster, men specifikke leverandører, der tager ansvar for funktionaliteten, support, service og vedligeholdelse af produktet og sikrer dets fremtidige udvikling. Sådanne løsninger er mest efterspurgte i flere sektorer.
Telekommunikationsoperatører
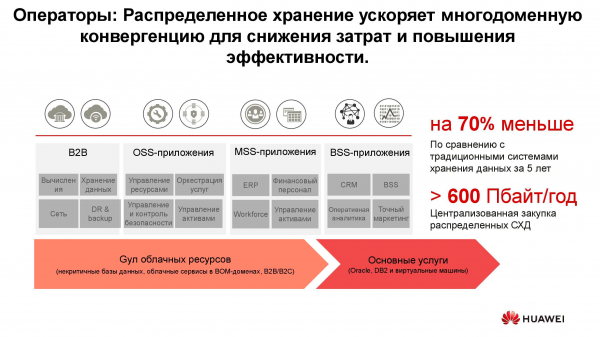
En af de ældste forbrugere af distribuerede lagringssystemer er telekommunikationsoperatører. Diagrammet viser, hvilke grupper af applikationer der genererer hovedparten af dataene. OSS (Operations Support Systems), MSS (Management Support Services) og BSS (Business Support Systems) udgør tre komplementære softwarelag, der er nødvendige for at levere service til abonnenterne, finansiel rapportering til udbyderen og driftsstøtte til operatørens ingeniører.
Ofte er dataene fra disse lag stærkt sammenblandet, og for at undgå ophobning af unødvendige kopier benyttes distribuerede lagre, der akkumulerer al information, der kommer fra det aktive netværk. Lagringssystemerne samles i et fælles pulje, som alle services får adgang til.
Vores beregninger viser, at overgangen fra klassiske lagringssystemer til bloklagring kan spare op til 70% af budgettet ved blot at undgå dedikerede hi-end lagringssystemer og bruge almindelige servere med klassisk arkitektur (normalt x86), der arbejder sammen med specialiseret software. Mobiloperatører har allerede for længe siden begyndt at erhverve sådanne løsninger i betydelige mængder. Især russiske operatører har brugt sådanne produkter fra Huawei i mere end seks år.
Ja, visse opgaver kan ikke udføres med distribuerede systemer. For eksempel ved høje krav til ydeevne eller kompatibilitet med ældre protokoller. Men ikke mindre end 70% af de data, som operatøren behandler, kan helt klart placeres i en distribueret pulje.
Banksektoren
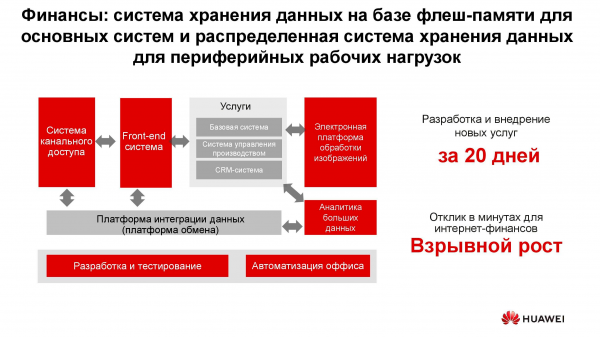
I enhver bank eksisterer mange forskellige IT-systemer, fra processtyring til automatiseret banksystem. Denne infrastruktur arbejder også med enorme mængder information, og en stor del af opgaverne kræver ikke høj ydeevne og pålidelighed i lagringssystemerne, såsom udvikling, testning, automatisering af kontorprocesser osv. Her er brugen af klassiske lagringssystemer mulig, men bliver med årene mindre fordelagtigt. Desuden mangler der fleksibilitet i ressourceforbruget af lagringssystemer, hvis ydeevne beregnes ud fra den maksimale belastning.
Ved brug af distribuerede lagringssystemer kan deres noder, der i princippet er almindelige servere, til enhver tid konverteres, f.eks. til et serverfarm og bruges som en beregningsplatform.
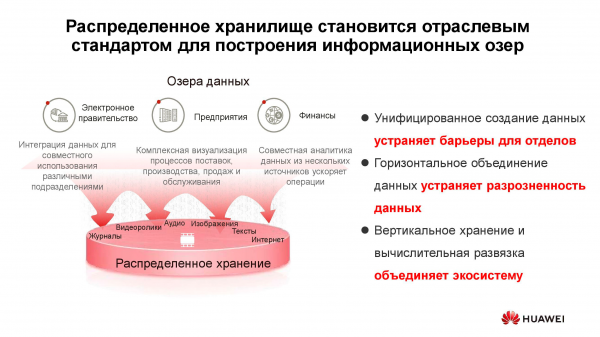
Data søer
Diagrammet ovenfor viser en liste over typiske forbrugere af tjenester . Dette kan være e-forvaltningstjenester (f.eks. "Borger.dk"), som har gennemgået digitalisering, finansielle institutioner m.m. Alle har brug for at arbejde med store mængder heterogen information.
Drift af klassiske lagringssystemer til løsning af sådanne opgaver er ikke effektiv, da der kræves både højtydende adgang til blokdatabaser og almindelig adgang til biblioteker af scannede dokumenter, der opbevares som objekter. Her kan også tilknyttes et bestillingssystem via en webportal. For at implementere alt dette på en klassisk lagringsplatform kræves der et stort sæt udstyr til forskelligartede opgaver. Et enkelt horisontalt universelt lagringssystem kan fint dække alle de førnævnte opgaver: det kræver blot at oprette flere puljer med forskellige lagringskarakteristika.
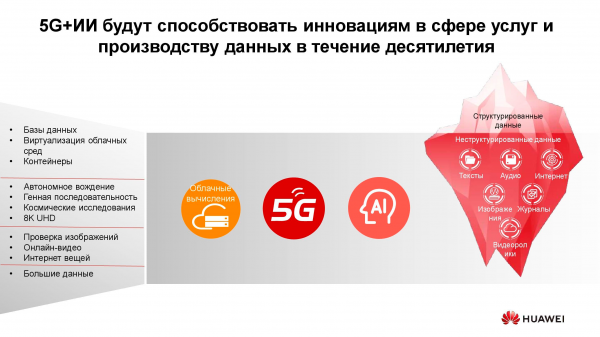
Skabere af ny information
Mængden af information, der opbevares i verden, vokser med cirka 30% om året. Det er gode nyheder for leverandører af lagringssystemer, men hvad er og vil være den primære kilde til disse data?
For ti år siden blev sociale medier sådanne generatører, hvilket krævede skabelsen af mange nye algoritmer, hardwareløsninger osv. Nu er der tre hoveddrivere for væksten i lagringsmængder. Den første er cloud computing. I dag bruger cirka 70% af virksomhederne på en eller anden måde cloud-tjenester. Det kan være e-mail-systemer, sikkerhedskopier og andre virtualiserede enheder.
Den anden driver er femte generations netværk. Dette giver nye hastigheder og nye datamængder. Ifølge vores prognoser vil udbredelsen af 5G føre til et fald i efterspørgslen efter flash-hukommelseskort. Uanset hvor meget hukommelse der er i telefonen, vil den til sidst være fyldt, og med en 100 megabit forbindelse i en enhed er der ikke længere nogen grund til at gemme billeder lokalt.
Den tredje gruppe årsager til den stigende efterspørgsel efter lagringssystemer inkluderer den hastige udvikling af kunstig intelligens, overgangen til big data-analyse og trenden mod universel automatisering af alt, hvad der er muligt.
En særlig karakteristika ved «nyt trafik» er dens . Vi skal opbevare disse data uden at definere deres format. Det kræves kun ved den efterfølgende læsning. For eksempel vil et banksystem til scoring af den tilgængelige lånesum kigge på de billeder, du har delt på sociale medier, for at vurdere, hvor ofte du besøger stranden og restauranter, samtidig med at det analyserer de medicinske dokumenter, der er tilgængelige for det. Disse data er på den ene side omfattende, men på den anden side er de uhomogene.
Havet af ustrukturerede data
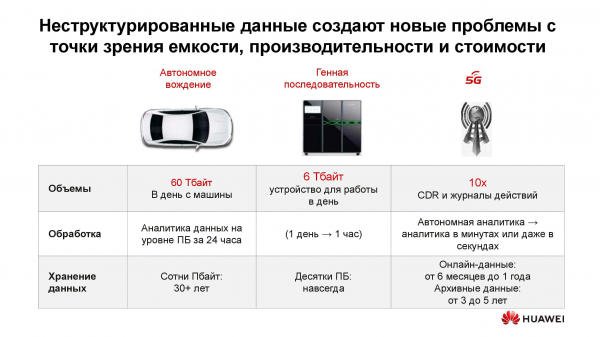
Hvilke problemer medfører så fremkomsten af «nye data»? Den primære blandt dem er selvfølgelig mængden af information og de beregnede opbevaringsperioder. Et moderne selvkørende køretøj genererer hver dag op til 60 TB data fra alle dets sensorer og mekanismer. For at udvikle nye bevægelsesalgoritmer skal denne information behandles inden for samme døgn, ellers vil den begynde at ophobe sig. Samtidig skal den opbevares i meget lang tid — i årtier. Kun da kan man i fremtiden drage konklusioner baseret på store analytiske prøver.
En enhed til dekodning af genetiske sekvenser producerer omtrent 6 TB om dagen. Og de data, der indsamles med dens hjælp, implicerer overhovedet ikke sletning, hvilket betyder, at de hypotetisk set skal opbevares for evigt.
Endelig er der de samme femte generations netværk. Udover selve den overførte information er et sådant netværk også en enorm generator af data: aktivitetsprotokoller, opkaldsoptagelser, mellemresultater af maskininteraktioner osv.
Alt dette kræver udvikling af nye tilgange og algoritmer til opbevaring og behandling af information. Og sådanne tilgange er ved at dukke op.
Teknologier fra den nye æra
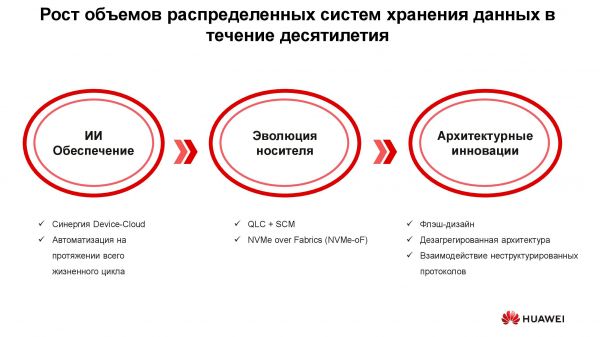
Man kan fremhæve tre grupper af løsninger, der har til formål at imødekomme de nye krav til informationslagringssystemer: implementering af kunstig intelligens, teknisk evolution af datalagringsmedier og innovationer inden for systemarkitektur. Lad os starte med AI.
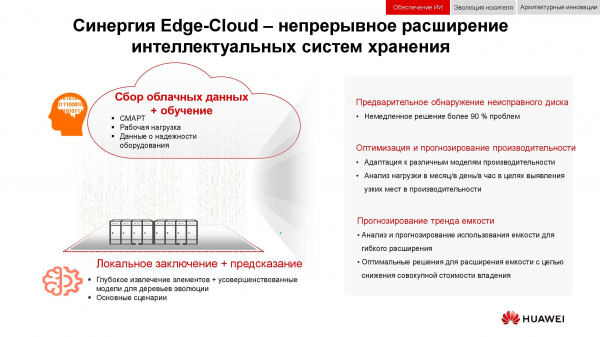
I de nye løsninger fra Huawei anvendes kunstig intelligens allerede på niveauet af selve lagringssystemet, som er udstyret med en AI-processor, der gør det muligt for systemet selv at analysere sin tilstand og forudsige fejl. Hvis lagringssystemet tilsluttes en servicecloud med betydelig beregningskraft, kan den kunstige intelligens behandle mere information og forbedre nøjagtigheden af sine hypoteser.
Udover fejl kan denne AI forudsige fremtidig spidsbelastning og tiden tilbage, indtil kapaciteten udtømmes. Dette gør det muligt at optimere ydeevnen og skalere systemet, inden nogen uønskede hændelser indtræffer.
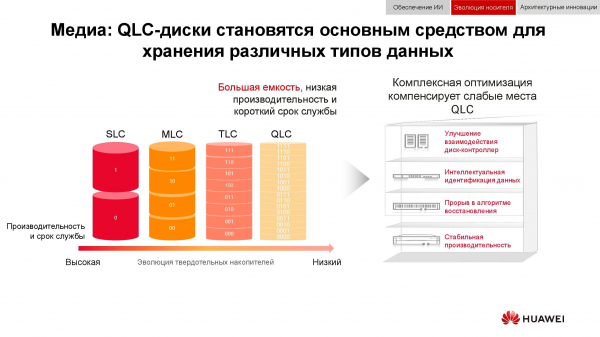
Lad os nu tale om udviklingen af datalagringsenheder. De første flash-drev blev fremstillet ved hjælp af SLC-teknologi (Single-Level Cell). Enheder baseret på denne teknologi var hurtige, pålidelige og stabile, men de havde en lille kapacitet og var meget dyre. Væksten i kapacitet og faldet i priserne blev opnået gennem visse tekniske kompromiser, som reducerede hastighed, pålidelighed og levetid for enhederne. Ikke desto mindre påvirkede denne trend ikke selve lagringssystemerne, som gennem forskellige arkitektoniske genveje generelt blev både mere ydedygtige og mere pålidelige.
Men hvorfor var der behov for All-Flash lagringssystemer? Var det ikke tilstrækkeligt blot at erstatte gamle HDD'er med nye SSD'er i den allerede eksisterende system? Dette var nødvendigt for effektivt at udnytte alle ressourcerne fra de nye flash-lagringsenheder, hvilket var umuligt i de gamle systemer.
Huawei har for eksempel udviklet en række teknologier til at løse denne opgave, hvoraf en blev , som maksimalt optimerede interaktionerne mellem "disk - controller".
Intelligent identifikation gjorde det muligt at opdelle data i flere strømme og håndtere en række uønskede fænomener såsom (write amplification). Samtidig har nye genoprettelsesalgoritmer, især , øget hastigheden på genopbygningen, hvilket reducerer tiden til helt ubetydelige værdier.
Fejl, overbelastning, "skraldesamlings" - disse faktorer påvirker heller ikke længere ydeevnen i lagringssystemet takket være specialtilpassede controllere.
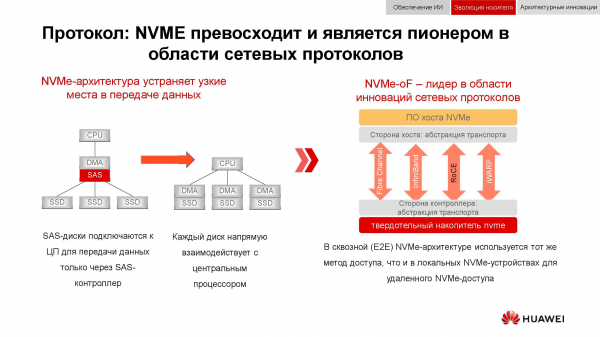
Og bloklagringsløsninger forbereder sig på at møde . Vi minder om, at den klassiske tilgang til dataadgang fungerede således: processoren henvendte sig til RAID-controlleren via PCI Express-bussen. Denne interagerede derefter med mekaniske diske via SCSI eller SAS. Anvendelsen af NVMe på backend har betydeligt accelereret hele processen, men det indebar en ulempe: lagringsenhederne måtte have direkte tilslutning til processoren for at give den direkte adgang til hukommelsen.
Den næste fase i udviklingen af teknologien, som vi ser nu, er anvendelsen af NVMe-oF (NVMe over Fabrics). Hvad angår Huaweis blokteknologier, understøtter de allerede FC-NVMe (NVMe over Fibre Channel), og NVMe over RoCE (RDMA over Converged Ethernet) er på vej. Testmodellerne er fuldt funktionelle, og der er kun et par måneder tilbage til deres officielle præsentation. Vi bemærker, at alt dette også vil dukke op i distribuerede systemer, hvor 'Ethernet uden tab' vil være meget eftertragtet.
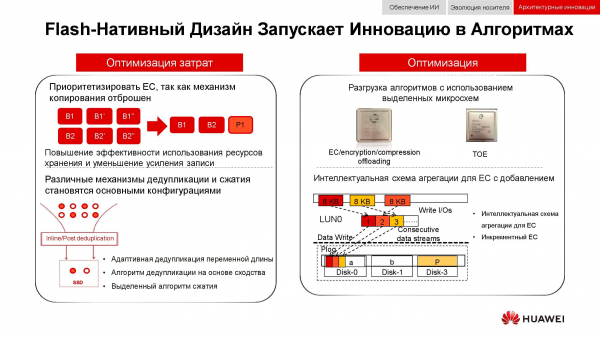
En yderligere metode til at optimere arbejdet med specifikt distribuerede lagringsløsninger er den fuldstændige opgivelse af datamirroring. Huaweis løsninger bruger ikke længere n kopier, som i det velkendte RAID 1, og skifter helt til mekanismen (Erasure coding). Et specielt matematisk værktøj beregner med jævne mellemrum kontrolblokke, der gør det muligt at genoprette mellemliggende data i tilfælde af tab.
Mekanismer til deduplikerings- og kompressionsprocesser bliver obligatoriske. Hvis vi i klassiske lagringssystemer er begrænset af antallet af installerede processorer i kontrollerne, så indeholder hvert modul i distribuerede horisontalt skalerbare lagringssystemer alt nødvendigt: diske, hukommelse, processorer og interconnect. Disse ressourcer er tilstrækkelige til, at deduplikation og komprimering har minimal indflydelse på ydeevnen.
Og om hardwaremetoder til optimering. Her er det lykkedes at reducere belastningen på de centrale processorer ved hjælp af ekstra dedikerede chips (eller dedikerede blokke i selve processoren), der fungerer som (TCP/IP Offload Engine) eller som påtager sig matematiske opgaver som EC, deduplikation og kompression.
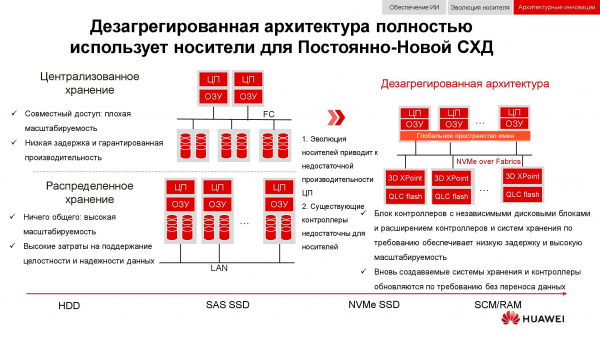
Nye tilgange til datalagring er blevet realiseret i en dekomponeret (distribueret) arkitektur. I systemer med centraliseret lagring findes der en serverfabrik, som er tilsluttet via Fibre Channel til et stort antal arrays. Ulemperne ved denne tilgang er vanskeligheder med skalerbarhed og sikring af et garanteret serviceniveau (med hensyn til ydeevne eller forsinkelse). Hyperkonvergerede systemer benytter de samme værter — både til lager og behandling af information. Dette giver praktisk talt ubegrænsede muligheder for skalerbarhed, men medfører høje omkostninger for at opretholde dataintegriteten.
I modsætning til de to ovenstående implicerer dekomponeret arkitektur adskillelse af systemet i en beregningsfabrik og et horisontalt lagersystem. Dette giver fordele fra begge arkitekturer og muliggør praktisk talt ubegribelig skalerbarhed kun på den komponent, hvor ydeevnen mangler.
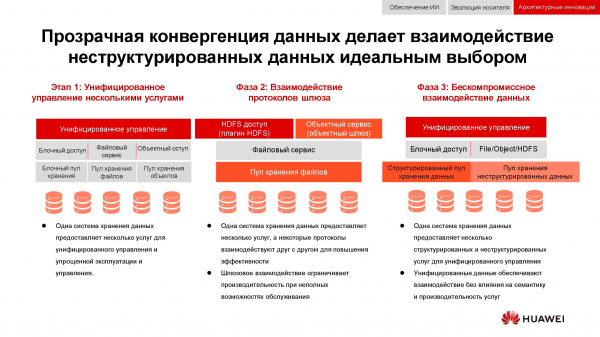
Fra integration til konvergens
Et klassisk problem, hvis relevans kun er steget de sidste 15 år, er behovet for samtidigt at sikre bloklagring, filadgang, adgang til objekter, arbejde med big data farm osv. Kirsebæret på toppen kunne for eksempel være et backup-system på magnetbånd.
I første fase kunne man kun standardisere administrationen af disse tjenester. Heterogene datalagringssystemer var bundet til noget specialiseret software, hvorigennem administratoren fordelte ressourcer fra tilgængelige puljer. Men da disse puljer var forskellige hardware-mæssigt, var belastningsmigration mellem dem umulig. På et højere integrationsniveau skete sammenlægningen på gateway-niveau. Med fælles filadgang kunne det gives gennem forskellige protokoller.
Den mest avancerede metode til konvergens, vi har til rådighed nu, indebærer oprettelse af et universelt hybrid-system. Netop sådan, som vores . Universel adgang bruger de samme hårdvareressourcer, logisk opdelt i forskellige puljer, men tillader belastningsmigration. Alt dette kan gøres gennem en enkelt administrationskonsol. På denne måde har vi været i stand til at implementere konceptet 'ét datacenter – ét lager'.
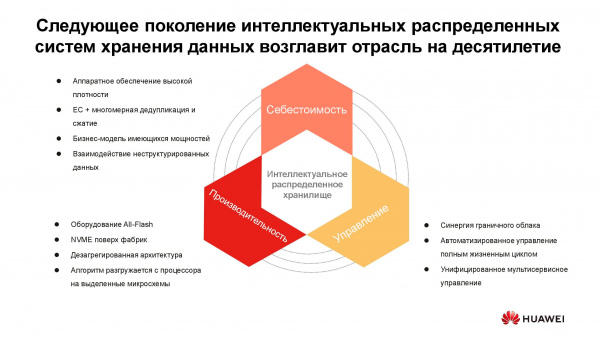
Omkostningerne ved informationsopbevaring definerer nu mange arkitektoniske beslutninger. Selvom man trygt kan sætte dette i centrum, diskuterer vi i dag 'live' opbevaring med aktiv adgang, så ydeevnen skal også tages i betragtning. Endnu en vigtig egenskab ved næste generations distribuerede systemer er ensartethed. Ingen ønsker at have flere disparate systemer, der styres fra forskellige konsoller. Alle disse kvaliteter er blevet realiseret i den nye serie af produkter fra Huawei. .
Massiv lager af næste generation
OceanStor Pacific opfylder kravene til pålidelighed på niveauet 'seks ni' (99,9999%) og kan bruges til at oprette datacentre af klassen HyperMetro. Ved en afstand mellem to datacentre på op til 100 km viser systemerne en ekstra forsinkelse på 2 ms, hvilket gør det muligt at bygge katastrofesikre løsninger baseret på dem, herunder med kvotumsystemer.
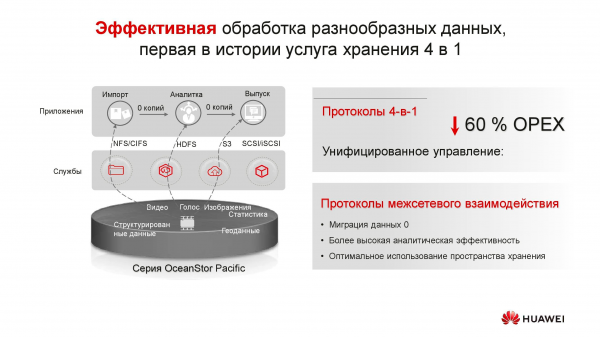
Produkter i den nye serie viser alsidighed med hensyn til protokoller. OceanStor 100D understøtter allerede blokadgang, objektadgang og Hadoop-adgang. Snart vil filadgang også blive implementeret. Der er ikke behov for at opbevare flere kopier af data, hvis de kan leveres via forskellige protokoller.
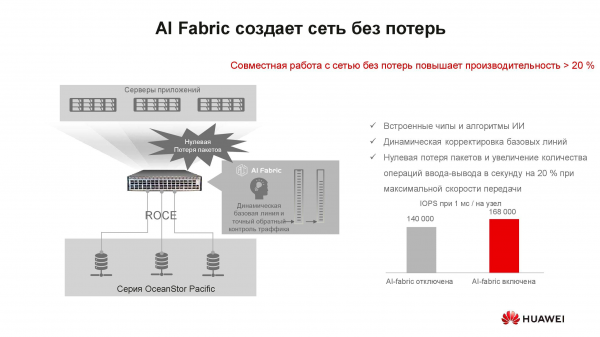
Hvordan relaterer ideen om 'netværk uden tab' sig til lagringssystemer? Det skyldes, at distribuerede datalagringssystemer er bygget på hurtige netværk, der understøtter relevante algoritmer og RoCE-mekanismer. Vores switches hjælper også med at øge netværkhastigheden og reducere forsinkelser med et system af kunstig intelligens. . Ydeevneforøgelsen ved aktivering af AI Fabric kan nå op på 20%.
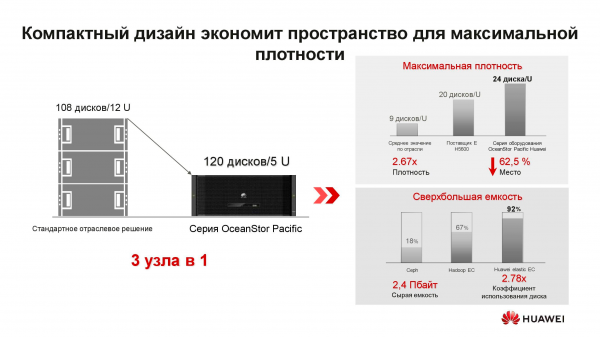
Hvad repræsenterer den nye node i det distribuerede lager OceanStor Pacific? En 5U formfaktor-løsning indeholder 120 drev og kan erstatte tre klassiske noder, hvilket giver mere end dobbelt så stor pladsbesparelse i rack'en. Takket være opgivelsen af opbevaring af kopier øges drevets effektivitet mærkbart (op til +92%).
Vi er vant til, at softwaredefinerede lagringssystemer er speciel software, der installeres på en klassisk server. Men for at opnå optimale parametre kræver denne arkitektur nu også specielle noder. Den inkluderer to servere baseret på ARM-processorer, der styrer en række 3-tommers lagringsenheder.
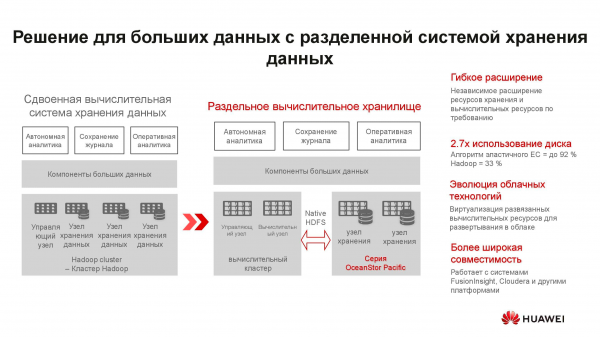
Disse servere er ikke velegnede til hyperkonvergente løsninger. For det første er der ikke mange applikationer til ARM, og for det andet er det svært at opretholde belastningsbalancen. Vi foreslår at skifte til separat opbevaring: den beregningscluster, der består af klassiske eller rack-servere, fungerer separat, men tilsluttes OceanStor Pacific-lagringsnoderne, som også udfører deres direkte opgaver. Og det betaler sig.
For eksempel, lad os tage en klassisk løsning til opbevaring af store data med et hyperkonvergent system, der optager 15 serverracks. Hvis belastningen fordeles mellem separate beregningsservere og OceanStor Pacific-lagringsnoder og adskilles, vil antallet af nødvendige racks halveres! Dette reducerer omkostningerne ved drift af datacenteret og mindsker de samlede ejeromkostninger. I en verden, hvor mængden af gemt information vokser med 30 % om året, skal man ikke sprede sådanne fordele.
***
Du kan få mere information om Huawei-løsninger og deres anvendelsesscenarier på vores eller ved at kontakte virksomhedens repræsentanter direkte.
Kilde: habr.com
