

Jeg vil gerne invitere dig til at se nærmere på afrapporteringen fra Nikolai Samokhalovs "Industriel tilgang til tuning af PostgreSQL: eksperimenter med databaser"
Shared_buffers = 25% – er det meget, lidt eller lige tilpas? Hvordan kan man finde ud af, om denne – ret forældede – anbefaling er relevant i dit specifikke tilfælde?
Det er tid til at tage spørgsmålet om valg af parametre i postgresql.conf "seriøst". Ikke ved hjælp af blinde "autotunere" eller forældede råd fra artikler og blogs, men baseret på:
- strengt kontrollerede eksperimenter på databaser, udført automatisk, i store mængder og under forhold, så tæt som muligt på "kamp"
- en dyb forståelse af databasens og operativsystemets funktioner.
Ved at bruge Nancy CLI (), vil vi se på et konkret eksempel – de berygtede shared_buffers – i forskellige situationer, i forskellige projekter og forsøge at finde ud af, hvordan man vælger den optimale indstilling til vores infrastruktur, database og belastning.
Vi vil tale om eksperimenter med databaser. Dette er en historie, der har varet lidt mere end et halvt år.
Lidt om mig selv. Jeg har mere end 14 års erfaring med Postgres. Jeg har grundlagt en række sociale netværk. Postgres er blevet brugt, og bliver stadig brugt, overalt.
Derudover har RuPostgres-gruppen på Meetup, 2. plads i verden. Vi nærmer os langsomt 2000 medlemmer. RuPostgres.org.
Og til forskellige konferencer, inklusive Highload, har jeg ansvaret for databaser, især Postgres, siden grundlæggelsen.
Og de seneste par år har jeg genoptaget min praksis inden for Postgres-konsulentarbejde i 11 tidszoner herfra.
Da jeg gjorde dette for et par år siden, havde jeg haft en vis pause i aktivt håndarbejde med Postgres, nok siden 2010. Jeg blev overrasket over, hvor lidt der var ændret i DBA'ernes arbejdsmiljø, og hvor meget håndarbejde der stadig var nødvendigt. Jeg tænkte straks, at der måtte være noget galt – der er behov for at automatisere så meget som muligt.
Og da alt dette var fjernt, var de fleste kunder i skyen. Og allerede meget var åbenlyst automatiseret. Mere om det senere. Med andre ord førte alt dette til ideen om, at der skulle være et sæt værktøjer, altså en platform, der ville automatisere stort set alle DBA-handlinger for at kunne håndtere et stort antal databaser.
I denne rapport vil der ikke være:
- Der vil ikke være "sølvkugler" og udsagn som – sæt 8 GB eller 25 % shared_buffers, så vil alt være godt. Der vil ikke være så meget om shared_buffers.
- Hardcore 'indretningsdelene'.
Hvad sker der?
- Der vil være optimeringsprincipper, som vi anvender og udvikler. Der vil komme forskellige ideer, som opstår undervejs, og forskellige værktøjer, som vi i høj grad udvikler i Open Source, dvs. vores grundlag er i Open Source. Desuden har vi billetter, alt kommunikation foregår praktisk taget i Open Source. Du kan se, hvad vi arbejder på nu, hvad der kommer i næste udgivelse osv.
- Og der vil også være en vis erfaring med anvendelsen af disse principper og værktøjer i en række virksomheder: fra små startups til store firmaer.
Hvordan udvikler det sig?
For det første er hovedopgaven for DBA ud over at sikre oprettelsen af instanser, implementeringen af backups osv. at finde flaskehalse og optimere ydeevnen.
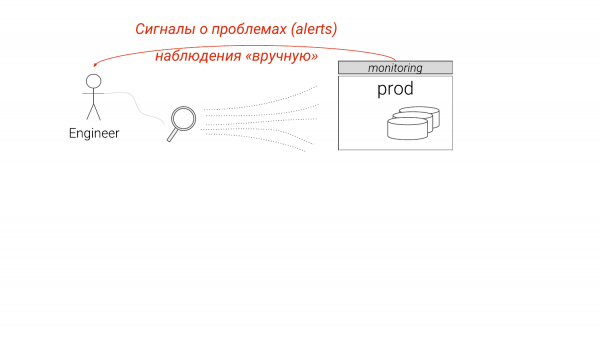
I øjeblikket er det struktureret på denne måde. Vi ser på overvågning, ser noget, men mangler nogle detaljer. Vi begynder at grave dybere, typisk manuelt, og forstår, hvad vi skal gøre med det.
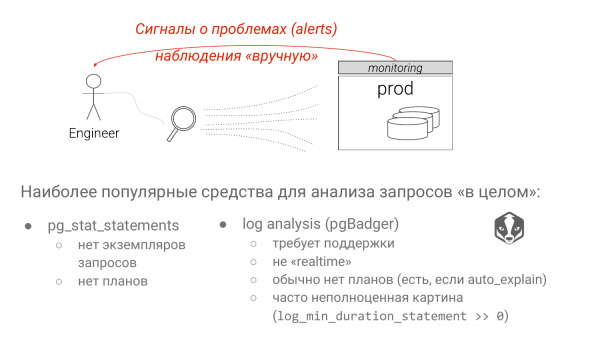
Der er to tilgange. Pg_stat_statements – den standardløsning, der bruges til at identificere langsomme forespørgsler. Og loganalyse af Postgres ved hjælp af pgBadger.
Hver af tilgange har alvorlige mangler. Den første tilgang kaster alle parametre væk. Og hvis vi ser grupper af SELECT * FROM table where kolonne er lig med ? eller $ med starten fra version 10 af Postgres. Vi ved ikke - er det en index scan eller seq scan. Det afhænger meget af parameteren. Hvis du indsætter en sjældent forekommende værdi, vil det være en index scan. Indsætter du en værdi, der udgør 90 % af tabellen, vil det åbenlyst være en seq scan, fordi Postgres kender statistikken. Dette er en stor ulempe ved pg_stat_statements, selvom der er gjort nogle forsøg på at forbedre det.
Den største ulempe ved loganalyser er, at du typisk ikke kan tillade 'log_min_duration_statement = 0'. Og det vil vi også tale om. Derfor ser du ikke det komplette billede. Og en forespørgsel, der er meget hurtig, kan forbruge en enorm mængde ressourcer, men du vil ikke se den, fordi den er under din tærskel.
Hvordan løser DBA'er de problemer, de finder?
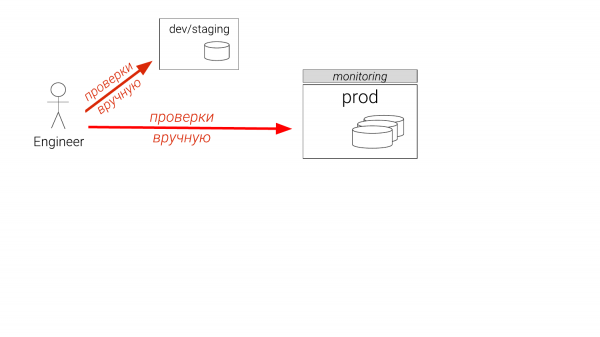
For example, we found some problem. What is usually done? If you're a developer, you'll do something on some instance that isn't that large. If you're a DBA, you have a staging. And there can only be one. And it's six months behind. And you think you're going to go into production. Even experienced DBAs check in production, on a replica. Sometimes they create a temporary index, ensure it helps, drop it, and hand it over to developers so they can stick it into migration files. This kind of nonsense is happening now. And it's a disaster.
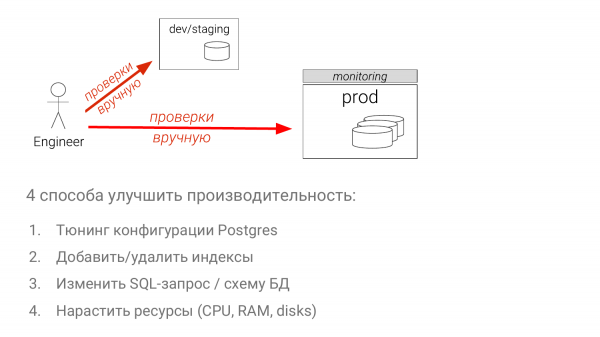
- Tuning configurations.
- Optimizing the set of indexes.
- Modifying the SQL query itself (this is the most complex method).
- Adding capacity (the simplest method in most cases).
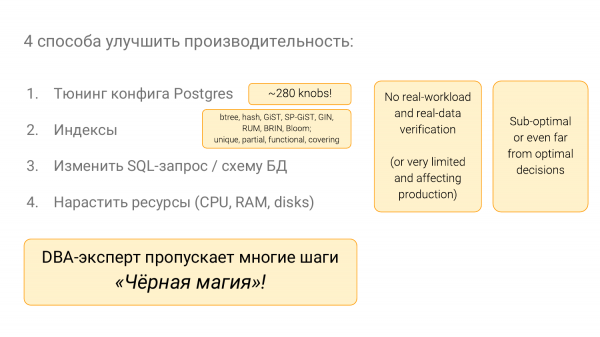
There are many things with these. There are many knobs in Postgres. You need to know a lot. Many indexes in Postgres, thanks in part to the organizers of this conference. And you need to understand all this, and this is what gives DBAs the feeling that they're practicing black magic. That is, you need to work for about 10 years to start understanding all of this properly.
And I am a fighter against this black magic. I want to do everything so that there is technology, not intuition in all of this.
Real-life examples
I have observed this in at least two projects, including my own. Another blog post informs us that a value of 1,000 for default_statistict_target is good. Good, let's try it in production.
And here we are, using our tool two years later through experiments on the databases we're discussing today, we can compare what was and what is now.
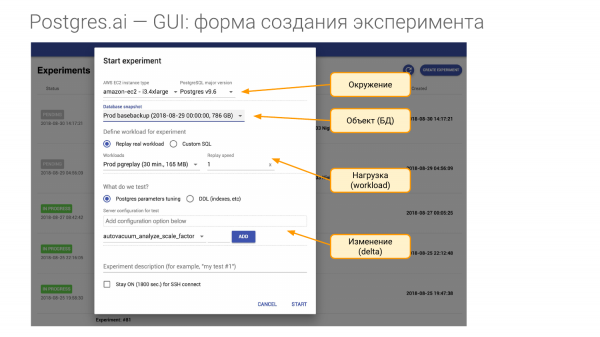
And for this, we need to create an experiment. It consists of four parts.
- The first is the environment. We need hardware. And when I come to a company and sign a contract, I say to provide me with hardware that is the same as in production. For each of your Masters, I need at least one piece of hardware like that. Whether it's a virtual machine instance on Amazon or Google, or I need exactly that same hardware. That is, I want to recreate the environment. And when we say environment, we include the major version of Postgres.
- The second part is the object of our research. This is the database. It can be created in several ways. I will show how.
- The third part is the load. This is the most difficult moment.
- Den fjerde del handler om, hvad vi kontrollerer, dvs. hvad vi sammenligner. Lad os sige, at vi kan ændre en eller flere parametre i konfigurationen, eller vi kan oprette en indeks, osv.
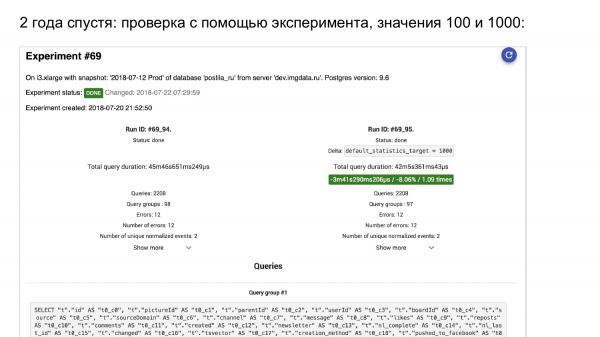
Vi starter et eksperiment. Her er pg_stat_statements. Til venstre – hvad der var. Til højre – hvad der blev.
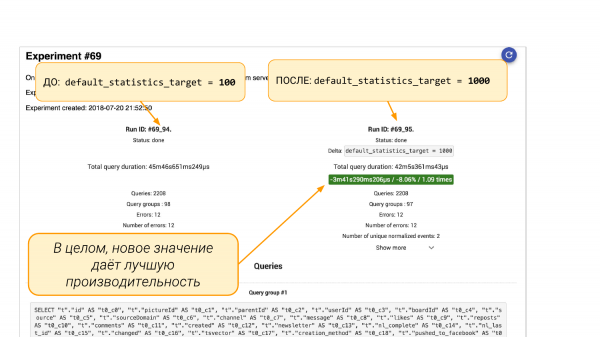
Til venstre default_statistics_target = 100, til højre = 1 000. Vi kan se, at det hjalp os. Generelt blev alt bedre med 8 %.
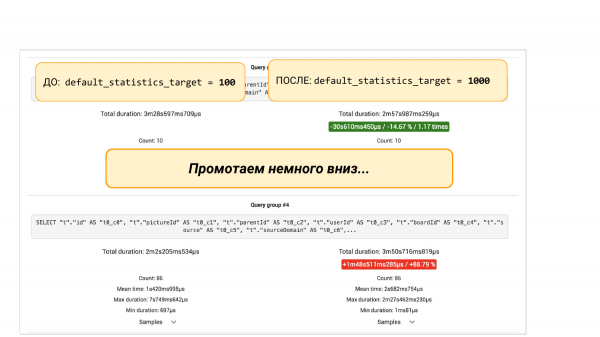
Men hvis vi ruller ned, vil der være gruppeforespørgsler fra pgBadger eller fra pg_stat_statements. Der er to muligheder. Vi kan se, at en forespørgsel er faldet med 88 %. Og her kommer det ingeniørmæssige aspekt ind. Vi kan dykke dybere, fordi det er interessant at finde ud af, hvorfor den faldt. Vi skal forstå, hvad der skete med statistikken. Hvorfor flere buckets i statistikken fører til et dårligere resultat.
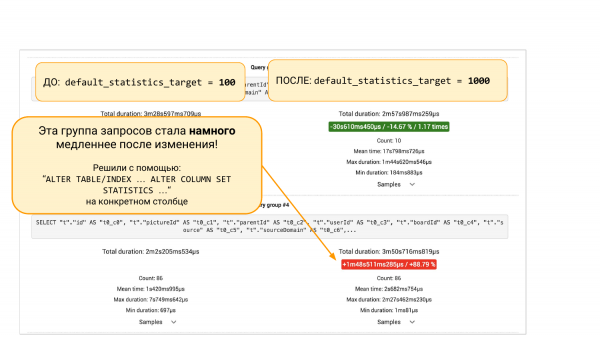
Eller vi kan vælge ikke at dykke dybere, men i stedet udføre "ALTER TABLE … ALTER COLUMN" og tilbageføre 100 buckets til statistikken for denne kolonne. Og derefter kan vi gennem yderligere eksperimenter bekræfte, at denne løsning hjalp. Det er det ingeniørmæssige tilgang, som hjælper os med at se hele billedet og træffe beslutninger baseret på data, ikke intuition.
Her er nogle eksempler fra andre områder. Tests har haft CI-tests i mange år. Og ingen projekt i sund fornuft vil eksistere uden automatiserede tests.
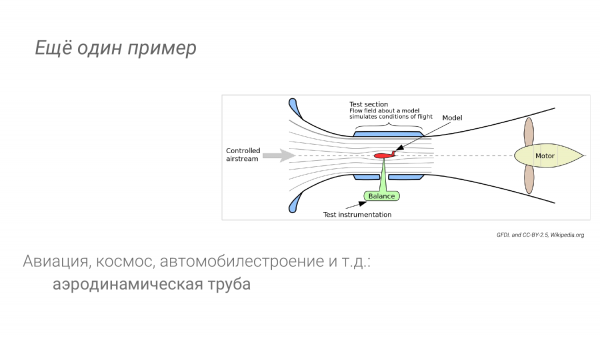
I andre industrier, såsom luftfart og bilproduktion, når vi tester aerodynamik, har vi også mulighed for at lave eksperimenter. Vi vil ikke umiddelbart sende noget fra tegningen direkte ud i rummet eller tage en bil ud på vejen. For eksempel har vi en vindtunnel.
Fra observationer i andre brancher kan vi drage konklusioner.
For det første har vi et specielt miljø. Det er tæt på produktionen, men ikke helt. Dets vigtigste kendetegn er, at det skal være billigt, gentageligt og så automatiseret som muligt. Der skal også være specielle værktøjer til at udføre en detaljeret analyse.
Sandsynligvis har vi færre muligheder for at undersøge hver millimeter af overfladen på en vinge, når vi har startet en flyvning og er i luften, end vi har i en vindtunnel. Vi har bedre diagnosticeringsværktøjer. Vi kan tillade os at tilføje mere tungt udstyr, som vi ikke kan installere på et fly i luften. Det samme gælder for Postgres. I nogle tilfælde kan vi aktivere fuld forespørgselslogging under eksperimenter. Og vi ønsker ikke at gøre dette i produktion. Måske vil vi endda aktivere det gennem auto_explain i vores planer.
Og som jeg allerede har sagt, betyder et højt niveau af automation, at vi trykker på en knap og gentager processen. Sådan skal det være, så der kan laves mange eksperimenter, og så det bliver en rutine.
Nancy CLI – fundamentet for "database-laboratoriet"
Og her er vi kommet med denne løsning. Det vil sige, jeg talte om disse idéer i juni, for næsten et år siden. Og vi har allerede i Open Source den såkaldte Nancy CLI. Dette er fundamentet for at bygge et database-laboratorium.
– Det er i Open Source, på Gitlab. Du kan sige, du kan prøve det. Jeg har givet et link i slides. Du kan klikke på det, og så vil der være for alle parametre.
Selvfølgelig er der stadig meget under udvikling. Der er mange idéer i spil. Men dette er allerede noget, vi anvender næsten dagligt. Og når vi får en idé – hvad nu hvis vi ved sletning af 40.000.000 rækker, at alt går i IO, så kan vi lave et eksperiment og se nærmere på, hvad der sker, og derefter forsøge at rette det i realtid. Det vil sige, vi laver et eksperiment. For eksempel justerer vi noget og ser, hvad resultatet bliver. Og vi gør det ikke i produktion. Det er essensen af idéen.
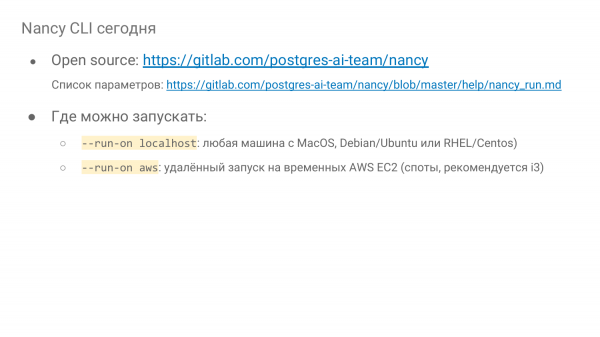
Hvor kan dette fungere? Det kan fungere lokalt, det vil sige, det kan gøres hvor som helst, jeg kan endda starte det på en MacBook. Du skal bruge Docker, så kører vi. Og det er det. Det kan køre i en hvilken som helst instans på hardware eller i en virtuel maskine, hvor som helst.
Og der er også mulighed for at køre eksternt i Amazon EC2 Instance, i spots. Og det er en rigtig god mulighed. For eksempel, i går gennemførte vi over 500 eksperimenter på i3 instance, fra den mindste og op til i3-16-xlarge. Og de 500 eksperimenter kostede os 64 dollars. Hvert eksperiment varede 15 minutter. Altså, takket være brugen af spots er det meget billigt – 70 % rabat, sekundtaxa fra Amazon. Du kan gøre rigtig meget. Du kan udføre reelle undersøgelser.
Og tre store versioner af Postgres understøttes. Det er ikke så svært at tilpasse nogle af de gamle versioner og den nye 12. version også.
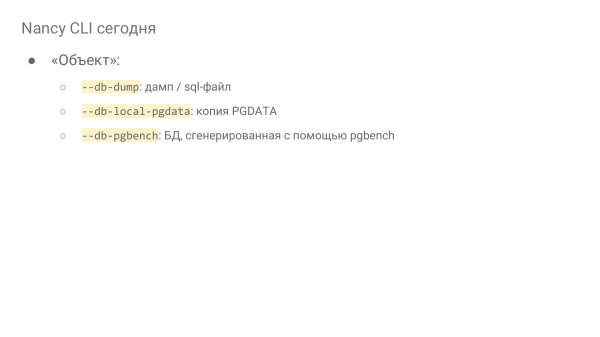
Vi kan angive objektet på tre måder. Det er:
- Dump/sql-fil.
- Den primære metode er at klone PGDATA-mappen. Som regel tages det fra backup-serveren. Hvis du har normale binære backups, kan du lave kloner derfra. Hvis du har cloud, så vil en cloud-udbyder som Amazon eller Google selv gøre det for dig. Dette er den vigtigste metode for kloner af reelt production. På denne måde implementerer vi lige netop.
- Og den sidste metode er velegnet til forskning, når du har lyst til at finde ud af, hvordan en bestemt ting fungerer i Postgres. Det er pgbench. Du kan generere med pgbench. Det er bare en mulighed ‘db-pgbench’. Du fortæller den, hvilken scale. Og alt vil blive genereret i skyen, som angivet.
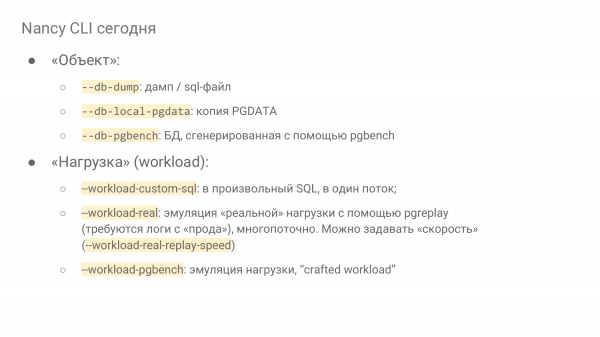
Og belastningen:
- Vi kan udføre belastningen i én SQL-tråd. Dette er den mest primitive metode.
- Eller vi kan emulere belastningen. Og vi kan emulere den primært på følgende måde. Vi skal samle alle logs. Og det er smertefuldt. Jeg vil vise, hvorfor. Og med hjælp af pgreplay, som er integreret i Nancy, afspiller vi.
- Eller en anden mulighed. Den såkaldte håndlavede belastning, som vi laver med en vis mængde kræfter. Ved at analysere vores nuværende belastning på systemet, trækker vi de mest fremtrædende grupper af forespørgsler. Og med pgbench kan vi emulere denne belastning i laboratoriet.
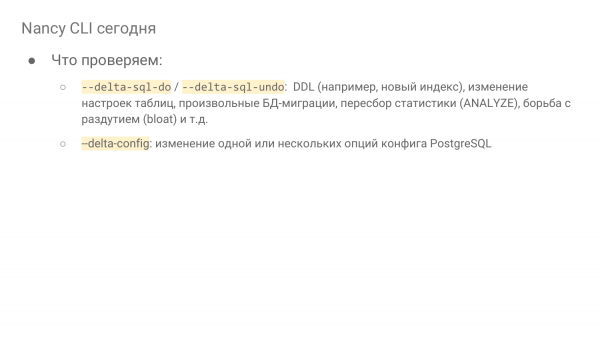
- Eller vi skal udføre en SQL-forespørgsel, dvs. kontrollere en eller anden migration, lave en indeks, køre ANALAZE der. Og vi ser, hvad der var før vacuum og efter vacuum. Kort sagt, enhver SQL.
- Enten ændrer vi en eller flere parametre i konfigurationen. Vi kan bede om at kontrollere for eksempel 100 værdier i Amazon for vores terabyte-database. Og efter et par timer har du resultatet. Som regel vil terabyte-database blive bygget op over flere timer. Men der er et patch i udviklingen, vi kan have en sekvens, det vil sige, du kan konsekvent bruge den samme pgdata på den samme server og udføre kontroller. Postgres vil genstarte, caches vil blive nulstillet. Og du kan påføre belastning.
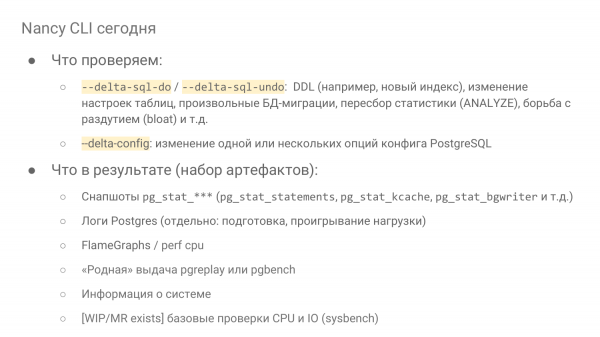
- Der kommer en mappe, hvor der ligger en masse forskellige filer, der starter med snapshots af pgstat***. Og det mest interessante der er pg_stat_statements, pg_stat_kcache. Dette er to udvidelser, som analyserer forespørgsler. Og pg_stat_bgwriter indeholder ikke kun pgwriter-statistik, men også statistik om checkpoint og hvordan backend-processer udskubber snavset buffers. Det hele er interessant at se på. For eksempel, når vi konfigurerer shared_buffers, er det meget interessant at se, hvor meget de har udskudt.
- Der kommer også Postgres logs. To logs – forberedelsesloggen og belastningsafspilningsloggen.
- En forholdsvis ny funktion – det er FlameGraphs.
- Hvis du også har brugt pgreplay eller pgbench varianter til belastningsafspilning, vil deres output være tilgængeligt. Og du vil se latency og TPS. Du kan forstå, hvordan de opfattede det.
- Systeminformation.
- Grundlæggende tests af CPU og IO. Dette er mere for EC2-instanser i Amazon, når du ønsker at starte 100 ens instanser i én strøm og køre 100 forskellige testløb, så har du 10.000 eksperimenter. Og du skal sikre dig, at du ikke får en defekt instans, som allerede er belastet af nogen. På denne hardware er der andre, der aktiverer og der er ikke mange ressourcer tilbage til dig. Sådanne resultater bør du bedre kaste ud. Og netop med sysbench fra Alexey Kopytov laver vi flere korte tests, som bliver leveret, og du kan sammenligne med andre, det vil sige, du forstår, hvordan CPU og IO opfører sig.
Hvilke tekniske udfordringer er der på eksempler fra forskellige virksomheder?
Lad os sige, at vi vil gentage en reel belastning ved hjælp af logs. Det er en fremragende idé, hvis det er skrevet med Open Source pgreplay. Vi bruger det. Men for at det fungerer godt, skal du aktivere fuld logning af forespørgsler med parametre og timing.
Der er nogle vanskeligheder med varighed og tidsstempel. Vi ser bort fra det hele. Det vigtigste spørgsmål er – har du råd til det eller ej?
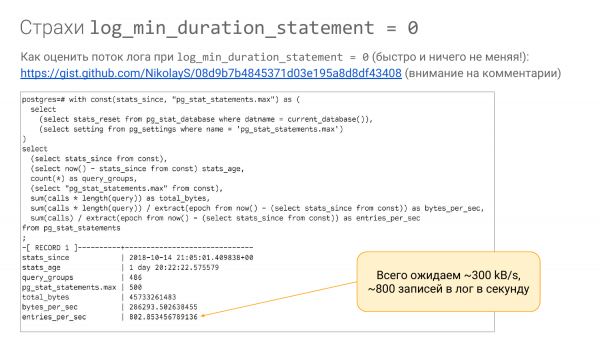
Problemet er, at det måske ikke er tilgængeligt. Du skal først forstå, hvilken strøm der vil blive skrevet i loggen. Hvis du har pg_stat_statements, kan du med denne forespørgsel (linket vil være tilgængeligt i slides) forstå, hvor mange byte der omtrent vil blive skrevet per sekund.
Vi ser på længden af forespørgslen. Vi ignorerer det faktum, at der ikke er parametre, men vi kender længden af forespørgslen og ved, hvor mange gange per sekund den blev udført. På den måde kan vi anslå, hvor mange byte der omtrent skrives per sekund. Vi kan tage fejl med det dobbelte, men ordren vil vi helt sikkert forstå på denne måde.
Vi kan se, at denne forespørgsel udføres 802 gange per sekund. Og vi ser, at bytes_per sec – 300 kB/s vil blive skrevet plus minus. Og som regel kan vi tillade os en sådan strøm.
Men! Sagen er, at der er forskellige logningssystemer. Og som standard har folk normalt ‘syslog’.
Og hvis du har syslog, kan du få et billede som dette. Vi tager pgbench, aktiverer logning af forespørgsler og ser, hvad der sker.
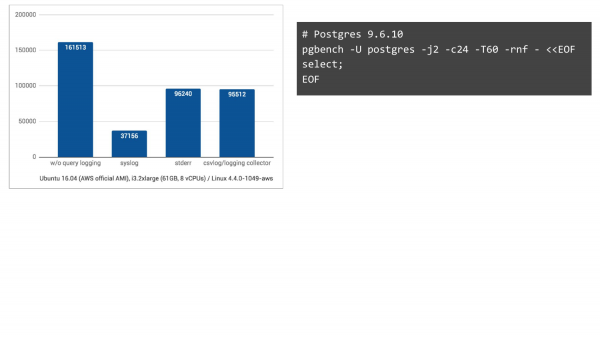
Uden logning – det er søjlen til venstre. Vi fik 161.000 TPS. Med syslog – det giver os 37.000 TPS i Ubuntu 16.04 på Amazon. Og hvis vi ændrer til de to andre logningsmetoder, er situationen meget bedre. Det vil sige, vi forventede, at det ville falde, men ikke så meget.
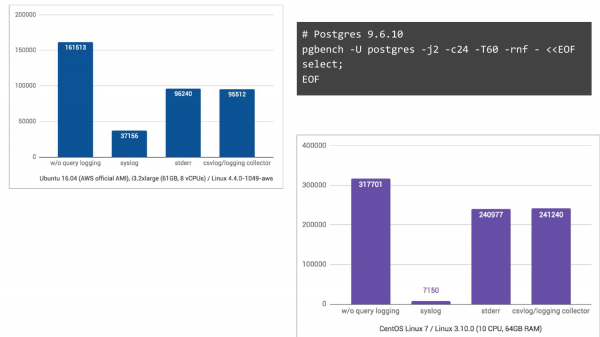
Og i CentOS 7, hvor journald også deltager og konverterer logfiler til binært format for nemmere søgning osv., falder vi faktisk med 44 gange i TPS.
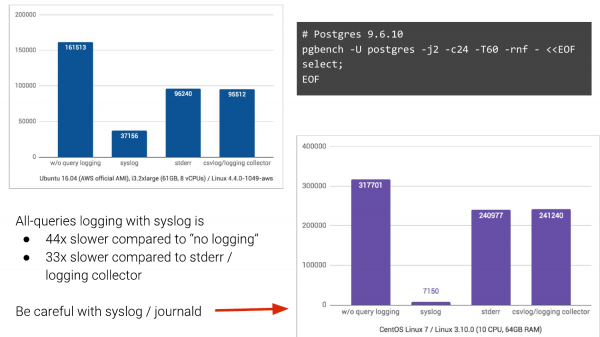
Og det er det, folk lever med. Og ofte i virksomheder, især store, er det meget svært at ændre. Hvis du kan bevæge dig væk fra syslog, så gør det venligst.
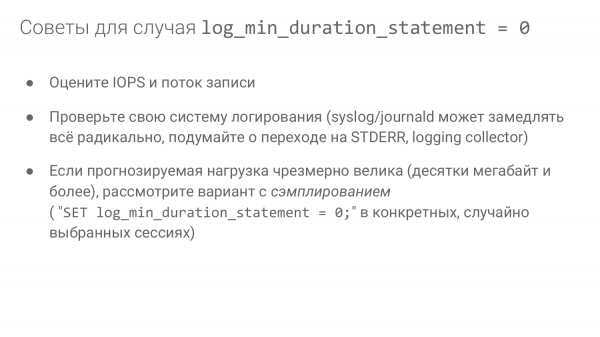
- Vurder IOPS og skriveflow.
- Tjek dit logningssystem.
- Hvis den forventede belastning er overdrevet høj, overvej muligheden for sampling.
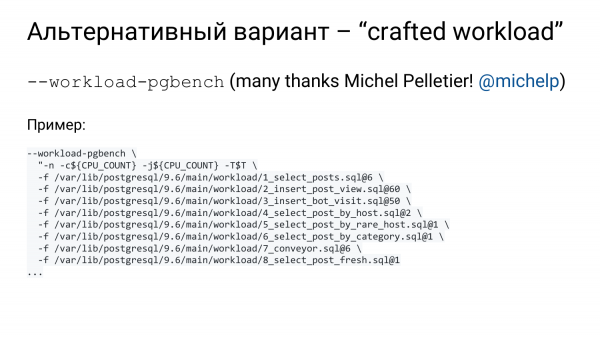
Vi har pg_stat_statements. Som jeg sagde, skal det nødvendigvis være der. Og vi kan tage og beskrive hver gruppe af forespørgsler på en speciel måde i en fil. Og herefter kan vi bruge en meget praktisk funktion i pgbench – muligheden for at indsætte flere filer ved hjælp af optionen '-f'.
Han forstår meget af "-f". Og man kan angive med "@" i slutningen, hvilken andel hver fil skal have. Således kan vi sige, at dette skal udføres i 10 % af tilfældene, og dette i 20 %. Dette vil bringe os tættere på, hvad vi ser i produktion.
Hvordan kan vi vide, hvad vi har i produktion? Hvilken andel og hvad er det? Her går vi lidt ud af kurs. Vi har et andet produkt. . Også baseret på Open Source. Og vi udvikler det aktivt lige nu.
Det blev skabt af lidt andre årsager. På grund af, at overvågning ikke er tilstrækkelig. Det vil sige, at når du kommer, kigger på databasen, ser på de problemer, der er. Og som regel laver du en health_check. Hvis du er en erfaren DBA, laver du en health_check. Du kigger på brugen af indekser mv. Hvis du har OKmeter, er det fantastisk. Det er en fremragende overvågning for Postgres. OKmeter.io – rabat, det er virkelig godt lavet. Det er betalt.
Hvis du ikke har det, er der som regel ikke meget i overvågning. Normalt er der CPU, IO og det med forbehold, og det er alt. Vi har brug for mere. Vi skal se, hvordan autovakuum fungerer, hvordan checkpoint fungerer, i io skal vi adskille checkpoint fra bgwriter og fra backend osv.
Problemet er, når du hjælper en større virksomhed, de kan ikke hurtigt implementere noget. De kan ikke hurtigt købe OKmeter. Måske køber de det om et halvt år. De kan ikke hurtigt installere nogen pakker.
Og vi fik ideen om, at vi havde brug for et særligt værktøj, der ikke kræver noget installation, det vil sige, at du slet ikke skal installere noget i produktionen. Du installerer det på din bærbare computer eller på en observerende server, hvorfra du vil køre det. Og det vil analysere mange elementer: både operativsystemet, filsystemet, og selve Postgres ved at udføre nogle lette forespørgsler, som kan køres direkte på produktion uden nedetid.
Vi kaldte det Postgres-checkup. Hvis vi taler medicinsk, er det en regelmæssig sundhedsvurdering. Hvis vi taler om bilhold, er det som serviceeftersyn. Du får service på din bil hver sjette måned eller hvert år, afhængigt af mærket. Gør du service på din database? Det vil sige, laver du dybdegående undersøgelser regelmæssigt? Det skal gøres. Hvis du tager backups, så skal du også lave checkup, det er mindst lige så vigtigt.
Og vi har et sådant værktøj. Det begyndte først at tage form for omkring tre måneder siden. Det er stadig ungt, men der er allerede meget i det.
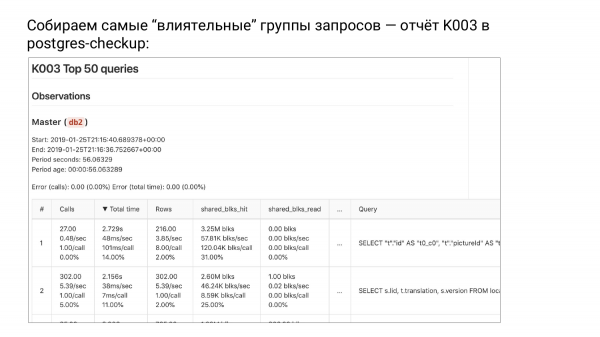
Vi samler de mest 'indflydelsesrige' forespørgselsgrupper – rapport K003 i Postgres-checkup
Og der er en gruppe rapporter K. Der er tre rapporter indtil videre. Og der er denne rapport K003. Den viser toppen af pg_stat_statements, sorteret efter total_time.
Når vi sorterer forespørgselsgrupper efter total_time, ser vi på toppen en gruppe, der bruger vores system mest, dvs. forbruger flest ressourcer. Hvorfor kalder jeg dem forespørgselsgrupper? Fordi vi har udelukket parametrene. Det er ikke længere forespørgsler, men grupper af forespørgsler, dvs. de er abstraherede.
Og hvis vi optimerer fra toppen og ned, vil vi lette vores ressourcer og forsinke det tidspunkt, hvor vi skal opgradere. Det er en meget god måde at spare penge på.
Måske er det ikke den bedste metode til at tage sig af brugerne, fordi vi muligvis ikke ser sjældne, men meget irriterende situationer, hvor en person ventede i 15 sekunder. Samlet set er de så sjældne, at vi ikke ser dem, men vi tager os af ressourcerne.
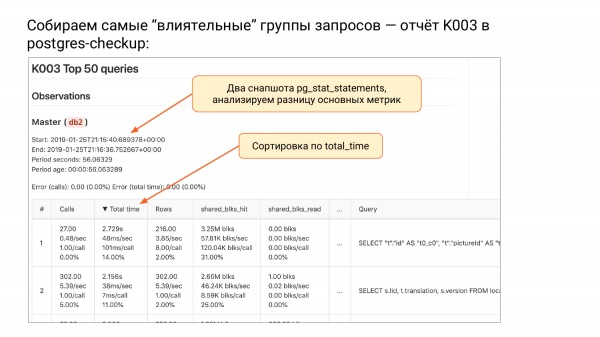
Hvad skete der i denne tabel? Vi lavede to snapshots. Postgres_checkup vil give dig en delta for hver metric: total-time, calls, rows, shared_blks_read osv. Det er det, deltaen er blevet beregnet. Problemet med pg_stat_statements er, at den ikke husker, hvornår den blev nulstillet. Mens pg_stat_database husker, gør pg_stat_statements ikke. Du ser, at der står 1.000.000, men vi ved ikke, hvorfra vi har regnet.
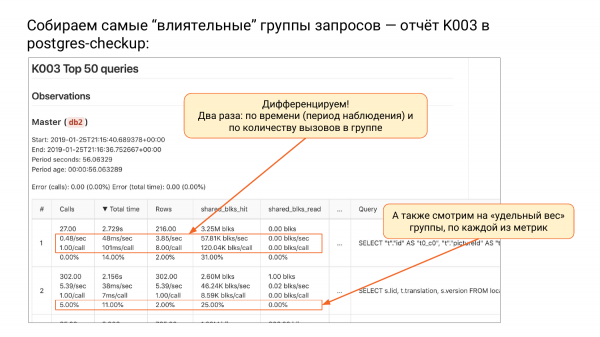
Og her ved vi, her har vi to snapshots. Vi ved, at deltaen i dette tilfælde var 56 sekunder. En meget lille periode. Sorteret efter total_time. Og videre kan vi differentiere, dvs. vi deler alle metrics med duration. Hvis vi deler hver metric med duration, vil vi få antal opkald per sekund.
Dernæst total_time per sekund – det er min yndlingsmetrik. Den måles i sekunder, pr. sekund, dvs. hvor mange sekunder vores system brugte på at udføre denne gruppe forespørgsler pr. sekund. Hvis du ser, at det er mere end én sekund pr. sekund, betyder det, at du skal give mere end én kerne. Det er en meget god metrisk. Du kan forstå, at denne person for eksempel har brug for minimum tre kerner.
Dette er vores know-how, jeg har aldrig set noget lignende. Bemærk – det er en meget simpel ting – sekunder pr. sekund. Nogle gange, når din CPU er 100 %, så er det halve time pr. sekund, dvs. du har kun arbejdet med disse forespørgsler i et halvt time.
Here we see rows per second. We know how many rows per second were returned.
And then there's another interesting thing. How much we read from shared_buffers per second from the shared_buffers itself. Hits were already there, and the rows were taken from the operating system cache or from the disk. The first option is fast, while the second may or may not be fast, depending on the situation.
The second way of differentiation is to divide the number of queries in this group. In the second column, you will always have one request divided by the request. And then it gets interesting – how many milliseconds were spent on this request. We know how this request typically performs. It took 101 milliseconds for each request. This is a traditional metric we need for understanding.
How many lines each request returned on average. We see that this group returns 8. How much was taken and read from the cache on average. We see that everything is nicely cached. Consistent hits for the first group.
The fourth substring in each line indicates the percentage of the total. We have calls, say, in 1,000,000. And we can understand what contribution this group makes. We see that in this case the first group contributes less than 0.01%. That is, it is so slow that we don’t see it in the overall picture. The second group, however, accounts for 5% of the calls. That is, 5% of all calls are from the second group.
It’s also interesting regarding total_time. We spent 14% of the total work time on the first group of requests. On the second, we spent 11%, and so on.
I won’t go into details, but there are nuances. We show the error at the top because when we compare, snapshots can drift, meaning some requests might drop out and might not be present in the second snapshot while new ones might appear. We calculate the error there. If you see 0, that's good. There are no errors. If the error rate is up to 20%, that’s OK.
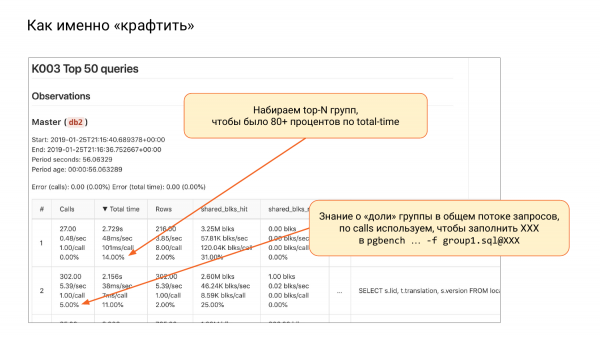
Next, we return to our topic. We need to craft the workload. We take a top-down approach until we reach 80% or 90%. Usually, this is 10-20 groups. And we create files for pgbench. We use random there. Sometimes, unfortunately, this doesn’t work out. In Postgres 12, there will be more opportunities to use this approach.
Sådan når vi 80-90 % af total_time. Hvad skal vi derefter indsætte efter «@»? Vi kigger på opkald, ser hvor mange procent og forstår, at vi her skal have en bestemt procentdel. Fra disse procentdele kan vi bestemme, hvordan vi balancerer hver af filerne. Herefter bruger vi pgbench og går i gang med arbejdet.
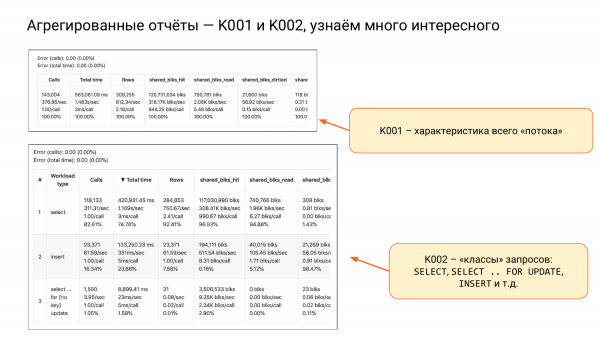
Vi har også K001 og K002.
K001 – det er en stor streng med fire understrenge. Det er karakteristikken af vores hele belastning. Se den anden kolonne og den anden understreng. Vi ser, at det er cirka halvanden sekund pr. sekund, det vil sige, at hvis der er to kerner, så er det godt. Belastningen vil være omkring 75 %. Og det vil fungere sådan. Hvis vi har 10 kerner, så vil vi være helt rolige. Sådan kan vi evaluere ressourcerne.
K002 – det kalder jeg klasser af forespørgsler, dvs. SELECT, INSERT, UPDATE, DELETE. Og separat SELECT FOR UPDATE, fordi den låser.
Og her kan vi konkludere, at almindelige læsende SELECT – udgør 82 % af alle opkald, men de har 74 % af total_time. Det vil sige, at de bliver kaldt meget, men forbruger mindre ressourcer.
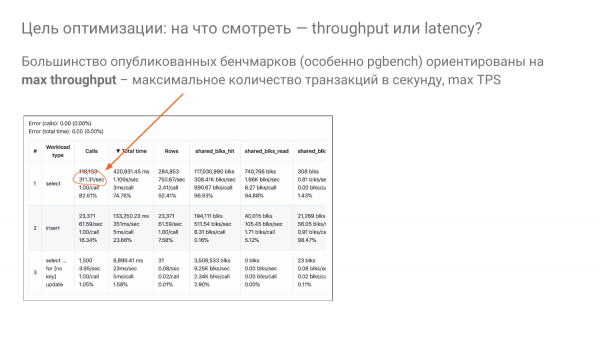
Og vi vender tilbage til spørgsmålet: «Hvordan vælger vi shared_buffers korrekt?». Jeg har bemærket, at de fleste benchmark-test er bygget på ideen – lad os se, hvilken throughput der vil være, det vil sige, hvad kapaciteten bliver. Den måles som regel i TPS eller QPS.
Og vi forsøger at presse så mange transaktioner pr. sekund som muligt ud af maskinen ved hjælp af tuning-parametre. Her er det nemlig 311 pr. sekund for select.
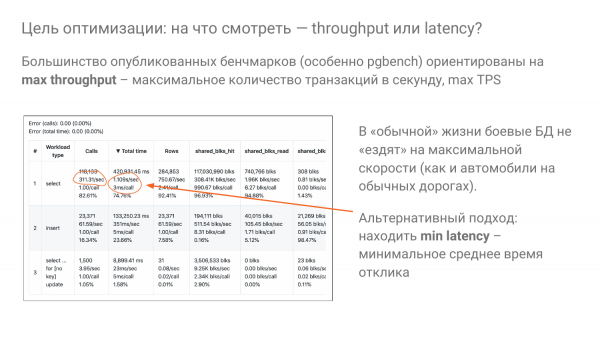
Men ingen kører til arbejde og tilbage hjem med bilen på fuld fart. Det ville være tåbeligt. Det samme gælder databaser. Vi bør ikke køre på fuld fart, og det gør ingen. Ingen lever i et production-miljø med 100 % CPU. Selvom der måske er nogen, der gør, er det ikke godt.
Ideen er, at vi normalt kører på ca. 20 % af vores kapacitet, gerne ikke over 50 %. Og vi forsøger først og fremmest at optimere svartid for vores brugere. Det vil sige, vi skal justere vores parametre, så vi har minimal latency ved en hypotetisk 20 % hastighed. Det er den idé, som vi også forsøger at anvende i vores eksperimenter.
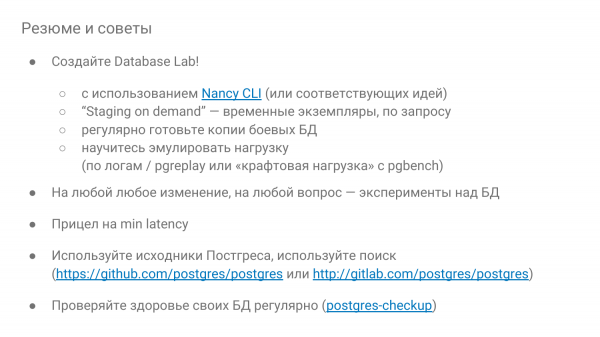
Og til slut nogle anbefalinger:
- Sørg for at lave Database Lab.
- Hvis muligt, lav det on demand, så det kan blive opdelt i et stykke tid – leg med det og smid det derefter væk. Hvis du har cloud, så er det selvfølgelig, dvs. hav mange stående ressourcer.
- Vær nysgerrig. Og hvis noget ikke ser rigtigt ud, så tjek det med eksperimenter for at se, hvordan det opfører sig. Nancy kan bruges til at lære sig selv og til at undersøge, hvordan databasen fungerer.
- Og sigt efter minimal responstid.
- Og vær ikke bange for Postgres-kildekoden. Når du arbejder med kildekoden, skal du kunne engelsk. Der er mange kommentarer, der forklarer alt.
- Og tjek sundheden af databasen regelmæssigt, mindst en gang hver tredje måned manuelt eller brug Postgres-checkup.
Spørgsmål
Tusind tak! Det er en meget interessant ting.
To ting.
Ja, to ting. Jeg forstod bare ikke helt. Når vi arbejder med Nancy, kan vi kun justere én parameter eller en hel gruppe?
Vi har en delta-config parameter. Du kan justere så mange, som du ønsker, på én gang. Men du skal forstå, at når du ændrer mange ting, kan du drage forkerte konklusioner.
Ja. Derfor spurgte jeg? Fordi det er svært at lave eksperimenter, når du kun har én parameter. Du justerer den, ser hvordan det fungerer, stiller den ind, og så begynder du med den næste.
Du kan justere flere på én gang, men det afhænger selvfølgelig af situationen. Men det er bedre at teste én idé ad gangen. Vi fik en idé i går. Vi havde en meget lignende situation. Der var to konfigurationer. Og vi kunne ikke forstå, hvorfor der var så stor forskel. Og idéen opstod om, at vi skulle bruge dikotomi for systematisk at forstå og finde ud af, hvad forskellen var. Du kan gøre halvdelen af parametrene ens på én gang, derefter en fjerdedel osv. Alt er fleksibelt.
Og jeg har et spørgsmål mere. Projektet er ungt og udvikler sig. Er dokumentationen allerede klar, og findes der en detaljeret beskrivelse?
Jeg har der lavet et link til beskrivelsen af parametrene. Det findes. Men der mangler stadig meget. Jeg leder efter ligesindede. Og jeg finder dem, når jeg taler. Det er rigtig fedt. Nogen arbejder allerede sammen med mig, nogen har hjulpet, og har gjort noget der. Og hvis du er interesseret i dette emne, så giv mig gerne feedback - hvad der mangler.
Når vi får lavet laboratoriet, kan der måske komme feedback. Vi ser på det. Tak!
Hej! Tak for præsentationen! Jeg bemærkede, at der er støtte for Amazon. Er der planer om støtte til GSP?
Det er et godt spørgsmål. Vi er begyndt at arbejde på det. Og lige nu er det sat i bero, fordi vi ønsker at spare. Det vil sige, der er support via 'run on localhost'. Du kan selv oprette en instance og arbejde lokalt. For resten gør vi det på den måde. Jeg gør det sådan i Getlab, der kører på GSP. Men vi ser ikke umiddelbart nogen mening i at lave netop denne orkestrering, fordi Google ikke har billige spottjenester. De har status instances, men de har begrænsninger. For det første er der altid kun 70 % rabat, og der er ikke mulighed for at lege med prisen. Det er derfor, vi hæver prisen på spottjenester med 5-10 % for at mindske risikoen for, at du bliver ramt. Det vil sige, at du sparer med spottjenesterne, men de kan til enhver tid fjernes. Hvis du sætter prisen en smule højere end de andre, vil du blive slået ud senere. Google har en helt anden specifik. Og der er også en meget dårlig begrænsning – de lever kun i 24 timer. Nogle gange vil vi dog gerne køre eksperimentet i 5 dage. Men det kan ske med spottjenester, som nogle gange lever i flere måneder.
Hej! Tak for din præsentation! Du nævnte om checkup. Hvordan beregner du fejlene i stat_statements?
Det er et meget godt spørgsmål. Jeg kan vise og forklare det i detaljer. Kort sagt – vi ser på, hvordan sæt af forespørgsler har ændret sig: hvor mange der er faldet væk, og hvor mange nye der er dukket op. Og derefter kigger vi på to metrikker: total_time og calls, så der er to fejl her. Vi ser på, hvilket bidrag de ændrede grupper har. Der er to undergrupper: de der er faldet væk, og de der er kommet tilbage. Vi ser på, hvilket bidrag de har til det samlede billede.
Er du ikke bange for, at den vil blive behandlet to-tre gange mellem snapshots?
Det vil sige, de registrerede sig igen, eller hvordan?
For eksempel, denne forespørgsel blev allerede udelukket én gang, så kom den tilbage og blev udelukket igen, og så kom den tilbage igen og blev udelukket. Og hvad har du så talt med? Hvor er alt det?
Godt spørgsmål, vi skal kigge på det.
Jeg har lavet noget lignende. Naturligvis var jeg alene om det, og det var simplere. Men jeg måtte nulstille, lave reset stat_statements og orientere mig på tidspunktet for snapshot, så der var mindre end en bestemt andel, hvilket stadig ikke nåede loftet, hvor mange stat_statements der kan akkumuleres. Og jeg orienterer mig efter, at der sandsynligvis ikke er noget, der er blevet udelukket.
Ja- ja.
Men hvordan kan man ellers gøre det på en pålidelig måde, forstår jeg ikke.
Desværre kan jeg ikke huske præcist – bruger vi teksten i forespørgslen eller queryid fra pg_stat_statements og orienterer os efter det. Hvis vi orienterer os efter queryid, så sammenligner vi principielt sammenlignelige ting.
Nej, den kan blive overskrevet flere gange mellem snapshots og komme tilbage igen.
Med denne id?
Ja.
Vi vil undersøge det. Godt spørgsmål. Vi skal se nærmere på det. Men indtil videre ser det ud til, at vi enten skriver 0…
Det er selvfølgelig en sjælden situation, men jeg blev rystet, da jeg fandt ud af, at stat_statements kan blive overskrevet.
Der kan være meget i Pg_stat_statements. Vi har oplevet, at hvis track_utility = on, så bliver dine sets også tracket.
Ja, selvfølgelig.
Og hvis du har java hibernate, som er tilfældig, så begynder hash-tabellen at blive låst. Og så snart du deaktiverer en meget belastet applikation, ender du med 50-100 grupper. Og så er alt mere eller mindre stabilt. En af måderne at bekæmpe dette på er at øge pg_stat_statements.max.
Ja, men det er vigtigt at vide, hvor meget. Og man skal holde øje med det. Det gør jeg også. Det vil sige, at jeg har pg_stat_statements.max. Og jeg ser, at jeg ikke nåede 70 % ved snapshot tidspunktet. Godt, så vi har ikke mistet noget. Vi laver reset. Og samler op igen. Hvis det i det næste snapshot er under 70, så har vi sandsynligvis heller ikke mistet noget.
Ja. Som standard er det nu 5.000. Og mange har rigeligt med det.
Normalt – ja.
Video:
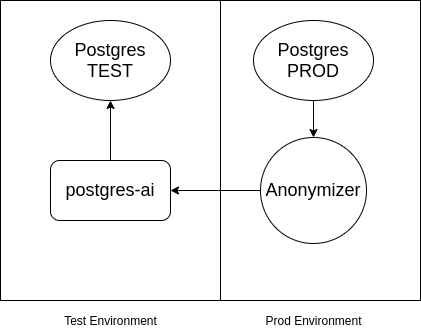
P.S. Jeg vil tilføje, at hvis der er fortrolige oplysninger i Postgres, som ikke må komme ind i testmiljøet, kan man benytte . Skemaet er cirka følgende:
Kilde: habr.com
