

Dette indlæg er skrevet, fordi vores medarbejdere har haft en del samtaler med kunder om app-udvikling på Kubernetes og de specifikke aspekter ved denne udvikling på OpenShift.
Vi starter ofte med tesen, at Kubernetes er bare Kubernetes, mens OpenShift er en Kubernetes-platform, ligesom Microsoft AKS eller Amazon EKS. Hver af disse platforme har sine fordele, rettet mod forskellige målgrupper. Og derefter flyder samtalen over i en sammenligning af styrker og svagheder ved de konkrete platforme.
Generelt tænkte vi at skrive dette indlæg med konklusionen, "Hør her, det er ligegyldigt, hvor du kører koden, på OpenShift, AKS, EKS eller på en hvilken som helst specialbygget Kubernetes, ja, på hvilken som helst Kubernetes. (for kortheds skyld kalder vi det KUK) – det er faktisk ret simpelt, begge steder."
Derefter planlagde vi at tage en simpel "Hello World" og vise, hvad der er fælles og hvor der er forskelle mellem KUK og Red Hat OpenShift Container Platform (herefter OCP eller blot OpenShift).
Men mens vi skrev dette indlæg, indså vi, at vi på så mange måder er blevet så vant til at bruge OpenShift, at vi simpelthen ikke er klar over, hvordan det er vokset og blevet en fantastisk platform, der er blevet meget mere end bare en Kubernetes-distribution. Vi har taget OpenShifts modenhed og enkelhed for givet og overset dets storhed.
Generelt er det tid til forsoning, og nu vil vi trin-for-trin sammenligne implementeringen af vores "Hello World" på KUK og OpenShift og gøre det så objektivt som muligt (mediens vi nogle gange viser personlig holdning til emnet). Hvis du er interesseret i en rent subjektiv mening om dette emne, kan den læses . I dette indlæg holder vi os til fakta og kun fakta.
Klynger
Så til vores "Hello World" har vi brug for klynger. Lad os straks sige "nej" til offentlige skyer for ikke at betale for servere, registre, netværk, dataoverførsel osv. Derfor vælger vi en simpel enkelt-nodeklynge på (til KUK) og (til OpenShift-klyngen). Begge disse muligheder er ret nemme at installere, men kræver en del ressourcer på din bærbare computer.
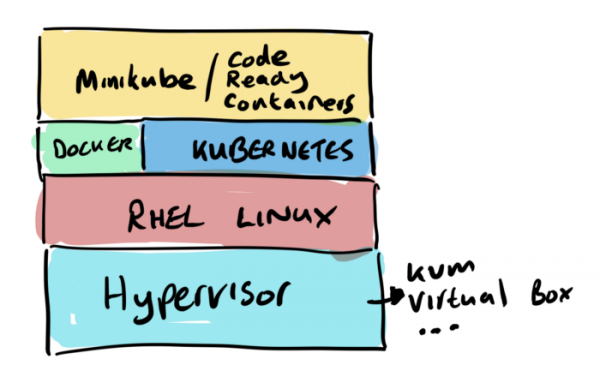
Bygning på KUK
Så lad os komme i gang.
Trin 1 – vi opbygger vores containerbillede
Jeg starter med at deployere vores "Hello World" på minikube. Til dette vil vi få brug for:
- 1. Installeret Docker.
- 2. Installeret Git.
- 3. Installeret Maven (faktisk bruger dette projekt mvnw-binæren, så dette kan undlades).
- 4. Selve kilden, altså klon af repository'et.
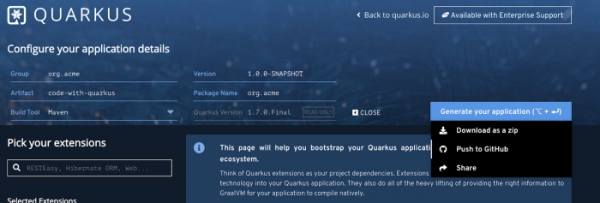
Først skal vi oprette et Quarkus-projekt. Bliv ikke skræmt, hvis du aldrig har arbejdet med Quarkus.io – det er let. Du vælger bare de komponenter, du ønsker at bruge i projektet (RestEasy, Hibernate, Amazon SQS, Camel osv.), og så konfigurerer Quarkus selv archetypen mvn og uploader alt til GitHub. Så det er bogstaveligt talt et enkelt klik med musen – og det er klar. Det er netop derfor, vi elsker Quarkus.
Den nemmeste måde at bygge vores "Hello World" i en containerbillede er at bruge quarkus-maven-udvidelserne til Docker, som klarer alt det nødvendige arbejde. Med Quarkus er det virkelig blevet let og enkelt: tilføj udvidelsen container-image-docker, og du kan oprette billeder med mvn-kommandoer.
./mvnw quarkus:add-extension -Dextensions="container-image-docker"
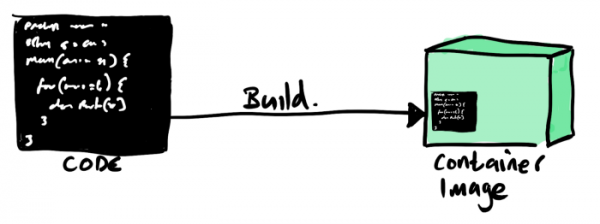
Og endelig bygger vi vores billede ved hjælp af Maven. Resultatet er, at vores kildekode bliver til et klart containerbillede, som allerede kan køres i containerudførelsesmiljøet.
./mvnw -X clean package -Dquarkus.container-image.build=true
Og der har vi det, nu kan vi køre containeren med kommandoen docker run, ved at kortlægge vores service til port 8080, så den kan tilgås.
docker run -i --rm -p 8080:8080 gcolman/quarkus-hello-world
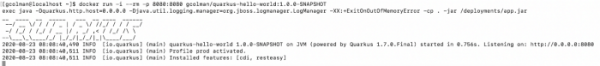
Når container-instansen er startet, er det kun at kontrollere med kommandoen curl, om vores service kører:

Så, det fungerer, og det var virkelig let og enkelt.
Trin 2 – sender vores container til containerbillede-repositoriet.
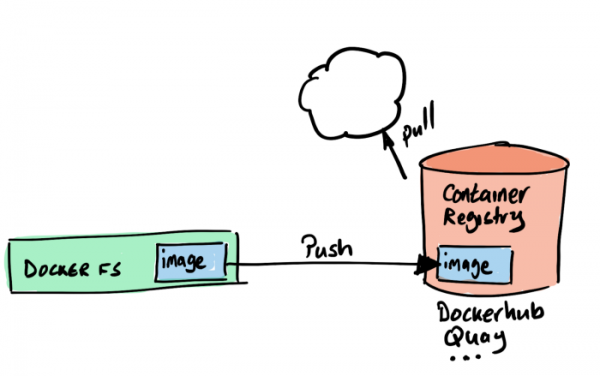
Indtil videre opbevares det billede, vi har oprettet, lokalt i vores lokale containerlager. Hvis vi vil bruge dette billede i vores K8s-miljø, skal det placeres i et andet repository. Kubernetes har ikke denne funktion, så vi vil bruge Docker Hub. Fordi for det første er det gratis, og for det andet (næsten) alle gør det.
Det er også meget enkelt, og her er der kun brug for en konto på Docker Hub.
Så, lad os tilføje Docker Hub og sende vores billede derop.
Trin 3 – starter Kubernetes.
Der er mange måder at samle Kubernetes-konfigurationen til at køre vores "Hello World", men vi vil bruge den letteste af dem, vi er sådan nogle mennesker...
Lad os starte med at køre minikube-klister:
minikube start
Trin 4 – udlægger vores containerbillede
Nu skal vi konvertere vores kode og containerbillede til Kubernetes-konfigurationer. Med andre ord, vi har brug for en pod- og deployment-definition, der henviser til vores containerbillede på Docker Hub. En af de nemmeste måder at gøre dette på er at køre kommandoen create deployment og angive vores billede:
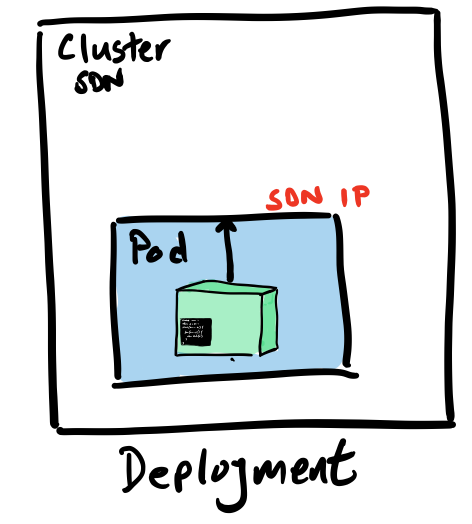
kubectl create deployment hello-quarkus --image=gcolman/quarkus-hello-world:1.0.0-SNAPSHOT
Med denne kommando har vi sagt til vores KUBE at skabe en deployment-konfiguration, der skal indeholde specifikationen af pod'en for vores containerbillede. Denne kommando anvender også denne konfiguration på vores Minikube-klynge og opretter en deployment, der downloader vores containerbillede og starter en pod i klyngen.
Trin 5 – åbner adgang til vores service
Nu hvor vi har et udrullet containerbillede, er det tid til at overveje, hvordan vi konfigurerer ekstern adgang til denne RESTful-service, som faktisk er programmeret i vores kode.
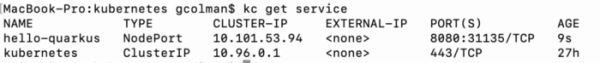
Der er mange måder at gøre dette på. For eksempel kan vi bruge kommandoen expose til automatisk at skabe de relevante Kubernetes-komponenter, såsom services og endpoints. Faktisk vil vi gøre netop dette ved at køre expose-kommandoen for vores deployment-objekt:
kubectl expose deployment hello-quarkus --type=NodePort --port=8080
Lad os tage et øjeblik til at stoppe op ved optionen "--type" i expose-kommandoen.
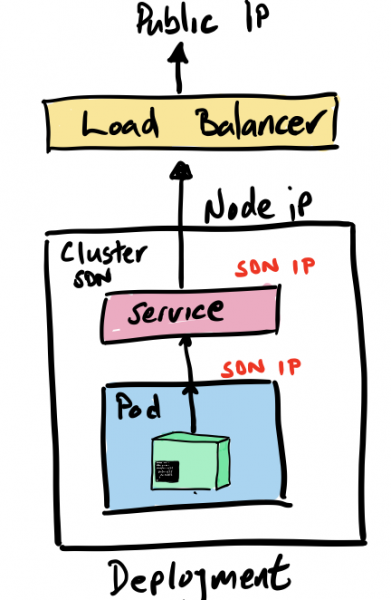
Når vi laver expose og skaber de komponenter, der er nødvendige for at køre vores service, skal vi blandt andet sørge for, at vi kan tilslutte til service hello-quarkus, som er inde i vores softwaredefinerede netværk. Og parameteren type giver os mulighed for at oprette og forbinde ting som belastningsafbalancere, så trafikken kan rutes til dette netværk.
For eksempel, ved at angive type=LoadBalancer, initierer vi automatisk en belastningsafbalancer i det offentlige cloud for at tilslutte til vores Kubernetes-klynge. Dette er selvfølgelig fantastisk, men det er vigtigt at forstå, at en sådan konfiguration vil være stift knyttet til en bestemt offentlig cloud og vil være sværere at flytte mellem Kubernetes-instanser i forskellige miljøer.
I vores eksempel type=NodePort, hvilket betyder, at anmodningen til vores service går via IP-adressen på noden og portnummeret. Denne løsning kræver ikke brug af offentlige skyer, men kræver en række ekstra skridt. For det første har vi brug for en egen load balancer, så vi vil implementere en NGINX load balancer i vores klynge.
Trin 6 - Installerer load balancer
Minikube har en række platformfunktioner, der gør det lettere at oprette de nødvendige komponenter til ekstern adgang, som f.eks. ingress- controllere. Minikube leveres med en Nginx ingress-controller, og vi skal bare aktivere og konfigurere den.
minikube addons enable ingress
Nu genererer vi med et enkelt kommando en Nginx ingress-controller, som vil køre inden i vores minikube klynge:
ingress-nginx-controller-69ccf5d9d8-j5gs9 1/1 Kører 1 33m
Trin 7 - Konfigurerer ingress
Nu skal vi konfigurere Nginx ingress-controlleren, så den kan håndtere anmodninger til hello-quarkus.
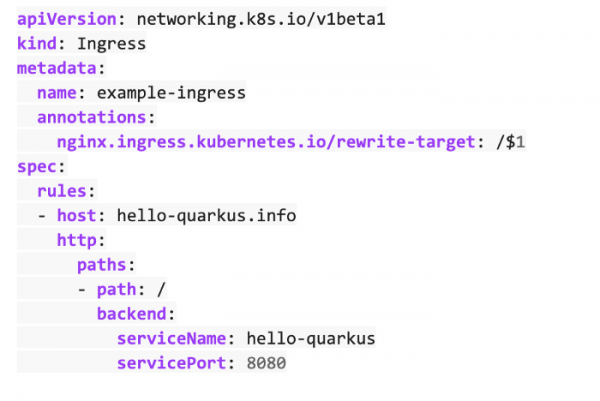
Og til sidst skal vi anvende denne konfiguration.
kubectl apply -f ingress.yml

Da vi gør alt dette på vores egen computer, tilføjer vi blot IP-adressen til vores node i filen /etc/hosts for at dirigere http-anmodninger til vores minikube via NGINX load balancer.
192.168.99.100 hello-quarkus.info
Nu er vores minikube service tilgængelig udefra gennem Nginx ingress-controlleren.
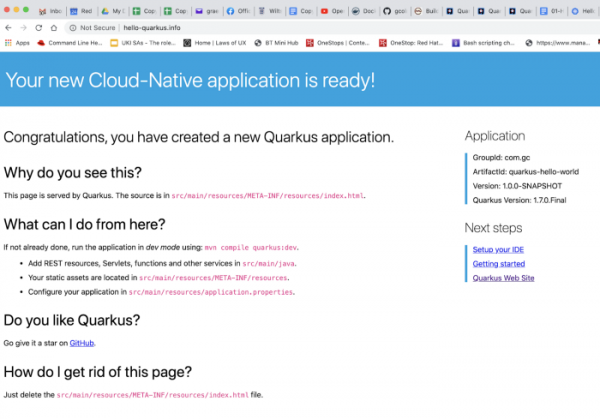
Nå, det var da nemt, ikke? Eller måske ikke så meget?
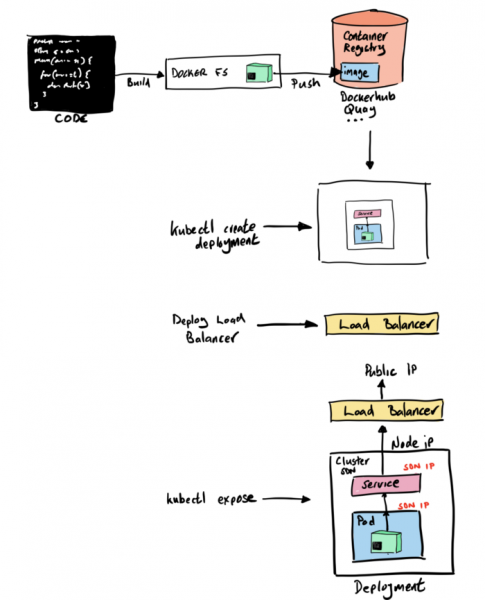
Kørsel på OpenShift (Code Ready Containers)
Og nu lad os se, hvordan det hele gøres på Red Hat OpenShift Container Platform (OCP).
Som med minikube vælger vi en en-nodesklynge OpenShift opsætning i form af Code Ready Containers (CRC). Tidligere kaldte man det minishift, og det var baseret på OpenShift Origin-projektet, men nu er det CRC, bygget på Red Hats OpenShift Container Platform.
Her kan vi, undskyld, ikke lade være med at sige: "OpenShift er fantastisk!"
I starten tænkte vi at skrive, at udvikling på OpenShift ikke adskiller sig fra udvikling på Kubernetes. Og det er i princippet korrekt. Men mens vi skrev dette indlæg kom vi i tanker om, hvor mange unødvendige skridt man skal tage, når man ikke har OpenShift, og derfor er det, som vi gentager, fantastisk. Vi elsker, når tingene er enkle, og hvor let vores eksempel kan implementeres og startes på OpenShift i forhold til minikube, er faktisk det, der inspirerede os til at skrive dette indlæg.
Lad os kaste et blik på processen og se, hvad vi skal gøre.
Så i eksemplet med minikube startede vi med Docker... Stop, vi har ikke brug for, at Docker er installeret på maskinen længere.
Og lokal git er ikke nødvendigt.
Og Maven er heller ikke nødvendigt.
Og det er ikke nødvendigt at oprette containerbilleder manuelt.
Og det er ikke nødvendigt at finde et containerbillede-repositorium.
Og det er ikke nødvendigt at installere en ingress-controller.
Og konfiguration af ingress er heller ikke nødvendigt.
Forstod du det, ikke? For at implementere og køre vores applikation på OpenShift, er intet af ovenstående nødvendigt. Selve processen ser sådan her ud.
Trin 1 – Start dit OpenShift-kluster
Vi bruger Code Ready Containers fra Red Hat, som i bund og grund er det samme som Minikube, men med et fuldt funktionelt enkelt-node OpenShift-kluster.
crc start
Trin 2 – Byg og implementer applikationen i OpenShift-klusteret
Netop på dette trin kommer enkelheden og bekvemmeligheden ved OpenShift virkelig til sin ret. Som med alle Kubernetes-distributioner har vi mange måder at køre applikationen i klusteret på. Og som med KUK vælger vi bevidst den absolut enkleste metode.
OpenShift har altid været bygget som en platform til at skabe og køre containerapplikationer. Bygningen af containere har altid været en uadskillelig del af denne platform, så der er en masse yderligere Kubernetes-ressourcer til relevante opgaver.
Vi vil bruge OpenShifts Source 2 Image (S2I) proces, som har flere forskellige metoder til at tage vores kildekode (kode eller binære filer) og omdanne den til et containerbillede, der kan køre i OpenShift-klusteret.
For dette har vi brug for to ting:
- Vores kildekode i et git-repositorium
- Et builder-billede, som bygningen vil blive udført på.
Der er mange sådanne billeder, der understøttes både af Red Hat og på fællesskabsniveau, og vi vil bruge OpenJDK-billedet, da jeg jo bygger en Java-applikation.
S2I-bygningen kan startes enten fra OpenShift Developer-grafikkonsollen eller fra kommandolinjen. Vi bruger kommandoen new-app og angiver, hvor vi skal tage builder-billedet og vores kildekode fra.
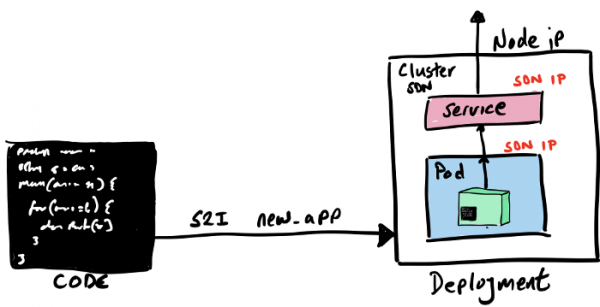
oc new-app registry.access.redhat.com/ubi8/openjdk-11:latest~https://github.com/gcolman/quarkus-hello-world.git
Det er det, vores applikation er oprettet. I denne proces udførte S2I følgende:
- Oprettede en service build-pod til forskellige opgaver relateret til applikationsbygning.
- Oprettede OpenShift Build-konfiguration.
- Downloadede builder-billedet til OpenShifts interne Docker-register.
- Klonede 'Hello World' til det lokale repository.
- Jeg så, at der var en maven pom, og derfor kompilerede jeg applikationen ved hjælp af maven.
- Oprettede et nyt containerbillede, der indeholder den kompilerede Java-applikation, og lagde dette billede i det interne containerregister.
- Oprettede en Kubernetes Deployment med specifikationer for pod, service osv.
- Udrullede containerbilledet.
- Slettede det midlertidige build-pod.
Der er mange elementer på denne liste, men det vigtigste er, at hele bygningen udelukkende sker inden for OpenShift, det interne Docker-register findes inden for OpenShift, og byggeprocessen skaber alle Kubernetes-komponenter og kører dem i klyngen.
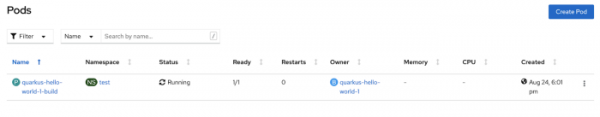
Hvis man visuelt følger opstarten af S2I i konsollen, kan man se, hvordan build-pod'en startes under udførelsen af bygningen.
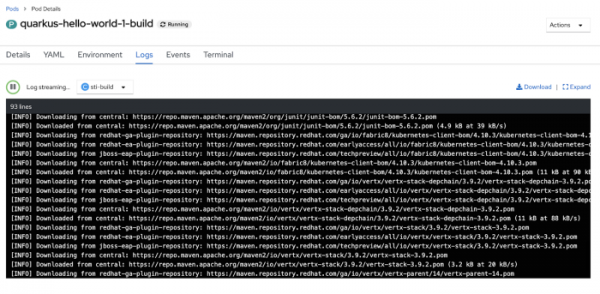
Og nu lad os se på loggen fra builder pod'en: for det første kan man se, hvordan maven udfører sit arbejde og henter afhængigheder til bygningen af vores java-applikation.
Efter at maven-bygningen er færdig, startes bygningen af containerbilledet, og derefter sendes det færdige billede til det interne repository.
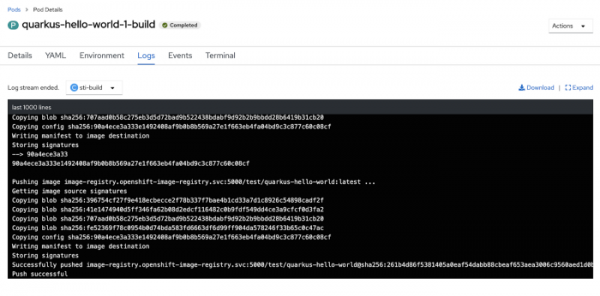
Det er det, processen er afsluttet. Lad os nu sikre os, at pod'erne og tjenesterne i vores applikation er startet op i klyngen.
oc get service
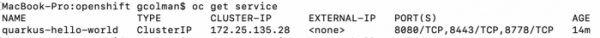
Sådan. Og kun én kommando. Vi skal bare eksponere denne service for adgang udefra.
Trin 3 – eksponering af servicen for adgang udefra
Som i tilfældet med KUK, skal vores 'Hello World' også have en router på OpenShift-platformen for at dirigere den eksterne trafik til servicen inden for klyngen. I OpenShift er dette meget enkelt. For det første er komponenten til routing HAProxy som standard installeret i klyngen (den kan ændres til NGINX). For det andet er der specielle ressourcer, der tilbyder omfattende konfigurationsmuligheder, kaldet Routes, som minder om Ingress-objekterne i det gode gamle Kubernetes (faktisk har OpenShift's Routes stærkt påvirket designet af Ingress-objekterne, som nu også kan bruges i OpenShift), men til vores 'Hello World' og næsten i alle andre tilfælde er den standard Route uden yderligere konfiguration tilstrækkelig.
For at oprette et routbart FQDN for 'Hello World' (ja, i OpenShift er der sin egen DNS for routing efter servicenavne), vil vi blot udføre eksponeringen for vores service:
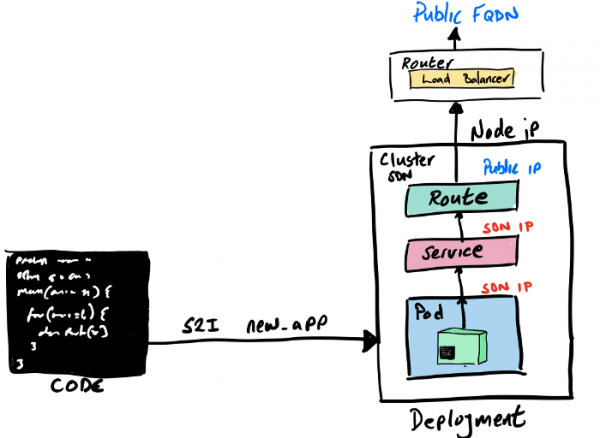
oc expose service quarkus-hello-world
Hvis vi kigger på den nyoprettede Route, kan vi finde FQDN og andre oplysninger om routing:
oc get route

Og endelig tilgår vi vores service fra en browser:
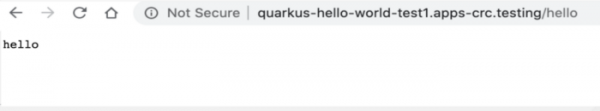
Og nu var det virkelig nemt!
Vi elsker Kubernetes og alt, hvad denne teknologi gør muligt, ligesom vi elsker enkelhed og lighed. Kubernetes blev skabt for at gøre drift af distribuerede, skalerbare containere utrolig nemt, men når det kommer til at implementere applikationer, er dens enkelhed i dag ikke længere tilstrækkelig. Og her træder OpenShift ind i billedet, som følger med tiden og tilbyder en Kubernetes, der primært er rettet mod udviklere. Der er gjort en stor indsats for at skræddersy OpenShift-platformen til udviklere, herunder oprettelse af værktøjer som S2I, ODI, Developer Portal, OpenShift Operator Framework, integration med IDE, Developer Catalogues, integration med Helm, overvågning og mange andre.
Vi håber, at denne artikel har været interessant og nyttig for dig. Du kan finde yderligere ressourcer, materialer og andre nyttige ting til udvikling på OpenShift-platformen på portalen .
Kilde: habr.com
