

I Vi har undersøgt RabbitMQ-klyngedannelse for at sikre fejltolerance og høj tilgængelighed. Lad os nu dykke dybere ned i Apache Kafka.
Her er en reproduktionsenhed en partition. Hver topic har en eller flere partitioner. I hver partition er der en leder med eller uden følgere. Ved oprettelse af en topic angives antallet af partitioner og reproduktionsfaktoren. Den normale værdi er 3, hvilket betyder tre replikaer: en leder og to følgere.
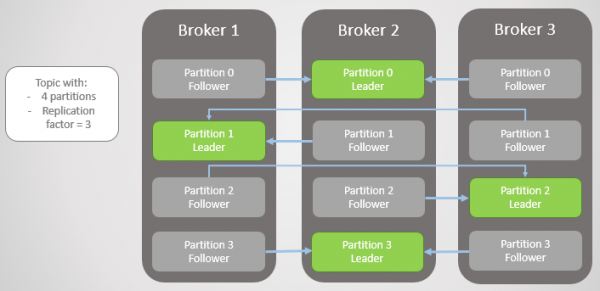
Fig. 1. Fire partitioner er fordelt mellem tre mæglere.
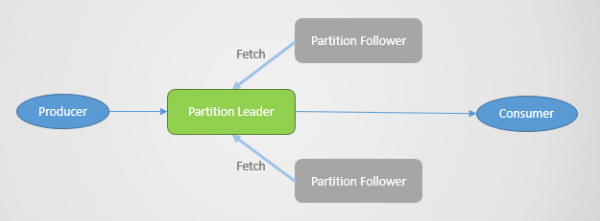
Alle læse- og skriveanmodninger går til lederen. Følgerne sender regelmæssigt anmodninger til lederen om at modtage de seneste beskeder. Forbrugere henvender sig aldrig til følgerne; de sidstnævnte eksisterer kun for redundans og fejltolerance.
Partitionsfejl
Når en mægler falder ud, stopper lederne af flere partitioner ofte med at fungere. I hver af dem bliver en følger fra en anden node leder. Dette er dog ikke altid tilfældet, da synkroniseringsfaktoren også spiller ind: om der er synkroniserede følgere, og hvis der ikke er, om overgangen til en usynkroniseret replika er tilladt. Men lad os ikke gøre det mere kompliceret.
Broker 3 falder ud af netværket — og for partition 2 vælges en ny leder på broker 2.
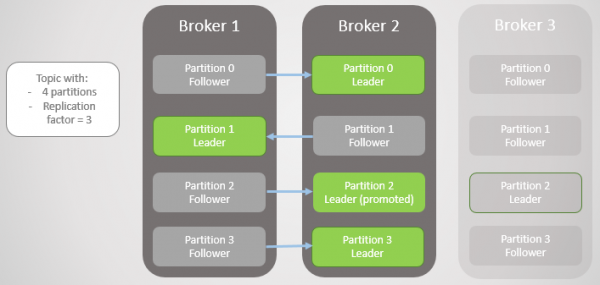
Fig. 2. Broker 3 dør, og dens følger på broker 2 vælges som ny leder for partition 2.
Derefter falder broker 1 ud, og partition 1 mister også sin leder; rollen overgår til broker 2.
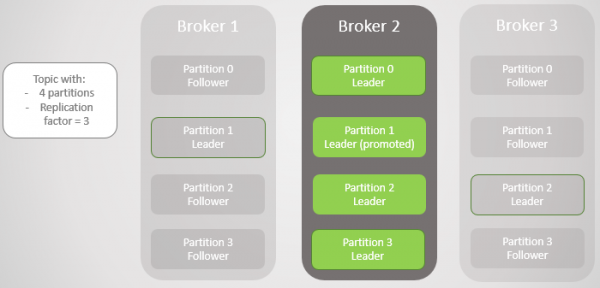
Fig. 3. Der er kun én broker tilbage. Alle ledere er på samme broker med nul redundans.
Når broker 1 vender tilbage til netværket, tilføjer den fire følgere, hvilket sikrer noget redundans til hver partition. Men alle ledere forbliver stadig på broker 2.
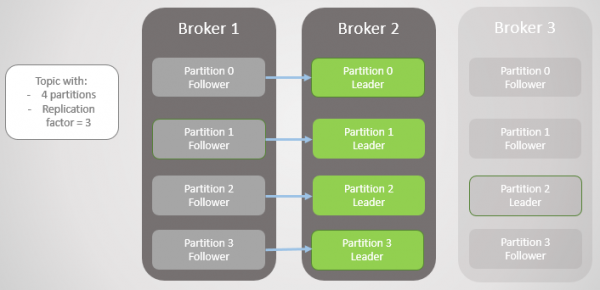
Fig. 4. Lederne forbliver på broker 2.
Når broker 3 genstartes, vender vi tilbage til tre replikaer pr. partition. Men alle ledere forbliver stadig på broker 2.
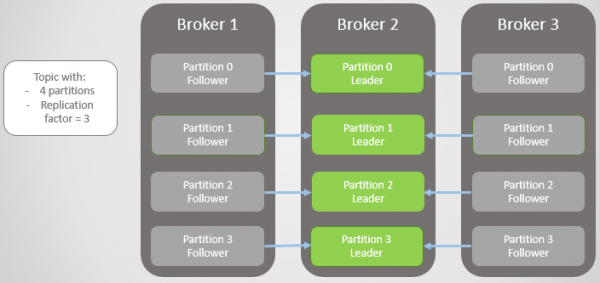
Fig. 5. Ubalanceret placering af lederne efter genopretning af brokerne 1 og 3.
Kafka har et værktøj til en mere fintfølende genbalancering af ledere end RabbitMQ. Der måtte bruges et tredjepartsplugin eller script, der ændrede politikkerne for migration af hovednoden ved at reducere redundansen under migreringen. Desuden måtte der accepteres utilgængelighed under synkroniseringen for store køer.
Kafka har et koncept med "foretrukne replikaer" til lederrollen. Når der oprettes partitioner af et emne, forsøger Kafka at fordele lederne jævnt over noderne og markerer disse første ledere som foretrukne. Over tid kan lederne på grund af servergenstarter, fejl og forbindelse problemer befinde sig på andre noder, som i det ovenfor beskrevne ekstreme tilfælde.
For at rette op på dette tilbyder Kafka to muligheder:
- Mulighed auto.leader.rebalance.enable=true tillader kontrolnoden automatisk at genindse lederne til de foretrukne replikaer og dermed genoprette en jævn fordeling.
- En administrator kan køre skriptet kafka-preferred-replica-election.sh for at omfordele manuelt.
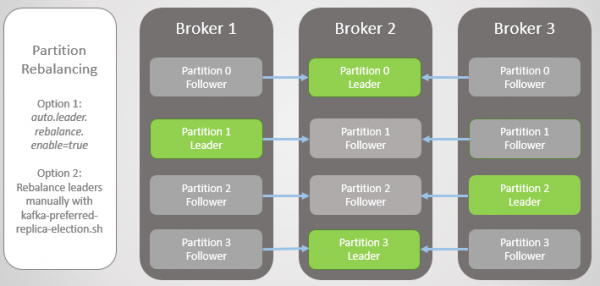
Fig. 6. Replikater efter ombalancering
Dette var en forenklet version af fejlen, men virkeligheden er mere kompleks, selvom intet her er for kompliceret. Det hele drejer sig om synkroniserede replikaer (In-Sync Replicas, ISR).
Synkroniserede replikaer (ISR)
ISR er et sæt replikater af en partition, der betragtes som "synkroniseret". Her er der en leder, mens der måske ikke er nogen følgere. En følger betragtes som synkroniseret, hvis den har taget nøjagtige kopier af alle lederens meddelelser inden for intervallet replica.lag.time.max.ms.
En følger fjernes fra ISR-sættet, hvis den:
- ikke har anmodet om at hente inden for intervallet replica.lag.time.max.ms (betegnes som død)
- ikke har haft tid til at opdatere sig inden for intervallet replica.lag.time.max.ms (betegnes som langsom)
Følgere anmoder om at hente inden for intervallet replica.fetch.wait.max.ms, som som standard er 500 ms.
For klart at forklare formålet med ISR, skal vi se på bekræftelser fra producenten (producer) og nogle fejlscenarier. Producenterne kan vælge, hvornår brokerne sender bekræftelse:
- acks=0, bekræftelse sendes ikke
- acks=1, bekræftelse sendes, efter at lederen har skrevet meddelelsen til sin lokale log
- acks=all, bekræftelse sendes, efter at alle replikaer i ISR har skrevet meddelelsen til deres lokale logs
I Kafka-terminologi, hvis ISR har bevaret meddelelsen, forekommer dens "commit". Acks=all er den sikreste mulighed, men det medfører også en ekstra forsinkelse. Lad os overveje to eksempler på fejl og hvordan forskellige 'acks'-indstillinger interagerer med ISR-konceptet.
Acks=1 og ISR
I dette eksempel vil vi se, at hvis lederen ikke venter på at gemme hver besked fra alle følgere, kan der opstå datatab ved lederfejl. Overgang til en usynkroniseret follower kan tillades eller forhindres ved indstilling unclean.leader.election.enable.
I dette eksempel er acks=1 indstillet hos producenten. Partitionen er fordelt over de tre mæglere. Broker 3 er forsinket; han synkroniserede med lederen for otte sekunder siden og er nu forsinket med 7456 beskeder. Broker 1 er kun forsinket med en sekund. Vores producent sender en besked og modtager hurtigt et ack tilbage uden overhead fra langsomme eller døde følgere, som lederen ikke venter på.
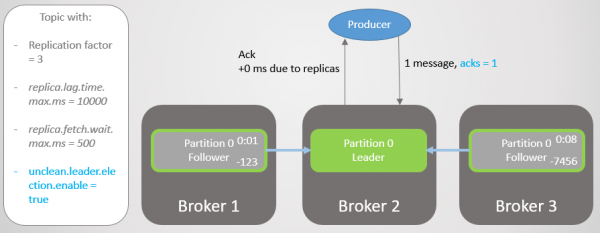
Fig. 7. ISR med tre replikaer
Broker 2 fejler, og producenten modtager en forbindelsefejl. Efter overgangen til lederskabet til broker 1 mister vi 123 beskeder. Followeren på broker 1 var en del af ISR, men blev ikke helt synkroniseret med lederen, da han faldt.
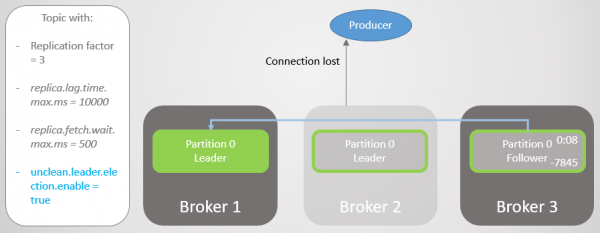
Fig. 8. Beskeder går tabt ved fejl
I konfigurationen bootstrap.servers er der angivet flere mæglere hos producenten, og han kan spørge en anden mægler, hvem der blev den nye leder af partitionen. Derefter opretter han forbindelse til broker 1 og fortsætter med at sende beskeder.
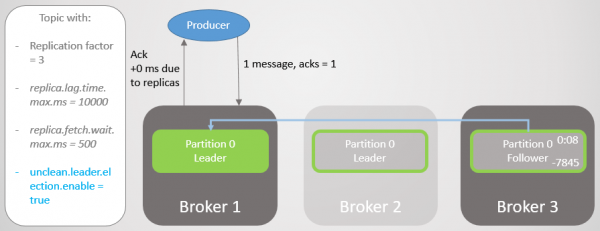
Fig. 9. Sending af beskeder genoptages efter en kort pause
Broker 3 er endnu mere forsinket. Han anmoder om data, men kan ikke synkronisere. Dette kan skyldes en langsom netværksforbindelse mellem mæglere, lagringsproblemer osv. Han fjernes fra ISR. Nu består ISR kun af en replika – lederen! Producenten fortsætter med at sende beskeder og modtage bekræftelser.
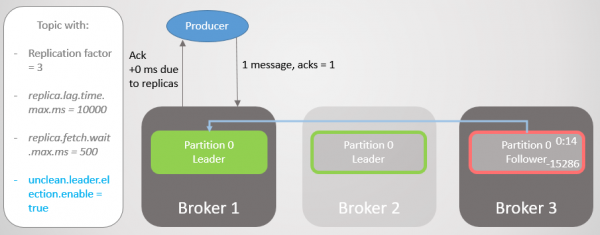
Fig. 10. Follower på broker 3 fjernes fra ISR
Broker 1 falder, og lederrollen går til broker 3 med et tab på 15286 beskeder! Producenten modtager en fejlmeddelelse. Overgangen til en leder uden for ISR var kun muligt på grund af indstillingen unclean.leader.election.enable=true. Hvis denne er indstillet til false, ville overgangen ikke være sket, og alle læse- og skriveanmodninger ville være blevet afvist. I så fald venter vi på, at broker 1 kommer tilbage med sine intakte data i den replika, der igen vil tage lederskabet.
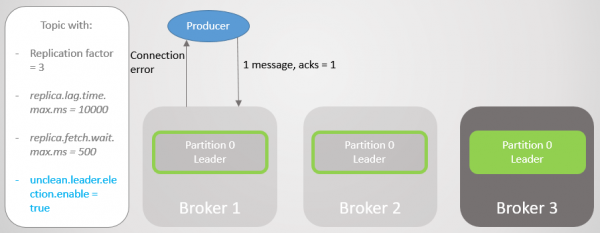
Fig. 11. Broker 1 falder. Et stort antal beskeder går tabt ved fejl
Producenten opretter forbindelse til den seneste broker og ser, at denne nu er leder af sektionen. Han begynder at sende meddelelser til broker 3.
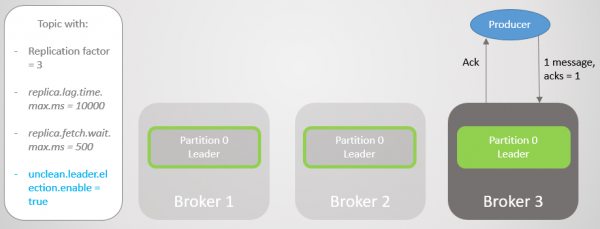
Fig. 12. Efter en kort pause sendes meddelelserne igen til sektion 0
Vi har set, at producenten konstant har sendt meddelelser, bortset fra de korte pauser til at etablere nye forbindelser og finde en ny leder. Denne konfiguration sikrer tilgængelighed gennem konsistens (datasikkerhed). Kafka har mistet tusindvis af meddelelser, men fortsatte med at modtage nye poster.
Acks=all og ISR
Lad os gentage dette scenarie igen, men med acks=all. Broker 3 har i gennemsnit en forsinkelse på fire sekunder. Producenten sender en meddelelse med acks=all, og får nu ikke et hurtigt svar. Lederen venter, indtil meddelelsen er gemt af alle replikaer i ISR.
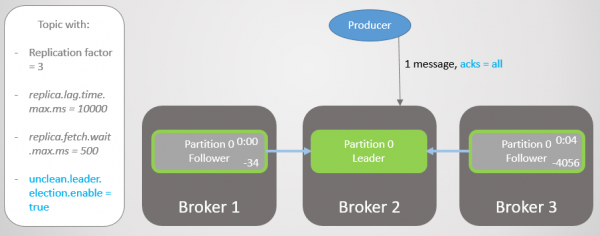
Fig. 13. ISR med tre replikaer. Én arbejder langsomt, hvilket medfører en forsinkelse i skrivningen.
Efter fire sekunders ekstra forsinkelse sender broker 2 ack. Alle replikaer er nu helt opdaterede.
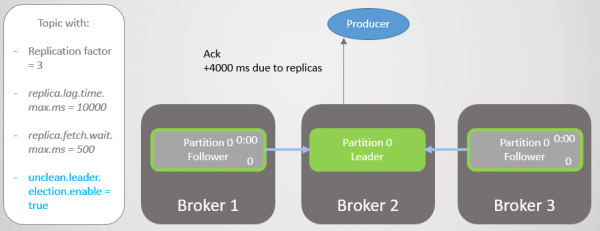
Fig. 14. Alle replikaer gemmer meddelelser og sender ack
Broker 3 er nu endnu mere bagud og fjernes fra ISR. Forsinkelsen mindskes betydeligt, da der ikke er nogen langsomme replikaer tilbage i ISR. Broker 2 venter nu kun på broker 1, som har en gennemsnitlig forsinkelse på 500 ms.
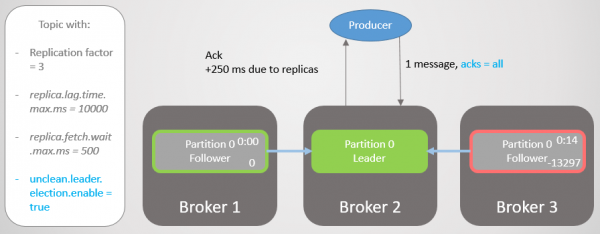
Fig. 15. Replica på broker 3 fjernes fra ISR
Så falder broker 2, og lederskabet går til broker 1 uden tab af meddelelser.
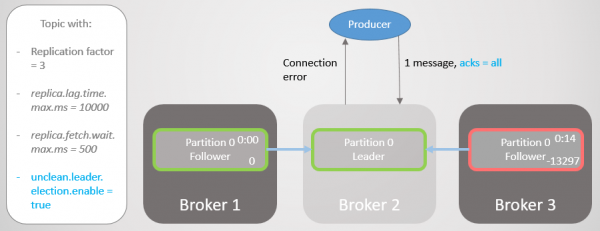
Fig. 16. Broker 2 falder
Producenten finder en ny leder og begynder at sende meddelelser til ham. Forsinkelsen bliver endnu mindre, da ISR nu kun består af én replik! Derfor tilføjer optionen acks=all ingen redundans.
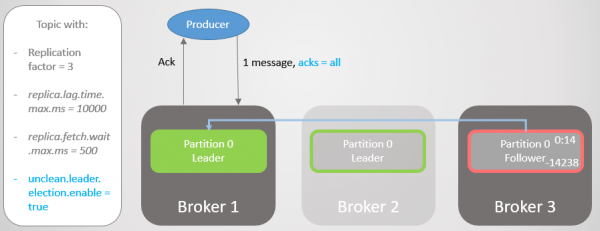
Fig. 17. Replica på broker 1 overtager lederskabet uden tab af meddelelser
Så falder broker 1, og lederskabet går til broker 3 med et tab på 14238 meddelelser!
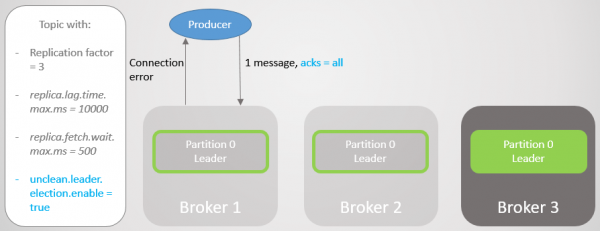
Fig. 18. Broker 1 dør, og overgangen af lederskab med indstillingen unclean fører til omfattende datatab
Vi kunne have undgået at indstille optionen unclean.leader.election.enable til værdien true. Som standard er den lig med false. Indstillingen acks=all med unclean.leader.election.enable=true sikrer tilgængelighed med en vis ekstra datasikkerhed. Men som du kan se, kan vi stadig miste meddelelser.
Men hvad nu, hvis vi ønsker at øge datasikkerheden? Vi kan indstille unclean.leader.election.enable = false, men det beskytter os ikke nødvendigvis mod datatab. Hvis lederen falder hårdt og medfører datatab, vil beskederne stadig gå tabt, plus adgangen går tabt, indtil administratoren genopretter situationen.
Det er bedre at garantere redundans for alle beskeder, eller i modsat fald at afvise optagelsen. Så kan tab af data fra brokerens synspunkt kun ske ved to eller flere samtidige fejlagtigheder.
Acks=all, min.insync.replicas og ISR
Med konfigurationen af emnet min.insync.replicas øger vi datasikkerheden. Lad os endnu en gang gennemgå den sidste del af det tidligere scenarie, men denne gang med min.insync.replicas=2.
Så broker 2 har en leder replika, og følgesvennen på broker 3 er blevet fjernet fra ISR.
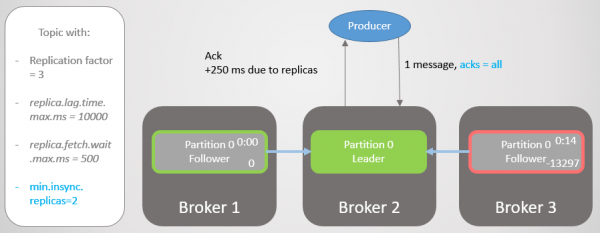
Fig. 19. ISR bestående af to replikaer
Broker 2 falder, og lederskabet overgår til broker 1 uden tab af beskeder. Men nu består ISR kun af én replika. Det lever ikke op til minimumsantalet for optagelse, og derfor svarer broker på forsøget på optagelse med en fejl. NotEnoughReplicas.
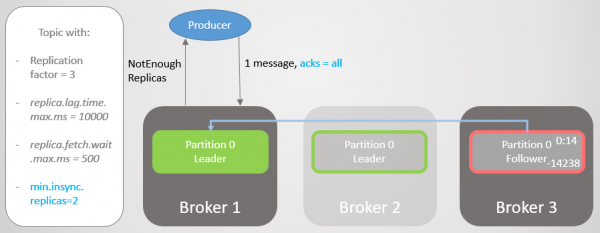
Fig. 20. Antallet af ISR er en mindre end angivet i min.insync.replicas
Denne konfiguration ofrer tilgængelighed til fordel for konsistens. Før vi bekræfter en besked, sikrer vi, at den optages på mindst to replikaer. Dette giver producenten meget større tillid. Her er tab af beskeder kun muligt, hvis to replikaer fejler samtidigt i et kort øjeblik, mens beskeden ikke er replikeret til en ekstra følgesvend, hvilket er usandsynligt. Men hvis du er superparanoid, kan du sætte replikationsforholdet til 5, og min.insync.replicas så på 3. Her skal tre brokere falde samtidig for at miste optagelsen! Naturligvis vil du betale ekstra forsinkelse for en sådan pålidelighed.
Når tilgængelighed er nødvendig for databeskyttelse
Som i , nogle gange er tilgængelighed nødvendig for databeskyttelse. Du skal tænke over dette:
- Kan udgiveren blot returnere en fejl, og kan den overordnede tjeneste eller bruger forsøge igen senere?
- Kan en udgiver gemme meddelelsen lokalt eller i en database, så den kan forsøge igen senere?
Hvis svaret er nej, så øger optimering af tilgængelighed datasikkerheden. Du taber mindre data, hvis du vælger tilgængelighed frem for at afvise optagelsen. Så alt handler om at finde balancen, og løsningen afhænger af den konkrete situation.
Meningen med ISR
ISR-sættet giver mulighed for at vælge den optimale balance mellem databeskyttelse og forsinkelse. For eksempel at sikre tilgængelighed under svigt af de fleste replikaer, mens man minimerer indflydelsen fra døde eller langsomme replikaer med hensyn til forsinkelse.
Vi vælger selv værdien replica.lag.time.max.ms i overensstemmelse med vores behov. I bund og grund betyder denne parameter, hvor stor en forsinkelse vi er villige til at acceptere ved acks=all. Standardværdien er ti sekunder. Hvis det er for lang tid for dig, kan du reducere den. Så vil hyppigheden af ændringer i ISR stige, da følgere vil blive fjernet og tilføjet oftere.
I RabbitMQ drejer det sig blot om et sæt spejle, der skal replikeres. Langsame spejle fører til ekstra forsinkelse, og man kan vente på responsen fra døde spejle op til udløbet af livstiden for pakkerne, der kontrollerer tilgængeligheden af hver node (net tick). ISR er en interessant måde at undgå disse problemer med øget forsinkelse. Men vi risikerer at miste redundans, da ISR kun kan reduceres til lederen. For at undgå denne risiko, brug indstillingen min.insync.replicas.
Klientforbindelsesgaranti
I indstillingerne bootstrap.servers for producent og forbruger, kan man angive flere mæglere til klientens forbindelse. Ideen er, at når en node er nede, er der stadig flere backup-noder, som klienten kan oprette forbindelse til. Det er ikke nødvendigvis lederne af partitionerne, men blot en platform for den indledende indlæsning. Klienten kan spørge dem, hvilken node lederpartitionen til læsning/skrivning er placeret på.
I RabbitMQ kan klienterne forbinde til enhver node, og den interne router sender anmodningen det rigtige sted hen. Dette betyder, at du kan placere en load balancer foran RabbitMQ. Kafka kræver, at klienterne forbinder til den node, hvor lederen af den relevante partition er placeret. I denne situation kan man ikke placere en load balancer. Listen bootstrap.servers er kritisk for, at klienterne kan henvende sig til de rigtige noder og finde dem efter en fejl.
Kafka-konsensusarkitektur
Indtil nu har vi ikke set på, hvordan klyngen opdager, at en mæglersystem er nede, og hvordan der vælges en ny leder. For at forstå, hvordan Kafka arbejder med netværksopdelinger, skal man først forstå konsensusarkitekturen.
Hver Kafka-klynge implementeres sammen med en Zookeeper-klynge – en service til distribueret konsensus, der muliggør, at systemet opnår konsensus om en bestemt tilstand med prioritet for konsistens over tilgængelighed. For at godkende læse- og skriveoperationer kræves der enighed fra flertallet af Zookeeper-noderne.
Zookeeper opretholder klyngets tilstand:
- En liste over emner, partitioner, konfiguration, nuværende lederreplikater, foretrukne replikater.
- Medlemmer af klyngen. Hver broker pinger Zookeeper-klyngen. Hvis Zookeeper ikke modtager et ping inden for en bestemt tidsramme, registrerer det brokeren som utilgængelig.
- Valg af primære og sekundære noder til controlleren.
Controller-noden er en af Kafka-brokerne, der er ansvarlig for valg af lederreplikater. Zookeeper sender notifikationer til controlleren om medlemskab i klyngen og ændringer af emner, og controlleren skal handle i overensstemmelse med disse ændringer.
For eksempel, lad os tage et nyt emne med ti partitioner og en replikationsfaktor på 3. Controlleren skal vælge lederen for hver partition, idet den forsøger at optimere fordelingen af ledere mellem brokeren.
For hver partition skal controlleren:
- opdatere oplysningerne i Zookeeper om ISR og lederen;
- sende en LeaderAndISRCommand-kommando til hver broker, der har en replikation af denne partition, og informere brokerne om ISR og lederen.
Når en broker med en leder falder, sender Zookeeper en notifikation til controlleren, som derefter vælger en ny leder. Igen opdaterer controlleren først Zookeeper, før den sender kommandoen til hver broker og informerer dem om ændringen i lederskabet.
Hver leder er ansvarlig for et sæt ISR. Konfigurationen replica.lag.time.max.ms definerer, hvem der skal inkluderes. Når ISR ændres, sender lederen nye oplysninger til Zookeeper.
Zookeeper er altid informeret om eventuelle ændringer, så i tilfælde af en fejl overgår ledelsen glat til den nye leder.
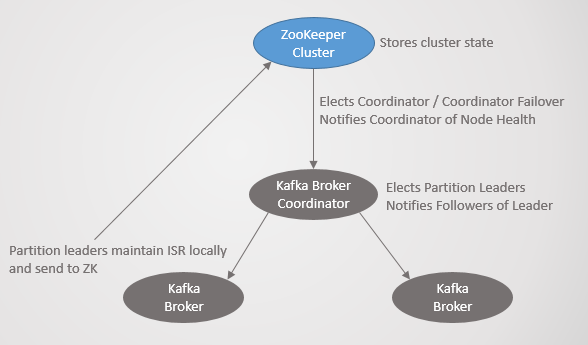
Fig. 21. Kafka-konsensus
Replikationsprotokol
At forstå detaljerne i replikation hjælper med bedre at forstå potentielle scenarier for datatab.
Forespørgsler om hentning, Log End Offset (LEO) og Highwater Mark (HW)
Vi har gennemgået, hvordan følgere periodisk sender anmodninger til lederen om hentning (fetch). Standardintervallet er 500 ms. Dette adskiller sig fra RabbitMQ, hvor replikering initieres af masteren, ikke af køens spejl. Masteren sender ændringer til spejlene.
Lederen og alle følgere gemmer loggens slutoffset (Log End Offset, LEO) og Highwater-mærket (HW). LEO-mærket gemmer offset for den seneste besked i den lokale replika, mens HW gemmer offset for den seneste commit. Husk, at for status som «commit» skal beskeden være gemt i alle repliker i ISR. Dette betyder, at LEO normalt lidt foran HW.
Når lederen modtager en besked, gemmer han den lokalt. Følgeren anmoder om hentning ved at overføre sin LEO. Derefter sender lederen et beskedpakke, der starter fra denne LEO, og overfører det aktuelle HW. Når lederen får information om, at alle replikas har gemt beskeden med det angivne offset, flytter han HW-mærket. Kun lederen kan flytte HW, og således får alle følgere at vide den aktuelle værdi i svarene på deres anmodninger. Dette betyder, at følgere kan være bagud både med hensyn til beskeder og viden om HW. Forbrugere modtager beskeder kun indtil det aktuelle HW.
Bemærk, at «gemt» (persisted) betyder optaget i hukommelsen, ikke på disken. For at sikre ydeevne synkroniserer Kafka til disken med et bestemt interval. RabbitMQ har også et sådant interval, men det sender en bekræftelse til publishere først efter, at master og alle spejle har gemt beskeden på disken. Kafka-udviklere har af hensyn til ydeevnen besluttet at sende ack, så snart beskeden er gemt i hukommelsen. Kafka satser på, at redundans kompenserer for risikoen ved kortvarig opbevaring af bekræftede beskeder kun i hukommelsen.
Lederfejl
Når lederen fejler, informerer Zookeeper controlleren, som vælger en ny leder-replika. Den nye leder fastsætter et nyt HW-mærke i overensstemmelse med sin LEO. Derefter modtager følgere information om den nye leder. Afhængigt af Kafka-versionen vælger følgere en af to scenarier:
- Afskærer den lokale log til det kendte HW og sender en anmodning til den nye leder om beskeder efter dette mærke.
- Sender en anmodning til lederen for at finde HW på det tidspunkt, hvor han blev valgt som leder, og derefter trimme loggen til denne offset. Derefter begynder den at lave periodiske forespørgsler om udtræk, der starter fra denne offset.
En follower kan være nødt til at trimme loggen af følgende grunde:
- Når en leder fejler, vinder den første follower fra ISR-sættet, der er registreret i Zookeeper, valget og bliver leder. Alle followers i ISR betragtes som "synkroniserede", men de har måske ikke modtaget kopier af alle meddelelser fra den tidligere leder. Det er muligt, at den valgte follower ikke har den mest opdaterede kopi. Kafka sikrer, at der ikke er uoverensstemmelser mellem replikaerne. For at undgå uoverensstemmelser skal hver follower trimme sin log til HW-værdien for den nye leder på det tidspunkt, de blev valgt. Dette er endnu en grund til, hvorfor konfigurationen acks=all er vigtig for konsistens.
- Meddelelser skrives periodisk til disk. Hvis alle noder i klyngen svigter samtidigt, vil replikaerne på diske have forskellige offsets. Det er muligt, at når brokerne igen vender tilbage til netværket, vil den nye leder, der vælges, være bag sine followers, fordi den blev gemt til disk tidligere end de andre.
Genforbindelse med klyngen
Ved genforbindelse med klyngen optræder replikaerne ligesom ved lederfejl: de tjekker lederen og trimmer deres log til dens HW (på tidspunktet for valget). Til sammenligning opfatter RabbitMQ genforbundne noder som helt nye. I begge tilfælde smider brokeren enhver eksisterende tilstand væk. Hvis automatisk synkronisering bruges, skal masteren replikere alt det nuværende indhold til det nye spejl med metoden "og lad hele verden vente". Under denne operation accepterer masteren ingen læse- eller skriveoperationer. Denne tilgang skaber problemer i store køer.
Kafka er en distribueret log, og generelt opbevarer den flere meddelelser end RabbitMQ, hvor data fjernes fra køen efter læsning. Aktive køer bør forblive relativt små. Men Kafka er en log med sin egen opbevaringspolitik, som kan fastsætte en periode i dage eller uger. Taktikken med at låse køen og fuld synkronisering er helt uacceptabel for en distribueret log. I stedet beskærer Kafka-følgere simpelthen deres log til HW-lederen (på tidspunktet for dens valg), hvis deres kopi er foran lederen. I det mere sandsynlige tilfælde, hvor følgere er bagud, begynder de blot at anmode om optagelser, startende fra deres nuværende LEO.
Nye eller genforenede følgere starter uden for ISR og deltager ikke i commits. De arbejder blot sideløbende med gruppen og modtager meddelelser så hurtigt som muligt, indtil de indhenter lederen og kommer ind i ISR. Der er ingen låsning, og der er ikke behov for at kaste alle dine data væk.
Netværkstilkoblingsbrud
Kafka har flere komponenter end RabbitMQ, så der er et mere komplekst sæt adfærd, når der opstår forbindelsesbrud i klyngen. Men Kafka blev oprindeligt designet til klynger, så løsningerne er meget velovervejede.
Her er nogle scenarier med forbindelsesbrud:
- Scenarie 1. Følgeren ser ikke lederen, men ser stadig Zookeeper.
- Scenarie 2. Lederen ser ingen følgere, men ser stadig Zookeeper.
- Scenarie 3. Følgeren ser lederen, men ser ikke Zookeeper.
- Scenarie 4. Lederen ser følgere, men ser ikke Zookeeper.
- Scenarie 5. Følgeren er helt adskilt fra både andre Kafka-noder og Zookeeper.
- Scenarie 6. Lederen er helt adskilt fra både andre Kafka-noder og Zookeeper.
- Scenarie 7. Kafka-controllerens node ser ikke en anden Kafka-node.
- Scenarie 8. Kafka-controlleren ser ikke Zookeeper.
Hver scenarie har sit eget adfærdsmønster.
Scenarie 1. Følgeren ser ikke lederen, men ser stadig Zookeeper
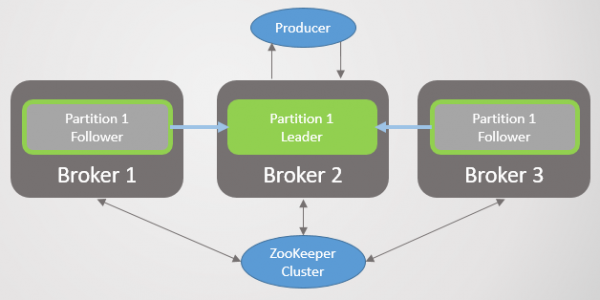
Fig. 22. Scenarie 1. ISR med tre replikaer
Forbindelsesbrud frakobler broker 3 fra broker 1 og 2, men ikke fra Zookeeper. Broker 3 kan ikke længere sende anmodninger om optagelser. Efter tidens udløb replica.lag.time.max.ms Han fjernes fra ISR og deltager ikke i meddelelsescommits. Så snart forbindelsen er genoprettet, vil han genoptage forespørgsler om hentning og slutte sig til ISR, når han når lederens niveau. Zookeeper vil fortsætte med at modtage pings og betragte broker som levende og rask.
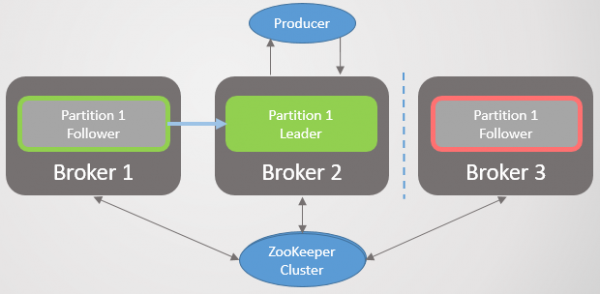
Fig. 23. Scenarie 1. Broker fjernes fra ISR, hvis der ikke er modtaget en forespørgsel om hentning fra ham inden for intervallet replica.lag.time.max.ms
Der er ingen logisk opdeling (split-brain) eller nedsættelse af en node, som i RabbitMQ. I stedet reduceres redundansen.
Scenarie 2. Lederen ser ingen følgere, men ser stadig Zookeeper
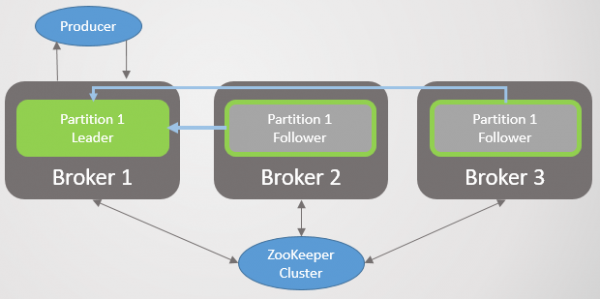
Fig. 24. Scenarie 2. Leder og to følgere
Brud på netværksforbindelsen adskiller lederen fra følgerne, men broker ser stadig Zookeeper. Ligesom i det første scenarie komprimeres ISR, men denne gang kun til lederen, da alle følgere holder op med at sende forespørgsler om hentning. Igen er der ingen logisk opdeling. I stedet sker der tab af redundans for nye meddelelser, indtil forbindelsen er genoprettet. Zookeeper fortsætter med at modtage pings og betragter broker som levende og rask.
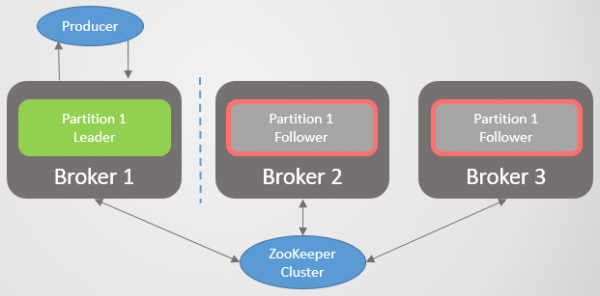
Fig. 25. Scenarie 2. ISR er kun komprimeret til lederen
Scenarie 3. Følger ser lederen, men ser ikke Zookeeper
Følgeren adskilles fra Zookeeper, men ikke fra broker med lederen. Som et resultat fortsætter følgeren med at lave forespørgsler om hentning og være medlem af ISR. Zookeeper modtager ikke længere pings og registrerer nedbruddet af broker, men da det kun er en følger, er der ingen konsekvenser efter genoprettelsen.
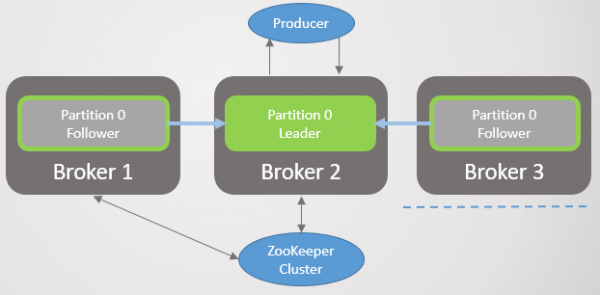
Fig. 26. Scenarie 3. Følgeren fortsætter med at sende forespørgsler om hentning til lederen
Scenarie 4. Lederen ser følgere, men ser ikke Zookeeper
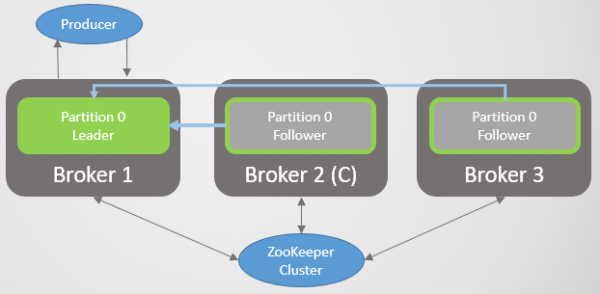
Fig. 27. Scenarie 4. Leder og to følgere
Lederen er adskilt fra Zookeeper, men ikke fra brokerne med følgerne.
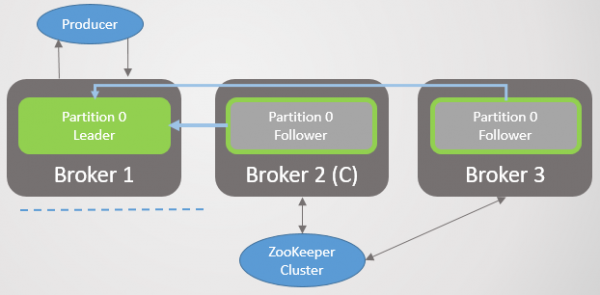
Fig. 28. Scenarie 4. Lederen er isoleret fra Zookeeper
Efter noget tid vil Zookeeper registrere nedbruddet af broker og informere controlleren. Denne vil vælge en ny leder blandt følgerne. Men den oprindelige leder vil fortsætte med at tro, at han er lederen og vil fortsætte med at modtage indtastninger med acks=1. Følgerne sender ikke længere forespørgsler om hentning, så han vil anse dem for døde og forsøge at komprimere ISR til sig selv. Men da han ikke har forbindelse til Zookeeper, vil han ikke være i stand til at gøre dette, og i dette øjeblik vil han opgive yderligere modtagelse af indtastninger.
Meddelelser acks=all de vil ikke få bekræftelse, fordi ISR først inkluderer alle replikaer, og beskederne når ikke frem til dem. Når den oprindelige leder forsøger at fjerne dem fra ISR, vil han ikke kunne gøre det og stoppe med at modtage nogen beskeder overhovedet.
Kunderne vil snart bemærke lederen, der skifter, og begynder at sende optegnelser til den nye server. Så snart netværket er genoprettet, vil den oprindelige leder se, at han ikke længere er leder, og skære sin log ned til den HW-værdi, den nye leder havde på tidspunktet for nedbruddet for at undgå logforskelle. Derefter vil han begynde at sende forespørgsler til den nye leder. Alle optegnelser fra den oprindelige leder, der ikke er replikeret til den nye leder, vil gå tabt. Det vil sige, at beskeder, der ikke er bekræftet af den oprindelige leder i de sekunder, hvor der var to ledere, vil gå tabt.
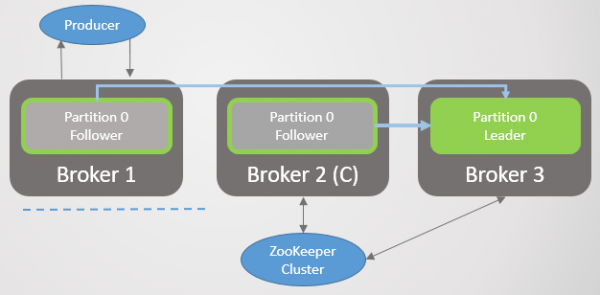
Fig. 29. Scenarie 4. Lederen på broker 1 bliver følger efter netværksgenopretningen
Scenarie 5. Følgeren er helt adskilt fra både andre Kafka-noder og Zookeeper
Følgeren er helt isoleret fra både andre Kafka-noder og Zookeeper. Han fjernes simpelthen fra ISR, indtil netværket er genoprettet, og så indhenter han de andre.

Fig. 30. Scenarie 5. Isoleret følger fjernes fra ISR
Scenarie 6. Lederen er helt adskilt fra både andre Kafka-noder og Zookeeper
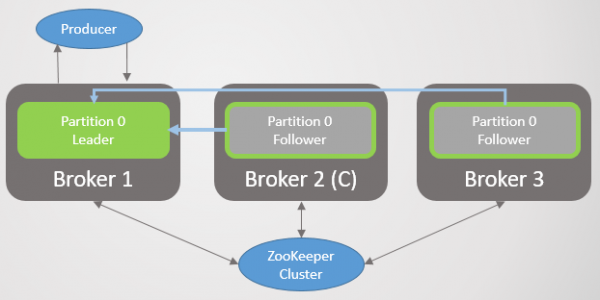
Fig. 31. Scenarie 6. Lederen og to følgere
Lederen er helt isoleret fra sine følgere, controlleren og Zookeeper. I en kort periode vil han fortsætte med at modtage optegnelser fra acks=1.
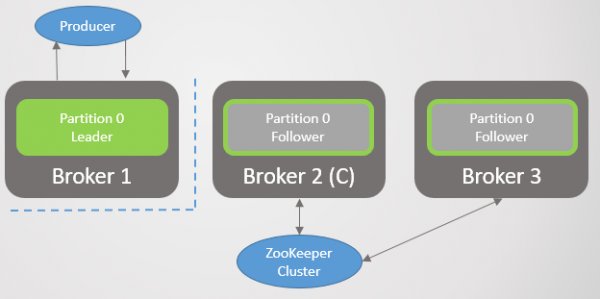
Fig. 32. Scenarie 6. Isolation af lederen fra andre Kafka-noder og Zookeeper
Uden at modtage forespørgsler efter udløbet replica.lag.time.max.ms, vil han forsøge at komprimere ISR til sig selv, men kan ikke gøre det, da der ikke er forbindelse til Zookeeper, hvorefter han stopper med at modtage optegnelser.
I mellemtiden vil Zookeeper markere den isolerede broker som død, og controlleren vil vælge en ny leder.
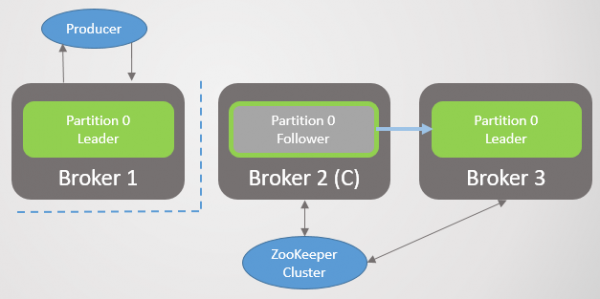
Fig. 33. Scenarie 6. To ledere
Den oprindelige leder kan modtage optegnelser i et par sekunder, men stopper derefter med at modtage nogen beskeder. Kunderne opdateres hvert 60. sekund med de seneste metadata. De vil blive informeret om lederens skift og begynde at sende optegnelser til den nye leder.
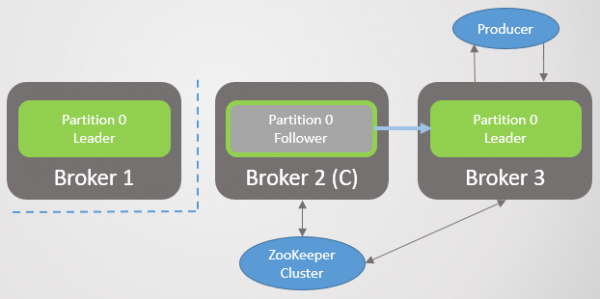
Fig. 34. Scenarie 6. Producenterne skifter til den nye leder
Alle bekræftede optegnelser lavet af den oprindelige leder vil gå tabt fra det tidspunkt, hvor forbindelsen blev tabt. Når netværket er genoprettet, vil den oprindelige leder opdage gennem Zookeeper, at han ikke længere er leder. Han vil derefter forkorte sin log til HW for den nye leder på tidspunktet for valget og begynde at sende anmodninger som følgesvend.
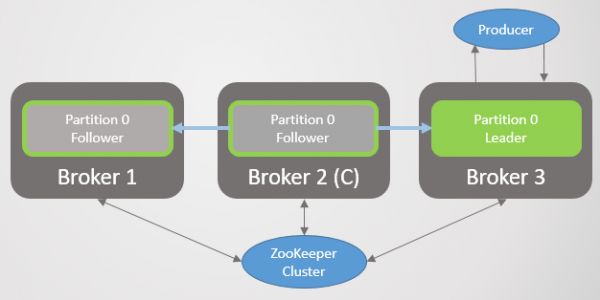
Fig. 35. Scenarie 6. Den oprindelige leder bliver følgesvend efter genoprettelse af netværksforbindelsen
I denne situation kan der i en kort periode være en logisk opdeling, men kun hvis acks=1 og min.insync.replicas den også 1. Den logiske opdeling afsluttes automatisk enten efter genoprettelse af netværket, når den oprindelige leder indser, at han ikke længere er leder, eller når alle klienter forstår, at lederen er skiftet, og begynder at skrive til den nye leder – afhængigt af hvad der sker først. I begge tilfælde vil der ske tab af nogle meddelelser, men kun med acks=1.
Der er en anden mulighed i dette scenario, hvor følgesvende er blevet forsinket umiddelbart før netværksopdelingen, og lederen har komprimeret ISR til kun sig selv. Derefter bliver han isoleret på grund af tab af forbindelse. En ny leder vælges, men den oprindelige leder fortsætter med at tage optegnelser, selv acks=all, fordi der ikke er nogen andre i ISR end ham. Disse optegnelser vil gå tabt efter genoprettelse af netværket. Den eneste måde at undgå dette scenario på er min.insync.replicas = 2.
Scenarie 7. Kafka-controlleren ser ikke en anden Kafka-node
Generelt vil controlleren ikke kunne videregive nogen information om lederændringer til den frakoblede Kafka-node. I værste fald vil dette føre til en kortvarig logisk opdeling, som i scenarie 6. Ofte vil mægleren simpelthen ikke blive kandidat til lederskab i tilfælde af den sidste fejlfunktion.
Scenarie 8. Kafka-controlleren ser ikke Zookeeper
Den frakoblede controller vil ikke modtage ping fra Zookeeper og vælge en ny Kafka-node som controller. Den oprindelige controller kan fortsætte med at fremstille sig selv som sådan, men han modtager ikke notifikationer fra Zookeeper, så han vil ikke have nogen opgaver at udføre. Når netværket er genoprettet, vil han indse, at han ikke længere er controller, men er blevet en almindelig Kafka-node.
Konklusioner fra scenarierne
Vi ser, at tabet af forbindelse til følgere ikke fører til tab af meddelelser, men blot midlertidigt reducerer redundansen, indtil netværket genoprettes. Dette kan dog føre til datatab, hvis en eller flere noder går tabt.
Hvis lederen på grund af tab af forbindelse er adskilt fra Zookeeper, kan det føre til tab af meddelelser fra acks=1. Manglende forbindelse til Zookeeper forårsager en kortvarig logisk opdeling med to ledere. Dette problem løses af parameteren acks=all.
Parameter min.insync.replicas med to eller flere replikaer giver ekstra garantier for, at sådanne kortsigtede scenarier ikke fører til tab af meddelelser, som i scenario 6.
Resume om tab af meddelelser
Lad os opremse alle måder, man kan miste data i Kafka:
- Enhver fejl i lederen, hvis meddelelser blev bekræftet via acks=1
- Enhver urenset (unclean) lederovergang, dvs. til en follower uden for ISR, selv med acks=all
- Isolation af lederen fra Zookeeper, hvis meddelelser blev bekræftet via acks=1
- Fuldt isolation af lederen, som allerede har komprimeret ISR-gruppen til sig selv. Alle meddelelser vil gå tabt, selv acks=all. Dette er kun sandt, hvis min.insync.replicas=1.
- Samtidige fejl på alle noder i partisjonen. Da meddelelser bekræftes fra hukommelsen, kan nogle muligvis endnu ikke være skrevet til disk. Efter genstart af serverne kan nogle meddelelser mangle.
Urensede lederovergange kan undgås ved enten at forbyde dem eller ved at sikre redundans på mindst to. Den mest robuste konfiguration er en kombination af acks=all og min.insync.replicas mere end 1.
Direkte sammenligning af pålideligheden af RabbitMQ og Kafka
For at sikre pålidelighed og høj tilgængelighed implementerer begge platforme et system med primær og sekundær replikation. Men RabbitMQ har en Achilles-hæl. Ved genforbindelse efter en fejl kasserer noderne deres data, og synkroniseringen blokeres. Denne dobbelte udfordring rejser spørgsmål om holdbarheden af store køer i RabbitMQ. Du bliver nødt til at indse, at du enten skal reducere redundansen eller beskæftige dig med langvarige blokeringer. At reducere redundansen øger risikoen for massivt datatab. Men hvis køerne er små, kan man klare sig med korte perioder med utilgængelighed (et par sekunder) ved hjælp af genoptagelsesforsøg.
I Kafka er der ikke et sådant problem. Den kasserer kun data fra forskellen mellem lederen og følgere. Alle fælles data bevares. Desuden blokerer replikation ikke systemet. Lederen fortsætter med at modtage indtastninger, mens en ny follower indhenter, så for DevOps bliver tilslutning eller genforening af klyngen en triviel opgave. Der er dog stadig problemer som båndbredde ved replikering. Hvis der samtidig tilføjes flere følgere, kan man støde på båndbreddebegrænsningen.
RabbitMQ overgår Kafka i pålidelighed ved samtidig svigt af flere servere i klyngen. Som nævnt sender RabbitMQ en bekræftelse til publisheren kun efter at have skrevet beskeden til disken på masteren og alle spejle. Men det tilføjer en ekstra forsinkelse af to grunde:
- fsync hvert par hundrede millisekunder
- Svigt af et spejl kan kun mærkes efter udløbet af pakkerne, der tjekker tilgængeligheden af hver node (net tick). Hvis et spejl halter eller er nede, tilføjer det forsinkelse.
Kafka satser på, at hvis en besked opbevares på flere noder, kan beskeder bekræftes, så snart de er nået ind i hukommelsen. Dette medfører en risiko for tab af beskeder af enhver type (selv acks=all, min.insync.replicas=2) i tilfælde af samtidig svigt.
Generelt viser Kafka højere ydeevne, da den oprindeligt er designet til klynger. Antallet af følgere kan øges til 11, hvis det er nødvendigt for pålidelighed. Replikationsforholdet på 5 og det minimale antal replikaer i synkroniseret tilstand min.insync.replicas=3 vil gøre tab af besked til en meget sjælden begivenhed. Hvis din infrastruktur kan sikre et sådant replikationsforhold og redundansniveau, kan du vælge denne mulighed.
Klyngen af RabbitMQ er god til små køer. Men selv små køer kan hurtigt vokse ved høje trafikmængder. Så snart køerne bliver store, må der træffes hårde valg mellem tilgængelighed og pålidelighed. Klyngen af RabbitMQ er bedst egnet til ikke-typiske situationer, hvor fordelene ved fleksibilitet i RabbitMQ opvejer eventuelle ulemper ved dets klyngedannelse.
Et af modgiftene mod sårbarheden i RabbitMQ med hensyn til store køer er at opdele dem i mange mindre. Hvis der ikke kræves fuld rækkefølge af hele køen, men kun de relevante meddelelser (f.eks. meddelelser fra en bestemt kunde), eller slet ikke noget er i rækkefølge, så er denne mulighed acceptabel: se mit projekt til opdeling af køen (projektet er stadig i de tidlige stadier).
Endelig skal man ikke glemme en række fejl i kluster- og replikeringsmekanisme både i RabbitMQ og i Kafka. Med tiden er systemerne blevet mere modne og stabile, men ingen meddelelse vil nogensinde være 100% beskyttet mod tab! Derudover sker der storstilede nedbrud i datacentre!
Hvis jeg har overset noget, lavet en fejl, eller hvis du er uenig i nogen af punkterne, så tøv ikke med at skrive en kommentar eller kontakte mig.
Jeg bliver ofte spurgt: «Hvad skal man vælge, Kafka eller RabbitMQ?», «Hvilken platform er bedre?». Sandheden er, at det virkelig afhænger af din situation, nuværende erfaring osv. Jeg tør ikke udtrykke min mening, da det ville være for stort et simplificering at anbefale én eneste platform til alle anvendelsesscenarier og mulige begrænsninger. Jeg har skrevet denne serie af artikler, så du kan danne din egen mening.
Jeg vil sige, at begge systemer er førende på dette område. Måske er jeg en smule partisk, fordi jeg af erfaring fra mine projekter sætter pris på ting som garanteret rækkefølge af meddelelser og pålidelighed.
Jeg ser andre teknologier, som mangler denne pålidelighed og garanteret rækkefølge, og så ser jeg på RabbitMQ og Kafka — og forstår den utrolige værdi af begge disse systemer.
Kilde: habr.com
