

Fejltolerance og høj tilgængelighed er store emner, så vi vil dedikere separate artikler til RabbitMQ og Kafka. Denne artikel handler om RabbitMQ, mens den næste vil være om Kafka i sammenligning med RabbitMQ. Artiklen er lang, så gør dig komfortabel.
Lad os se på strategier for fejltolerance, konsistens og høj tilgængelighed (HA), samt de kompromiser, der er nødvendige i hver strategi. RabbitMQ kan køre på et cluster af noder — og klassificeres så som et distribueret system. Når vi taler om distribuerede systemer, handler det ofte om konsistens og tilgængelighed.
Disse begreber beskriver, hvordan systemet opfører sig ved fejl. Fejl i netværksforbindelsen, serverfejl, harddiskfejl, midlertidig utilgængelighed af serveren på grund af affaldssamling, pakke tab eller langsom netværksforbindelse. Alt dette kan føre til datatab eller konflikter. Det viser sig, at det nærmest er umuligt at have et system, der er både fuldstændig konsistent (uden datatab, uden datainkonsekvenser) og tilgængeligt (det vil tage læse- og skriveoperationer) under alle fejlsituationer.
Vi vil se, at konsistens og tilgængelighed befinder sig på forskellige ender af spektret, og du skal vælge, hvilken retning du vil optimere imod. Den gode nyhed er, at med RabbitMQ er sådan et valg muligt. Du har nogle "nørdede" kontrolknapper, så du kan justere balancen mod mere konsistens eller mere tilgængelighed.
Vi vil sætte fokus på, hvilke konfigurationer der fører til datatab på grund af bekræftede opskrivninger. Der er et ansvarssamarbejde mellem udgivere, brokere og forbrugere. Når en besked overdrages til brokeren, er det dens opgave at ikke miste beskeden. Når brokeren bekræfter over for udgiveren, at den har modtaget beskeden, forventer vi ikke, at den går tabt. Men vi vil se, at det faktisk kan ske, afhængigt af konfigurationen af din broker og udgiver.
Primitiver for et enkelt nodes robusthed
Robuste køer/routing
I RabbitMQ findes der to typer af køer: langvarige/vedholdende (durable) og ikke vedholdende (non-durable). Alle køer gemmes i Mnesia-databasen. Vedholdende køer erklæres igen ved opstart af noden og overlever dermed genstart, systemfejl eller servernedbrud (så længe dataene bevares). Dette betyder, at så længe du erklærer routing (exchange) og køen som vedholdende, vil kø- og routinginfrastrukturen komme tilbage i drift.
Ikke-vedholdende køer og routing fjernes ved genstart af noden.
Vedholdende beskeder
At en kø er holdbar, betyder ikke, at alle dens beskeder overlever genstart af noden. Kun de beskeder, der er markeret af udgiveren som vedholdende (persistent), vil blive genoprettet. Vedholdende beskeder skaber faktisk ekstra belastning på brokeren, men hvis tab af beskeder ikke er acceptabelt, er der ingen anden udvej.
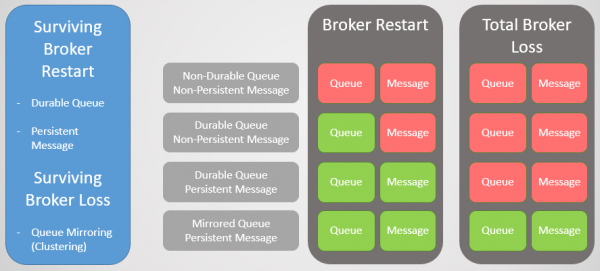
Fig. 1. Vedholdenhedsmatrix
Klyngedannelse med køspejling
For at overleve tab af brokeren har vi brug for redundans. Vi kan samle flere RabbitMQ-noder i en klynge og derefter tilføje yderligere redundans ved at replikere køerne mellem flere noder. På denne måde, hvis en node fejler, taber vi ikke data og forbliver tilgængelige.
Køspejling:
- én hovedkø (master), der modtager alle kommandoer til skrivning og læsning
- en eller flere spejle, der modtager alle beskeder og metadata fra hovedkøen. Disse spejle findes ikke til skalering, men udelukkende til redundans.
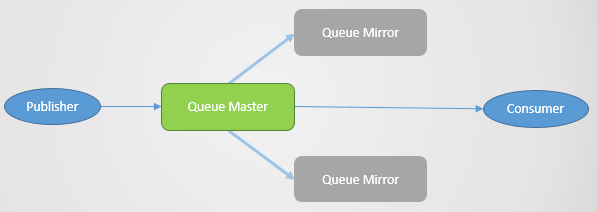
Fig. 2. Køspejling
Spejling oprettes med den relevante politik. Her kan du vælge replikationsfaktoren og endda de noder, som køen skal placeres på. Eksempler:
ha-mode: allha-mode: exactly, ha-params: 2(én master og ét spejl)ha-mode: nodes, ha-params: rabbit@node1, rabbit@node2
Bekræftelse til udgiveren
For achieving consistent recording, publisher confirmations are necessary. Without them, there is a risk of message loss. Confirmation is sent to the publisher after the message has been written to disk. RabbitMQ writes messages to disk not upon receipt, but periodically, within a few hundred milliseconds. When a queue is mirrored, confirmation is sent only after all mirrors have also written their copy of the message to disk. This means that using confirmations introduces latency, but if data security is important, they are essential.
Fejlsikker kø
When the broker shuts down or crashes, all leading queues (masters) on that node also go down with it. The cluster then selects the oldest mirror of each master and promotes it as the new master.
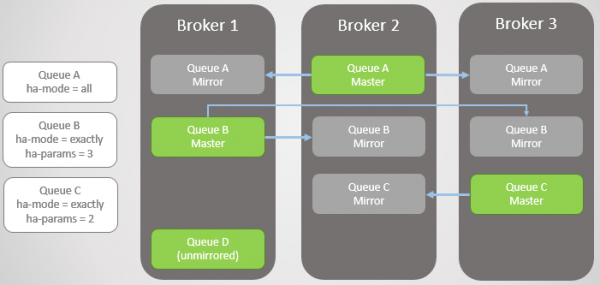
Fig. 3. Several mirrored queues and their policies
Broker 3 crashes. Note that the mirror of Queue C on Broker 2 is promoted to master. Also, note that a new mirror for Queue C is created on Broker 1. RabbitMQ always attempts to maintain the replication factor specified in your policies.
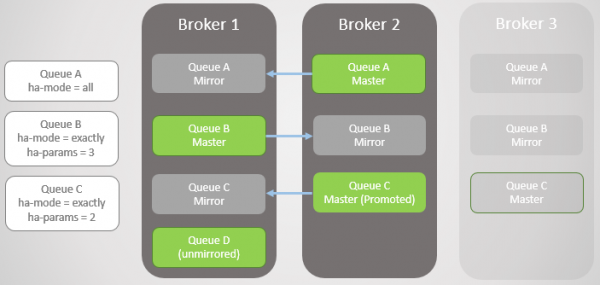
Fig. 4. Broker 3 crashes, causing the failure of Queue C
Next, Broker 1 crashes! We are left with only one broker. The mirror of Queue B is promoted to master.
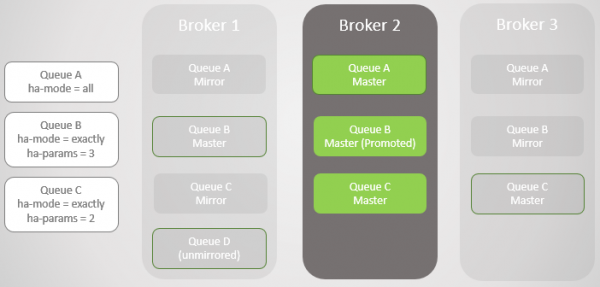
Fig. 5
We have restored Broker 1. Regardless of how successfully the data survived the loss and recovery of the broker, all mirrored queue messages are discarded upon restart. It is important to note this, as there will be consequences. We will soon look at these consequences. Thus, Broker 1 is now again a member of the cluster, and the cluster tries to comply with the policies and therefore creates mirrors on Broker 1.
In this case, the loss of Broker 1 was complete, as was the loss of data, so the unmirrored Queue B is completely lost.
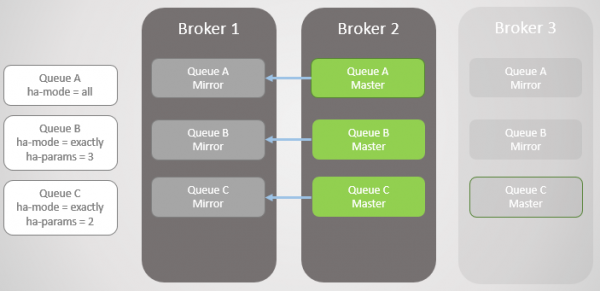
Fig. 6. Broker 1 returns to service
Broker 3 er tilbage i drift, så køerne A og B får deres oprettede spejle tilbage for at opfylde deres HA-politikker. Men nu er alle hovedkøer på én node! Dette er ikke ideelt; en bedre fordeling mellem noderne ville være at foretrække. Desværre er der ikke mange muligheder for genbalancering af mestre her. Vi kommer tilbage til dette problem senere, da vi først skal se på synkroniseringen af køen.
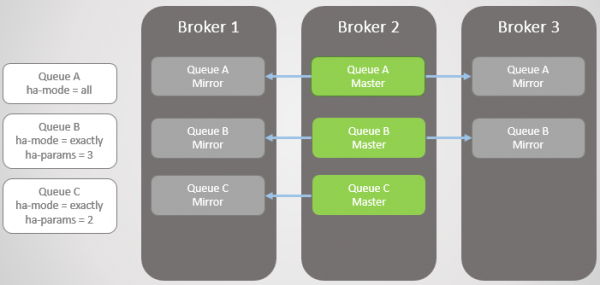
Fig. 7. Broker 3 vender tilbage i drift. Alle hovedkøer er på én node!
Således skulle du nu have en idé om, hvordan spejle sikrer redundans og fejltolerance. Dette garanterer tilgængelighed i tilfælde af, at én node fejler, og beskytter mod datatab. Men vi er stadig ikke færdige, for det hele er meget mere kompliceret.
Synkronisering
Når et nyt spejl oprettes, vil alle nye beskeder altid blive replikeret til dette spejl og eventuelle andre. Hvad angår de eksisterende data i hovedkøen, kan vi replikere dem til det nye spejl, så det bliver en fuldstændig kopi af mesteren. Vi kan også vælge ikke at replikere de eksisterende beskeder og lade hovedkøen og det nye spejl synkronisere over tid, hvor nye beskeder tilføjes i halen, mens eksisterende beskeder fjernes fra hovedkøens hoved.
Denne synkronisering udføres automatisk eller manuelt og styres vha. køpolitikker. Lad os se på et eksempel.
Vi har to spejlede køer. Kø A synkroniseres automatisk, mens Kø B synkroniseres manuelt. Begge køer indeholder ti beskeder.
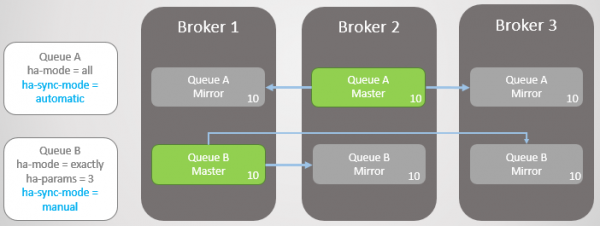
Fig. 8. To køer med forskellige synkroniseringsmetoder
Nu mister vi Broker 3.
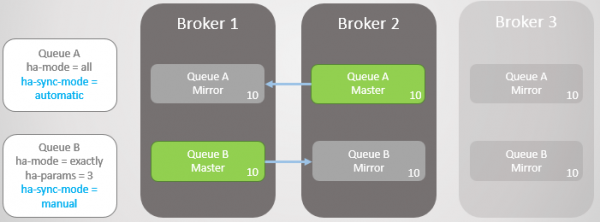
Fig. 9. Broker 3 er nede
Broker 3 er tilbage i drift. Klyngen opretter et spejl for hver kø på en ny node og synkroniserer automatisk den nye Kø A med mesteren. Dog forbliver spejlet for den nye Kø B tomt. Således har vi fuld redundans for Kø A og kun ét spejl for eksisterende beskeder i Kø B.
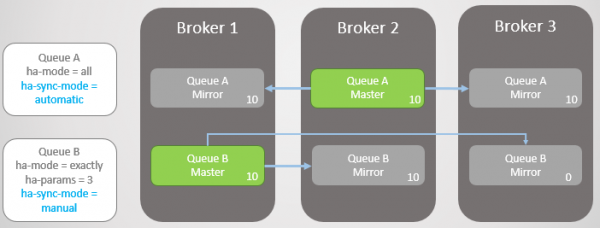
Fig. 10. Det nye spejl for Kø A modtager alle eksisterende beskeder, mens det nye spejl for Kø B ikke gør.
I begge køer modtages der yderligere ti beskeder. Derefter falder Broker 2, og Kø A rulles tilbage til det ældste spejl, som findes på Broker 1. Der sker ingen datatab ved nedbrud. I Kø B er der tyve beskeder i masteren og kun ti i spejlet, da denne kø aldrig har replikeret de oprindelige ti beskeder.
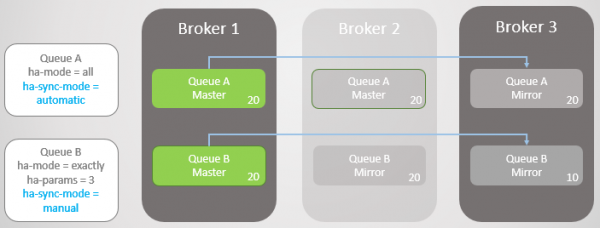
Fig. 11. Kø A rulles tilbage til Broker 1 uden tab af beskeder
I begge køer modtages der endnu ti beskeder. Nu falder Broker 1. Kø A skifter uden problemer til spejlet uden tab af beskeder. Men Kø B får problemer. På dette tidspunkt kan vi optimere enten tilgængeligheden eller konsistensen.
Hvis vi vil optimere tilgængeligheden, så skal politikken ha-promote-on-failure sættes til always. Denne værdi er standarden, så man kan ganske enkelt undlade at angive politikken overhovedet. I så fald tillader vi reelt fejl i usynkroniserede spejle. Dette vil føre til tab af beskeder, men køen forbliver tilgængelig for læsning og skrivning.
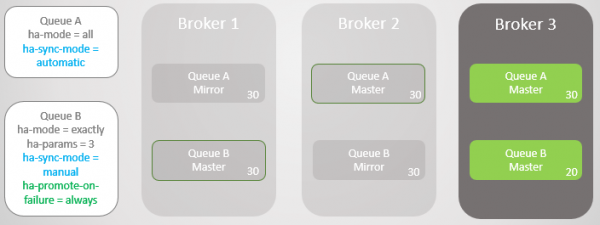
Fig. 12. Kø A rulles tilbage til Broker 3 uden tab af beskeder. Kø B rulles tilbage til Broker 3 med tab af ti beskeder
Vi kan også indstille ha-promote-on-failure til værdien when-synced. I dette tilfælde vil køen vente, indtil Broker 1 med sine data vender tilbage til drift. Efter hans tilbagevenden vil hovedkøen igen befinde sig på Broker 1 uden tab af data. Tilgængeligheden ofres for datasikkerhed. Men dette er en risikabel tilstand, som kan føre til endda total datatab, hvilket vi vil se nærmere på snart.
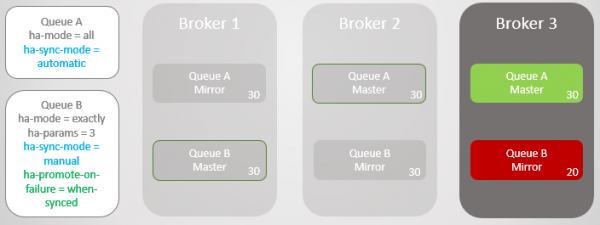
Fig. 13. Kø B forbliver utilgængelig efter tabet af Broker 1
Du kan stille spørgsmålet: «Måske er det bedre aldrig at bruge automatisk synkronisering?». Svaret er, at synkronisering er en blokkerende operation. Under synkroniseringen kan hovedkøen ikke udføre nogen læse- eller skriveoperationer!
Lad os overveje et eksempel. Vi har nu meget store køer. Hvordan kan de vokse til denne størrelse? Af flere grunde:
- Køerne er ikke aktive
- Dette er højhastighedskøer, og lige nu arbejder forbrugerne langsomt
- Dette er højhastighedskøer, der har lidt et nedbrud, og forbrugerne indhenter
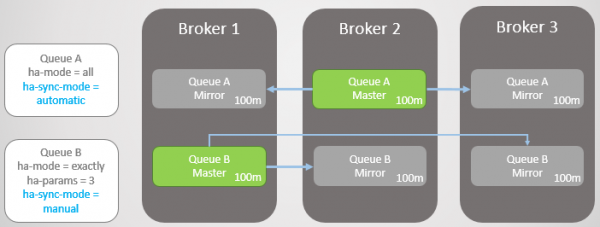
Fig. 14. To store large queues with different synchronization modes
Now Broker 3 goes down.
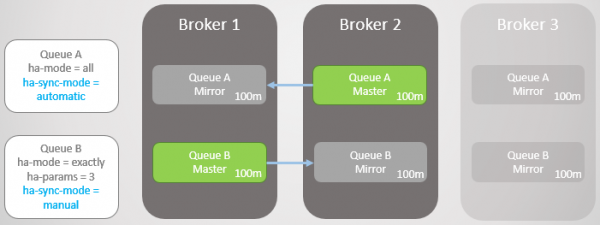
Fig. 15. Broker 3 is down, leaving one master and one mirror in each queue
Broker 3 comes back online, and new mirrors are created. Main Queue A starts replicating existing messages to the new mirror, during which time the queue is unavailable. It takes two hours to replicate the data, leading to two hours of downtime for this Queue!
However, Queue B remains available throughout this period. It sacrificed some redundancy for availability.
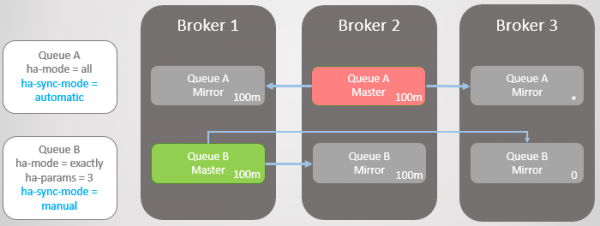
Fig. 16. The queue remains unavailable during synchronization
After two hours, Queue A also becomes available again and can resume read and write operations.
Opdateringer
This blocking behavior during synchronization complicates cluster updates with very large queues. At some point, the node with the master needs to be restarted, which means either switching to the mirror or taking the queue offline during the server update. If we choose to switch, we will lose messages if the mirrors are not synchronized. By default, during broker shutdown, switching to an unsynchronized mirror does not occur. This means that as soon as the broker returns, we do not lose any messages, the only damage was the downtime of the queue. The behavior rules for broker shutdown are set by the policy ha-promote-on-shutdown. You can set one of two values:
always= enable the transition to unsynchronized mirrorswhen-synced= switch only to a synchronized mirror; otherwise, the queue becomes unavailable for reading and writing. The queue comes back online as soon as the broker returns
Either way, with large queues, you have to choose between data loss and unavailability.
When availability enhances data security
Before making a decision, one more complication needs to be considered. Although automatic synchronization is better for redundancy, how does it affect data security? Of course, with better redundancy, RabbitMQ is less likely to lose existing messages, but what about new messages from publishers?
Here are some key points to consider:
- Kan en udgiver bare returnere en fejl, og kan den overordnede tjeneste eller bruger forsøge igen senere?
- Kan en udgiver gemme meddelelsen lokalt eller i en database, så den kan forsøge igen senere?
Hvis udgiveren kun kan kassere meddelelsen, forbedrer tilgængeligheden i virkeligheden også datasikkerheden.
Derfor skal der søges efter en balance, og løsningen afhænger af den specifikke situation.
Problemer med ha-promote-on-failure=when-synced
Idé ha-promote-on-failure= when-synced ligger i, at vi forhindrer skift til et usynkroniseret spejl og dermed undgår datatab. Køen forbliver utilgængelig for læsning eller skrivning. I stedet forsøger vi at genoprette den faldne broker med intakt data, så den kan genoptage driften som master uden datatab.
Men (og det er et stort men) hvis brokeren har mistet sine data, har vi et stort problem: køen er tabt! Alle data er væk! Selvom du har spejle, der hovedsageligt indhenter den primære kø, bliver disse spejle også kassere.
For at tilføje en node med det samme navn igen, beder vi klusteret om at glemme den tabte node (ved hjælp af kommandoen rabbitmqctl forget_cluster_node) og starte en ny broker med det samme værtsnavn. Så længe klusteret husker den tabte node, husker det den gamle kø og usynkroniserede spejle. Når klusteret beordres til at glemme den tabte node, glemmes denne kø også. Den skal nu deklareres igen. Vi har mistet alle data, selvom vi havde spejle med en delmængde af data. Det ville have været bedre at skifte til et usynkroniseret spejl!
Derfor er manuel synkronisering (og undgåelse af synkronisering) kombineret med ha-promote-on-failure=when-synced, efter min mening, ret risikabelt. Dokumenter siger, at denne mulighed eksisterer for datasikkerhed, men det er en tveægget sværd.
Masterforbalancering
Som lovet vender vi tilbage til problemet med, at alle mastere samles på en eller flere noder. Dette kan ske selv som følge af en "rolling" opdatering af klusteret. I et kluster med tre noder kan alle hovedkøer samle sig på en eller to noder.
Masterforbalancering kan vise sig at være problematisk af to grunde:
- Der er ikke gode værktøjer til at udføre forbalancering
- Synkronisering af køer
For at omfordele er der en tredjepart , som ikke understøttes officielt. Med hensyn til tredjeparts plugins i RabbitMQ's vejledning : «Plugin'et giver nogle ekstra konfigurations- og rapporteringsværktøjer, men det understøttes ikke og er ikke testet af RabbitMQ-holdet. Brug det på egen risiko».
Der er også et andet trick til at flytte hovedkøen via HA-politikker. Det nævnes i vejledningen til dette. Det fungerer på følgende måde:
- Fjerner alle spejle med en midlertidig politik med højere prioritet end den eksisterende HA-politik.
- Ændrer den midlertidige HA-politik til at bruge 'noder'-modus og angiver den node, som hovedkøen skal flyttes til.
- Synkroniserer køen for at tvinge migration.
- Når migrationen er afsluttet, slettes den midlertidige politik. Den oprindelige HA-politik træder i kraft, og det ønskede antal spejle oprettes.
Ulempen er, at denne tilgang måske ikke fungerer, hvis du har store køer eller strenge redundanskrav.
Lad os nu se på, hvordan RabbitMQ-klynger fungerer med netværksopdelinger.
Netværkstilkoblingsbrud
Noderne i et distribueret system forbindes via netværkstilkoblinger, og netværksforbindelser kan og vil blive brudt. Hyppigheden af afbrydelser afhænger af den lokale infrastruktur eller pålideligheden af den valgte sky. Under alle omstændigheder skal distribuerede systemer være i stand til at håndtere dem. Igen står vi overfor valget mellem tilgængelighed og konsistens, og igen er den gode nyhed, at RabbitMQ tilbyder begge muligheder (bare ikke samtidigt).
Med RabbitMQ har vi to hovedmuligheder:
- Tillade logisk adskillelse (split-brain). Det sikrer tilgængelighed, men kan medføre datatab.
- Forbyde logisk adskillelse. Kan føre til kortvarigt tab af tilgængelighed afhængigt af, hvordan kunderne forbinder til klyngen. Kan også resultere i total utilgængelighed i klyngen af to noder.
Men hvad er logisk adskillelse? Det er, når klyngen opdeles i to på grund af tab af netværksforbindelser. På hver side hæves spejlene til mestre, så der i sidste ende er flere mestre pr. kø.
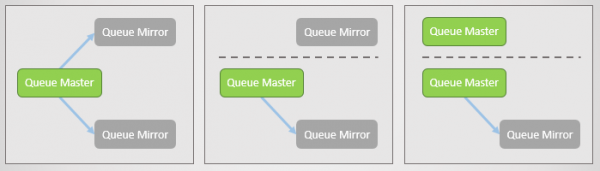
Fig. 17. Hovedkøen og to spejle, hver på en separat node. Derefter opstår der et netværksfejl, og et spejl adskilles. Den adskilte node ser, at de to andre er faldet fra, og opgraderer sine spejle til master. Nu har vi to hovedkøer, og begge tillader skrivning og læsning.
Hvis udgivere sender data til begge mestre, får vi to divergerende kopier af køen.
De forskellige tilstande i RabbitMQ sikrer enten tilgængelighed eller konsistens.
Ignore-tilstand (standard)
Denne tilstand sikrer tilgængelighed. Efter tab af forbindelsen sker der en logisk opdeling. Efter genoprettelse af forbindelsen skal administratoren beslutte, hvilken sektion der skal foretrækkes. Den tabende side vil blive genstartet, og alle akkumulerede data fra denne side går tabt.
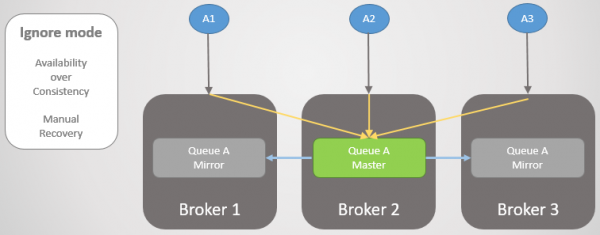
Fig. 18. Tre udgivere er forbundet til tre mæglere. Internt dirigerer klyngen alle anmodninger til hovedkøen på Broker 2.
Nu mister vi Broker 3. Den ser, at de andre mæglere er faldet fra, og opgraderer sit spejl til master. Så sker der en logisk opdeling.
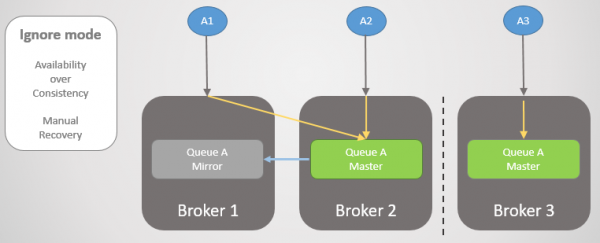
Fig. 19. Logisk opdeling (split-brain). Skrivninger går til to hovedkøer, og to kopier divergerer.
Forbindelsen genoprettes, men den logiske opdeling forbliver. Administratoren skal manuelt vælge den tabende side. I det følgende tilfælde genstarter administratoren Broker 3. Alle meddelelser, som den ikke kunne overføre, går tabt.
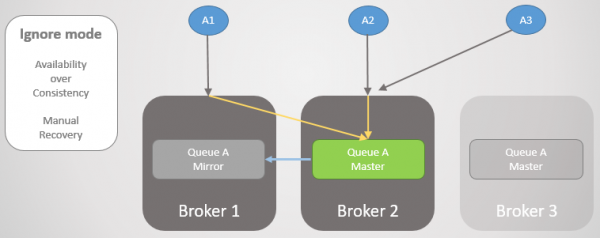
Fig. 20. Administratoren deaktiverer Broker 3.
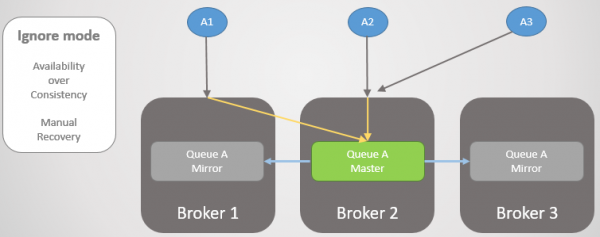
Fig. 21. Administratoren starter Broker 3, og den tilslutter sig klyngen, mens den mister alle meddelelser, der var der.
Under tab af forbindelsen og efter genoprettelse var klyngen og denne kø tilgængelige for læsning og skrivning.
Autoheal-tilstand
Fungerer på samme måde som Ignore-tilstanden, bortset fra at klyngen automatisk vælger den tabende side efter opdeling og genoprettelse af forbindelsen. Den tabende side genoptages i klyngen tom, og køen mister alle meddelelser, der kun blev sendt til den side.
Pause Minority-tilstand
Hvis vi ikke ønsker at tillade logisk opdeling, er vores eneste mulighed at undlade at læse og skrive på den mindre side efter opdelingen af klyngen. Når broker ser, at den er på den mindre side, stopper den arbejdet, lukker alle eksisterende forbindelser og afslår nye. En gang i sekundet tjekker den genoprettelsen af forbindelsen. Så snart forbindelsen er genoprettet, genoptager den arbejdet og tilslutter sig klyngen.
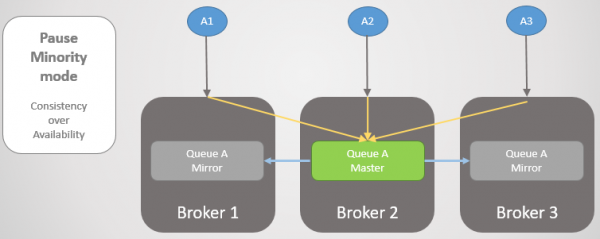
Fig. 22. Tre publishere er forbundet til tre brokere. Internt dirigerer klyngen alle forespørgsler til hovedkøen på Broker 2.
Derefter adskilles Brokere 1 og 2 fra Broker 3. I stedet for at opgradere sit spejl til master, stopper Broker 3 arbejdet og bliver utilgængelig.
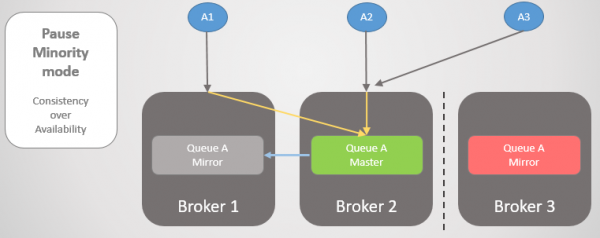
Fig. 23. Broker 3 stopper arbejdet, afbryder alle kunder og afviser tilslutningsanmodninger.
Så snart forbindelsen er genoprettet, vender den tilbage til klyngen.
Lad os se på et andet eksempel, hvor hovedkøen er på Broker 3.
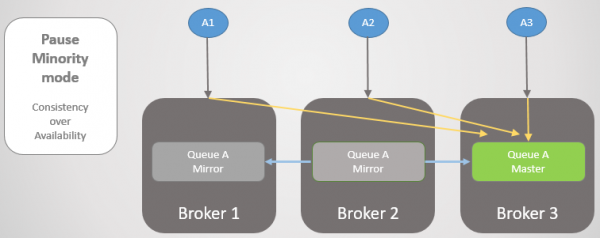
Fig. 24. Hovedkøen på Broker 3.
Derefter sker der den samme forbindelsestab. Broker 3 går på pause, da den er på den mindre side. På den anden side ser noderne, at Broker 3 er faldet ud, så det ældre spejl fra Broker 1 og 2 opgraderes til master.
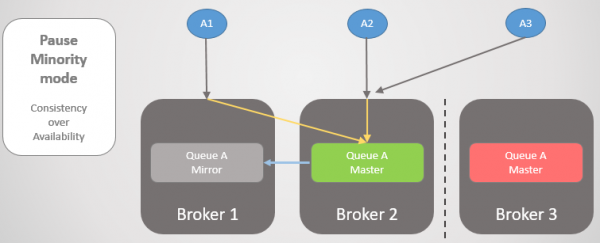
Fig. 25. Overgang til Broker 2 ved utilgængelighed af Broker 3.
Når forbindelsen er genoprettet, vil Broker 3 slutte sig til klyngen.

Fig. 26. Klyngen er vendt tilbage til normal drift.
Det er vigtigt at forstå her, at vi opnår konsistens, men vi kan også opnå tilgængelighed, hvis vi vil med succes overføre kunderne til den større del af sektionen. For de fleste situationer ville jeg personligt vælge Pause Minority-tilstand, men det afhænger reelt af den specifikke sag.
For at sikre tilgængelighed er det vigtigt at sikre, at kunderne med succes tilslutter sig noden. Lad os overveje vores muligheder.
Sikring af kundernes forbindelse
Vi har flere måder at dirigere kunder tilbage til hoveddelen af klyngen eller til fungerende noder (efter at en node er fejlet) efter et tab af forbindelse. Lad os først huske, at en bestemt kø placeres på en bestemt node, men routingen og politikkerne replikers på alle noder. Kunderne kan oprette forbindelse til enhver node, og den interne routing vil lede dem det rigtige sted hen. Men når en node er sat på pause, afviser den forbindelser, så kunderne skal oprette forbindelse til en anden node. Hvis en node falder ud, kan den overhovedet ikke gøre meget.
Vores muligheder:
- Adgang til klyngen sker via en load balancer, der simpelthen cykler gennem noderne, mens kunderne forsøger at oprette forbindelse, indtil det lykkes. Hvis en node ikke fungerer eller er sat på pause, vil forbindelsesforsøgene til denne node mislykkes, men efterfølgende forsøg vil gå til andre servere (i cyklus). Dette er passende til kortvarigt tab af forbindelse eller en nede server, der hurtigt vil blive genoprettet.
- Adgang til klyngen via en load balancer og fjernelse af sættede/nede noder fra listen, så snart de opdages. Hvis det gøres hurtigt, og hvis kunderne kan forsøge at oprette forbindelse igen, vil vi opnå konstant tilgængelighed.
- Giv hver kunde en liste over alle noder, og kunden vælger en af dem tilfældigt, når de opretter forbindelse. Hvis de får en fejltagelse ved forsøg på forbindelse, går de videre til den næste node på listen, indtil de opretter forbindelse.
- Fjern trafik fra den nede/satte node ved hjælp af DNS. Dette gøres ved hjælp af en lav TTL.
Konklusioner
RabbitMQ-klyngedannelse har sine fordele og ulemper. De mest alvorlige ulemper er:
- ved tilslutning til klyngen kasserer noder deres data;
- blokgivende synkronisering fører til utilgængelighed af køen.
Alle vanskelige beslutninger udspringer fra disse to egenskaber ved arkitekturen. Hvis RabbitMQ kunne gemme data ved genforbindelse af klyngen, ville synkroniseringen være hurtigere. Hvis den kunne udføre ikke-blokerende synkronisering, ville den bedre kunne understøtte store køer. At løse disse to problemer ville seriøst forbedre RabbitMQ's ydeevne som en fejltolerant og højtilgængelig messaging-teknologi. Jeg vil ikke anbefale RabbitMQ med klyngefunktionalitet i følgende situationer:
- U pålidelig netværk.
- U pålidelig lagring.
- Meget store køer.
Når det kommer til indstillinger for høj tilgængelighed, kan du overveje følgende:
ha-promote-on-failure=alwaysha-sync-mode=manualcluster_partition_handling=ignore(ellerautoheal)- vedholdende meddelelser
- sørg for, at klienter forbinder til den aktive knude, når en knude fejler
For konsistens (databeskyttelse) overvej følgende indstillinger:
- Publisher Confirms og Manual Acknowledgements på forbrugerens side
ha-promote-on-failure=when-synced, hvis udgiverne kan prøve igen senere, og hvis du har meget pålidelig lagring! Ellers sæt=always.ha-sync-mode=automatic(men for store inaktive køer kan manuel tilstand være nødvendig; overvej desuden, om utilgængelighed vil føre til tab af meddelelser)- Pause Minority-tilstand
- vedholdende meddelelser
Vi har endnu ikke dækket alle emner vedrørende fejltolerance og høj tilgængelighed; for eksempel hvordan man sikkert udfører administrative procedurer (såsom glidende opgraderinger). Vi skal også tale om federering og Shovel-plugin.
Hvis jeg har overset noget, så lad mig vide det.
Se også min , hvor jeg gennemfører eksperimenter i RabbitMQ-klyngen med Docker og Blockade for at teste nogle scenarier for meddelelsestab beskrevet i denne artikel.
Tidligere artikler i serien:
Nr. 1 —
Nr. 2 —
Nr. 3 —
Kilde: habr.com
