

Når man opretter et Kubernetes-kluster, kan der opstå spørgsmål: hvor mange arbejdsnoder skal man konfigurere, og hvilken type? Hvad er bedst for et on-premise kluster: at købe flere kraftige servere eller at bruge et dusin gamle maskiner i dit datacenter? Og i skyen er det bedre at tage otte enkeltkerne- eller to firekerne-instanser?
Svarene på disse spørgsmål findes i artiklen i oversættelse af teamet .
Klusterkapacitet
Generelt kan et Kubernetes-kluster betragtes som en stor "supernode". Den samlede beregningskraft er summen af alle de individuelle noders kapaciteter.
Der er flere måder at opnå den ønskede målkapacitet for klusteret. For eksempel, hvis vi har brug for et kluster med en samlet kapacitet på 8 CPU-kerner og 32 GB RAM, fordi sæt af applikationer kræver så mange ressourcer. Så kan vi installere to noder med 16 GB RAM eller fire noder med 8 GB RAM, to firekerne-processorer eller fire to-kerne-processorer.
Her er kun to mulige måder at oprette et kluster på:
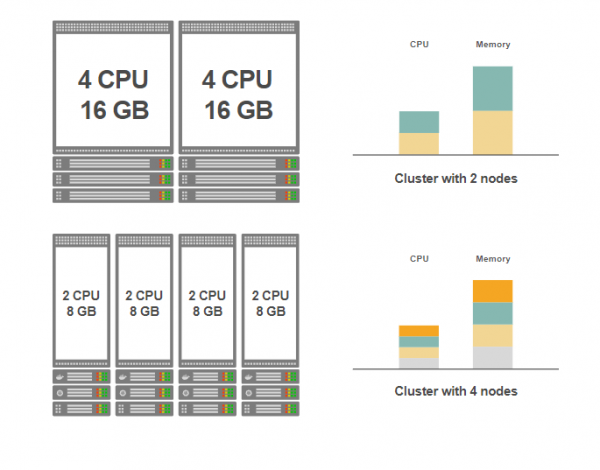
Begge muligheder giver et kluster med samme kapacitet, men i konfigurationen nedenfor er der fire mindre noder, mens konfigurationen ovenfor har to større.
Hvilket valg er bedre?
For at besvare dette spørgsmål, lad os se på fordelene ved begge muligheder. Vi har opsummeret dem i en tabel.
Flere store noder
Mange små noder
Lettere administration af klusteret (hvis det er on-premise)
Glidende automatisk skalering
Billigere (hvis on-premise)
Pris forskellen er lille (i skyen)
Kan køre ressourcekrævende applikationer
Fuldt replica
Ressourcerne bruges mere effektivt (mindre overhead til systemdæmoner)
Højere tilgængelighed af klusteret
Bemærk, at vi kun taler om arbejdsnoder. Valget af antal og størrelse af master-noder er et helt andet emne.
Lad os derfor se nærmere på hvert punkt fra tabellen.
Første mulighed: flere store noder
Den mest ekstreme mulighed er én arbejdsnode, der dækker hele kapaciteten af klusteret. I eksemplet ovenfor ville det være én arbejdsnode med 16 CPU-kerner og 16 GB RAM.
Fordele
Fordel #1. Lettere administration
Det er lettere at styre flere maskiner end et helt datacenter. Hurtigere at installere opdateringer og rettelser, nemmere at synkronisere. Antallet af fejl i absolutte tal er også mindre.
Bemærk, at alt det ovenstående vedrører dit eget udstyr, dine egne servere og ikke cloud-instanser.
I skyen er situationen en anden. Her håndterer cloud-leverandøren administrationen. Derfor adskiller styringen af ti noder i skyen sig ikke væsentligt fra styringen af én node.
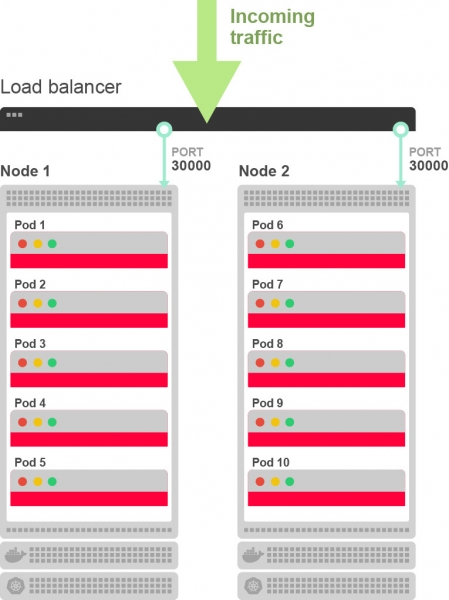
Routing af trafik og belastningsfordeling mellem pods i skyen : den indkommende trafik fra internettet dirigeres til den primære load balancer, som sender trafikken til porten på en af noderne (NodePort-tjenesten eksponerer en port i intervallet 30000-32767 på hver node i klyngen). De regler, der er fastsat af kube-proxy, omdirigerer trafikken fra noden til pod'en. Sådan ser det ud for ti pods på to noder:
Fordel nr. 2. Mindre omkostninger pr. node
En kraftig maskine er dyrere, men prisstigningen er ikke nødvendigvis lineær. Med andre ord er én ti-kerne server med 10 GB hukommelse normalt billigere end ti enkerne servere med den samme mængde hukommelse.
Men bemærk, at denne regel normalt ikke gælder for cloud-tjenester. I de nuværende prissætningsmodeller stiger priserne lineært med kapaciteten hos alle de store cloud-leverandører.
Derfor kan man normalt ikke spare penge på mere kraftfulde servere i skyen.
Fordel nr. 3. Ressourcetunge applikationer kan køres
Nogle applikationer kræver kraftfulde servere i klyngen. For eksempel, hvis et maskinlæringssystem kræver 8 GB hukommelse, kan du ikke køre det på noder med 1 GB, men kun hvis der er mindst én stor arbejdsnode.
Ulemper
Ulempe nr. 1. Mange pods pr. node
Hvis den samme opgave udføres på færre noder, vil der naturligvis være flere pods på hver af dem.
Det kan blive et problem.
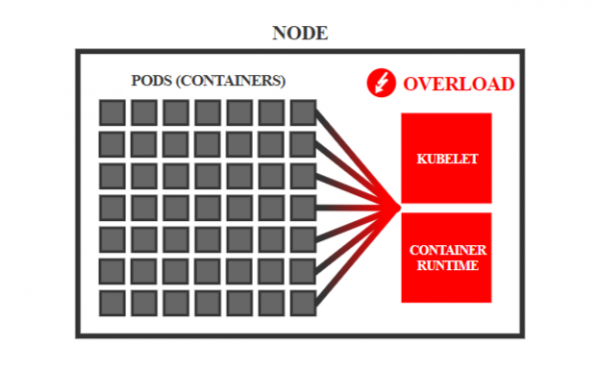
Årsagen er, at hver modul bidrager med nogle overhead til containerens runtime-miljø (f.eks. Docker) samt kubelet og cAdvisor.
For eksempel undersøger kubelet regelmæssigt livsvilkårene for alle containere på noden – jo flere containere, desto mere arbejde har kubelet.
CAdvisor indsamler statistik om ressourceforbruget for alle containere på noden, og kubelet anmoder regelmæssigt om denne information og stiller den til rådighed via API'et. Jo flere containere, jo mere arbejde er der for både cAdvisor og kubelet.
Hvis antallet af moduler vokser, kan det langsommeligt påvirke systemet og endda underminere dets pålidelighed.
I Kubernetes-repositoriet har nogle , over at noderne svinger mellem statusserne Ready/NotReady, fordi kubelets regelmæssige kontroller af alle containere på noden tager for lang tid.
Af denne grund anbefaler Kubernetes . Afhængigt af nodens ydelse kan du køre flere pod'e per node, men det er svært at forudsige, om der vil opstå problemer, eller om alt vil fungere godt. Det er en god idé at teste det på forhånd.
Ulempe nr. 2. Begrænsning af replikering
Et for lille antal noder begrænser den effektive replikationsgrad af applikationer. For eksempel, hvis du har en højtilgængelighedsapplikation med fem replikaer, men kun to noder, falder den effektive replikationsgrad for applikationen til to.
De fem replikaer kan kun fordeles på to noder, og hvis en af dem fejler, bringer det straks flere replikaer ud af drift.
Hvis du har fem noder eller flere, vil hver replika køre på en separat node, og en nodes fejl fjerner højst én replika.
På denne måde kan krav til højtilgængelighed kræve et vist minimum antal noder i klyngen.
Ulempe nr. 3. Værre konsekvenser af fejl
Med et lille antal noder bærer hver fejl mere alvorlige konsekvenser. For eksempel, hvis du kun har to noder, og en af dem fejler, forsvinder halvdelen af dine moduler straks.
Selvfølgelig vil Kubernetes flytte belastningen fra den fejlmeldte node til andre. Men hvis der er få, kan der mangle ledig kapacitet. Som følge heraf vil nogle af dine applikationer være utilgængelige, indtil du får den fejlmeldte node op at køre igen.
Jo flere noder, jo mindre indflydelse har hardwarefejlene.
Ulempe nr. 4. Større skridt til automatisk skalering
I Kubernetes fungerer der et system til automatisk skalering af klynger for cloudinfrastruktur, hvilket gør det muligt automatisk at tilføje eller fjerne noder afhængigt af de aktuelle behov. Med større noder bliver automatisk skalering mere markant og klodset. For eksempel, ved to noder vil tilføjelse af en ekstra node straks øge kapaciteten af klyngen med 50%. Og du vil være nødt til at betale for disse ressourcer, selvom du ikke har brug for dem.
Derfor, hvis du planlægger at bruge automatisk skalering af klynger, så jo mindre noderne er, desto mere fleksibel og økonomisk skalering vil du opnå.
Lad os nu se på fordele og ulemper ved mange små noder.
Alternativ nummer to: mange små noder
Fordelene ved denne tilgang følger i bund og grund af ulemperne ved det modsatte valg med få store noder.
Fordele
Fordel nr. 1. Mindre konsekvenser ved nedbrud
Jo flere noder, desto færre pods på hver node. For eksempel, hvis du har hundrede moduler fordelt på ti noder, vil der i gennemsnit være ti moduler på hver node.
Således, hvis en af noderne fejler, mister du kun 10% af arbejdsbelastningen. Der er en chance for, at kun et lille antal replikaer bliver berørt, mens applikationerne generelt forbliver operationelle.
Desuden er der sandsynligvis tilstrækkeligt med ledige ressourcer på de resterende noder til at håndtere arbejdsbelastningen fra den fejlede node, så Kubernetes kan frit omfordele pods, og dine applikationer relativt hurtigt kan vende tilbage til en funktionsdygtig tilstand.
Fordel nr. 2. God replikation
Hvis der er tilstrækkeligt med noder, kan Kubernetes-scheduler tildele forskellige noder til alle replikaer. Således vil der kun blive berørt én replika i tilfælde af en nodesvigt, mens applikationen forbliver tilgængelig.
Ulemper
Ulempe nr. 1. Sværere at administrere
Det er sværere at administrere mange noder. For eksempel skal hver Kubernetes-node interagere med alle de andre, hvilket betyder, at antallet af forbindelser vokser kvadratisk, og alle disse forbindelser skal overvåges.
Nodekontrolløren i Kubernetes-controller-manageren gennemgår regelmæssigt alle noder i klyngen for at kontrollere deres tilstand — jo flere noder, desto større belastning på kontrolløren.
Belastningen på etcd-databasen vokser også — hver kubelet og kube-proxy kalder for etcd (via API), to which etcd must relay object updates.
In general, each worker node adds additional load on the system components of the master nodes.
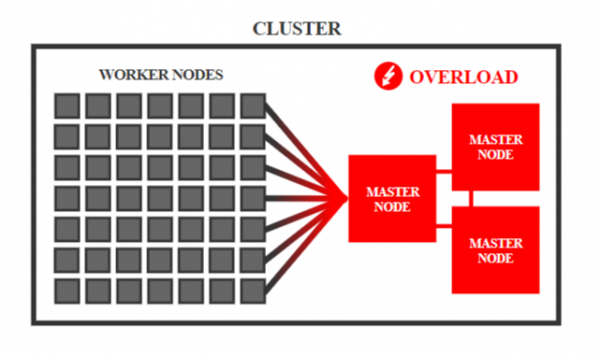
Officially, Kubernetes supports clusters with However, in practice, even 500 nodes .
To manage a large number of worker nodes, more powerful master nodes should be chosen. For example, kube-up the correct size VM for the master node based on the number of worker nodes. That is, the more worker nodes there are, the more powerful the master nodes need to be.
To address these specific issues, there are specialized developments such as This system allows bypassing limitations and building clusters with an enormous number of worker nodes.
Disadvantage #2. More overhead.
On each worker node, Kubernetes runs a set of system daemons—these include the container runtime (e.g., Docker), kube-proxy, and kubelet, including cAdvisor. Together, they consume a certain fixed amount of resources.
If you have many small nodes, the share of these overheads on each node is larger. For instance, imagine that all the system daemons of one node together use 0.1 CPU core and 0.1 GB of memory. If you have one ten-core node with 10 GB of memory, the daemons consume 1% of the cluster's capacity. On the other hand, on ten single-core nodes with 1 GB of memory each, the daemons would take 10% of the cluster's capacity.
Thus, the fewer nodes there are, the more efficiently the infrastructure is utilized.
Disadvantage #3. Inefficient resource utilization.
On small nodes, it may happen that the remaining fragments of resources are too small to be assigned any workload, so they remain unused.
For example, each pod requires 0.75 GB of memory. If you have ten nodes, and each has 1 GB of memory, you can run ten pods—in total, each node will have 0.25 GB of unused memory.
This means that 25% of the total cluster memory is wasted.
On a large node with 10 GB of memory, you can run 13 such modules—and there will be only one unused fragment of 0.25 GB left.
In this case, only 2.5% of the memory is wasted.
Derfor udnyttes ressourcerne mere optimalt på store noder.
Flere store noder eller mange små?
Så hvad er bedst: flere store noder i et cluster eller mange små? Som altid er der ikke et entydigt svar. Meget afhænger af typen af applikation.
For eksempel, hvis applikationen kræver 10 GB hukommelse, er valget klart til fordel for store noder. Men hvis applikationen kræver ti gange replikering for høj tilgængelighed, er det tvivlsomt, om man bør tage chancer og placere replikaer på kun to noder – der skal være minimum ti noder i clustret.
I mellemsituationer bør du træffe et valg baseret på fordele og ulemper ved hver mulighed. Nogle argumenter kan være mere relevante for din situation end andre.
Det er slet ikke nødvendigt at gøre alle noder samme størrelse. Der er intet, der forhindrer, at du først eksperimenterer med noder af samme størrelse, for derefter at tilføje noder af en anden størrelse og kombinere dem i clustret. Arbejdsnoderne i Kubernetes-clustret kan være helt heterogene. Så du kan prøve at kombinere fordelene ved begge tilgange.
Der findes ikke en universel opskrift, da hver situation har sine nuancer, og kun produktionen vil vise sandheden.
Oversættelsen er udført af cloudplatformteamet .
Mere om Kubernetes: .
Kilde: habr.com
