

CAP-teoremet er hjørnestenen i teorien om distribuerede systemer. Diskussionerne omkring den ebber selvfølgelig ikke ud; definitionerne er ikke kanoniske, og der findes ikke noget strengt bevis... Ikke desto mindre forstår vi intuitivt, at teoremet er gyldigt, når vi står fast på sund fornuft™.
Det eneste, der ikke er åbenlyst, er betydningen af bogstavet "P". Når en klynge deles, beslutter den, om den ikke vil svare, indtil der er opnået quorum, eller om den vil give de data, der er tilgængelige. Afhængigt af resultatet af dette valg klassificeres systemet enten som CP eller AP. Cassandra, for eksempel, kan fungere både som det ene og det andet, afhængigt ikke kun af klyngens indstillinger, men også af parametrene for hver enkelt forespørgsel. Men hvis systemet ikke er "P", og det deler sig, hvad så?
Svaret på dette spørgsmål er lidt overraskende: En CA-klynge kan ikke deles.
Hvad er det så for en klynge, der ikke kan deles?
Et uundgåeligt kendetegn ved en sådan klynge er et fælles datalagringssystem. I de fleste tilfælde betyder det tilslutning via SAN, hvilket begrænser anvendelsen af CA-løsninger til store virksomheder, der er i stand til at vedligeholde en SAN-infrastruktur. For at flere servere kan arbejde med de samme data, er en klynge-filsystem nødvendig. Sådanne filsystemer findes i porteføljerne fra HPE (CFS), Veritas (VxCFS) og IBM (GPFS).
Oracle RAC
Real Application Cluster-optionen blev første gang introduceret i 2001 med udgivelsen af Oracle 9i. I en sådan klynge arbejder flere instanser server med den samme database.
Oracle kan arbejde både med et klynge-filsystem og med sin egen løsning - ASM, Automatic Storage Management.
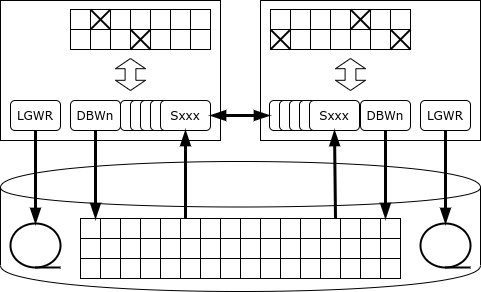
Hver instans fører sin egen log. En transaktion udføres og registreres af én instans. I tilfælde af nedbrud læser en af de overlevende knuder i klyngen (instanserne) dens log og gendanner de tabte data – på grund af dette sikres tilgængeligheden.
Alle instanser understøtter deres egen cache, og de samme sider (blokke) kan være til stede samtidig i cachen af flere instanser. Mere end det, hvis en instans har brug for en bestemt side, og den findes i cachen af en anden instans, kan den hente den fra "naboen" ved hjælp af cache fusion-mekanismen i stedet for at læse den fra disken.
Men hvad sker der, hvis en af instanserne har brug for at ændre data?
Et træk ved Oracle er, at det ikke har en dedikeret låneservice: hvis en server ønsker at låse en række, bliver låseoptegnelsen sat direkte på den hukommelsesside, hvor den låste række befinder sig. Takket være denne tilgang er Oracle en mester i ydeevne blandt monolitiske databaser: låneservice bliver aldrig en flaskehals. Men i en klyngekonfiguration kan en sådan arkitektur føre til intensiv netværkstrafik og gensidige låsninger.
Så snart en optegnelse låses, underretter instansen alle andre instanser om, at siden, der indeholder denne optegnelse, er blevet taget i monopoltilstand. Hvis en anden instans har brug for at ændre optegnelsen på samme side, skal den vente, indtil ændringerne på siden er blevet bekræftet, dvs. informationen om ændringen ikke er blevet skrevet til loggen på disken (mens transaktionen kan fortsætte). Det kan også ske, at siden ændres sekventielt af flere instanser, og så må man ved skrivning af siden til disken finde ud af, hvem der har den seneste version af denne side.
Tilfældige opdateringer af de samme sider gennem forskellige RAC-noder fører til et kraftigt fald i databasens ydeevne – til det punkt, at klyngens ydeevne kan være lavere end ydeevnen for en enkelt instans.
Korrekt brug af Oracle RAC indebærer en fysisk opdeling af data (f.eks. ved hjælp af mekanismen til partitionerede tabeller) og adgangen til hver sektion gennem en dedikeret node. Hovedformålet med RAC er ikke horisontal skalering, men at sikre fejltolerance.
Hvis en node holder op med at svare på heartbeat, starter den node, der opdager dette først, en afstemningsprocedure på disken. Hvis den manglende node heller ikke registreres her, overtager en af noderne ansvaret for at genoprette data:
- «fryser» alle sider, der var i cache hos den manglende node;
- læser logfilerne (redo) fra den manglende node og anvender igen ændringerne, der er skrevet i disse logfiler, samtidig med at det tjekker, om der er nyere versioner af de ændrede sider hos andre noder;
- ruller uafsluttede transaktioner.
For at lette skiftet mellem noder introducerer Oracle begrebet service – en virtuel instans. En instans kan håndtere flere services, og en service kan flytte mellem noder. En anvendelsesinstans, der betjener en bestemt del af databasen (f.eks. en gruppe kunder), arbejder med én service, og servicen, der ansvarer for denne del af databasen, flytter til en anden node i tilfælde af, at en node fejler.
IBM Pure Data Systems for Transactions
Klynge-løsningen for databaser dukkede op i den Blå Gigants portefølje i 2009. Ideologisk set er det en efterfølger til klyngen Parallel Sysplex, opbygget på 'almindeligt' udstyr. I 2009 blev produktet DB2 pureScale udgivet som en softwarepakke, og i 2012 tilbyder IBM en software-hardware pakke (appliance) kaldet Pure Data Systems for Transactions. Det må ikke forveksles med Pure Data Systems for Analytics, som blot er et omdøbt Netezza.
Architekturen pureScale ligner ved første øjekast Oracle RAC: På samme måde er flere noder tilsluttet et fælles datalager, og på hver node kører sin egen databaseinstans med sine egne hukommelsesområder og transaktionslogger. Men i modsætning til Oracle har DB2 en dedikeret låneservice, repræsenteret ved et sæt af processer db2LLM*. I klyngekonfigurationen flyttes denne service til en separat node, som i Parallel Sysplex kaldes coupling facility (CF), og i Pure Data – PowerHA.
PowerHA tilbyder følgende tjenester:
- låneadministrator;
- global buffer cache;
- område for inter-proces kommunikation.
For at overføre data fra PowerHA til databasenoderne og tilbage bruges fjernadgang til hukommelse, derfor skal klyngeinterkonnektet understøtte RDMA-protokollen. PureScale kan bruge både Infiniband og RDMA over Ethernet.
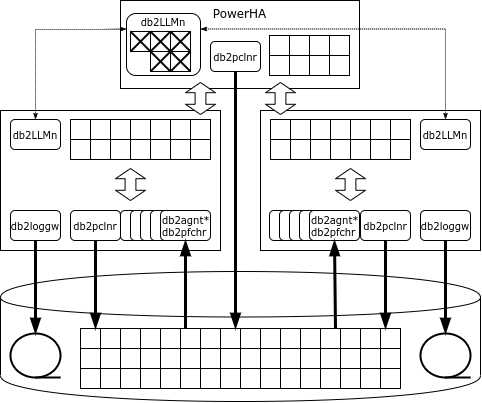
Hvis en node har brug for en side, som ikke er i cachen, anmoder noden om siden i den globale cache, og kun hvis den heller ikke findes der, læses den fra disken. I modsætning til Oracle går anmodningen kun til PowerHA, ikke til nabonoder.
Hvis instansen planlægger at ændre en række, låser den den i eksklusiv tilstand og siden, hvor rækken befinder sig, i delt tilstand. Alle låsninger registreres i den globale låsemanager. Når transaktionen er afsluttet, sender noden en besked til låsemanageren, som kopierer den ændrede side til den globale cache, løfter låsene og invalidere den ændrede side i cachen på andre noder.
Hvis den side, der indeholder den ændrede række, allerede er låst, vil låsemanageren læse den ændrede side fra hukommelsen på den node, der har foretaget ændringen, løfte låsen, invalidere den ændrede side i cachen på andre noder og give låsen på siden tilbage til noden, der anmodede om den.
«Snuskede», det vil sige ændrede, sider kan skrives til disk både fra en almindelig node og fra PowerHA (castout).
Ved fejl på en af noderne er pureScale-gendannelsen kun begrænset til de transaktioner, som ikke var afsluttet på tidspunktet for fejlen: sider, der var ændret af denne node i afsluttede transaktioner, er tilgængelige i den globale cache på PowerHA. Noden genstartes i en begrænset konfiguration på en af clusterets servere, ruller de uafsluttede transaktioner tilbage og frigiver låsene.
PowerHA fungerer på to servere, og hovednoden replikerer sin tilstand synkront. Ved fejl på hovednoden fortsætter PowerHA-klusteret med at arbejde med back-up noden.
Naturligvis, hvis man tilgår datasættet via én node, vil den samlede ydeevne af klusteret være højere. PureScale kan endda bemærke, at et bestemt datarum behandles af én node, hvorefter alle låsninger, der vedrører dette område, vil blive behandlet lokalt af noden uden kommunikation med PowerHA. Men så snart applikationen forsøger at tilgå disse data gennem en anden node, genoptages den centraliserede behandling af låsninger.
Intern IBM-test med en belastning bestående af 90% læsning og 10% skrivning, hvilket ligner en reel industriel belastning, viser næsten lineær skalering op til 128 noder. Testbetingelserne afsløres desværre ikke.
HPE NonStop SQL
Der egen højt tilgængelige platform findes også i Hewlett-Packard Enterprises portefølje. Dette er NonStop-platformen, som blev lanceret på markedet i 1976 af Tandem Computers. I 1997 blev firmaet opkøbt af Compaq, som igen blev en del af Hewlett-Packard i 2002.
NonStop bruges til at opbygge kritiske applikationer – eksempelvis HLR eller behandling af bankkort. Platformen leveres som en software-hardware kombination (appliance), der inkluderer beregningsnoder, datalagringssystem og kommunikationsudstyr. ServerNet-netværket (i moderne systemer – Infiniband) bruges både til kommunikation mellem noderne og til adgang til datalagringssystemet.
I de tidlige versioner af systemet blev der brugt proprietære processorer, som var synkroniserede med hinanden: alle operationer blev udført synkront af flere processorer, og så snart en processor fejlede, blev den deaktiveret, mens den anden fortsatte arbejdet. Senere overgik systemet til almindelige processorer (først MIPS, derefter Itanium og til sidst x86), og andre mekanismer blev brugt til synkronisering:
- beskeder: hver systemproces har en tvilling-«skygge», som den aktive proces periodisk sender beskeder om sin tilstand; ved fejl i den primære proces begynder skyggeprocessen sit arbejde fra det tidspunkt, der er bestemt af den seneste besked;
- afstemning: datalagringssystemet har en særlig hardwarekomponent, der modtager flere identiske anmodninger og udfører dem kun, hvis anmodningerne stemmer overens; i stedet for fysisk synkronisering arbejder processorerne asynkront, og deres resultater sammenlignes kun ved ind- og uddata.
Siden 1987 har der på NonStop-platformen fungeret et relationelt databasesystem – først SQL/MP, og senere SQL/MX.
Hele databasen opdeles i sektioner, hvor hver sektion styres af sin egen Data Access Manager (DAM). Den sikrer dataregistrering, caching og låsemekanismer. Behandling af data håndteres af executor-processer (Executor Server Process), der kører på de samme noder som de tilsvarende datamanagere. SQL/MX-planlæggeren fordeler opgaverne mellem executorerne og samler resultaterne. Til behov for samordnede ændringer anvendes en to-fase commit-protokol, som sikres af TMF-biblioteket (Transaction Management Facility).
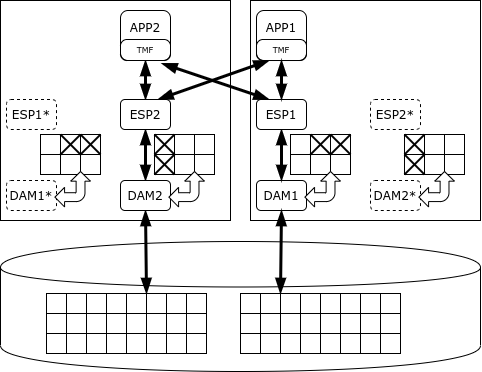
NonStop SQL kan prioritere processer, så lange analytiske forespørgsler ikke forstyrrer udførelsen af transaktioner. Dens formål er dog netop behandling af korte transaktioner, ikke analytisk bearbejdning. Udvikleren garanterer tilgængelighed af NonStop-klusteret på niveau fem «fem neuner», hvilket betyder, at nedetiden kun er 5 minutter om året.
SAP HANA
Den første stabile version af databasen HANA (1.0) blev lanceret i november 2010, og SAP ERP-pakken skiftede til HANA fra maj 2013. Platformen er baseret på købt teknologi: TREX Search Engine (til søgning i kolonnelager), P*TIME-database og MAX DB.
Selve ordet «HANA» er et akronym, High performance ANalytical Appliance. Denne database leveres i form af kode, der kan køre på alle x86-servere; dog er industrielle installationer kun tilladt på udstyr, der er blevet certificeret. Der er løsninger fra HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Nogle Lenovo-konfigurationer tillader endda drift uden SAN – GPFS-klusteret på lokale diske fungerer som delt lager.
I modsætning til de ovennævnte platforme er HANA en in-memory database, dvs. primære data gemmes i RAM, mens kun logs og periodiske snapshots skrives til disk – til gendannelse i tilfælde af fejl.
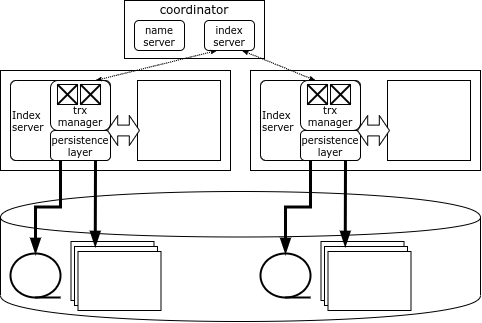
Hver node i HANA-klusteret er ansvarlig for sin egen del af dataene, og datakortet opbevares i en særlig komponent – Name Server, som ligger på koordinator-noden. Data mellem noderne duplikeres ikke. Oplysninger om låsninger opbevares også på hver node, men systemet har en global deadlock-detektor.
HANA-klienten indlæser clusterets topologi ved tilslutning og kan derefter direkte kommunikere med hvilken som helst node afhængigt af de nødvendige data. Hvis en transaktion kun involverer data fra én node, kan den udføres lokalt af denne node. Men hvis data fra flere noder ændres, kontakter initiatornoden koordinatornoden, som åbner og koordinerer den distribuerede transaktion og bekræfter den ved hjælp af en optimeret protokol for to-fase forpligtelse.
Koordinatornoden er duplikeret, så hvis koordinatoren fejler, træder en reserve-node straks i kraft. Men hvis en datanode fejler, er den eneste måde at få adgang til dens data at genstarte noden. I HANA-klynger har man typisk en reserve (spare) server for hurtigst muligt at kunne genstarte den tabte node.
Kilde: habr.com
