

Hej, Habr-folk. Som vi allerede har skrevet, lancerer OTUS i denne måned to kurser i maskinlæring, nemlig og . I den forbindelse fortsætter vi med at dele nyttigt materiale.
Formålet med denne artikel er at fortælle om vores første erfaring med .
Vi vil begynde med at se nærmere på dens tracking-server og logge alle iterationer af forskningen. Derefter deler vi erfaringer med at forbinde Spark med MLflow ved hjælp af UDF. Alpha Health
Kontext
Vi i Hovedformålet med MLflow er at give et ekstra lag oven på maskinlæring, så data science-specialister kan arbejde med stort set enhver maskinlæringsbibliotek (
MLflow
h2o, , , , og MLflow tilbyder tre komponenter:
Tracking
- – logging og forespørgsler om eksperimenter: kode, data, konfiguration og resultater. At følge processen med at skabe modellen er meget vigtigt. – En pakkeformat for at køre på enhver platform (for eksempel,
- Projects SageMaker )
- – et fælles format til at sende modeller til forskellige implementeringsværktøjer. MLflow (på tidspunktet for skrivningen i alpha-version) - en open source-platform, der giver mulighed for at administrere livscyklussen for maskinlæring, herunder eksperimenter, genbrug og implementering.
Konfiguration af MLflow
For at bruge MLflow skal du først konfigurere hele Python-miljøet, og til det vil vi bruge
PyEnv ). Så vi kan oprette et virtuelt miljø, hvor vi installerer alle nødvendige biblioteker. ``` pyenv install 3.7.0 pyenv global 3.7.0 # Brug Python 3.7 mkvirtualenv mlflow # Opret et Virtuelt Miljø med Python 3.7 workon mlflow ```
Lad os installere de nødvendige biblioteker.``` pip install mlflow==0.7.0 Cython==0.29 numpy==1.14.5 pandas==0.23.4 pyarrow==0.11.0 ```
Bemærk: Vi bruger PyArrow til at køre modeller som UDF. Versionerne af PyArrow og Numpy skulle rettes, da de nyeste versioner var i konflikt med hinanden.Lad os starte Tracking UI
Запускаем Tracking UI
MLflow Tracking giver os mulighed for at logge og anmode om eksperimenter ved hjælp af Python og API'en. Derudover kan vi definere, hvor artefaktmodellerne skal opbevares (localhost, , , eller ). Da vi i Alpha Health bruger AWS, vil S3 blive anvendt som lager for artefakter.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
MLflow anbefaler at bruge vedvarende filopbevaring. Filopbevaring er det sted, hvor serveren vil gemme metadata om kørsel og eksperimenter. Når serveren startes, skal du sørge for, at den peger på en vedvarende filopbevaring. I dette eksempel vil vi blot benytte /tmp.
Husk at, hvis vi ønsker at bruge mlflow-serveren til at køre gamle eksperimenter, skal de være til stede i filopbevaringen. Men selv uden dette ville vi kunne bruge dem i UDF, da vi kun har brug for stien til modellen.
Bemærk: Vær opmærksom på, at Tracking UI og modelklienten skal have adgang til artefaktets placering. Det vil sige, uanset om Tracking UI er placeret i en EC2-forekomst, skal maskinen have direkte adgang til S3 for at kunne skrive artefaktmodeller.
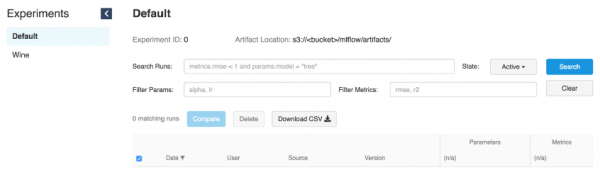
Tracking UI gemmer artefakter i en S3-bucket
Kørsel af modeller
Når Tracking-serveren er i drift, kan vi begynde at træne modeller.
Som et eksempel vil vi bruge vin-modifikationen fra MLflow-eksemplet i .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ration 0.5
  --wine_file ./data/winequality-red.csv
Som nævnt tidligere tillader MLflow os at logge parametre, metrics og artefakter af modeller, så vi kan følge med i, hvordan de udvikler sig gennem iterationer. Denne funktion er ekstremt nyttig, da vi kan reproducere den bedste model ved at kontakte Tracking-serveren eller forstå, hvilken kode der udførte den nødvendige iteration ved at bruge git hash loggene.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 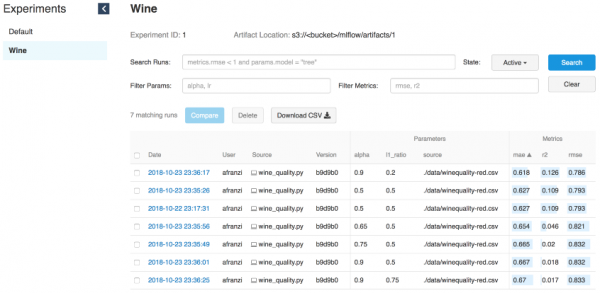
Wine-iterationer
Serverdelen for modellen
Tracking-server MLflow, der er startet med kommandoen “mlflow server”, har et REST API til at overvåge kørsel og registrere data i det lokale filsystem. Du kan angive adressen på tracking-serveren med miljøvariablen «MLFLOW_TRACKING_URI», og tracking API'et MLflow vil automatisk oprette forbindelse til tracking-serveren på denne adresse for at oprette/hente oplysninger om kørsel, logmetrics osv.
Kilde:
For at betjene modellen med en server skal vi have en aktiv tracking-server (se startgrænsefladen) og Run ID for modellen.
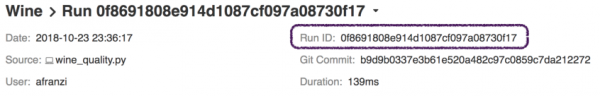
Run ID
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
For at betjene modeller med MLflow serve-funktionalitet har vi brug for adgang til Tracking UI for at hente oplysninger om modellen blot ved at angive --run_id.
Når modellen er forbundet til tracking-serveren, kan vi få en ny model-endpoint.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Kørsel af modeller fra Spark
Selvom tracking-serveren er kraftfuld nok til at betjene modeller i realtid, deres træning og brugen af serve-funktionalitet (kilde: ), er brugen af Spark (batch eller streaming) en endnu mere kraftfuld løsning takket være distribueret behandling.
Forestil dig, at du lige har trænet offline og derefter anvendt den uddannede model på alle dine data. Det er her, Spark og MLflow virkelig skinner.
Installér PySpark + Jupyter + Spark
Kilde:
For at demonstrere, hvordan vi anvender MLflow-modeller til Spark DataFrames, skal vi konfigurere samarbejdet mellem Jupyter notebooks og PySpark.
Begynd med at installere den seneste stabile version :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Installer PySpark og Jupyter i et virtuelt miljø:
pip install pyspark jupyterKonfigurer miljøvariabler:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Ved at definere notebook-dir, kan vi opbevare vores notebooks i den ønskede mappe.
Starter Jupyter fra PySpark
Da vi har været i stand til at konfigurere Jupyter som PySpark-driver, kan vi nu køre Jupyter notebook i sammenhæng med PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] sparkmagic-udvidelse aktiveret!
[I 19:05:01.573 NotebookApp] Serverer notebooks fra lokal mappe: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] Jupyter Notebook kører på:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Brug Control-C til at stoppe denne server og lukke alle kerner (tryk to gange for at springe bekræftelsen over).
[C 19:05:01.574 NotebookApp]

    Kopier/indsæt denne URL i din browser, når du tilkobler for første gang,
    for at logge ind med en token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Som nævnt tidligere giver MLflow mulighed for logning af modelartefakter til S3. Når vi har den valgte model i hænderne, kan vi importere den som UDF ved hjælp af modulet mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "fixed acidity", "volatile acidity", "citric acid",
            "residual sugar", "chlorides", "free sulfur dioxide",
            "total sulfur dioxide", "density", "pH",
            "sulphates", "alcohol"
          ]

df.withColumn('prediction', wine_udf(*columns)).show(100, False) 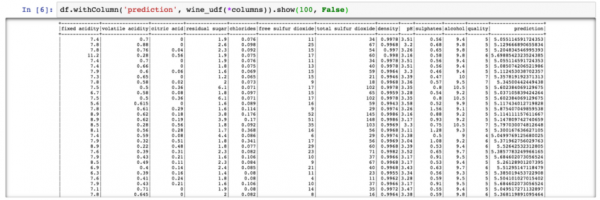
PySpark – Udfald af vinens kvalitet
Indtil nu har vi talt om, hvordan man bruger PySpark med MLflow ved at køre kvalitetsprognoser på hele datamængden af vin. Men hvad nu, hvis man ønsker at bruge MLflow-moduler fra Scala Spark?
Vi har testet dette ved at dele Spark-konteksten mellem Scala og Python. Det vil sige, at vi registrerede MLflow UDF i Python og brugte den fra Scala (ja, det er muligvis ikke den bedste løsning, men det er hvad vi har).
Scala Spark + MLflow
Til dette eksempel vil vi tilføje til den eksisterende Jupyter.
Installerer Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Tilgængelige kerner:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Som det ses fra den vedhæftede notebook, bruges UDF i samarbejde med Spark og PySpark. Vi håber, at denne del vil være nyttig for dem, der elsker Scala og ønsker at implementere maskinlæringsmodeller i produktion.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Næste skridt
Selvom MLflow på tidspunktet for denne artikel er i alpha-version, ser det ret lovende ud. Muligheden for at køre flere maskinlæringsrammer og bruge dem fra et enkelt endpoint løfter anbefalingssystemer til et nyt niveau.
Derudover bringer MLflow dataingeniører og datavidenskabsfolk tættere sammen ved at etablere et fælles lag mellem dem.
Efter denne undersøgelse af MLflow er vi sikre på, at vi vil gå videre og bruge den til vores Spark-pipelines og i anbefalende systemer.
Det ville være godt at synkronisere filsystemet med databasen i stedet for filsystemet. På den måde bør vi få flere slutpunkter, der kan bruge det samme filsystem. For eksempel ved at bruge flere instanser og med den samme Glue metastore.
Afslutningsvis vil jeg gerne takke MLFlow-fællesskabet for at gøre vores arbejde med data mere interessant.
Hvis du eksperimenterer med MLflow, er du velkommen til at skrive til os og fortælle, hvordan du bruger det, især hvis du bruger det i produktionen.
Lær mere om kurserne:
Læs mere:
Kilde: habr.com
