

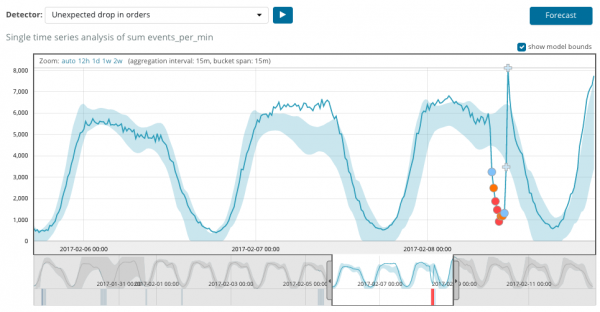
Vi minder om, at Elastic Stack bygger på den ikke-relationelle database Elasticsearch, webgrænsefladen Kibana og databehandlingsbehandlere (den mest kendte er Logstash, samt forskellige Beats, APM og andre). En af de behagelige tilføjelser til hele dette produktstack er dataanalyse ved hjælp af maskinlæringsalgoritmer. I artiklen undersøger vi, hvad disse algoritmer indebærer. Vi inviterer dig til at læse videre.
Maskinlæring er en betalt funktion i det betinget gratis Elastic Stack og er inkluderet i X-Pack-pakken. For at begynde at bruge det er det tilstrækkeligt at aktivere en 30-dages prøveversion efter installationen. Efter prøvetidens udløb kan du anmode om støtte til forlængelse eller købe et abonnement. Abonnementsprisen beregnes ikke ud fra datamængden, men ud fra antallet af anvendte noder. Nej, datamængden påvirker naturligvis antallet af nødvendige noder, men alligevel er denne tilgang til licensering mere menneskelig i forhold til virksomhedens budget. Hvis der ikke er behov for høj ydeevne, kan man også spare penge.
ML i Elastic Stack er skrevet i C++ og kører uden for JVM'en, hvor Elasticsearch selv kører. Det vil sige, at processen (den kaldes faktisk autodetect) bruger alt, hvad JVM'en ikke kan håndtere. På demonstrationsstandet er dette ikke så kritisk, men i et produktionsmiljø er det vigtigt at tildele separate noder til ML-opgaver.
Maskinlæringsalgoritmer deles op i to kategorier — og . I Elastic Stack er algoritmen fra kategorien 'uden lærer'. I kan du se den matematiske teori bag maskinlæringsalgoritmer.
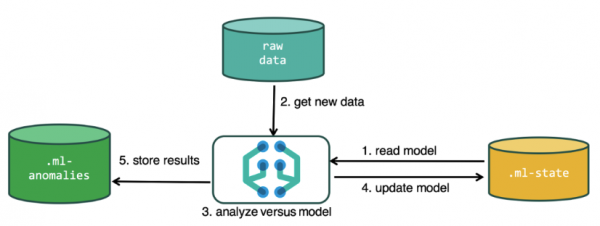
Til at udføre analysen bruger maskinlæringsalgoritmen data, der opbevares i indeksene i Elasticsearch. Opgaver til analyse kan skabes både fra Kibana-grænsefladen og gennem API'en. Hvis dette gøres via Kibana, er det ikke nødvendigt at vide visse ting. For eksempel, de ekstra indekser, som algoritmen bruger i sin drift.
Ekstra indekser, der bruges under analysen.ml-state — information om statistiske modeller (analyseindstillinger);
.ml-anomalies-* — resultaterne af ML-algoritmernes arbejde;
.ml-notifications — indstillinger for underretninger baseret på analyseresultater.
Data strukturen i Elasticsearch-databasen består af indekser og de dokumenter, der er gemt i dem. Sammenlignet med en relationel database kan et indeks sammenlignes med databasens skema, mens et dokument svarer til en post i en tabel. Denne sammenligning er betinget og er givet for at forenkle forståelsen af det følgende materiale for dem, der kun har hørt om Elasticsearch.
Gennem API'et er den samme funktionalitet tilgængelig som via webgrænsefladen, så for klarhed og forståelse af koncepternes betydning vil vi vise, hvordan man konfigurerer gennem Kibana. I venstre menu er der et afsnit om Machine Learning, hvor man kan oprette en ny opgave (Job). I Kibana-grænsefladen ser dette ud som på billedet nedenfor. Nu vil vi gennemgå hver type opgave og vise de analyser, som man kan konstruere her.
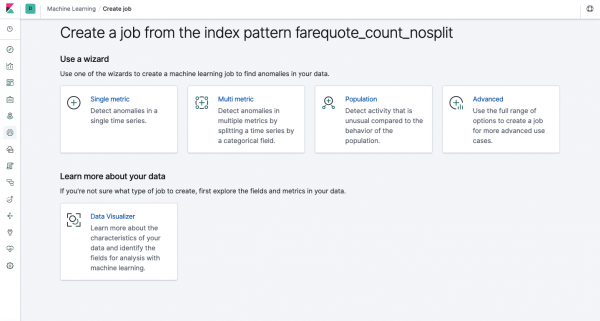
Single Metric — analyse af én metrik, Multi Metric — analyse af to eller flere metrikker. I begge tilfælde analyseres hver metrik i et isoleret miljø, dvs. algoritmen tager ikke hensyn til adfærden af de parallelt analyserede metrikker, som kunne være indtryk i tilfælde af Multi Metric. For at udføre beregninger under hensyntagen til korrelationen mellem forskellige metrikker kan man anvende Population-analyse. Advanced — det er finjustering af algoritmerne med yderligere muligheder til specifikke opgaver.
Single Metric
Analysen af ændringer i en enkelt metrik — den enkleste, man kan udføre her. Efter at have trykket på Create Job, vil algoritmen lede efter anomalier.
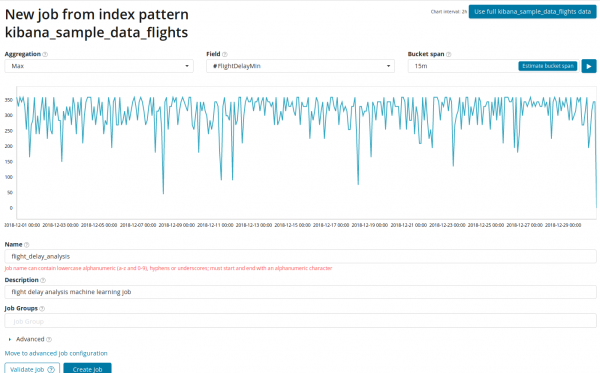
I feltet Aggregation kan man vælge tilgang til at finde anomalier. For eksempel, ved Min vil værdier under de typiske blive betragtet som anomale. Der er Max, High Mean, Low, Mean, Distinct og andre. Beskrivelsen af alle funktioner kan ses .
I feltet Field angiver det numeriske felt i dokumentet, som vi vil analysere.
I feltet er granulariteten af intervallerne på tidslinjen, som analysen vil blive udført over. Man kan stole på automatikken eller vælge manuelt. På billedet nedenfor er et eksempel på for lav granularitet — du kan gå glip af en anomali. Med denne indstilling kan man ændre algoritmens følsomhed over for anomalier.
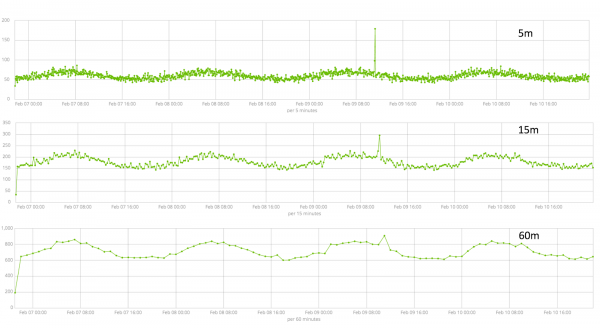
Datavarighed er en nøglefaktor, der påvirker effektiviteten af analysen. Under analysen identificerer algoritmen gentagne intervaller, beregner konfidensintervallet (baseline) og afslører anomalier - atypiske afvigelser fra normal adfærd for metrikken. Bare som et eksempel:
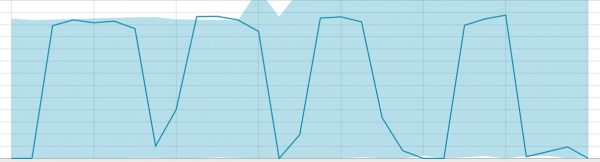
Baselines ved et lille datainterval:
Når algoritmen har noget at lære af - ser baselines således ud:
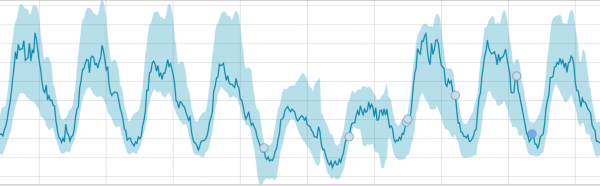
Efter opstart af opgaven identificerer algoritmen anomale afvigelser fra normen og rangerer dem efter sandsynligheden for anomalier (farven på den tilsvarende mærkning er angivet i parentes):
Warning (blå): mindre end 25
Minor (gul): 25-50
Major (orange): 50-75
Critical (rød): 75-100
I grafen nedenfor er et eksempel med fundne anomalier.
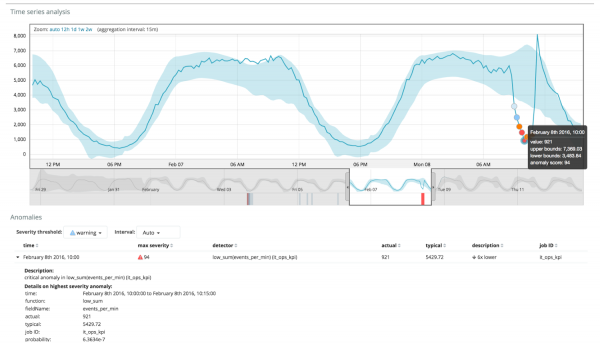
Her ses tallet 94, som angiver sandsynligheden for en anomali. Det er klart, at da værdien er tæt på 100, så står vi over for en anomali. I kolonnen under grafen er den uværdigt lille sandsynlighed på 0.000063634% for, at der optræder en metrikværdi der.
Udover at finde anomalier kan man i Kibana starte forudsigelse. Det gøres enkelt og fra den samme visning med anomalier - knappen Forecast i øverste højre hjørne.
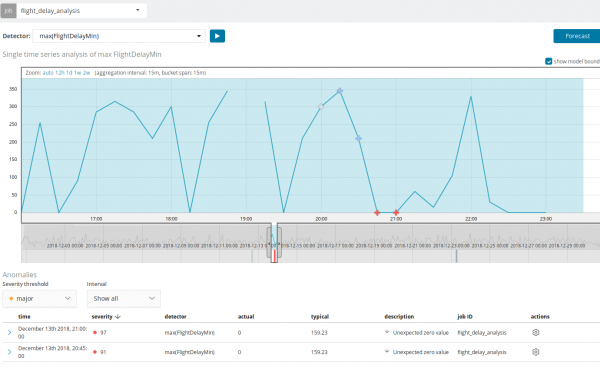
Forudsigelsen laves maksimalt 8 uger frem. Selv hvis man virkelig gerne vil - må man ikke mere af design.
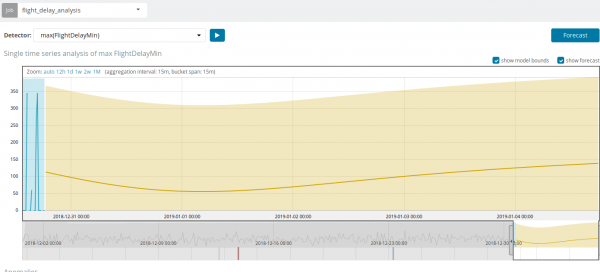
I nogle situationer vil forudsigelsen være meget nyttig, f.eks. når man overvåger brugerbelastningen på infrastrukturen.
Multi Metric
Vi går videre til den næste mulighed for ML i Elastic Stack - analysen af flere metrikker på én gang. Men det betyder ikke, at man vil analysere afhængigheden af én metrik fra en anden. Det er det samme som Single Metric, dog med flere metrikker på én skærm for nem sammenligning af indflydelsen af den ene på den anden. Vi vil fortælle om analysen af afhængighed af én metrik fra en anden i afsnittet Population.
Når man trykker på kvadraten med Multi Metric, vises et vindue med indstillinger. Vi stopper ved dem i detaljer.
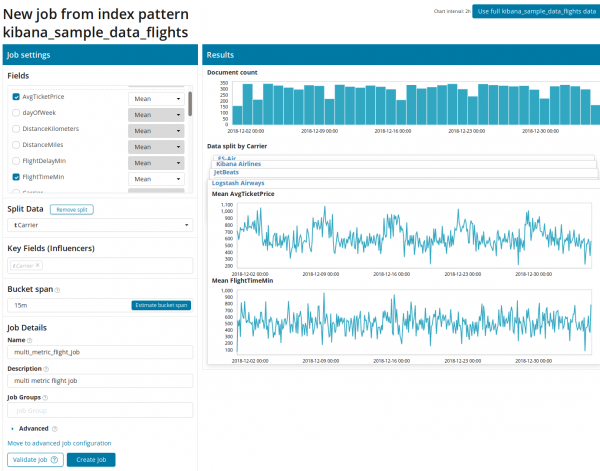
For at starte skal man vælge felter til analyse og aggregere dataene efter dem. Aggregationsmulighederne her er de samme som for Single Metric (Max, High Mean, Low, Mean, Distinct og andre). Derefter kan dataene, hvis ønskes, opdeles baseret på et af felterne (feltet Split Data). I eksemplet har vi gjort dette efter feltet OriginAirportID. Bemærk, at grafen for metrikkerne til højre nu vises som en mængde grafer.
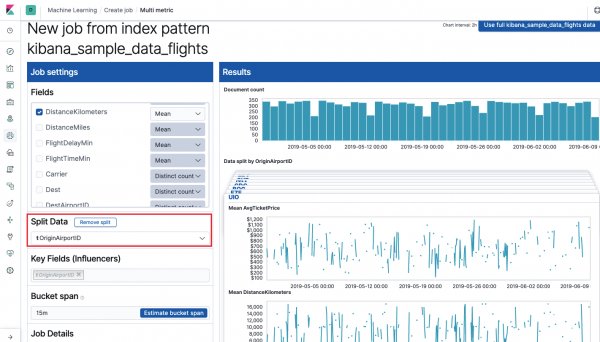
Felt Key Fields (Influencers) har direkte indflydelse på de fundne anomalier. Som standard vil der altid være mindst én værdi her, og du kan tilføje flere. Algoritmen vil tage hensyn til indflydelsen fra disse felter under analysen og vise de mest 'indflydelsesrige' værdier.
Efter lanceringen vil grænsefladen i Kibana se omtrent sådan her ud.
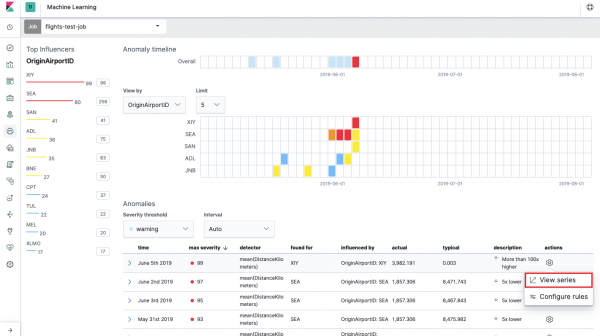
Dette er den såkaldte varmekort over anomalier for hvert feltværdi OriginAirportID, som vi angav i Split Data. Som i tilfælde af Single Metric, angiver farven niveauet af anomalt afvigelse. En lignende analyse kan nemt udføres, for eksempel for arbejdsstationer for at overvåge dem, hvor der er usædvanligt mange godkendelser osv. Vi har allerede skrevet , som også kan samles og analyseres her.
Under varmekortet er der en liste over anomalier, hvorfra hver sektion kan lede til Single Metric visningen for en detaljeret analyse.
Population
For at søge efter anomalier blandt korrelationer mellem forskellige målinger i Elastic Stack er der en specialiseret Population-analyse. Det er netop ved hjælp af denne, at vi kan lede efter anomale værdier i ydeevnen for en bestemt server i forhold til de andre, for eksempel ved en stigning i antallet af forespørgsler til det målrettede system.
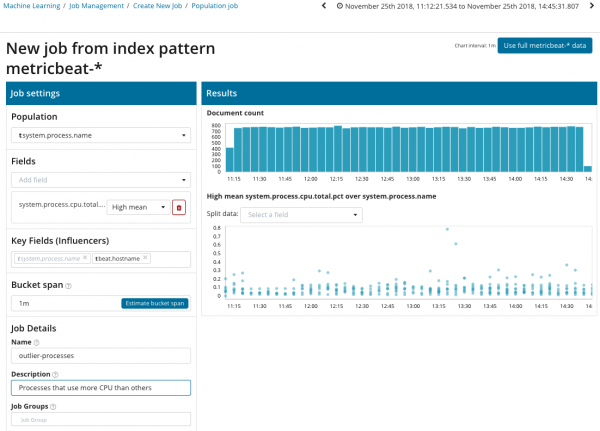
I denne illustration er feltet Population angivet med værdien, som de analyserede målinger vil relatere sig til. I dette tilfælde er det procesnavnet. Som et resultat vil vi se, hvordan CPU-belastningen fra hver af processerne influerede hinanden.
Bemærk, at grafen over de analyserede data adskiller sig fra tilfældene med Single Metric og Multi Metric. Det er gjort i Kibana by design for at forbedre opfattelsen af fordelingen af værdier i de analyserede data.
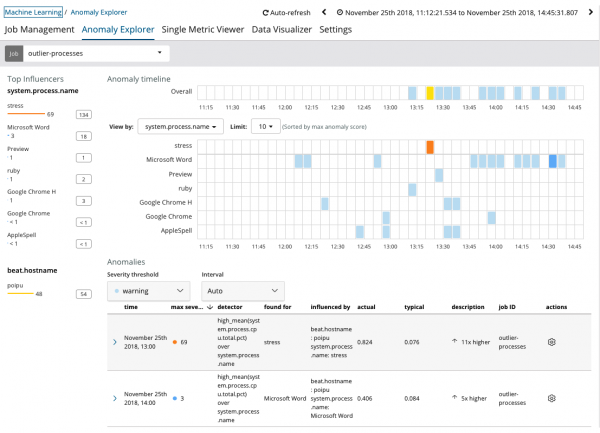
Fra grafen ses det, at processen stress (for at nævne, skabt af et specialværktøj) på serveren poipu, som havde indflydelse (eller var influencer) på opståen af denne anomali.
Avanceret
Analyse med præcise indstillinger. Ved Advanced analyse i Kibana vises der yderligere indstillinger. Efter at have trykket på menuen for at oprette på Advanced-flisen vises et vindue med faner. Fanen Job Details blev bevidst sprunget over, da der er grundlæggende indstillinger, der ikke relaterer sig direkte til indstillingen af analysen.
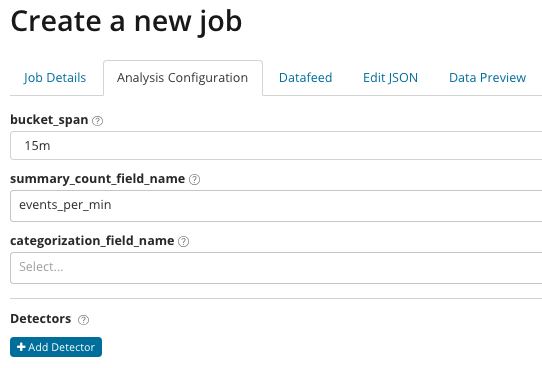
I summary_count_field_name kan valgfrit angives som navnet på feltet i dokumenterne, der indeholder aggregerede værdier. I dette eksempel — antal begivenheder pr. minut. I angiver navnet på feltværdien fra dokumentet, som indeholder en variabel værdi. Ved hjælp af masken for dette felt kan de analyserede data opdeles i undergrupper. Vær opmærksom på knappen Tilføj detektor på det forrige illustration. Nedenfor er resultatet af at trykke på denne knap.
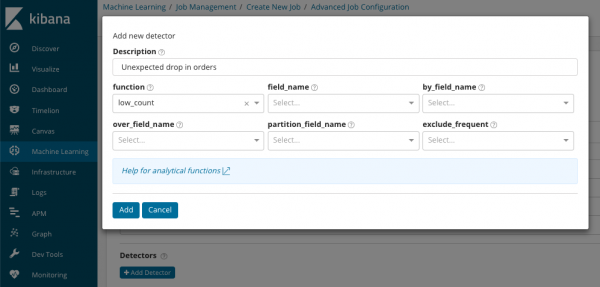
Her er et ekstra indstillingsområde til at tilpasse anomalidetektoren til en bestemt opgave. Vi planlægger at gennemgå specifikke brugssager (især inden for sikkerhed) i kommende artikler. For eksempel, en af de gennemgåede sager. Den relaterer sig til at finde sjældent forekommende værdier og implementeres .
I feltet funktion kan du vælge en bestemt funktion til at finde anomalier. Udover rare, er der et par interessante funktioner — . De afslører anomalier i adfærden af metrikker i løbet af dagen eller ugen henholdsvis. De øvrige analysefunktioner .
I field_name angiver feltet i dokumentet, som analysen vil baseres på. By_field_name kan bruges til at opdele analyseresultaterne efter hver enkelt værdi af det angivne felt i dokumentet. Hvis du udfylder over_field_name vil du få en population-analyse, som vi nævnte tidligere. Hvis du angiver en værdi i partition_field_name, så vil separate basislinjer beregnes for hver værdi i dette dokumentfelt (hver værdi kan for eksempel være navnet på serveren eller processen på serveren). I exclude_frequent kan du vælge alle eller ingen, hvilket vil betyde udelukkelse (eller inkludering) af ofte forekommende værdier fra dokumentfelterne.
I artiklen forsøgte vi så kortfattet som muligt at give en præsentation af maskinlæringens muligheder i Elastic Stack, men der er stadig mange detaljer tilbage. Del i kommentarerne, hvilke sager du har løst ved hjælp af Elastic Stack, og til hvilke opgaver du bruger det. Du kan kontakte os via private beskeder på Habr eller .
Kilde: habr.com
