

Mit navn er Sergey, jeg er fra ITSumma, og jeg vil gerne fortælle dig, hvordan vi håndterer reservede i Kubernetes. I den seneste tid har jeg arbejdet meget med rådgivning om implementering af forskellige devops-løsninger for forskellige teams, og jeg arbejder især tæt med projekter, der bruger K8s. På konferencen Uptime day 4, der var dedikeret til reservede i komplekse arkitekturer, holdt jeg et oplæg om reservede af "terningen", og her er en fritstående genfortælling. Jeg vil kun advare på forhånd om, at det ikke er en direkte handlingsvejledning, men snarere en opsummering af tanker om emnet.
Generelt set er overvågning og reservede to grundlæggende værktøjer til at øge fejlmodstandsdygtigheden i ethvert projekt. Men i Kubernetes balancerer alt af sig selv, vil du sige, alt skaleres af sig selv, og hvis noget sker, vil det rejse sig af sig selv… Så ved en første overfladisk undersøgelse af emnet svarede internettet mig på spørgsmålet om, hvordan man tilgår reservede i K8s: «hvorfor?» Mange mener, at Kubernetes er en magisk ting, der fjerner alle infrastrukturproblemer og sikrer, at projektet aldrig falder. Men... verden er ikke, hvad den ser ud til.
Hvordan tilgik vi reservedeprocessen før? Vi havde identiske platforme til hosting - enten virtuelle maskiner eller fysiske servere, serveresom vi anvendte tre grundlæggende praksisser på:
- synkronisering af kode og statisk indhold
- synkronisering af konfigurationer
- replicering af databaser
Og voilà: på ethvert tidspunkt kan vi skifte til den reservede platform, alle er glade, vi rejser os og går hver til sit.
Hvad tilbyder vi for at øge den kontinuerlige tilgængelighed af vores Kubernetes-applikation? Det første, som den uofficielle dokumentation nævner, er at opsætte mange maskiner og have mange mestre - antallet skal opfylde kravene til at opnå quorum i klyngen, og på hver af mestrene skal etcd, api, MC, scheduler... være opsat. Og det ser ud til at fungere godt: når flere arbejdsnoder eller mestre fejler, vil vores klynge genbalanceres, og applikationen fortsætter med at fungere. Det ser igen ud som magi! Men ofte befinder vores klynge sig inden for en enkelt datacenter, og det kan rejse nogle spørgsmål. Hvad hvis en gravemaskine ankommer og graver en kabel op, lynet slår ned, der opstod en universel oversvømmelse? Alt er gone, vores klynge findes ikke længere. Hvordan nærmer vi os redundans med denne side af problemet i tankerne?
Først og fremmest skal du have en anden klynge i hot standby, det vil sige en klynge, som du kan skifte til på et hvilket som helst tidspunkt. Set fra Kubernetes' perspektiv skal infrastrukturen være fuldstændig identisk. Det vil sige, hvis der findes nogle ikke-standard plugins til filsystemet, brugerdefinerede løsninger til ingress, skal de være fuldstændig identiske på dine to (eller tre, eller ti, alt efter hvor mange ressourcer og administratorer du har) klynger. Det er nødvendigt klart at definere to sæt applikationer (deployments, statefulsets, daemonsets, cronjobs osv.): hvilke af dem kan køre på standby konstant, og hvilke er bedre ikke at starte, før der er behov for skift.
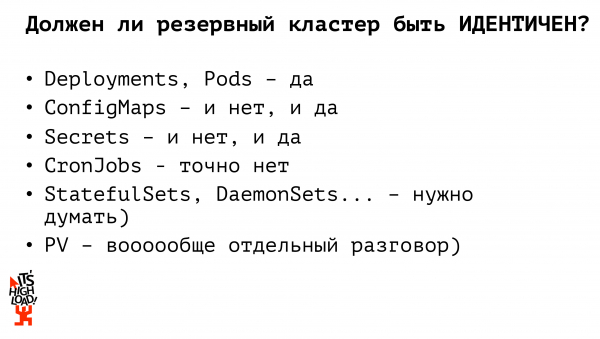
Skal vores reserveklynge så være fuldstændig identisk med vores produktionsklynge? Nej. Hvis vi før i arbejdet med monolitiske projekter og fysisk infrastruktur holdt et praktisk set identisk miljø, så mener jeg, at dette ikke bør være tilfældet i forbindelse med Kubernetes. Lad os se på, hvorfor.
For eksempel, lad os starte med de grundlæggende enheder i Kubernetes – deployments – de skal være identiske. Applikationerne skal være aktive, så de på ethvert tidspunkt kan overtage behandlingen af trafikken og lade vores projekt fortsætte med at fungere. Når vi taler om konfigurationsfiler, skal vi vurdere, om de skal være identiske eller ej. Det vil sige, hvis vi, kloge mennesker, ikke bruger nogen forbudte stoffer og ikke opbevarer databasen i K8s, så skal vores configmaps indeholde indstillinger for adgang til produktionsdatabasen (denne reservationsproces er bygget separat). Tilsvarende for at sikre adgang til den sikkerhedskopierede database skal vi have en separat konfigurationsfil (configmap). Ligeledes arbejder vi med secrets: adgangskoder til databaseadgang, API-nøgler; på ethvert tidspunkt kan vi have enten en produktionssecret eller en sikkerhedskopieret. Således har vi allerede to Kubernetes-enheder, hvis sikkerhedskopier ikke bør være identiske med produktionsversionerne. Den næste enhed, vi skal stoppe ved, er cronjob. Cronjobs på reservestrukturen må under ingen omstændigheder være identiske med mængden af cronjobs i produktionsklusteret! Hvis vi opsætter et reserveret kluster og aktiverer det fuldt ud med alle aktiverede cronjobs – så for eksempel vil folk modtage to e-mails fra dig på én gang i stedet for én. Eller en data-synkronisering med eksterne kilder vil finde sted to gange, hvilket resulterer i, at vi begynder at føle os dårlige, græde, skrige og finde os irriterede.
Hvordan foreslår folk fra internettet, at vi organiserer et sikkerhedskopieringskluster? Det næst mest populære svar efter "hvorfor?" – brug af Kubernetes Federation.
Hvad er det? Det er, lad os sige, et stort meta-kluster. Hvis vi forestiller os Kubernetes-arkitekturen — hvor vi har en master og flere noder — så har vi også en master og flere noder i forhold til federation, men hver node er et separat kluster. Det vil sige, at vi arbejder med de samme enheder, de samme primitive, som vi gør med en enkelt Kubernetes, men vi håndterer ikke vores fysiske maskiner, men hele klynger. Inden for federationen har vi fuld synkronisering af de federerede ressourcer fra forældre til børn. For eksempel, hvis vi har startet en deployment gennem federation — vil den blive deployeret til hver af vores datterklustre. Hvis vi tager en configmap eller hemmelighed og ruller den ud gennem federation — så vil det blive udbredt til alle vores datterklustre; samtidig tillader federation at tilpasse vores ressourcer på børnene. Det vil sige, at vi tog en configmap, deployerede den gennem federation, og hvis vi derefter har brug for at ændre noget på specifikke klustre, går vi ind og retter det på det enkelte kluster, og denne ændring vil ikke blive synkroniseret noget sted.
Kubernetes Federation - et relativt nyt værktøj, der ikke understøtter hele det sæt af ressourcer, som K8s selv tilbyder. På tidspunktet for udgivelsen af en af de første versioner af dokumentationen blev det nævnt, at der kun var understøttelse for config maps, deployment til replica set og ingress. Secrets blev ikke understøttet, og arbejde med volume var heller ikke understøttet. Det er et for begrænset sæt. Især hvis vi elsker at eksperimentere - for eksempel at overføre vores egne ressourcer til Kubernetes gennem custom resource definition - så kan vi ikke få dem ind i federation. Det er næsten en sandhed, men det betyder også, at vi periodisk skyder os selv i foden. På den anden side gør federation det muligt at administrere vores replicaset fleksibelt. For eksempel, hvis vi ønsker, at der skal køre 10 replikaer af vores applikation, vil federation som standard fordele dette antal proportionalt mellem antallet af klynger. Og alt dette kan også konfigureres! Vi kan for eksempel angive, at der på produktionsklyngen skal være 6 replikaer af vores applikation, mens der på testklyngen, for at spare ressourcer eller for egne eksperimenter, kun skal være 4 replikaer af vores applikation. Det er også ret praktisk. Men med federation skal vi bruge nogle nye løsninger, deploye noget undervejs, og tvinge os selv til at tænke en smule mere...
Kan vi gøre processen med at reservere Kubernetes lidt enklere? Hvilke værktøjer har vi overhovedet?
For det første har vi altid et slags CI/CD-system, så vi går ikke manuelt ind og skriver create/apply på serverne. Systemet genererer yaml-filer til vores containere.
For det andet har vi flere klynger, vi har enten en enkelt eller flere (hvis vi er smarte) registries, som vi også har taget og reserveret. Og der er det fantastiske værktøj kubectl, som kan arbejde med flere klynger samtidig.
Så her er jeg: efter min mening er den enkleste og mest korrekte løsning til opbygning af et backup-kluster en primitiv parallel deployment. Der er en eller anden pipeline i CI/CD-systemet; først bygger vi vores containere, tester dem og ruller applikationerne ud via kubectl på flere uafhængige klynger. Vi kan lave samtidige udrulninger til flere klynger. Derfor løser vi også leveringen af konfigurationer på dette trin. Vi kan på forhånd definere et sæt konfigurationer til vores produktionskluster, et sæt konfigurationer til backup-klusteret og på niveauet af CI/CD-systemet rulle produktionsmiljøet ud til produktionsklusteret og backup-miljøet til backup-klusteret. I forhold til federation behøver vi ikke at gå ind på hver underordnet klynge og redefinere noget efter at have bestemt den føderale ressource. Vi har gjort dette på forhånd. For en god indsats.
Men… der er… jeg havde skrevet, der er "roden til alt ondt", men der er faktisk to. For det første filsystemet. Der er en eller anden PV, eller vi bruger ekstern lagring. Hvis vi gemmer filer inden i klyngen, så skal vi handle efter gamle praksisser, som stammer fra tiden med fysiske infrastrukturer: for eksempel synkronisere med lsync. Eller en anden metode, du personligt foretrækker. Vi ruller alt ud på andre maskiner og lever videre.
For det andet, og faktisk en endnu vigtigere hæmsko — databasen. Hvis vi er kloge mennesker og ikke holder databasen i Kubernetes, så er data-backup-processen efter den samme gamle skema — master-slave replikation, derefter skifter vi, replikatet indhenter vi, og så lever vi godt. Men hvis vi holder vores DB inde i klyngen, så er der faktisk mange færdige løsninger til at organisere den samme master-slave replikation, mange løsninger til at oprette DB inde i Kubernetes.
Der er allerede læst en milliard præsentationer om database-backup, skrevet en milliard artikler, der er ikke noget nyt her, faktisk. Generelt skal du følge din drøm, leve som du vil, opfinde dig selv også nogle komplicerede løsninger, men sørg for at tænke over, hvordan du vil backup alt dette.
Lad os nu tale om, hvordan vi generelt vil håndtere overgangen til den reserveplacering i tilfælde af brand. For det første implementerer vi stateless-applikationer parallelt. De påvirker ikke forretningslogikken i vores applikationer, vores projekt, vi kan konstant have to sæt applikationer kørende, og de kan begynde at modtage trafik. Det er meget vigtigt under overgangen til den reserveplacering at se på, om konfigurationerne skal omdefineres. For eksempel har vi et produktions Kubernetes-klynge, en reserve Kubernetes-klynge, en ekstern masterdatabase og en reserve masterdatabase. Vi har fire muligheder for, hvordan disse applikationer i produktion kan interagere med hinanden. Vores database kan skifte, og det viser sig, at vi skal skifte trafikken på produktionsklusteret til den nye database, eller vores klynge kan gå ned — og vi skifter til reserve, men fortsætter med at arbejde med produktionsdatabasen, og så er der den tredje mulighed, hvor både dette og hint går ned, og vi skifter begge applikationer, omdefinerer vores konfiguration, så de nye applikationer arbejder med den nye database.
Så, hvad kan vi konkludere ud fra alt dette?
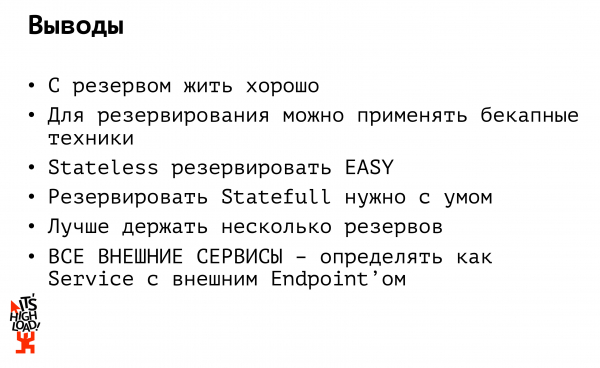
Første konklusion: det er godt at have en reserve. Men det er dyrt. Ideelt set bør man ikke kun have én reserve. Man bør faktisk have flere reserver. For det første skal reserverne være i mindst to forskellige datacentre, og for det andet, helst hos en anden udbyder. Jeg har ofte set det — og jeg kan desværre ikke nævne projekter; netop da der var brand i datacentret... Jeg sagde: lad os skifte til reserven! Men de reservedatacenter-servere stod i det samme rack...
Eller forestil dig, at Amazon blev blokeret i Rusland (og det er sket). Og så: hvad hjælper det, at vores reserve ligger i en anden Amazon? Den er også utilgængelig. Så lad mig gentage: Behold reservedele, mindst i et andet datacenter, og helst — hos en anden udbyder.
Anden udgang: Hvis du har en applikation i Kubernetes, der kommunikerer med eksterne kilder (det kan være både en database og et eksternt API), så skal du definere det som en tjeneste med en ekstern endpoint, så du ikke skal genudrulle 15 af dine applikationer, der henvender sig til den samme database, når du skifter. Definer databasen som en separat tjeneste, og tilgå den, som om den var inde i klyngen: hvis din database går ned, ændrer du IP’en ét sted, og så kan du fortsætte med at leve lykkeligt.
Og til sidst: Jeg elsker "kuben", ligesom jeg elsker eksperimenter med den. Jeg elsker også at dele resultaterne af disse eksperimenter og generelt min personlige erfaring. Derfor har jeg lavet en række webinarer om K8s, velkommen til for yderligere detaljer.
Kilde: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish