

Ifølge , data engineer er i øjeblikket et erhverv, hvor efterspørgslen vokser hurtigere end nogen andre. Data engineer spiller en kritisk rolle i organisationer – de skaber og vedligeholder pipelines og databaser, som bruges til behandling, transformation og opbevaring af data. Hvilke færdigheder er nødvendige for personer i dette erhverv først og fremmest? Adskiller listen sig fra det, der kræves af data scientists? Alt dette vil du finde ud af i min artikel.
Jeg har analyseret stillingsopslag for data engineer positioner, som de fremstår i januar 2020, for at forstå, hvilke teknologiske færdigheder der er mest efterspurgte. Derefter sammenlignede jeg de opnåede resultater med statistikken for stillingsopslag til data scientists – hvilket afslørede nogle interessante forskelle.
Lad os skippe de lange indledninger – her er de ti mest nævnte teknologier i stillingsopslag:
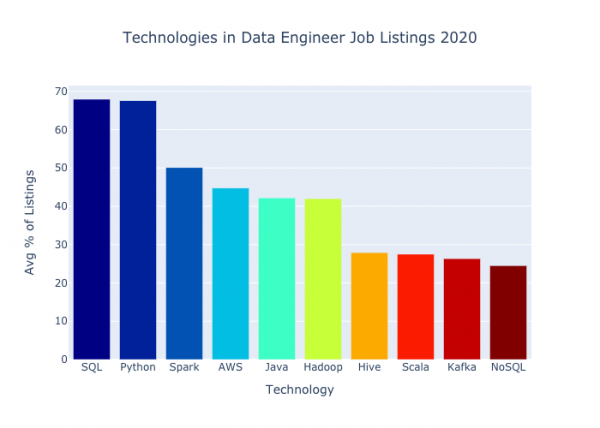
Henvisninger til teknologier i stillingsopslag for data engineer i 2020
Lad os finde ud af det.
Ansvarsområder for data engineer
I dag er arbejdet udført af data engineers af enorm betydning for organisationer – det er disse personer, der er ansvarlige for opbevaring af information og tilpasser den, så andre medarbejdere kan arbejde med den. Data engineers opbygger pipelines for at sikre, at data modtages, enten kontinuerligt eller i batches, fra mange forskellige kilder. Derefter udfører disse pipelines operationer for ekstraktion, transformation og indlæsning (med andre ord, ETL-processer), hvilket gør data mere anvendelige til videre brug. Til sidst overdrages dataene til analytikere og data scientists til dybere behandling. Til slut afslutter data deres rejse på instrumentbrætter, i rapporter og modeller til maskinlæring.
Jeg har søgt information, der kunne give indtryk af, hvilke teknologier der i øjeblikket er mest efterspurgte i arbejdet som data engineer.
Metoder
Jeg indsamlede information fra tre jobportaler — , og og så, hvilke nøgleord der dukker op sammen med «data engineer» i stillingsopslag målrettet mod beboere i USA. Til denne opgave anvendte jeg to Python-biblioteker — og I included key phrases that were both in the previous list for analyzing job postings for the data scientist position and those I manually selected while reading job descriptions for data engineers. LinkedIn was not included as a source because I was banned there after my last attempt to gather data.
For each keyword, I calculated the percentage of occurrences from the total number of texts on each site individually and then computed the average across the three sources.
Resultater
Below are thirty technical terms from the data engineering field with the highest rates across all three job sites.
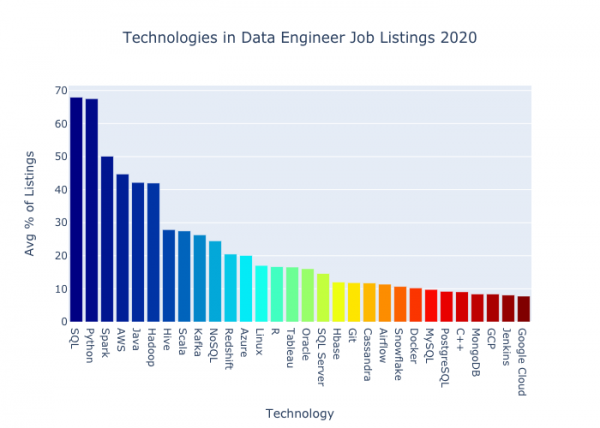
Here are the same figures presented in a table format:
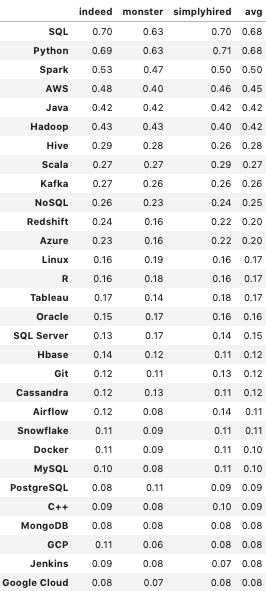
Let's go step by step.
Overview of Results
Both SQL and Python appear in more than two-thirds of the reviewed job postings. These two technologies are particularly worth studying first. is a very popular programming language used for working with data, creating websites, and writing scripts. stands for Structured Query Language; it implies a standard implemented by a group of languages and is used for extracting data from relational databases. It has been around for a long time and has proven to be very robust.
Spark is mentioned in about half of the job postings. is a unified analytics engine for big data processing with built-in modules for streaming, SQL, machine learning, and graph processing. It is particularly popular among those working with large databases.
AWS appears in about 45% of job texts. It is a cloud computing platform from Amazon and holds the largest market share among all cloud platforms.
Next come Java and Hadoop – just over 40% each. is a widely used, battle-tested language that ranked tenth among the languages causing programmers dread in the In contrast, Python was the second most loved language. Java is managed by Oracle, and everything you need to know about it can be understood from this screenshot of the official page from January 2020.
It feels like I traveled in a time machine
bruger en MapReduce-softwaremodel med klynge servere til big data. Denne model afvises nu oftere.
Dernæst ser vi Hive, Scala, Kafka og NoSQL – hver af disse teknologier nævnes i en fjerdedel af de præsenterede stillinger. Apache Hive er et datalagerprogram, der "forenkler læsning, skrivning og administration af store datasæt, der er placeret i distribuerede lagre ved hjælp af SQL." – et programmeringssprog, der aktivt anvendes til arbejdet med big data. Særligt er Spark bygget på Scala. I den allerede nævnte liste over frygtindgydende sprog indtager Scala den ellevte plads. – en distribueret platform til behandling af streamede beskeder. Meget populær som et middel til dataoverførsel.
sætter sig op imod SQL. De adskiller sig ved, at de ikke er relationelle, ikke strukturerede og har horisontal skalerbarhed. NoSQL har vundet en vis popularitet, men den hektiske fascination af denne tilgang, op til profetier om, at den vil erstatte SQL som den dominerende lagringsparadigme, synes at være forbi.
Sammenligning med termer i stillingsopslag for data scientist
Her er tredive teknologiske termer, der er mest almindelige blandt arbejdsgivere inden for data science. Denne liste er opnået på samme måde som beskrevet tidligere for data engineering.
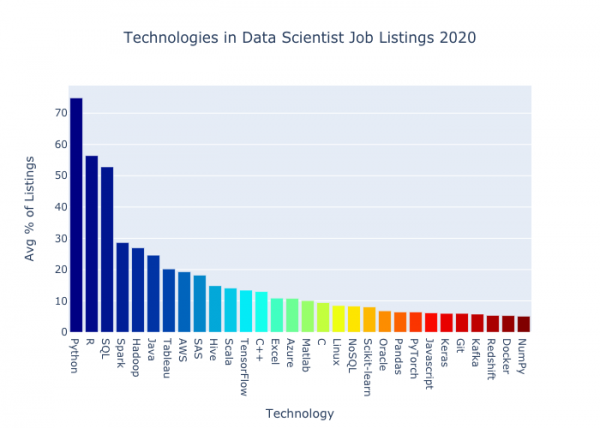
Nævnelse af teknologier i stillingsopslag for data scientist i 2020
Når vi ser på det samlede antal, er der flere opslåede stillinger end i den tidligere gennemgåede gruppe med 28% (12.013 mod 9.396). Lad os se, hvilke teknologier der er mindre hyppige i stillingsopslag for data scientists end for data engineers.
Mere populære inden for data engineering
I grafen nedenfor vises nøgleord med en gennemsnitlig forskel i værdier på mere end 10% eller mindre end -10%.
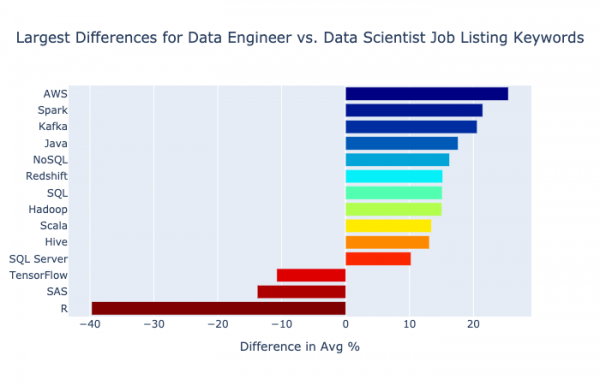
De største forskelle i nøgleords hyppighed mellem data engineer og data scientist
Den mest markante stigning ses hos AWS: i data engineering optræder det 25% hyppigere end i data science (ca. 45% og 20% af det samlede antal stillinger hhv. ). Forskellen er mærkbar!
Her er de samme data præsenteret på en lidt anden måde – i grafen er resultaterne for det samme nøgleord i stillingsopslag for data engineer og data scientist placeret side om side.
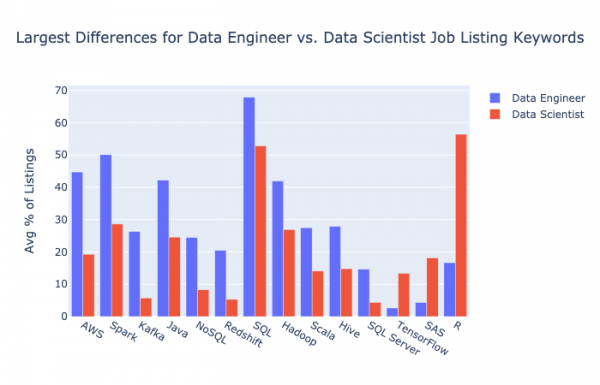
De største forskelle i nøgleords hyppighed mellem data engineer og data scientist
Den næste største stigning, jeg har bemærket, var hos Spark – dataingeniører arbejder ofte med store data. er også steget med 20%, hvilket næsten er fire gange så meget sammenlignet med resultaterne for data scientists. Datatransmission er en af de centrale opgaver for dataingeniører. Endelig viste antallet af omtaler sig at være 15% højere inden for data engineering for Java, NoSQL, Redshift, SQL og Hadoop.
Mindre populære inden for data engineering
Lad os nu se på, hvilke teknologier der er mindre populære i jobopslag for dataingeniører.
Det mest markante fald sammenlignet med data science skete hos : her forekom det i ca. 56% af jobopslagene, mens det kun er 17% her. Imponerende. R er et programmeringssprog, der er populært blandt forskere og statisikere, og det indtager en ottendeplads på listen over frygtede sprog.
fremgår også betydeligt sjældnere i jobopslag til dataingeniører – forskellen er 14%. SAS er et patenteret sprog designet til arbejde med statistik og data. En interessant detalje: ifølge resultaterne , har det i den seneste tid mistet betydelig ground – mere end nogen anden teknologi.
Efterspurgte inden for både data engineering og data science
Det skal bemærkes, at otte ud af de ti øverste pladser i begge sæt er de samme. SQL, Python, Spark, AWS, Java, Hadoop, Hive og Scala er blandt de ti bedste både for data engineering-branchen og for data science. På grafikken nedenfor kan du se de femten mest populære teknologier blandt arbejdsgivere af dataingeniører, samt deres tal for jobopslag til data scientists.
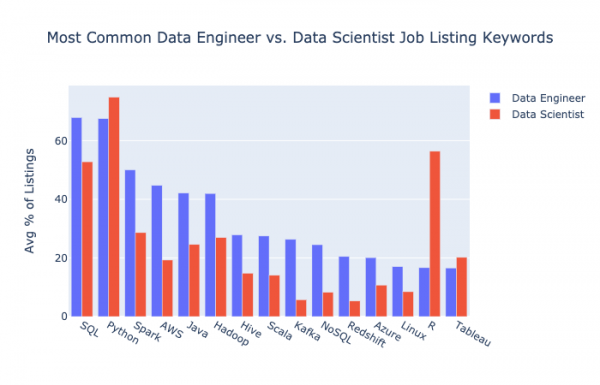
Anbefalinger
Hvis du vil beskæftige dig med data engineering, vil jeg anbefale, at du mestrer følgende teknologier – jeg opregner dem i rækkefølge af omtrentlig prioritet.
Lær SQL. Jeg anbefaler PostgreSQL, fordi det er open source, meget populært i samfundet og er i vækst. Hvordan man bruger sproget, kan man lære fra bogen My Memorable SQL – dens testversion er tilgængelig .
Lær Python, ikke nødvendigvis på det mest hardcore niveau. Bogen My Memorable Python er lige netop for nybegyndere. Den kan købes på , elektronik kopi eller fysisk, alt efter dit valg, eller du kan downloade den i pdf- eller epub-format .
Når du først har fået styr på Python, kan du gå videre til pandas – et Python-bibliotek, der bruges til at rense og behandle data. Hvis du har til hensigt at arbejde i et firma, hvor det er nødvendigt at kunne skrive i Python (og det er tilfældet for de fleste), kan du være sikker på, at kendskab til pandas vil blive forventet som standard. Jeg er i øjeblikket ved at afslutte en introduktionsguide til brug af pandas – du kan , så du ikke går glip af udgivelsesøjeblikket.
Lær AWS. Hvis du vil blive data engineer, kan du ikke undgå en cloud-platform, og AWS er den mest populære af dem alle. Jeg fandt kurserne , da jeg studerede , og jeg tror, de også har gode materialer til AWS.
Hvis du allerede har mestret hele denne liste og ønsker at vokse i øjnene på arbejdsgiverne som data engineer, foreslår jeg, at du tilføjer Apache Spark til arbejde med store data. Selvom min undersøgelse af jobopslag inden for data science viste et fald i interessen, dukker det op næsten i hver anden stilling for data engineers.
Til sidst
Håber denne oversigt over de mest efterspurgte teknologier for data engineers har været nyttig for dig. Hvis du er interesseret i, hvordan situationen er for analytikere, kan du læse . Held og lykke med ingeniørarbejdet!
Kilde: habr.com
