

Idéer og møder om, hvilke yderligere processer der kan automatiseres, opstår dagligt i virksomheder af forskellige størrelser. Men udover at der kan gå meget tid på at skabe en model, skal man også investere tid i at evaluere og kontrollere, at det opnåede resultat ikke er tilfældigt. Efter implementeringen er det nødvendigt at overvåge enhver model og jævnligt kontrollere dens ydeevne.
Og det er alle trin, der skal gennemføres i enhver virksomhed, uanset størrelse. Hvis vi taler om skalaen og legacy Sberbank, stiger antallet af fine justeringer mange gange. Ved udgangen af 2019 blev der allerede brugt over 2000 modeller i Sber. Det er ikke nok blot at udvikle en model; det er nødvendigt at integrere med industrielle systemer, udvikle datavitriner til modelopbygning og sikre kontrol over dens drift i klyngen.
Vores team udvikler platformen Sber.DS. Den muliggør løsning af maskinlæringsopgaver, fremskynder processen for hypotesetestning, forenkler generelt udviklingen og valideringen af modeller samt overvåger resultaterne af modellens arbejde i ПРОМ.
For ikke at undlade at opfylde dine forventninger vil jeg på forhånd sige, at dette indlæg er en introduktion, og hvad der kommer under læsningen beskriver, hvad der grundlæggende er under motorhjelmen på platformen Sber.DS. Historien om modellens livscyklus fra oprettelse til implementering vil vi fortælle separat.
Sber.DS består af flere komponenter, hvoraf de centrale er biblioteket, udviklingssystemet og systemet til udførelse af modeller.
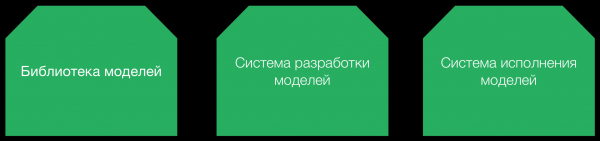
Biblioteket overvåger livscyklussen for modellen fra idéen til udviklingen til implementering i ПРОМ, overvågning og udfasning. Mange af bibliotekets funktioner er dikteret af reguleringens krav, såsom rapportering og opbevaring af trænings- og valideringssæt. I realiteten er det et register over alle vores modeller.
Udviklingssystemet er designet til visuel udvikling af modeller og valideringsmetoder. De udviklede modeller gennemgår en indledende validering og leveres til udførelsessystemet for at udføre deres forretningsfunktioner. I systemet til udførelse kan modellen også sættes på monitor for periodisk at aktivere valideringsmetoder til kontrol af dens drift.
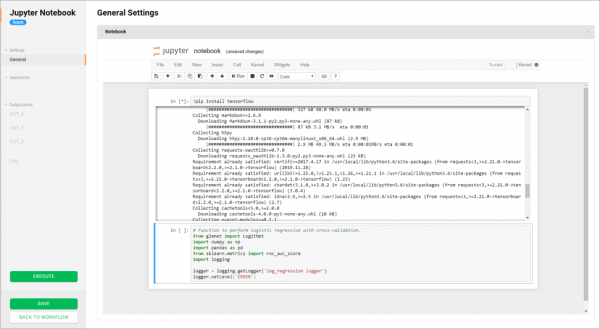
Systemet har flere typer noder. Nogle er designet til at forbinde til forskellige datakilder, mens andre er til at transformere og berige de originale data (mærkning). Der er mange noder til opbygning af forskellige modeller og noder til deres validering. Udvikleren kan indlæse data fra enhver kilde, konvertere, filtrere, visualisere mellemdatasæt og opdele dem i dele.
Platformen indeholder også færdige moduler, som kan trækkes ind i projektområdet. Alle handlinger udføres ved hjælp af et visualiseret interface. Faktisk kan opgaven løses uden en eneste linje kode.
Hvis de indbyggede funktioner ikke er tilstrækkelige, giver systemet muligheder for hurtigt at oprette sine egne moduler. Vi har skabt en integreret udviklingsmulighed baseret på for dem, der opretter nye moduler 'fra bunden'.
Sber.DS's arkitektur er bygget på mikrotjenester. Der er mange meninger om, hvad mikrotjenester er. Nogle mener, at det er tilstrækkeligt at dele monolitisk kode op i dele, men de bruger stadig den samme database. Vores mikrotjeneste skal kommunikere med en anden mikrotjeneste udelukkende via REST API. Ingen omgåelse af direkte databaseadgang.
Vi stræber efter, at tjenesterne ikke bliver for store og klodsede: en instans må ikke forbruge mere end 4-8 gigabyte RAM og skal sikre mulighed for horisontal skalering af forespørgsler ved at starte nye instanser. Hver tjeneste kommunikerer kun med andre via REST API (). Teamet ansvarligt for tjenesten skal bevare bagudkompatibiliteten af API til den sidste klient, der bruger den.
Kernen af applikationen er skrevet i Java med brug af Spring Framework. Løsningen blev oprindeligt designet til hurtig implementering i cloud-infrastruktur, derfor er applikationen bygget ved hjælp af et containeriseringssystem (). Platformen udvikler sig konstant, både hvad angår tilføjelse af forretningsfunktionalitet (nye tilslutninger, AutoML), og hvad angår teknologisk effektivitet.
En af de store fordele ved vores platform er, at vi kan køre kode udviklet i et visuelt interface på ethvert system til udførelse af modeller i Sberbank. I øjeblikket er der allerede to: en på Hadoop og en anden på OpenShift (Docker). Vi stopper ikke her og opretter integrationsmoduler til at køre kode på hvilken som helst infrastruktur, herunder on-premise og i skyen. Hvad angår mulighederne for effektiv integration i Sberbanks økosystem, planlægger vi også at understøtte arbejdet med de eksisterende udførelsesmiljøer. På sigt kan løsningen fleksibelt integreres
De, der nogensinde har prøvet at vedligeholde en løsning, der kører Python på Hadoop i PRO-M, ved, at det ikke er nok bare at forberede og levere et brugerdefineret Python-miljø til hver datanode. Et stort antal C/C++ biblioteker til maskinlæring, som bruger Python-moduler, vil ikke lade dig hvile let. Man skal huske at opdatere pakkerne, når der tilføjes nye biblioteker eller servere, for at holde tilbagekompatibiliteten med den allerede implementerede modelkode.
Der er flere tilgange til, hvordan dette kan gøres. For eksempel kan man på forhånd forberede flere ofte brugte biblioteker og implementere dem i PRO-M. I Clouderas Hadoop-distribution bruges der normalt . Derudover er der nu mulighed for at køre -containere i Hadoop. I nogle enkle tilfælde kan man levere koden sammen med pakken .
Banken tager sikkerheden ved at køre tredjepartkode meget seriøst, derfor udnytter vi i videst muligt omfang de nye muligheder i Linux-kernen, hvor processen, der kører i et isoleret miljø, , kan begrænses, for eksempel med hensyn til adgang til netværk og lokal disk, hvilket betydeligt reducerer mulighederne for ondsindet kode. Dataområderne for hver afdeling er beskyttede og kun tilgængelige for ejere af disse data. Plattformen garanterer, at data fra et område kun kan komme ind i et andet område via en datapubliceringsproces med kontrol på alle trin fra adgang til kilder til landing af data i det målrettede showcase.
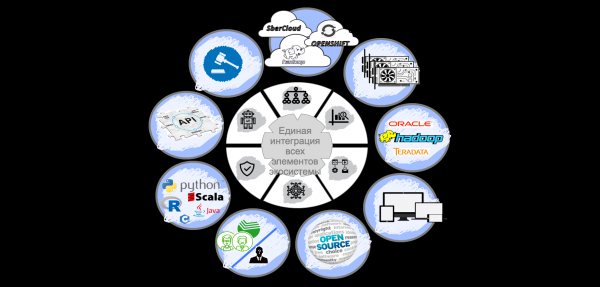
I år planlægger vi at afslutte MVP-lanceringen af modeller skrevet i Python/R/Java på Hadoop. Vi har sat os det ambitiøse mål at lære at køre ethvert brugerdefineret miljø på Hadoop, så vi ikke begrænser brugerne af vores platform.
Desuden viser det sig, at mange DS-specialister har en god forståelse for matematik og statistik, laver fantastiske modeller, men ikke har så meget erfaring med transformation af store data, og de har brug for hjælp fra vores dataingeniører til at forberede træningsdatasæt. Vi har besluttet at hjælpe vores kolleger og skabe brugervenlige moduler til typisk transformation og forberedelse af funktioner til modeller på Spark-motoren. Dette vil give dem mere tid til at fokusere på modeludvikling og slippe for at vente på, at dataingeniørerne forbereder et nyt datasæt.
Vi har folk, der har viden inden for forskellige områder: Linux og DevOps, Hadoop og Spark, Java og Spring, Scala og Akka, OpenShift og Kubernetes. I næste gang vil vi tale om modelbiblioteket, hvordan en model gennemgår livscyklussen inde i virksomheden, samt hvordan validering og implementering foregår.
Kilde: habr.com
