

Bem. overs.: Service mesh - et fænomen, der endnu ikke har en fast oversættelse til dansk (for over 2 år siden foreslog vi „netværk for services“, og lidt senere begyndte nogle kolleger at promovere udtrykket „servicetælling“). De konstante diskussioner om denne teknologi har ført til en situation, hvor den marketingmæssige og tekniske del er blevet for tæt sammenflettet. Dette fantastiske materiale fra en af forfatterne af det originale udtryk har til formål at bringe klarhed for ingeniører og andre.
Comic from
Introduktion
Hvis du er softwareingeniør, der arbejder et sted med backend-systemer, er udtrykket „service mesh“ sandsynligvis blevet fastgrebet i din bevidsthed de seneste par år. Takket være en mærkelig sammenfald af omstændigheder vinder dette udtryk indpas i branchen, og hype og de tilknyttede reklameforslag stiger som en snebold, der ruller ned ad en skrænt og ikke viser tegn på at bremse.
Service mesh opstod i de uklare, tendentiøse vande af cloud native-økosystemet. Desværre betyder det, at en betydelig del af de tilknyttede debatter spænder fra „lavkalorie-snak“ til - for at bruge et teknisk udtryk - rent vrøvl. Men hvis vi frasorterer alt støj, kan vi opdage, at service mesh har en rigtig, bestemt og vigtig funktion.
I denne publikation vil jeg forsøge at gøre lige netop det: at præsentere en ærlig, dybdegående, ingeniørorienteret guide til service mesh. Jeg vil besvare ikke blot spørgsmålet: „Hvad er det?“, - men også „Hvorfor?“, samt „Hvorfor netop nu?“. Endelig vil jeg forsøge at skitsere, hvorfor (i min mening) netop denne teknologi har skabt sådan et vanvittigt hype, hvilket i sig selv er en interessant historie.
Hvem er jeg?
Hej alle! Mit navn er . Jeg er en af skaberne af — det allerførste service mesh projekt og projektet, der er ansvarligt for fremkomsten af termen service mesh som sådan (undskyld, gutter!). (Translation example.: For at sige det i korthed, i begyndelsen af dette terms fremkomst, for over 2,5 år siden, oversatte vi allerede tidligt materiale fra samme forfatter med titlen „».) Jeg leder også — en startup, der laver så seje service mesh-løsninger som Linkerd og .
Du gætter sikkert, at jeg har en temmelig biased og subjektiv mening om dette emne. Dog vil jeg forsøge at minimere tendensen (med undtagelse af én sektion: «Hvorfor er der så meget snak om service mesh?», — hvor jeg stadig vil dele mine forudindfattede ideer). Jeg vil også gøre mit bedste for at gøre denne guide så objektiv som muligt. I konkrete eksempler vil jeg primært stole på erfaringen med Linkerd, mens jeg påpeger kendte forskelle (hvis de eksisterer) i implementeringen af andre typer service mesh.
Okay, det er tid til at komme til det spændende.
Hvad er en service mesh?
På trods af al hypen er service mesh struktureret ganske enkelt. Det er blot en bunke af userspace-proxyer, der er placeret "nær" tjenesterne (vi vil senere tale lidt om, hvad "nær" betyder), plus et sæt kontrolprocesser. Proxyerne kaldes samlet data plane, mens kontrolprocesserne kaldes control plane. Data plane fanger opkald mellem tjenesterne og gør "diverse ting" med dem; control plane koordinerer derfor proxyernes adfærd og giver dig, dvs. operatøren, adgang til API'et, så du kan manipulere netværket og måle det som en helhed.
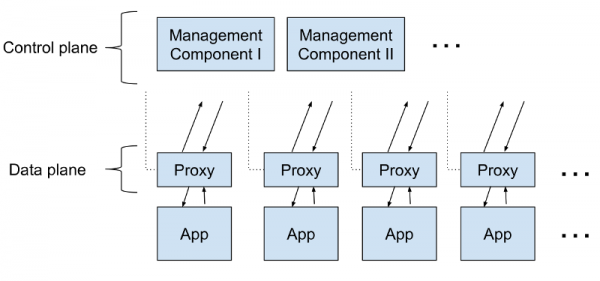
Hvad er disse proxyer? Det er TCP-proxyer i kategorien "Layer 7-aware" (dvs. "bevidste om" lag 7 i OSI-modellen) som HAProxy og NGINX. Du kan vælge en proxy efter eget valg; Linkerd bruger en proxy skrevet i Rust, simpelt kaldt . Vi har samlet den specielt til service mesh. Andre mesh'er foretrækker andre proxyer (Envoy er et hyppigt valg). Men valget af proxy er blot et spørgsmål om implementering.
Hvad gør disse proxies? Åbenlyst, de proxy'er opkald til tjenesterne og fra dem (strengt taget fungerer de som både proxy og reverse proxy og håndterer både indgående og udgående opkald). Og de implementerer en række funktioner, der er fokuseret på opkald mellem tjenesterne. Dette fokus på trafikken mellem tjenesterne adskiller service mesh-proxyer fra f.eks. API-gateways eller ingress-proxyer (sidstnævnte fokuserer på opkald, der kommer til klyngen fra den eksterne verden). (Bem. overs.: sammenligning af eksisterende Ingress-controllere til Kubernetes, hvor mange af dem bruger den allerede nævnte Envoy, se i .)
Så vi har styr på data plane. Control plane er enklere opbygget: det er et sæt komponenter, der sørger for al den mekanik, der er nødvendig for, at data plane fungerer koordineret, inklusiv serviceopdatering, udstedelse af TLS-certifikater, aggregering af metrics osv. Data plane informerer control plane om sin adfærd; til gengæld giver control plane et API, der gør det muligt at ændre og overvåge data planes adfærd som en enhed.
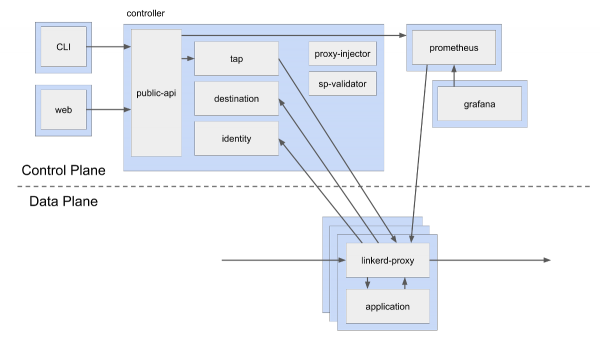
Nedenfor er en skema for control plane og data plane i Linkerd. Som det ses, inkluderer control plane flere forskellige komponenter, herunder en Prometheus-instans, der indsamler metrics fra proxy-servere, samt andre komponenter som destination (serviceopdatering), identity (certificeringscenter, CA) og public-api (endepunkter for web og CLI). I modsætning hertil er data plane en simpel linkerd-proxy ved siden af en applikationsinstans. Dette er blot et logisk diagram; under faktiske implementeringer kan du have tre replikaer af hver control plane-komponent og hundrede eller tusinde proxies i data plane.
(De blå rektangler i dette diagram symboliserer grænserne for Kubernetes-pods. Det kan ses, at containerne med linkerd-proxy er i samme pod som applikationscontainerne. En sådan konfiguration er kendt som sidecar-container..)
Arkitekturen for service mesh har flere vigtige konsekvenser. For det første, da proxyens opgave er at opsnappe kald mellem tjenester, giver service mesh kun mening, hvis din applikation er bygget op omkring et sæt tjenester. Mesh you can kan anvendes med monolitter, men det er åbenlyst overflødigt for én enkelt proxy, og dens funktionalitet vil næppe være efterspurgt.
En anden vigtig konsekvens er, at service mesh kræver et enormt antal proxies. Faktisk tilknytter Linkerd linkerd-proxy til hver instans af hver tjeneste (andre implementeringer tilføjer proxy til hver node/vært/virtual maskine. I hvert fald er det ikke lidt). En så aktiv brug af proxies medfører selv flere komplikationer:
- Proxies i data plane skal være hurtige, da der til hvert kald er to opkald til proxien: ét på klientsiden, ét på serversiden.
- Desuden skal proxiene være små og lette.Hver enkelt vil forbruge hukommelses- og CPU-ressourcer, og dette forbrug vil vokse lineært sammen med applikationen.
- Du har brug for en mekanisme til at implementere og opdatere et stort antal proxyer. At gøre dette manuelt er ikke en løsning.
Generelt ser service mesh sådan ud (i det mindste set fra fugleperspektiv): du implementerer en masse userspace-proxyer, der 'gør noget' med intern, mellemservice trafik, og bruger control plane til at overvåge og styre dem.
Det er tid til spørgsmålet 'Hvorfor?'
Hvad er formålet med en service mesh?
Det er forståeligt, at dem, der først støder på ideen om service mesh, kan føle en let nervøsitet. Konstruktionen af service mesh betyder, at den ikke kun vil øge latensen i applikationen, men også vil forbruge ressourcer og tilføje en masse nye mekanismer til infrastrukturen. Først installerer du service mesh, og så opdager du pludselig, at du skal vedligeholde hundrede (hvis ikke tusinde) proxyer. Hvem vil frivilligt gå ind i det?
Svaret på dette spørgsmål består af to dele. For det første kan de operationelle omkostninger ved implementationen af disse proxyer blive betydeligt reduceret takket være nogle ændringer, der finder sted i økosystemet (mere om dette senere).
For det andet er en sådan enhed faktisk en fremragende måde at indføre ekstra logik i systemet. Og ikke kun fordi det er muligt at tilføje mange nye funktioner med hjælp af service mesh, men også fordi det kan gøres uden at blande sig i økosystemet. Faktisk er hele modellen for service mesh baseret på denne postulat: i et multi-service system, uanset hvad de enkelte tjenester gør, er trafikken mellem dem det perfekte punkt for at tilføje funktionalitet. For eksempel i Linkerd (som i de fleste mesh'er) er funktionaliteten primært fokuseret på HTTP-anmodninger, inklusive HTTP/2 og gRPC*. Funktionaliteten er ret rig — den kan opdeles i tre klasser:
Funktioner relateret til
- . Gen-anmodninger, tidsgrænser, kanarietilgang (deling/omdirigering af trafik) osv. pålidelighedovervågning.
- . Gen-anmodninger, tidsgrænser, kanarietilgang (deling/omdirigering af trafik) osv. Aggregation af succesrater, latens og anmodningsvolumener for hver tjeneste eller specifikke retninger; opbygning af topologiske kort over tjenester osv.. Mutual TLS, adgangskontrol osv.
- . Gen-anmodninger, tidsgrænser, kanarietilgang (deling/omdirigering af trafik) osv. sikkerhed.
* Set fra Linkerd's synspunkt adskiller gRPC sig ikke meget fra HTTP/2: der anvendes blot protobuf i nyttelasten. Set fra udviklerens perspektiv er disse to ting selvfølgelig forskellige.
Mange af disse mekanismer arbejder på anmodningsniveau (deraf betegnelsen "L7-proxy"). For eksempel, hvis tjenesten Foo sender en HTTP-anmodning til tjenesten Bar, kan linkerd-proxy på Foo's side udføre intelligent belastningsfordeling og dirigere anmodninger fra Foo til Bar-instanser afhængigt af den observerede forsinkelse; det kan gentage anmodningen, hvis det er nødvendigt (og hvis den er idempotent); det kan registrere statuskode og ventetid osv. På tilsvarende måde kan linkerd-proxy på Bar's side afvise anmodningen, hvis den ikke er autoriseret, eller hvis anmodningsgrænsen er overskredet; det kan registrere forsinkelse fra sin side osv.
Proxies kan også "gøre noget" på forbindelsesniveau. For eksempel kan linkerd-proxy på Foo's side initiere en TLS-forbindelse, mens linkerd-proxy på Bar's side kan afbryde den, og begge parter kan kontrollere hinandens TLS-certifikater. Dette sikrer ikke kun kryptering mellem tjenesterne, men også en kryptografisk sikker metode til identifikation af tjenester: Foo og Bar kan "bevise", at de er dem, de siger de er.
* "Hinanden" betyder, at klientens certifikat også verificeres (mutual TLS). I "klassisk" TLS, for eksempel mellem browser og server, verificeres normalt kun den ene parts (serverens) certifikat.
Uanset om de arbejder på anmodningsniveau eller forbindelsesniveau, er det vigtigt at understrege, at alle funktioner i service mesh har en driftsmæssig karakter. Linkerd kan ikke transformere semantikken i nyttelasten – for eksempel tilføje felter til JSON-fragmenter eller ændre protobuf. Vi vil senere tale om denne vigtige egenskab, når vi diskuterer ESB og middleware.
Dette er sæt af funktioner, som service mesh tilbyder. Spørgsmålet opstår: hvorfor ikke implementere dem direkte i applikationen? Og hvorfor overhovedet arbejde med proxies?
Hvorfor service mesh er en god idé
Selv om mulighederne for service mesh vækker fantasi, ligger dens egentlige værdi ikke i funktionerne. I sidste ende er vi kan implementere dem direkte i applikationen (senere vil vi se, at dette var oprindelsen til service mesh). Hvis man skal udtrykke denne tanke i én sætning, består værdien af service mesh i følgende: den leverer funktioner, der er kritisk vigtige for driften af moderne serversoftware, ensartet for hele stakken og uafhængigt af applikationskoden.
Lad os analysere denne sætning.
«Funktioner, der er kritisk vigtige for driften af moderne serversoftware». Hvis du udvikler en transaktionel serverapplikation, der er relateret til det offentlige internet, modtager anmodninger fra den eksterne verden og svarer på dem inden for kort tid — for eksempel en webapplikation, en API-server, og for den sags skyld det overvejende flertal af andre moderne applikationer — og hvis du implementerer den som en samling af tjenester, der synkront interagerer med hinanden, og hvis du konstant opdaterer denne software ved at tilføje nye funktioner, og hvis du er nødt til at vedligeholde dette system i drift under modifikationen — så tillykke, du arbejder med at skabe moderne serversoftware. Og alle disse vidunderlige funktioner, der er nævnt ovenfor, viser sig faktisk at være kritisk vigtige for dig. Applikationen skal være pålidelig, sikker, og du skal have mulighed for at overvåge, hvad den laver. Netop disse spørgsmål hjælper service mesh med at løse.
(Okay, min overbevisning om, at denne tilgang er den moderne måde at skabe serversoftware på, snedede sig ind i det forrige afsnit. Andre foretrækker at udvikle monolitter, "reaktive mikrotjenester" og andre ting, der ikke falder ind under den ovenfor nævnte definition. Disse mennesker har helt sikkert deres egen mening, der adskiller sig fra min. Jeg mener derimod, at de "ikke har ret" — men i hvert fald er service mesh ikke særlig nyttigt for dem).
«Ensartet for hele stakken». Funktionerne, der leveres af service mesh, er ikke blot kritisk vigtige. De anvendes på alle tjenester i applikationen, uanset hvilken sprog de er skrevet i, hvilken ramme de bruger, hvem der har skrevet dem, hvordan de er blevet implementeret og alle de andre nuancer af deres udvikling og anvendelse.
«Uafhængigt af applikationskodenEndelig giver service mesh ikke kun ensartede funktioner til hele stakken — det gør det på en måde, der ikke kræver ændringer af applikationen. Den fundamentale basis for funktionaliteten i service mesh, inklusive opgaver som opsætning, opdatering, drift, vedligeholdelse osv., ligger udelukkende på platformsniveau og er uafhængig af applikationen. Applikationen kan ændre sig uden at påvirke service mesh. Omvendt kan service mesh ændre sig uden at involvere applikationen.
Kort sagt, service mesh giver ikke kun livsvigtige funktioner, men gør det på en global, ensartet og applikationsuafhængig måde. Derfor, selvom funktionaliteten i service mesh kan implementeres i servicens kode (for eksempel i form af et bibliotek, der inkluderes i hver tjeneste), vil denne tilgang ikke sikre den ensartethed og uafhængighed, som er så værdifulde i forhold til service mesh.
Og alt, hvad der kræves, er at tilføje en masse proxyer! Jeg lover, at vi meget snart vil se på driftsomkostningerne forbundet med at tilføje disse proxyer. Men lad os først stoppe op og se på denne idé om uafhængighed fra forskellige synsvinkler. mennesker.
Hvem drager fordel af service mesh?
Hvor ubelejligt det end måtte være, så skal en teknologi blive en vigtig del af økosystemet, før den accepteres af mennesker. Så hvem er interesseret i service mesh? Hvem får gavn af dens brug?
Hvis du udvikler moderne serversoftware, kan du omtrent forestille dig dit team som en gruppe ejere af tjenester, der sammen udvikler og implementerer forretningslogik, og ejere af platforme, der arbejder med udviklingen af den interne platform, som disse tjenester kører på. I små organisationer kan det være de samme personer, men i takt med at virksomheden vokser, bliver disse roller normalt mere udtalte og endda opdelt i underroller… (Der kan siges meget om den skiftende natur af devops, organisatorisk indflydelse fra mikrotjenester osv. Men lad os indtil videre tage disse beskrivelser for givet).
Set fra det perspektiv er platformsejere de åbenlyse begunstigede af service mesh. I sidste ende er målet for platformteamet at skabe en intern platform, hvor tjenesteoperatører kan implementere forretningslogik på en måde, der sikrer maksimal uafhængighed fra de trælse detaljer ved driften. Service mesh tilbyder ikke kun kritisk vigtige muligheder for at nå dette mål; den gør det på en måde, der ikke pålægger afhængigheder på tjenesteoperatørerne.
Tjenesteoperatørerne drager også fordel, omend på en mere indirekte måde. Målsetningen for en tjenesteoperatør er at være så produktiv som muligt i implementeringen af forretningsproceslogik, og jo mindre de skal bekymre sig om driftsrelaterede spørgsmål, desto bedre. I stedet for at være optaget af implementeringen af for eksempel genanmodningspolitikker eller TLS, kan de fokusere udelukkende på forretningens opgaver og håbe, at platformen tager sig af resten. Dette er en stor fordel for dem.
Den organisatoriske værdi af denne opdeling mellem platformsejere og tjenesteoperatører er vanskelig at overvurdere. Jeg mener, at den bidrager hoved til værdien af service mesh.
Vi lærte denne lektion, da en af de første entusiaster for Linkerd fortalte os, hvorfor de valgte service mesh: fordi det gjorde det muligt for dem at 'minimere snakken'. Her er nogle detaljer: fyrene fra en stor virksomhed migrerede deres platform til Kubernetes. Da applikationen arbejdede med fortrolige oplysninger, ønskede de at kryptere alle kommunikationer i klyngerne. Men situationen blev kompliceret af hundreder af tjenester og hundreder af udviklingsteams. Udsigten til at kontakte alle og overbevise dem om at inkludere TLS i deres planer gjorde dem ikke glade. Da de installerede Linkerd, flyttede de ansvaret fra udviklerne (for dem var det unødvendige besvær) til platformteamet, hvor dette var en højprioriteret opgave. Med andre ord løste Linkerd for dem ikke så meget et teknisk problem som et organisatorisk.
Kort sagt er service mesh i højere grad en løsning på et ikke-teknisk socio-teknisk problem. (Tak for introduktionen af denne betegnelse.)
Vil service mesh løse alle mine problemer?
Ja. Som i, nej!
Hvis man ser på de tre funktioner nævnt ovenfor: pålidelighed, sikkerhed og overvågning, bliver det klart, at service mesh ikke er en fuldgyldig løsning på nogen af disse problemer. Selvom Linkerd kan sende gentagne forespørgsler (hvis det ved, at de er idempotente), er det ikke i stand til at træffe beslutninger om, hvad der skal returneres til brugeren, hvis tjenesten er faldet helt ud — sådanne beslutninger skal applikationen træffe. Linkerd kan føre statistik over succesfulde forespørgsler, men det kan ikke se ind i tjenesten og give dens interne målinger — sådne værktøjer skal være tilgængelige for applikationen. Og selvom Linkerd er i stand til at organisere mTLS, kræver fuldgyldige løsninger til at sikre sikkerhed meget mere.
Et delmængde af funktionerne inden for disse områder, som service mesh tilbyder, vedrører platformens funktioner. Med dette mener jeg funktioner, der:
- er uafhængige af forretningslogikken. Måden, hvorpå histogrammer af kald mellem Foo og Bar opbygges, afhænger på ingen måde af, hvorfor at Foo kalder Bar.
- Det er svært at implementere korrekt. I Linkerd er gentagne forsøg parametriseret ved hjælp af forskellige indviklede funktioner som f.eks. retry budgets (gentagelsesbudgetter), da en simpel tilgang til at implementere sådanne ting helt sikkert vil føre til en såkaldt "retry storm" (gentagelsesstorm) og andre problemer, der er karakteristiske for distribuerede systemer.
- Er mest effektive, når de anvendes ensartet. TLS-mekanismen giver mening kun, når den anvendes overalt.
Da disse funktioner er implementeret på proxy-niveau (og ikke på applikationsniveau), leverer service mesh dem på niveauet platform, og ikke applikationen. Derfor er det ligegyldigt, hvilket sprog tjenesterne er skrevet i, hvilket framework de bruger, hvem der har skrevet dem, og hvorfor. Proxies arbejder uden for alle disse detaljer, og den grundlæggende basis for denne funktionalitet, herunder opgaver relateret til konfiguration, opdatering, drift, vedligeholdelse osv., ligger udelukkende på platformens niveau.
Eksempler på egenskaber ved service mesh
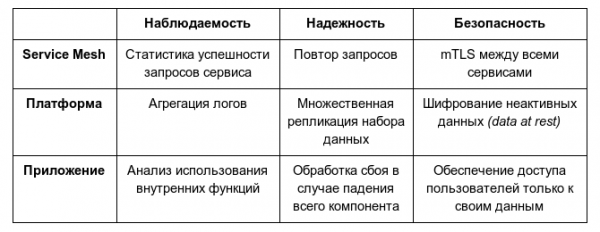
Sammenfattende vil jeg sige, at service mesh ikke er en fuldstændig løsning til at sikre pålidelighed, overvågning eller sikkerhed. Omfanget af disse områder kræver nødvendigvis deltagelse af serviceejere, Ops/SRE-teams og andre aktører i virksomheden. Service mesh giver kun et "skud" på platformniveau for hver af disse områder.
Hvorfor er service mesh blevet populært netop nu?
Du sidder måske nu og spørger dig selv: ok, hvis service mesh er så godt, hvorfor har vi så ikke begyndt at implementere millioner af proxies i stakken for ti år siden?
Der er et banalt svar på dette spørgsmål: for ti år siden byggede alle monolitter, og service mesh var ikke nødvendig. Det er sandt, men efter min mening mister man essensen i et sådant svar. Selv for ti år siden blev konceptet med mikrotjenester bredt diskuteret og anvendt i selskaber som Twitter, Facebook, Google og Netflix som en lovende måde at skabe store systemer på. Den generelle opfattelse - i hvert fald i de dele af branchen, jeg har haft kontakt med - var, at mikrotjenester er den "rette måde" at bygge store systemer på, selvom det var frygtelig svært.
Selvfølgelig, selvom der for ti år siden var virksomheder, der benyttede mikrotjenester, satte de ikke bare proxies overalt for at danne en service mesh. Men hvis man ser nærmere på det, gjorde de noget lignende: i mange af disse virksomheder var det påkrævet at bruge et særligt internt bibliotek til netværkskommunikation (nogle gange kaldet et fat client library, fat client library).
Netflix havde Hysterix, Google havde Stubby, og Twitter havde Finagle-biblioteket. Finagle var for eksempel obligatorisk for hver ny service i Twitter. Det håndterede både klient- og serverdelen af forbindelserne, tillod gentagne anmodninger, understøttede ruteanmodninger, belastningsafbalancering og målinger. Det sikrede et konsistent lag af pålidelighed og overvågning for hele Twitter-stakken, uanset hvad servicen beskæftigede sig med. Selvfølgelig fungerede det kun for JVM-sprog og baserede sig på den programmeringsmodel, der var nødvendig for hele applikationen. Men dens funktionalitet var næsten den samme som service mesh. (Den første version af Linkerd var egentlig bare Finagle indhyllet i en proxy-form.)
For ti år siden eksisterede der derfor ikke kun mikrotjenester, men også specielle proto-service-mesh biblioteker, der løste de samme problemer, som service mesh løser i dag. Men selve service mesh eksisterede ikke dengang. Der skulle ske endnu et skifte, før den kom.
Og her ligger et dybere svar, skjult i en anden forandring, der er sket i de sidste 10 år: Omkostningerne ved at implementere mikrotjenester er faldet drastisk. De virksomheder, der nævntes tidligere, som brugte mikrotjenester for ti år siden: Twitter, Netflix, Facebook, Google, var gigantiske virksomheder med enorme ressourcer. De havde ikke bare behov, men også muligheden for at skabe, implementere og drifte store applikationer baseret på mikrotjenester. Den energi og de ressourcer, som ingeniørerne hos Twitter lagde i overgangen fra en monolitisk til en mikrotjeneste-tilgang, er simpelthen imponerende. (Ærligt talt, ligesom det faktum, at det lykkedes.) Den slags infrastrukturelle manøvrer var dengang umulige for mindre virksomheder.
Lad os bevæge os ind i nutiden. I dag er der startups, hvor forholdet mellem mikrotjenester og udviklere er 5:1 (eller endda ), og mere end det, de håndterer dem med succes! Hvis en startup bestående af 5 personer er i stand til ubesværet at drifte 50 mikrotjenester, må noget helt klart have reduceret omkostningerne ved deres implementering.
1500 mikrotjenester i Monzo; hver linje er en foreskreven netværksregel, der tillader trafik
Det drastiske fald i omkostningerne ved drift af mikrotjenester er resultatet af én proces: væksten i populariteten af containere og orkestratorer. Det er her, det dybe svar på spørgsmålet om, hvad der har bidraget til fremkomsten af service mesh, ligger. Den samme teknologi har gjort både service mesh og mikrotjenester attraktive: Kubernetes og Docker.
Hvorfor? Nå, Docker løser et stort problem — emballageproblemet. Ved at pakke en applikation og dens (ikke-netværks) runtime-afhængigheder ind i en container, gør Docker applikationen til en udskiftelig enhed, der kan placeres og køres hvor som helst. Samtidig forenkler det driften betydeligt af flersprogede stak: da en container er en atomisk enhed for udførelse, er det ligegyldigt, hvad der er indeni, hvad enten det er en applikation på JVM, Node, Go, Python eller Ruby. Du starter det bare, og så er det det.
Kubernetes tager det hele til et nyt niveau. Nu, når der er en masse 'udførbare enheder' og mange maskiner at køre dem på, opstår der et behov for et værktøj, der kan matche dem med hinanden. I brede træk giver du Kubernetes mange containere og mange maskiner, og det matcher dem med hinanden (selvfølgelig er dette en dynamisk og konstant ændrende proces: nye containere flytter rundt i systemet, maskiner startes og stoppes, osv. Men Kubernetes tager alt dette i betragtning).
Efter opsætning af Kubernetes er tidsforbruget til udførelse og drift af en service næppe anderledes end omkostningerne til at udføre og drifte ti tjenester (faktisk er de praktisk talt ens også for 100 tjenester). Tilføj til dette containere som en pakke-mekanisme, der fremmer flersproget implementering, og du får en masse nye applikationer implementeret som mikrotjenester, skrevet på forskellige sprog — lige netop det miljø, som service mesh passer så godt ind i.
Så vi er nået til svaret på spørgsmålet om, hvorfor ideen om service mesh er blevet populær netop nu: den ensartethed, som Kubernetes sikrer for tjenester, er direkte anvendelig på de driftsopgaver, som service mesh står overfor. Du pakker en proxy i containere, giver Kubernetes opgaven at placere dem, hvor som helst det er muligt, og voila! Resultatet er en service mesh, hvor hele mekanikken til dens implementering styres af Kubernetes. (I det mindste set fra et fugleperspektiv. Selvfølgelig er der mange nuancer i denne proces.)
For at opsummere: grunden til, at service mesh er blevet populært netop nu, og ikke for ti år siden, er, at Kubernetes og Docker ikke kun har øget behovet for det ved at forenkle implementeringen af applikationer som sæt af flersprogede mikrotjenester, men også væsentligt har reduceret omkostningerne til driften af det ved at sikre mekanismer til implementering og vedligeholdelse af sidecar-proxy-parker.
Hvorfor er der så meget snak om service mesh?
Advarsel: i dette afsnit henviser jeg til alle mulige antagelser, gætterier, spekulationer og intern information.
Når du søger på udtrykket „service mesh“, vil du støde på en masse genbrugt, lavkalorisk indhold, mærkelige projekter og kaleidoskoper af forvrængninger, der er værdige til en ekkokammer. Enhver trendy ny teknologi har dette til fælles, men i tilfældet med service mesh er problemet særligt udtalt. Hvorfor?
Nå, det er delvis min skyld. Jeg har gjort alt for at fremme Linkerd og service mesh, når som helst muligheden bød sig, gennem utallige blogindlæg og artikler som denne. Men jeg er ikke så magtfuld. For virkelig at besvare dette spørgsmål er det nødvendigt at tale lidt om den generelle situation. Og det kan ikke gøres uden at nævne et projekt: — en open source service mesh, der udvikles i samarbejde mellem Google, IBM og Lyft.
(Disse tre virksomheder har meget forskellige roller: Lyfts deltagelse ser ud til at være begrænset til navnet; de er skaberne af Envoy, men bruger ikke Istio eller deltager i dens udvikling. IBM er involveret i udviklingen af Istio og bruger det. Google deltager aktivt i udviklingen af Istio, men så vidt jeg kan bedømme, bruger de det faktisk ikke.)
Istio-projektet er bemærkelsesværdigt af to grunde. For det første er det de enorme marketingindsatser, som Google, især, lægger i dets promovering. Efter min vurdering er de fleste mennesker, der i øjeblikket kender til konceptet service mesh, blevet bekendt med det for første gang gennem Istio. Den anden bemærkelsesværdige ting er, hvor dårligt Istio er blevet modtaget. I denne sag er jeg åbenbart en part i sagen, men i et forsøg på at forblive så objektiv som muligt, kan jeg ikke undgå at , ikke særlig karakteristisk (selvom det ikke er unikt: man kan komme til at tænke på systemd, …) for et Open Source-projekt.
(I praksis ser det ud til, at Istio har problemer, ikke kun med kompleksitet og UX, men også med ydeevne. For eksempel under , som blev udført af en tredjepart, fandt specialister situationer, hvor tail latency for Istio var 100 gange højere end den tilsvarende for Linkerd, samt situationer med ressourcemangel, hvor Linkerd fortsatte med at fungere, mens Istio stoppede helt.)
Lad mig lægge mine teorier om, hvorfor det skete til side; jeg mener, at den enorme interesse omkring service mesh skyldes, at Google er involveret. Specifikt er det en kombination af følgende tre faktorer:
- Google's påtrængende promovering af Istio;
- den tilsvarende negative og kritiske holdning til projektet;
- den nylige hurtige stigning i popularitet for Kubernetes, hvis minder stadig er friske.
Sammen skaber disse faktorer et fortryllende, iltfattigt miljø, hvor evnen til rationel ræsonnering svækkes, og der er kun den vidunderlige art af .
Set fra Linkerd's synspunkt ville jeg beskrive det som en ambivalent velsignelse. Jeg mener, det er fantastisk, at service mesh er kommet ind i mainstream - noget, der ikke var tilfældet i 2016, da Linkerd først dukkede op, og det var virkelig svært at vække opmærksomhed omkring projektet. Nu er det ikke længere et problem! Men det er skidt, at situationen med service mesh i dag er så forvirrende, at det næsten er umuligt at forstå, hvilke projekter der faktisk falder ind under kategorien service mesh (for ikke at nævne, at forstå, hvilket af dem der er bedst egnet til en bestemt brugssituation). Det hindrer bestemt alle (og i nogle tilfælde kan Istio eller et andet projekt være mere passende end Linkerd, da sidstnævnte ikke er en universel løsning).
Fra Linkerd's side var vores strategi at ignorere støjen, fortsætte med at fokusere på at løse reelle problemer i samfundet og i det væsentlige vente på, at hypen ville lægge sig. Til sidst vil hype falme, og vi kan fortsætte med at arbejde roligt.
Indtil da må vi alle holde ud lidt længere.
Vil en service mesh være nyttig for mig, en beskeden softwareingeniør?
Et spørgsmål, der kan hjælpe med at besvare dette, kan findes i følgende spørgeskema:
Arbejder du udelukkende med implementering af forretningslogik? I så fald vil service mesh ikke være nyttig for dig. Selvfølgelig kan du blive interesseret, men ideelt set bør service mesh ikke direkte påvirke noget i dit miljø. Fortsæt med at arbejde med det, du får betalt for.
Understøtter du en platform i en virksomhed, der bruger Kubernetes? Ja, i så fald har du brug for en service mesh (naturligvis, hvis du ikke bruger K8s bare til at køre et monolith eller batch-behandling — men så ville jeg gerne spørge, hvorfor du overhovedet bruger K8s). Du vil sandsynligvis finde dig selv i en situation med mange mikrotjenester skrevet af forskellige personer. Alle interagerer med hinanden og er viklet ind i en rushe af runtime-afhængigheder, og du har brug for at finde en måde at håndtere det hele på. Ved at anvende Kubernetes kan du vælge en service mesh der passer til dine behov. For det formål skal du undersøge deres muligheder og funktioner og svare på spørgsmålet, om nogen af de eksisterende projekter overhovedet passer til dig (jeg anbefaler at starte undersøgelsen med Linkerd).
Arbejder du med en platform i en virksomhed, der IKKE bruger Kubernetes, men som bruger mikrotjenester? I så fald vil en service mesh være nyttig for dig, men dens anvendelse vil være uhåndterlig. Selvfølgelig kan du imiterer driften af en service mesh ved at placere en række proxyer, men en vigtig fordel ved Kubernetes er netop deploymentsmodellen: at vedligeholde disse proxyer manuelt vil kræve meget mere tid, kræfter og omkostninger.
Er du ansvarlig for platformen i en virksomhed, der arbejder med monolitter? I så fald har du sandsynligvis ikke brug for en service mesh. Hvis du arbejder med monolitter (eller endda sæt af monolitter) med klart definerede og sjældent ændrede interaktionsmønstre, så vil en service mesh ikke kunne tilbyde dig meget. Så du kan bare ignorere den og håbe, at den forsvinder som en skræmmende drøm...
Konklusion
Måske er det stadig ikke passende at kalde en service mesh "den mest hypede teknologi i verden" — den tvivlsomme ære tilfalder sandsynligvis bitcoin eller AI. Måske ligger den i top fem. Men hvis man graver sig igennem lagene af støj og brum, bliver det klart, at en service mesh giver reel værdi for dem, der bygger applikationer i Kubernetes.
Jeg vil gerne have, at du prøver Linkerd — installationen i et Kubernetes-kluster (eller endda i Minikube på din bærbare computer) , og så kan du selv se, hvad jeg taler om.
FAQ
— Hvis jeg ignorerer service mesh, forsvinder den?
— Jeg må skuffe dig: service mesh er her for at blive.
— Men jeg VIL IKKE bruge service mesh!
— Jamen så gør du ikke! Bare læs mit spørgeskema ovenfor for at forstå, om du i det mindste bør sætte dig ind i dets grundlæggende koncepter.
— Er det ikke bare den gode gamle ESB/middleware i ny forklædning?
— Service mesh håndterer driftslogik, ikke meningsindhold. ved virksomhedsbus (). At opretholde denne opdeling hjælper service mesh med at undgå den samme skæbne.
— Hvordan adskiller service mesh sig fra API-gateways?
— Der findes millioner af artikler om emnet. Bare søg på Google.
— Er Envoy en service mesh?
— Nej, Envoy er ikke en service mesh, det er en proxyserver. Den kan bruges til at organisere en service mesh (og meget andet — det er en general-purpose proxy). Men i sig selv er den ikke en service mesh.
— Er Network Service Mesh en service mesh?
— Nej. På trods af navnet er det ikke en service mesh (tak til marketingens vidundere?).
— Vil service mesh hjælpe min reaktive asynkrone system baseret på beskedkø?
— Nej, service mesh vil ikke hjælpe.
— Hvilken service mesh skal jeg bruge?
— , det er tydeligt.
— Artiklen er skod! / Forfatteren skal på maden!
— Venligst del linket til den med alle dine venner, så de kan få det bekræftet!
Taknemmelighed
Som du måske har gættet ud fra titlen, blev denne artikel inspireret af Jay Kreps' fantastiske afhandling “”. Jeg mødte Jay for ti år siden, da jeg interviewede hos LinkedIn, og siden da har han været en inspiration for mig.
Selvom jeg elsker at kalde mig selv “Linkerd-udvikler”, er virkeligheden, at jeg snarere er vedligeholder af README.md-filen i projektet. Der arbejder , , mennesker på Linkerd i dag, og dette projekt ville ikke være lykkedes uden det fantastiske fællesskab af bidragydere og brugere.
Og til sidst en særlig tak til skaberen af Linkerd, (primus inter pares), som for mange år siden dykkede hovedkulds ind i hele denne service mesh omtale sammen med mig.
P.S. fra oversætteren
Læs også på vores blog:
- «»;
- «»;
- «»;
- «»;
- «».
Kilde: habr.com
