

I den anden del af artiklen om simulatorer til computersystemer vil jeg fortsætte med at forklare på en enkel og informativ måde om computersimulatorer, særligt om fuldplatformssimulation, som den almindelige bruger oftest støder på, samt om taktsimulering og baner, der er mere udbredte blandt udviklere.
I Jeg har forklaret, hvad simulatorer generelt er, samt om niveauerne af modellering. Nu vil jeg baseret på den viden dykke lidt dybere og tale om fuldplatformssimulation, hvordan man opbygger baner, hvad man skal gøre med dem efterfølgende, samt om taktsimuleringsmikroarkitektur.
Fuldplatformsimulator (full platform simulator), eller “En alene på marken er ikke en kriger”
Hvis man skal undersøge arbejdet i en bestemt enhed, såsom et netværkskort, eller skrive firmware eller driver til denne enhed, kan man simulere enheden separat. Det er dog ikke særlig praktisk at bruge den isoleret fra den øvrige infrastruktur. For at køre den tilhørende driver kræves en centralprocessor, hukommelse, adgang til bus til dataoverførsel og meget mere. Derudover kræver driveren et operativsystem (OS) og netværksstak. Yderligere kan der være behov for en separat pakkegenerator og en server til at modtage svar.
Fuldplatformsimulatoren skaber et miljø til at køre et komplet softwarestack, der inkluderer alt fra BIOS og bootloader til selve OS'et og forskellige underliggende systemer, såsom netværksstak, drivere og applikationer på brugerniveau. For at opnå dette implementeres softwaremodeller af de fleste enheder i computeren: processor og hukommelse, disk, input/output-enheder (tastatur, mus, skærm), samt det pågældende netværkskort.
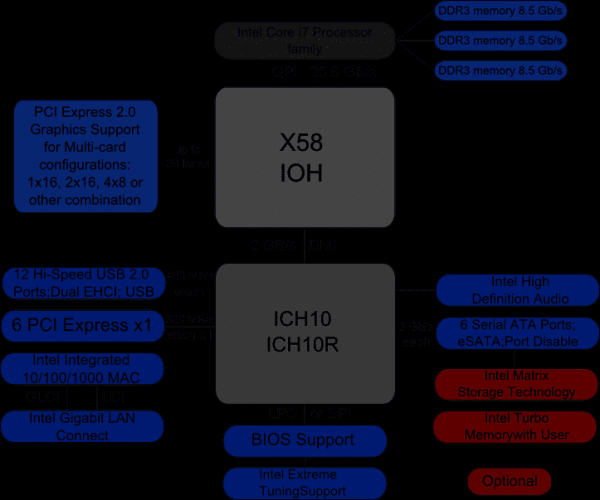
Nedenfor er blokdiagrammet for chipset x58 fra Intel. I en fuldplatformssimulator for computere, der bruger dette chipset, er det nødvendigt at implementere de fleste nævnte enheder, inklusive dem, der er inde i IOH (Input/Output Hub) og ICH (Input/Output Controller Hub), som ikke er detaljeret tegnet i blokdiagrammet. Selvom det i praksis viser sig, at der ikke er så få enheder, der ikke anvendes af den software, vi planlægger at køre. Modeller af sådanne enheder behøver ikke at blive oprettet.
Ofte implementeres fuldplatformssimulatorer på niveauet for processorens instruktioner (ISA; se ). Dette gør det muligt at skabe selve simulatoren relativt hurtigt og billigt. ISA-niveauet er også godt, da det forbliver mere eller mindre konstant, i modsætning til for eksempel API/ABI-niveauet, som ændrer sig oftere. Desuden gør implementeringen på instruktionernes niveau det muligt at køre såkaldt umodificeret binær software, hvilket betyder, at man kan køre allerede kompil kode uden ændringer, lige som det bruges på rigtig hardware. Med andre ord kan man lave en kopi ("dump") af harddisken, angive den som billede for modellen i den fuldplatformssimulator, og – vupti! – operativsystemet og andre programmer indlæses i simulatoren uden yderligere handlinger.
Ydelse af simulatorer
Som nævnt ovenfor er selve simuleringsprocessen af hele systemet, det vil sige alle dens enheder, en temmelig langsom proces. Hvis man også implementerer alt dette på et helt detaljeret niveau, for eksempel mikroarkitektonisk eller logisk, vil udførelsen blive ekstremt langsom. Men instruktionernes niveau er et passende valg og gør det muligt for operativsystemet og programmer at køre med hastigheder, der er tilstrækkelige for brugeren til en behagelig interaktion med dem.
Her vil det være passende at berøre emnet om ydelse af simulatorer. Det måles typisk i IPS (instruktioner pr. sekund), nærmere i MIPS (millioner IPS), det vil sige antallet af processorens instruktioner, der udføres af simulatoren på en sekund. I mellemtiden afhænger simuleringshastigheden også af ydelsen af det system, hvor simuleringsprocessen kører. Derfor kan det være mere korrekt at tale om "nedsættelse" (slowdown) af simulatoren i forhold til det originale system.
De mest udbredte fuldplatformssimulatorer på markedet, såsom QEMU, VirtualBox eller VmWare Workstation, har en glimrende ydeevne. For brugeren kan det endda være usynligt, at arbejdet foregår i en simulator. Dette skyldes de specielle virtualiseringsmuligheder, der er implementeret i processorene, binære oversættelsesalgoritmer og andre interessante elementer. Dette er alle emner for en separat artikel, men for at gøre det kort, så er virtualisering en hardwarefunktion i moderne processorer, der gør det muligt for simulatorer ikke at simulere instruktioner, men i stedet udføre dem direkte på den ægte processor, hvis selvfølgelig arkitekturerne for simulatoren og processorene ligner hinanden. Binær oversættelse er oversættelsen af den gæste-maskinkode til værtskode og den efterfølgende udførelse på den ægte processor. Som resultat er simuleringen kun lidt langsommere, med en faktor på 5-10, og fungerer ofte overhovedet med samme hastighed som det virkelige system. Dog påvirkes dette af mange faktorer. For eksempel, hvis vi ønsker at simulere et system med adskillige dusin processorer, vil hastigheden falde drastisk i forhold til det antal. På den anden side understøtter simulatorer som Simics i de seneste versioner multiprocessor-værtsikret hardware og effektivt paralleliserer de simulerede kerner på kernerne af den ægte processor.
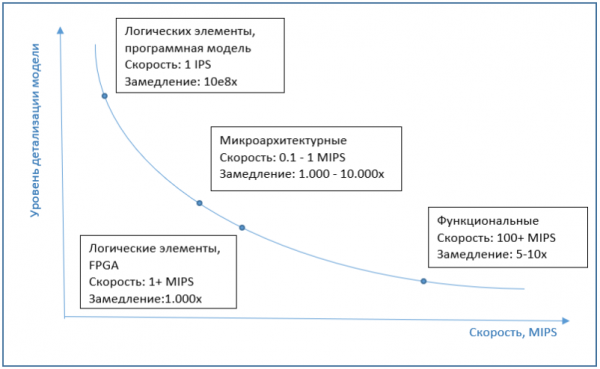
Når man taler om hastigheden for mikroarkitektursimulering, er den sædvanligvis flere rækkefter, omtrent 1000-10000 gange langsommere end udførelsen på en almindelig computer uden simulering. Implementeringer på niveauet af logiske elementer er endnu langsommere. Derfor bruges FPGA som emulator på dette niveau, hvilket væsentligt kan øge ydeevnen.
Grafen nedenfor viser den omtrentlige afhængighed af simuleringshastighed fra detaljeringen af modellen.
Taktsimulering
På trods af den lave udførelseshastighed er mikroarkitekturelle simulatorer ret udbredte. Modellerne af de indre blokke i processoren er nødvendige for præcist at simulere udførelsestiden for hver instruktion. Her kan der opstå misforståelse - for hvorfor kan man ikke bare programmere udførelsestiden for hver instruktion? Men en sådan simulator vil fungere meget upræcist, da udførelsestiden for den samme instruktion kan variere fra kald til kald.
Et simpelt eksempel er hukommelsestilgangs-instruktionen. Hvis den anmodede hukommelsescelle er tilgængelig i cachen, vil udførelsestiden være minimal. Hvis den pågældende information ikke er i cachen ("cache miss"), vil det markant øge udførelsestiden for instruktionen. Derfor er en cache-model nødvendig for præcis simulering. Men det stopper ikke ved cache-modellen. Processoren vil ikke bare vente på at hente data fra hukommelsen, hvis det ikke er i cachen. I stedet vil den begynde at udføre følgende instruktioner og vælge de, der ikke afhænger af resultatet af læsningen fra hukommelsen. Dette kaldes "out of order execution" (OOO) og er nødvendigt for at minimere processorens ventetid. At tage højde for alt dette ved beregning af udførelsestiden for instruktioner vil hjælpe modellering af de relevante processorblokke. Blandt disse instruktioner, der udføres, mens resultatet af læsningen fra hukommelsen afventes, kan der også være en betinget springoperation. Hvis udførelsesresultatet af betingelsen ikke kendes i øjeblikket, stopper processoren ikke sin udførelse, men laver en "formodning", udfører det tilsvarende spring og fortsætter med at udføre instruktioner proaktivt fra stedet for springet. En sådan blok, kaldet en branch predictor, skal også implementeres i den mikroarkitekturale simulator.
Billedet nedenfor viser hovedblokke i processoren; det er ikke nødvendigt at vide, men det er kun inkluderet for at vise kompleksiteten i mikroarkitekturel implementering.
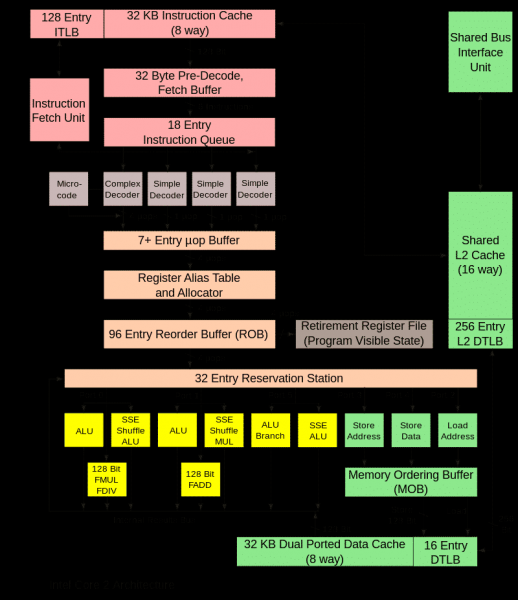
Driften af alle disse blokke i en rigtig processor synkroniseres med særlige klokkesignaler, og det samme gælder for modellen. En sådan mikroarkitektur-simulator kaldes en cyklusnøjagtig simulator. Dens primære formål er at forudsige ydeevnen af den udviklede processor præcist og/eller beregne udførelsestiden for et bestemt program, for eksempel et benchmark. Hvis værdierne ligger under det nødvendige, skal algoritmerne og processorblokkene revideres eller programmet optimeres.
Som nævnt tidligere er cyklusnøjagtig simulering meget langsom, derfor bruges den kun til at undersøge bestemte aspekter af programmets funktion, hvor det er nødvendigt at kende den reelle udførelseshastighed og vurdere den fremtidige ydeevne af enheden, hvis prototype simuleres.
Til simulering af den resterende programkørsel bruges en funktionel simulator. Hvordan foregår en sådan kombineret brug i praksis? Først startes den funktionelle simulator, hvor operativsystemet og alt nødvendigt til at starte det undersøgte program indlæses. Vi er ikke interesseret i selve operativsystemet, de indledende faser af programstarten, konfigurering osv. Men vi kan heller ikke springe disse dele over og bare gå til udførelsen af programmet fra midten. Derfor kører alle disse forberedende faser på den funktionelle simulator. Når programmet er udført til det punkt, vi er interesseret i, er der to muligheder. Man kan skifte til en cyklusnøjagtig model og fortsætte udførelsen. Simuleringsmetoden, hvor den eksekverbare kode anvendes (dvs. almindelige kompileringer af programfiler), kaldes udførelsesdrevet simulering. Dette er den mest udbredte form for simulering. Der er også en anden tilgang – sporbaseret simulering.
Sporbaseret simulering
Det består af to trin. Ved hjælp af en funktionel simulator eller på et reelt system indsamles og registreres programmets handlingslog i en fil. Denne log kaldes et spor. Afhængigt af hvad der undersøges, kan sporet omfatte udførelsesinstruktioner, hukommelsesadresser, portnumre og information om afbrud.
Næste skridt er "afspilning" af sporer, hvor cyklussimulatoren læser sporet og udfører alle instruktioner, der er skrevet i det. I slutningen får vi udførelsestidspunktet for denne del af programmet samt forskellige karakteristika ved denne proces, for eksempel cache-hit procent.
En vigtig egenskab ved arbejdet med spor er determinismen, det vil sige, at når vi kører simulationen på den beskrevede måde, reproducerer vi gang på gang den samme handlingssekvens. Dette giver mulighed for at ændre modelparametre (cache-størrelser, buffere og køer) og bruge forskellige interne algoritmer eller justere dem for at undersøge, hvordan en bestemt parameter påvirker systemets ydeevne og hvilken mulighed der giver de bedste resultater. Alt dette kan gøres med en prototype-model af enheden, før der skabes en reel hardwareprototype.
Kompleksiteten ved denne tilgang skyldes behovet for først at køre applikationen igennem og indsamle spor samt den enorme størrelse på sporfilen. Fordelen er, at man kun behøver at modellere den interessante del af enheden eller platformen, mens udførelsessimulationen som regel kræver en fuld model.
I denne artikel har vi set på funktionerne ved fuld platforms-simulering, talt om hastigheden af implementeringer på forskellige niveauer, cyklussimulering og spor. I den næste artikel vil jeg beskrive de vigtigste anvendelsesscenarier for simulatorer, både til personlige formål og i forhold til udvikling i større virksomheder.
Kilde: habr.com
