

Hej alle. Venner, vi deler en oversættelse af en artikel, der er forberedt specielt til studerende på kurset . Lad os komme i gang!
Apache Beam og DataFlow til realtids pipelines
Dagens indlæg er baseret på en opgave, jeg for nylig arbejdede med på jobbet. Jeg var meget glad for at kunne realisere det og beskrive det udførte arbejde i form af et blogindlæg, da det gav mig mulighed for at arbejde med dataengineering samt gøre noget, der ville være meget nyttigt for mit team. For ikke så længe siden opdagede jeg, at vores systemer indeholdt en ret stor brugerliste relateret til et af vores databehandlingsprodukter. Det viste sig, at ingen havde brugt disse data, så jeg blev straks interesseret i, hvad vi kunne lære, hvis vi begyndte at analysere dem regelmæssigt. Der var dog flere problemer undervejs. Det første problem var, at dataene var gemt i mange forskellige tekstfiler, som ikke var tilgængelige for øjeblikkelig analyse. Det andet problem var, at de var gemt i et lukket system, så jeg kunne ikke bruge nogle af mine yndlingsværktøjer til dataanalyse.
Jeg skulle finde ud af, hvordan vi kunne gøre adgangen lettere og tilføje nogen værdi ved at integrere denne datakilde i nogle af vores brugerinteraktionsløsninger. Efter at have tænkt over det i et stykke tid besluttede jeg at konstruere en pipeline til at overføre disse data til en cloud database, så jeg og teamet kunne få adgang til dem og begynde at generere nogle konklusioner. Efter at jeg havde færdiggjort min specialisering i Data Engineering på Coursera for et stykke tid siden, var jeg ivrig efter at bruge nogle værktøjer fra kurset i projektet.
Derfor syntes det at placere dataene i en cloud database at være en fornuftig måde at løse mit første problem på, men hvad kunne jeg gøre med problem nummer 2? Heldigvis var der en måde at flytte disse data til et miljø, hvor jeg kunne få adgang til værktøjer som Python og Google Cloud Platform (GCP). Men det var en lang proces, så jeg måtte gøre noget, der kunne lade mig fortsætte med udviklingen, mens jeg ventede på, at dataoverførslen blev færdig. Løsningen, jeg kom frem til, var at skabe falske data ved hjælp af biblioteket Faker i Python. Jeg har aldrig brugt dette bibliotek før, men jeg indså hurtigt, hvor nyttigt det er. Denne tilgang gjorde det muligt for mig at begynde at skrive kode og teste pipeline uden faktiske data.
Med det sagt, vil jeg i dette indlæg fortælle, hvordan jeg opbyggede den beskrevne pipeline ved hjælp af nogle af de teknologier, der er tilgængelige i GCP. Især vil jeg bruge Apache Beam (Python version), Dataflow, Pub/Sub og BigQuery til at indsamle brugerlogfiler, transformere data og overføre dem til databasen til videre analyse. I mit tilfælde var jeg kun nødt til at bruge Beam's batch-funktionalitet, da mine data ikke kom i realtid, så Pub/Sub var ikke nødvendigt. Jeg vil dog også dække streamingversionen, da dette er noget, du kan støde på i praksis.
Introduktion til GCP og Apache Beam
Google Cloud Platform tilbyder et sæt virkelig nyttige værktøjer til behandling af store data. Her er nogle af de værktøjer, jeg vil bruge:
- — er en messaging-tjeneste, der bruger Publisher-Subscriber mønsteret, som gør det muligt for os at modtage data i realtid.
- — er en tjeneste, der forenkler oprettelsen af datarørledninger og automatisk håndterer opgaver som skalering af infrastrukturen, hvilket betyder, at vi kun kan fokusere på at skrive kode til vores pipeline.
- — er en cloud-database. Hvis du er bekendt med andre SQL-databaser, vil du hurtigt finde dig til rette med BigQuery.
- Og endelig, vil vi bruge Apache Beam, specifikt fokusere på Python-versionen til at opbygge vores pipeline. Dette værktøj vil gøre det muligt for os at skabe en pipeline til streaming eller batch behandling, der integreres med GCP. Det er især nyttigt til parallel behandling og egner sig godt til ETL (Extract, Transform, Load) opgaver, så hvis vi skal flytte data fra et sted til et andet med transformationer eller beregninger, er Beam et godt valg.
Der er et bredt udvalg af værktøjer tilgængelige på GCP, så det kan være svært at holde styr på dem alle og deres formål, men her er en opsummering af dem til reference.
På GCP er der et stort antal værktøjer, så det kan være svært at omfatte dem alle, herunder deres funktioner, men ikke desto mindre. kort resume til reference.
Visualisering af vores pipeline
Lad os visualisere komponenterne i vores pipeline på figur 1. På højt niveau ønsker vi at indsamle brugerdata i realtid, behandle dem og sende dem til BigQuery. Logs oprettes, når brugerne interagerer med produktet ved at sende forespørgsler til serveren, som derefter logges. Disse data kan være særligt nyttige for at forstå, hvordan brugerne interagerer med vores produkt, og om det fungerer korrekt. Generelt vil pipelinen indeholde følgende trin:
Beam gør denne proces meget simpel, uanset om vi har en streaming datakilde eller en CSV-fil, og vi ønsker at udføre batchbehandling. Senere vil du se, at der kun er minimale ændringer i koden, der er nødvendige for at skifte mellem dem. Dette er en af fordelene ved at bruge Beam.
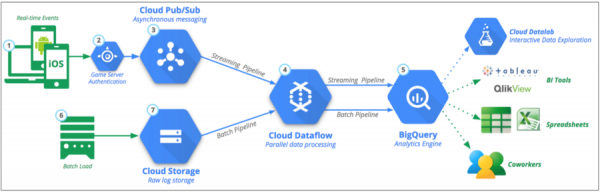
Figur 1: Hoveddatastrøm: Kilde:
Oprettelse af pseudodata ved hjælp af Faker
Som jeg nævnte tidligere, besluttede jeg at skabe pseudodata i det samme format som de faktiske, på grund af begrænset adgang til data. Det var virkelig en nyttig øvelse, da jeg kunne skrive kode og teste pipeline, mens jeg ventede på data. Lad os tage et kig på Faker, hvis du vil vide, hvad denne bibliotek ellers kan tilbyde. Vores brugerdata vil overordnet set ligne eksemplet nedenfor. Baseret på dette format kan vi generere linje-for-linje data for at simulere realtidsdata. Disse logs giver os information som dato, type forespørgsel, svar fra serveren, IP-adresse osv.
192.52.197.161 - - [30/Apr/2019:21:11:42] "PUT /tag/category/tag HTTP/1.1" [401] 155 "https://harris-lopez.com/categories/about/" "Mozilla/5.0 (Macintosh; PPC Mac OS X 10_11_2) AppleWebKit/5312 (KHTML, like Gecko) Chrome/34.0.855.0 Safari/5312"
Baseret på den ovenstående linje ønsker vi at oprette vores variabel LINE, ved at bruge 7 variabler i krøllede parenteser nedenfor. Vi vil også bruge dem som variable navne i vores tabel skema lidt senere.
LINE = """
 {remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
 """
Hvis vi skulle udføre batchbehandling, ville koden være meget lig, selvom vi skulle oprette et sæt eksempler inden for en bestemt tidsramme. For at bruge Faker skal vi blot oprette et objekt og kalde de metoder, vi har brug for. Især har Faker været nyttig til at generere IP-adresser og websteder. Jeg har brugt følgende metoder:
fake.ipv4()
 fake.uri_path()
 fake.uri()
 fake.user_agent()
from faker import Faker
import time
import random
import os
import numpy as np
from datetime import datetime, timedelta


LINE = """
{remote_addr} - - [{time_local}] "{request_type} {request_path} HTTP/1.1" [{status}] {body_bytes_sent} "{http_referer}" "{http_user_agent}"
"""


def generate_log_line():
    fake = Faker()
    now = datetime.now()
    remote_addr = fake.ipv4()
    time_local = now.strftime('%d/%b/%Y:%H:%M:%S')
    request_type = random.choice(["GET", "POST", "PUT"])
    request_path = "\/" + fake.uri_path()

    status = np.random.choice([200, 401, 404], p = [0.9, 0.05, 0.05])
    body_bytes_sent = random.choice(range(5, 1000, 1))
    http_referer = fake.uri()
    http_user_agent = fake.user_agent()

    log_line = LINE.format(
        remote_addr=remote_addr,
        time_local=time_local,
        request_type=request_type,
        request_path=request_path,
        status=status,
        body_bytes_sent=body_bytes_sent,
        http_referer=http_referer,
        http_user_agent=http_user_agent
    )

    return log_line
Slutningen af den første del.
I de kommende dage vil vi dele fortsættelsen af artiklen med dig, og som altid ser vi frem til dine kommentarer ;-).
Kilde: habr.com
