

I den seneste halvandet år har jeg arbejdet på at skabe et system til bekæmpelse af svindel (fraudulent activity, fraud, etc.) uden nogen indledende infrastruktur til dette. Dagens ideer, som vi har fundet og implementeret i vores system, hjælper os med at opdage mange svindelagtige aktiviteter og analysere dem. I denne artikel vil jeg gerne fortælle om de principper, vi har fulgt, og hvad vi har gjort for at nå den nuværende tilstand af vores system uden at gå i dybden med de tekniske detaljer.
Principperne for vores system
Når du hører termer som 'automatic' og 'fraud', begynder du sandsynligvis at tænke på maskinlæring, Apache Spark, Hadoop, Python, Airflow og andre teknologier inden for Apache Foundation-økosystemet og Data Science-området. Jeg tror, at der er én aspekt ved brugen af disse værktøjer, som sjældent nævnes: de kræver visse forudsætninger i dit virksomhedssystem, før du kan begynde at bruge dem. Kort sagt, du har brug for en dataplatform, der inkluderer et datalake og et lager. Men hvad nu, hvis du ikke har sådan en platform, og du stadig har brug for at udvikle denne praksis? De følgende principper, som jeg beskriver nedenfor, har hjulpet os med at nå et punkt, hvor vi kan fokusere på at forbedre vores ideer i stedet for at finde en, der fungerer. Ikke desto mindre er dette ikke et 'plateau' for projektet. Der er stadig mange ting tilbage i planen, både teknologisk og produktmæssigt.
Princip 1: Værdi for virksomheden først
I spidsen for alle vores bestræbelser har vi sat 'værdi for virksomheden'. Generelt hører ethvert system til automatisk analyse til gruppen af komplekse systemer med høj grad af automatisering og teknisk kompleksitet. At skabe en færdig løsning vil tage en hel del tid, hvis du bygger det fra bunden. Vi har besluttet at prioritere virksomhedens værdi over teknisk fuldstændighed. I praksis betyder det, at vi ikke tager avanceret teknologi som en dogme. Vi vælger den teknologi, der fungerer bedst for os lige nu. Over tid kan det vise sig, at vi skal implementere nogle moduler igen. Dette kompromis har vi accepteret.
Princip 2: Udvidet menneskelig intelligens (augmented intelligence)
Jeg ved, at de fleste mennesker, der ikke er dybt involveret i udviklingen af maskinløsninger, måske tror, at målet er at erstatte mennesker. I virkeligheden er maskinløsninger langt fra perfekte, og erstatning er kun muligt inden for bestemte områder. Vi forkastede denne idé fra starten af af flere grunde: ubalancerede data om svindel og manglende mulighed for at give en omfattende liste over funktioner til maskinlæringsmodeller. I stedet valgte vi en tilgang med udvidet intelligens. Det er et alternativt koncept til kunstig intelligens, der fokuserer på AI's støttefunktion, hvilket understreger, at kognitive teknologier er designet til at forbedre menneskelig intelligens i stedet for at erstatte den. [1]
Når man ser på dette, ville udviklingen af en komplet maskinløsning fra starten kræve enorme ressourcer, hvilket ville forsinke værdiskabelsen for vores virksomhed. Vi valgte at opbygge et system med en iterativt voksende tilgang til maskinlæring under vejledning af vores fagfolk. Den udfordrende del af udviklingen af et sådant system er, at det skal give vores analytikere sager ikke kun ud fra, om det er svindel eller ej. Generelt er enhver anomali i kundeadfærd en mistænkelig sag, som specialisterne skal undersøge og reagere på. Kun en del af disse registrerede sager kan faktisk kategoriseres som svindel.
Princip 3: platform for omfattende analytiske data
Den mest komplekse del af vores system er den end-to-end workflow kontrol. Analytikere og udviklere skal let kunne få adgang til datasæt fra tidligere perioder med alle de metrikker, der blev brugt til analysen. Derudover skal dataplatformen give en enkel måde at supplere eksisterende metrikker med nye. De processer, vi skaber, som ikke kun er softwareprocesser, skal gøre det nemt at genberegne tidligere perioder, tilføje nye metrikker og ændre dataprognoser. Vi kunne have nået dette ved at samle alle de data, som vores produktionssystem genererer. I så fald ville dataene gradvist blive en belastning. Vi ville skulle opbevare en voksende mængde data, som vi ikke bruger, og beskytte dem. I et sådant scenarie ville dataene over tid blive mere og mere irrelevante, men stadig kræve vores indsats for at administrere dem. For os gav det ikke mening at akkumulere data (data hoarding), og vi besluttede at anvende en anden tilgang. Vi besluttede at organisere realtidsdatacentre omkring de målrettede enheder, vi ønsker at klassificere, og kun opbevare de data, der gør det muligt at kontrollere de seneste og mest aktuelle perioder. Kompleksiteten i disse bestræbelser ligger i, at vores system er heterogent med flere datacentre og softwaremoduler, der kræver omhyggelig planlægning for sammenhængende drift.
De konstruktive koncepter i vores system
Vi har fire hovedkomponenter i vores system: ingestion system, computing, BI analysis og tracking system. De tjener specifikke isolerede formål, og vi holder dem isolerede ved at følge bestemte udviklingsmetoder.
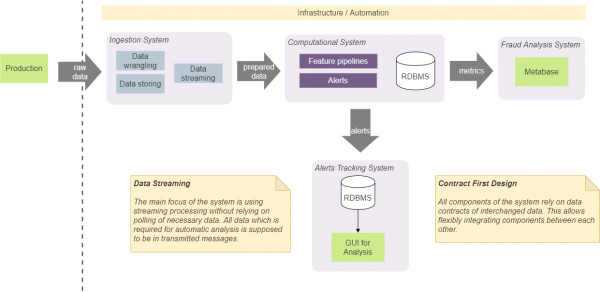
Kontraktbaseret design
Først og fremmest har vi aftalt, at komponenterne kun skal stole på bestemte datastrukturer (kontrakter), som overføres mellem dem. Dette muliggør nem integration mellem dem og påtvinger ikke en specifik sammensætning (og rækkefølge) af komponenter. For eksempel giver det i visse tilfælde mulighed for, at vi direkte kan integrere modtagessystemet med advarselskontrolsystemet. I så fald vil det blive udført i henhold til den aftalte kontrakt for advarsler. Det betyder, at begge komponenter vil blive integreret ved hjælp af en kontrakt, der kan anvendes af enhver anden komponent. Vi vil ikke tilføje en ekstra kontrakt til at tilføje advarsler til kontrolsystemet fra inputsystemet. Denne tilgang kræver brug af et foruddefineret minimalt antal kontrakter og forenkler systemet og kommunikationen. I princippet bruger vi en tilgang, der kaldes "Contract First Design", og anvender den på kontrakter for dataflow.
Streaming overalt
At gemme og administrere tilstand i systemet vil nødvendigvis føre til kompleksitet i implementeringen. Generelt bør tilstanden være tilgængelig fra enhver komponent, den skal være konsistent og give det mest aktuelle værdi for alle komponenter, og den skal være pålidelig med de korrekte værdier. Derudover øger tilstedeværelsen af opkald til permanent lager for at hente den seneste tilstand antallet af input/output-operationer og kompleksiteten af de algoritmer, der anvendes i vores realtids pipelines. Af denne grund har vi besluttet at fjerne opbevaring af tilstanden, hvis muligt, helt fra vores system. Denne tilgang kræver, at alle nødvendige data inkluderes i den overførte datablok (besked). For eksempel, hvis vi skal beregne det samlede antal af nogle observationer (antal operationer eller tilfælde med bestemte karakteristika), beregner vi det i hukommelsen og genererer en strøm af sådanne værdier. Afhængige moduler vil bruge partitionering og batching til at opdela strømmen efter enheder og operere med de seneste værdier. Denne tilgang har elimineret behovet for at have permanent diskopbevaring til sådanne data. Vores system bruger Kafka som beskedbrokker, og den kan bruges som en database med KSQL. [3] Men dets brug ville i høj grad binde vores løsning til Kafka, og vi har besluttet ikke at bruge det. Den tilgang, vi har valgt, tillader os at erstatte Kafka med en anden beskedbrokker uden betydelige interne ændringer i systemet.
Dette koncept betyder ikke, at vi ikke bruger diskopbevaring og databaser. For at verificere og analysere systemets ydeevne er det nødvendigt for os at opbevare en betydelig mængde data på disken, som repræsenterer forskellige målinger og tilstande. Et vigtigt punkt her er, at realtidsalgoritmerne ikke er afhængige af sådanne data. I de fleste tilfælde bruger vi gemte data til autonom analyse, debugging og sporing af specifikke tilfælde og resultater, som systemet genererer.
Problemerne i vores system
Der er visse problemer, som vi har løst til en vis grad, men de kræver mere gennemtænkte løsninger. Jeg vil gerne nævne dem her, da hvert punkt fortjener sin egen artikel.
- Vi skal stadig definere processer og politikker, der fremmer opbygningen af meningsfulde og relevante data til vores automatiske analyse, opdagelse og forskning af data.
- Implementeringen af menneskelig analyse i processen med automatisk systemjustering for at opdatere den med de nyeste data. Dette indebærer ikke kun opdatering af vores model, men også opdatering af processer og forbedring af vores forståelse af dataene.
- At finde balancen mellem en deterministisk IF-ELSE tilgang og ML. Nogen sagde: "ML er et redskab for de fortvivlede". Det betyder, at du vil bruge ML, når du ikke længere forstår, hvordan du optimerer og forbedrer dine algoritmer. På den anden side tillader den deterministiske tilgang ikke opdagelse af anomalier, der ikke var forudset.
- Vi har brug for en simpel måde at teste vores hypoteser eller korrelationer mellem målinger i dataene.
- Systemet skal have flere niveauer af reelle positive (true positive) resultater. Svindelsager er kun en del af alle de tilfælde, der kan betragtes som positive for systemet. For eksempel ønsker analytikere at modtage alle mistænkelige tilfælde til kontrol, og kun en lille del af dem er svindel. Systemet skal effektivt levere alle tilfælde til analytikerne, uanset om det er reel svindel eller blot mistænkelig adfærd.
- Data-platformen skal tillade adgang til datasæt fra tidligere perioder med beregninger, der er oprettet og beregnet i realtid.
- En simpel og automatisk udrulning af enhver af systemets komponenter i mindst tre forskellige miljøer: produktions-, eksperimentel (beta) og udviklermiljø.
- Og sidst, men ikke mindst. Vi har brug for at opbygge en omfattende ydeevnevalideringsplatform, hvor vi kan analysere vores modeller. [4]
Links
Kilde: habr.com
