

Hej, jeg hedder Evgeny, jeg er teamleder for B2B-afdelingen hos Ситимобил. En af vores teams opgaver er at understøtte integrationer til bestilling af taxier fra partnere, og for at sikre en stabil service skal vi altid forstå, hvad der sker i vores mikrotjenester. Derfor skal vi konstant overvåge loggene.
Hos Ситимобил bruger vi ELK-stakken (ElasticSearch, Logstash, Kibana) til at arbejde med loggene, og mængden af data, der kommer ind, er enorm. At finde problemer i dette store antal forespørgsler, som kan opstå efter implementeringen af ny kode, er ret svært. For at identificere dem visuelt er der en sektion i Kibana kaldet Dashboard.
På Хабре er der mange artikler med eksempler på, hvordan man konfigurerer ELK-stakken til at indsamle og gemme data, men der er ikke mange relevante materialer om oprettelsen af et Dashboard. Derfor vil jeg vise, hvordan man opretter en visuel repræsentation af data i Kibana baseret på de indkommende logfiler.
Indstillinger
For at gøre det mere visuelt har jeg oprettet et Docker-image med ELK og Filebeat. Og jeg har placeret en lille applikation skrevet i Go, som til vores eksempel vil generere testlogfiler. Jeg vil ikke gå i detaljer med konfigurationen af ELK, der er skrevet tilstrækkeligt om dette på Хабре.
Vi kloner repositoryet med konfigurationen docker-compose og indstillingerne for ELK, og starter det med kommandoen docker-compose up. Jeg tilføjer bevidst ikke en nøgle -d, så vi kan se processen med, hvordan ELK-stakken fungerer.
git clone https://github.com/et-soft/habr-elk
cd habr-elk
docker-compose up
Hvis alt er konfigureret korrekt, bør vi se en post i loggene (måske ikke med det samme, da opstarten af containeren med hele stakken kan tage nogle minutter):
{"type":"log","@timestamp":"2020-09-20T05:55:14Z","tags":["info","http","server","Kibana"],"pid":6,"message":"http server running at http://0:5601"}
På adressen localhost:5061 bør Kibana åbne.
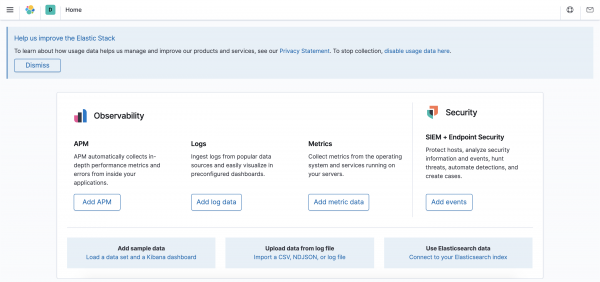
Det eneste, vi skal konfigurere, er at oprette et Index Pattern for Kibana med oplysninger om, hvilke data der skal vises. For at gøre dette udfører vi en curl-forespørgsel eller foretager en række handlinger i det grafiske interface.
$ curl -XPOST -D- 'http://localhost:5601/api/saved_objects/index-pattern'
     -H 'Content-Type: application/json'
     -H 'kbn-xsrf: true'
     -d '{"attributes":{"title":"logstash-*","timeFieldName":"@timestamp"}}'
Oprettelse af Index Pattern via det grafiske interface
Til konfiguration vælger vi sektionen Discover i venstre menu og kommer til siden for oprettelse af Index pattern.
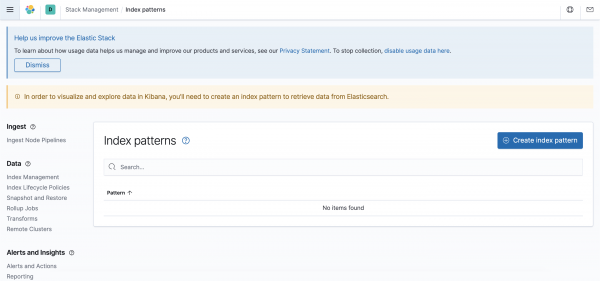
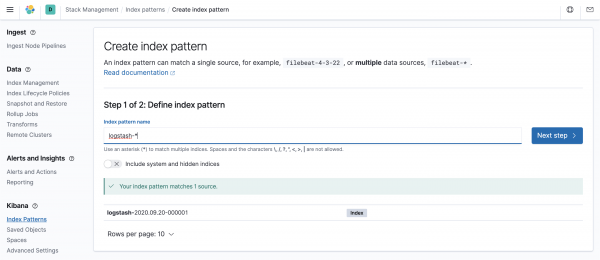
Ved at klikke på knappen 'Create index pattern' kommer vi til siden for oprettelse af indekset. I feltet 'Index pattern name' indtaster vi 'logstash-*'. Hvis alt er konfigureret korrekt, vil Kibana nedenfor vise de indekser, der falder ind under reglen.
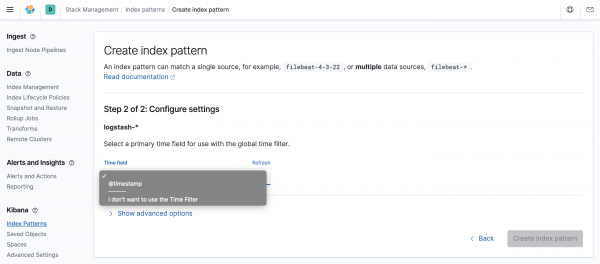
På den næste side vælger vi det nøgleværdifelt med tidsstempel, i vores tilfælde er det @timestamp.
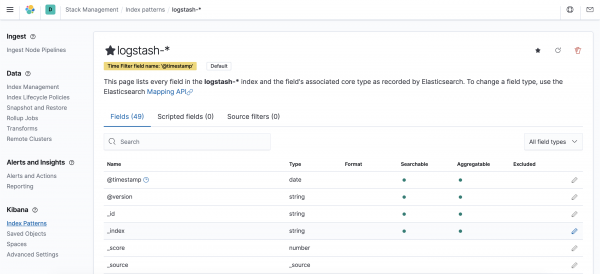
Resultatet vil være en indstillingsside for indekset, men i øjeblikket kræver det ingen yderligere handling fra os.
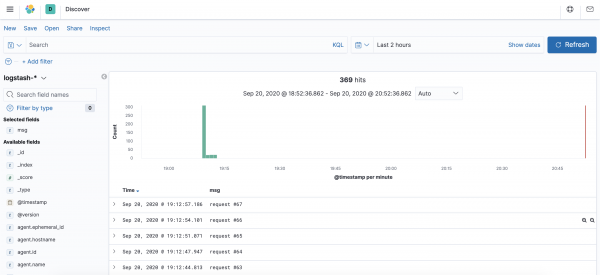
Nu kan vi igen gå til sektionen Discover, hvor vi vil se logposter.
Dashboard
I venstre menu klikker vi på sektionen for oprettelse af Dashboard og kommer til den relevante side.
Vi klikker på "Create new dashboard" og kommer til siden for tilføjelse af objekter til Dashboard.
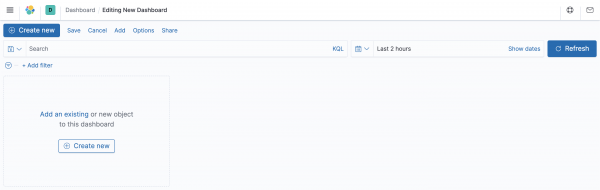
Vi klikker på knappen "Create new", og systemet vil foreslå, hvordan dataene skal vises. Der er mange visningsformer i Kibana, men vi vil se på oprettelse af en grafisk repræsentation "Vertical Bar" og en tabel "Data Table". De andre visningsformer konfigureres på lignende måde.
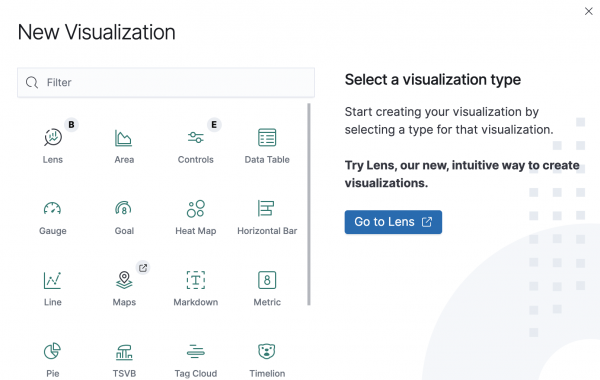
Nogle tilgængelige objekter har mærkerne B og E – dette betyder, at formatet er eksperimentelt eller i beta-test. Med tiden kan formatet ændre sig eller helt forsvinde fra Kibana.
Vertikal Bar
Som eksempel vil vi for "Vertical Bar" oprette et histogram over forholdet mellem succesfulde og ikke-succesfulde svarstatusser fra vores tjeneste. Ved afslutningen af indstillingerne får vi følgende graf:
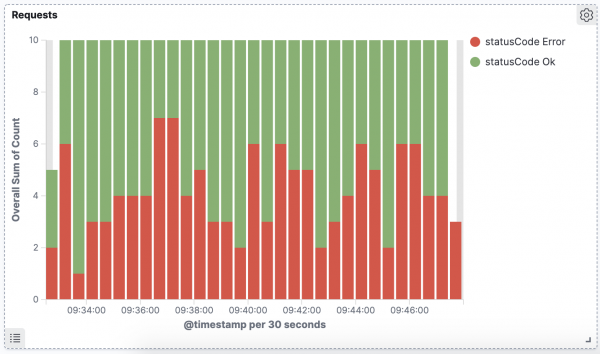
Vi vil betragte alle anmodninger med svarstatus < 400 som succesfulde, og dem med >= 400 som problematiske.
For at oprette "Vertical Bar"-grafen skal vi vælge datakilden. Vi vælger det Index Pattern, vi oprettede tidligere.
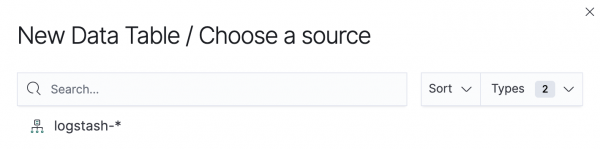
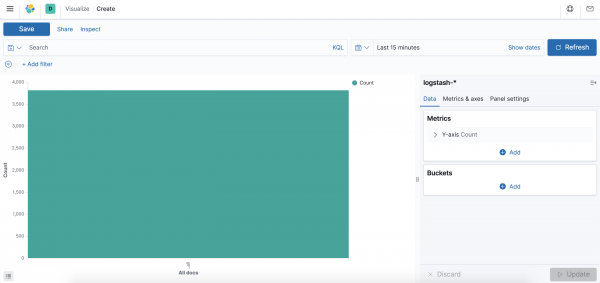
Som standard vil der efter valg af datakilde vises én sammenhængende graf. Lad os konfigurere den.
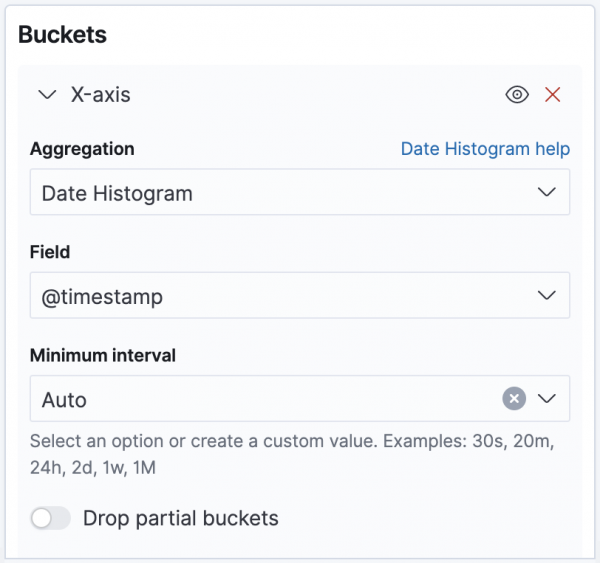
I sektionen "Buckets" klikker vi på knappen "Add", vælger "X-axis" og konfigurerer X-aksen. Vi vil vise tidsstempler for logposternes ankomst. I feltet "Aggregation" vælger vi "Date Histogram", og i "Field" vælger vi "@timestamp", som angiver tidsfeltet. "Minimum interval" lader vi stå på "Auto", og det vil automatisk tilpasse sig vores visning.
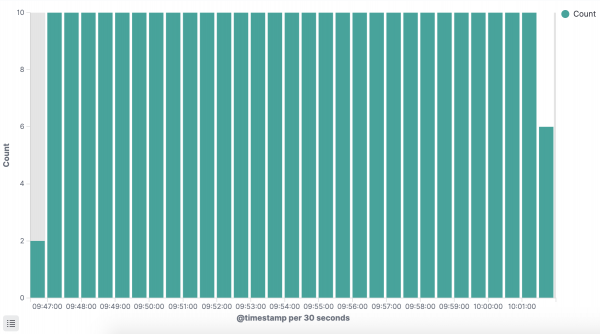
Når vi klikker på knappen "Update", vil vi se grafen med antallet af anmodninger hver 30. sekund.
Nu konfigurerer vi kolonnerne på Y-aksen. Lige nu vises det samlede antal anmodninger i det valgte tidsinterval.
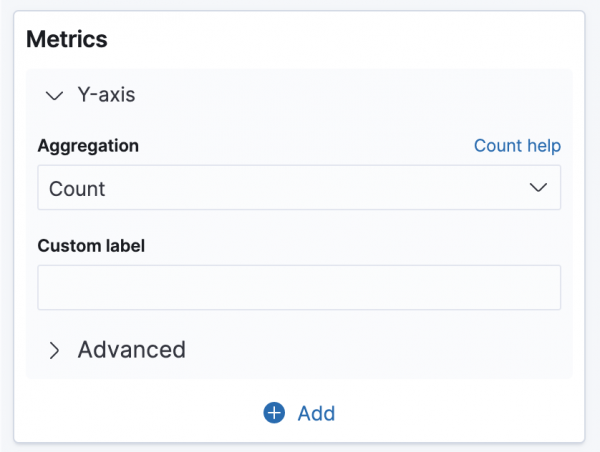
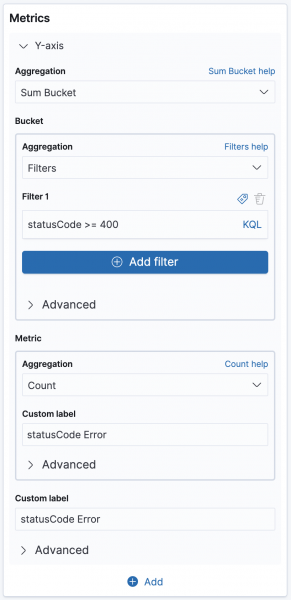
Vi ændrer værdien i "Aggregation" til "Sum Bucket", som gør det muligt for os at kombinere dataene for succesfulde og ikke-succesfulde anmodninger. I sektionen Bucket -> Aggregation vælger vi aggregering baseret på "Filters" og angiver filtrering for "statusCode >= 400". I feltet "Custom label" angiver vi vores indeksbeteckning for en mere forståelig visning i legenden på grafen og listen generelt.
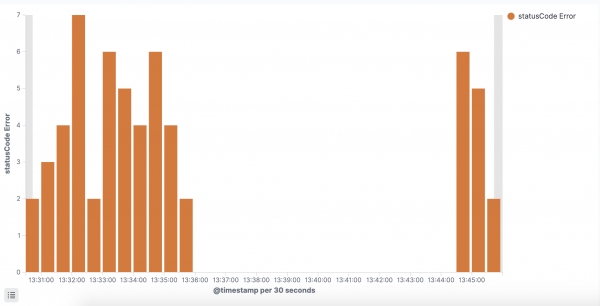
Når vi klikker på knappen "Update" under indstillingssektionen, får vi grafen med problematiske anmodninger.
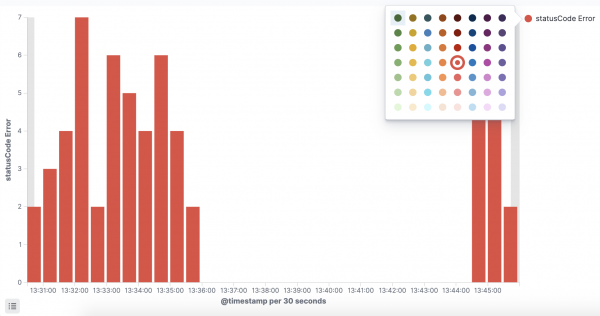
Hvis du klikker på cirklen ved siden af legenden, vises et vindue, hvor du kan ændre farven på søjlerne.
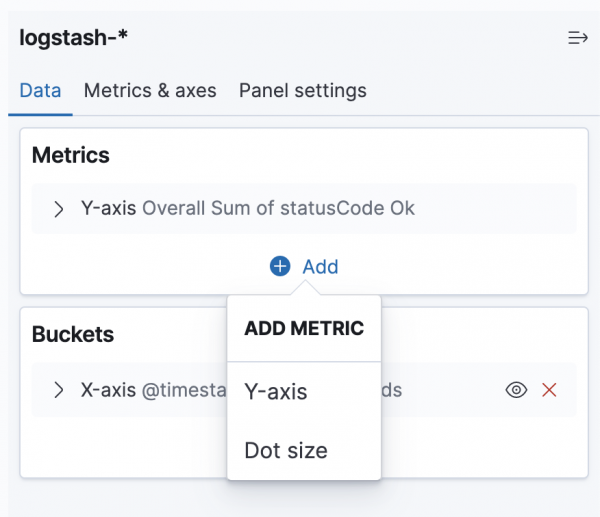
Lad os nu tilføje data om succesfulde forespørgsler til diagrammet. I afsnittet 'Metrics' klikker vi på knappen 'Add' og vælger 'Y-axis'.
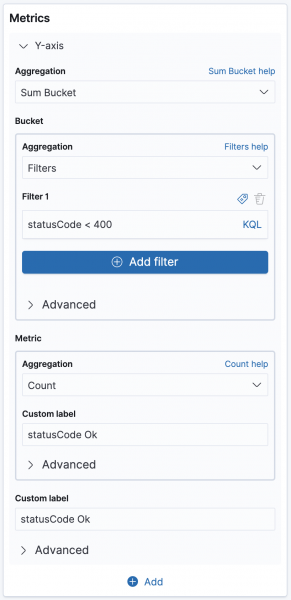
I den oprettede metrisk gør vi de samme indstillinger som for fejlede forespørgsler. Kun i filteret angiver vi 'statusCode < 400'.
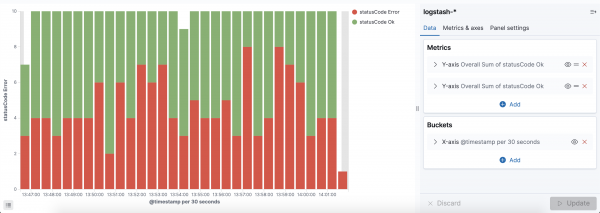
Ved at ændre farven på den nye søjle får vi en visualisering af forholdet mellem problematiske og succesfulde forespørgsler.
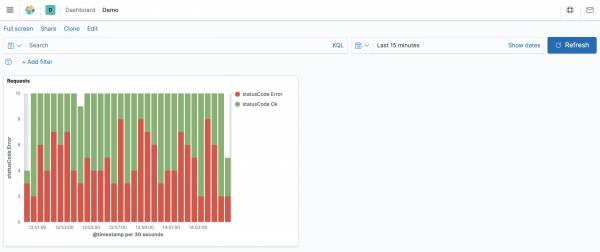
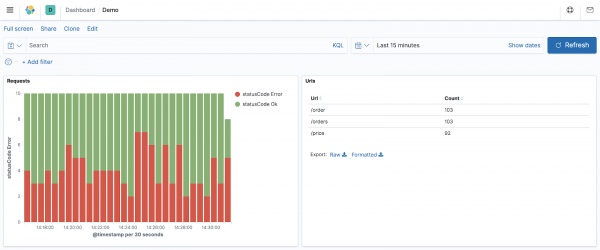
Når vi klikker på knappen 'Save' øverst på skærmen og angiver et navn, vil vi se det første diagram på Dashboard.
Datatabel
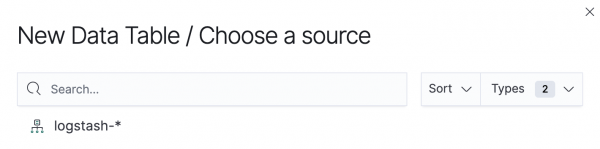
Lad os nu se på den tabelmæssige præsentation 'Data Table'. Vi opretter en tabel med en liste over alle URL'er, der blev forespurgt, og antallet af disse forespørgsler. Som i eksemplet med Vertical Bar vælger vi først datakilden.
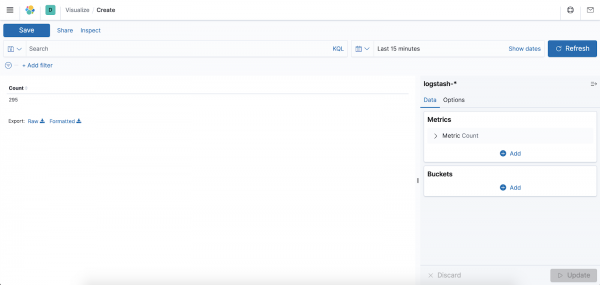
Efter dette vises en tabel på skærmen med en kolonne, der viser det samlede antal forespørgsler for det valgte tidsrum.
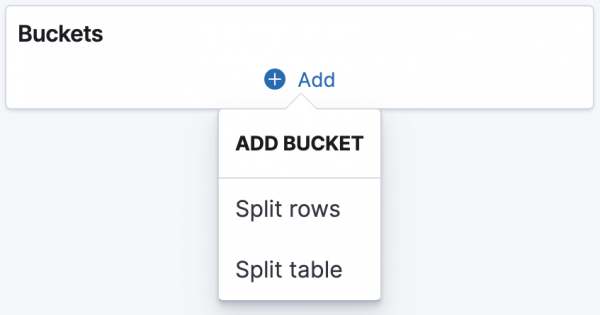
Vi vil kun ændre blokken 'Buckets'. Klik på knappen 'Add' og vælg 'Split rows'.
I feltet 'Aggregation' vælger vi 'Terms'. I det fremkomne felt 'Field' vælger vi 'url.keyword'.
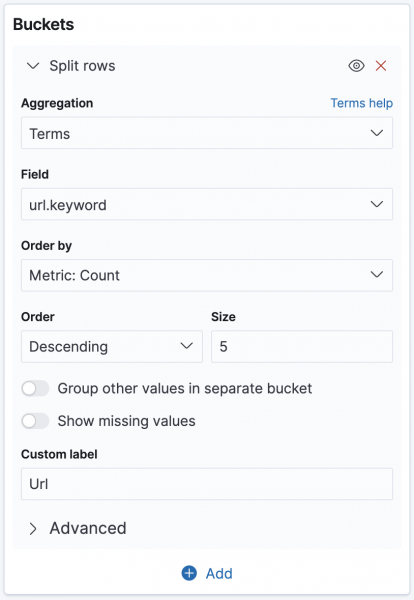
Ved at angive værdien 'Url' i feltet 'Custom label' og klikke på 'Update', får vi den ønskede tabel med antallet af forespørgsler pr. URL for den valgte tidsperiode.
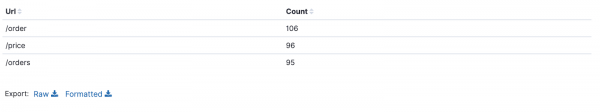
Øverst på skærmen klikker vi igen på knappen 'Save' og angiver tabelnavnet, for eksempel Urls. Vi går tilbage til Dashboard og ser begge oprettede visualiseringer.
Arbejder med Dashboard
Når vi opretter en Dashboard, har vi kun angivet de grundlæggende visningsparametre i indstillingerne for visualiseringsobjekterne. Det giver ikke mening at angive data til filtre i objekterne, for eksempel 'datointerval', 'filtrering efter useragent', 'filtrering efter land for forespørgslen', osv. Det er meget mere praktisk at angive det ønskede tidsinterval eller tilføje den nødvendige filtrering i forespørgselspanelet, der ligger over objekterne.

De filtre, der tilføjes i dette panel, vil blive anvendt på hele Dashboardet, og alle visualiseringsobjekter vil blive omorganiseret i henhold til de aktuelle filtrerede data.
Konklusion
Kibana er et kraftfuldt værktøj, der gør det muligt at visualisere enhver data på en brugervenlig måde. Jeg har forsøgt at vise opsætningen af to grundlæggende typer visualiseringer. Men andre typer konfigureres på lignende måde. Og de mange indstillinger, som jeg har efterladt 'i kulissen', vil give dig mulighed for meget fleksibelt at tilpasse graferne til dine behov.
Kilde: habr.com
