

 Når man arbejder med store mængder data, kan problemet med pladsmangel på diske ofte opstå. En af løsningerne på dette problem er komprimering, som gør det muligt at øge lagerkapaciteten på det samme udstyr. I denne artikel vil vi se på, hvordan datakomprimering fungerer i Apache Ignite. Artiklen vil kun beskrive de komprimeringsmetoder, der er implementeret i produktet. Andre metoder til datakomprimering (over netværket, i hukommelsen) vil ikke være medtaget, uanset om de er implementeret eller ej.
Så når persistence-tilstand er aktiveret, begynder Ignite at skrive til disken som et resultat af ændringer i dataene i cacherne:
- Indholdet af cacherne
- Journal for forudgående skrivning (Write Ahead Log, herefter blot WAL)
Der har længe eksisteret en mekanisme til komprimering af WAL, kaldet WAL compaction. I den nyligt udgivne Apache Ignite 2.8 er der også kommet to nye mekanismer, der muliggør komprimering af data på disken, nemlig disk page compression til komprimering af indholdet af cacherne og WAL page snapshot compression til komprimering af visse WAL-poster. Læs mere om disse tre mekanismer nedenfor.
Disk page compression
Hvordan fungerer det
Lad os først kort gennemgå, hvordan Ignite opbevarer data. Der anvendes sideorienteret hukommelse til opbevaring. Størrelsen på siden fastsættes ved start af noden og kan ikke ændres senere; størrelsen skal også være en potens af to og et multipel af filsystemets blokstørrelse. Sider hentes ind i RAM fra disken efter behov, og størrelsen på dataene på disken kan overstige den tildelte RAM. Hvis der ikke er plads i RAM til at hente en side fra disken, vil gamle, ikke-brugte sider blive skubbet ud af RAM.
Dataene gemmes på disken på følgende måde: for hver partition af hver cache-gruppe oprettes en separat fil, hvor siderne i stigende indeks rækkefølge følger hinanden. Den fulde identifiering af en side indeholder identificeringen af cache-gruppen, partitionens nummer og sidens indeks i filen. Dermed kan vi entydigt bestemme filen og offsettet i filen for hver side ud fra den fulde identifiering. Du kan læse mere om opbygningen af sideorienteret hukommelse i artiklen på Apache Ignite Wiki: .
Disk page compression-mekanismen arbejder, som navnet antyder, på en side-for-side basis. Når denne mekanisme er aktiveret, behandles data i RAM som de er, uden nogen kompression, men når siderne gemmes fra RAM til disk, komprimeres de.
Men at komprimere hver side individuelt løser stadig ikke problemet; vi skal finde en måde at reducere størrelsen på de endelige datofiler. Hvis størrelsen på en side ikke længere er fast, kan vi ikke længere skrive sider i filen én efter én, da det kan forårsage en række problemer:
- Vi kan ikke beregne offset for en side i filen ved hjælp af sidens indeks.
- Det er uklart, hvordan man skal håndtere sider, der ikke er i slutningen af filen og ændrer størrelse. Hvis størrelsen på en side reduceres, vil det frigjorte plads gå tabt. Hvis størrelsen på en side øges, skal der findes ny plads til den i filen.
- Hvis en side flyttes med et antal bytes, der ikke er et multiplum af blokstørrelsen i filsystemet, vil læsning eller skrivning af den kræve, at der berøres en blok mere i filsystemet, hvilket kan føre til degradering af ydeevnen.
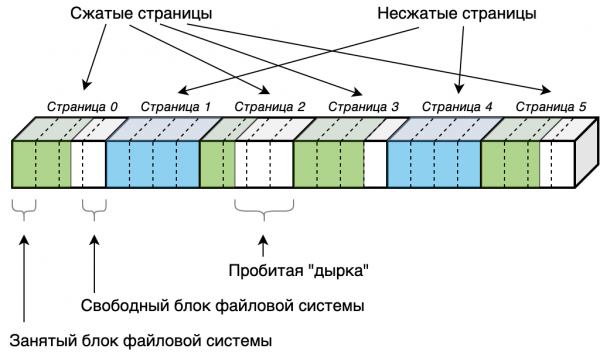
For at undgå at skulle håndtere disse problemer selv, bruger disk page compression i Apache Ignite et filsystemmekanisme kaldet sparse filer. En sparse (sparsom) fil er en fil, i hvilken nogle regioner, der er fyldt med nuller, kan mærkes som 'huller'. Der vil ikke blive tildelt filsystemblokke til at gemme disse huller, hvilket resulterer i besparelser på diskplads.
Det er logisk, at for at frigøre en filsystemblok, skal størrelsen af hullet være større end eller lig med blokstørrelsen, hvilket pålægger en yderligere begrænsning for side størrelsen i Apache Ignite: For at kompressionen skal have en effekt, skal størrelsen på en side være strengt større end blokstørrelsen i filsystemet. Hvis størrelsen på en side er lig med blokstørrelsen, vil vi aldrig kunne frigøre nogen blokke, da for at frigøre en enkelt blok, skal den komprimerede side tage 0 bytes. Hvis størrelsen på en side derimod er lig med størrelsen på 2 eller 4 blokke, kan vi allerede frigøre mindst én blok, hvis vores side komprimeres med mindst 50% eller 75% henholdsvis.
Således er den endelige beskrivelse af mekanismens arbejde: Når en side skrives til disk, forsøges det at komprimere siden. Hvis den komprimerede sides størrelse gør det muligt at frigive en eller flere blokke fra filsystemet, skrives siden i komprimeret form, og der laves et 'hul' (udføres et systemopkald fallocate() med flaget „punch hole“). Hvis størrelsen på den komprimerede side ikke tillader at frigive blokke, gemmes siden som den er, i ukomprimeret form. Alle offsets af siderne beregnes som uden kompression, ved at gange sideindekset med sidens størrelse. Ingen relokering af sider kræves manuelt. Offsets af siderne, som uden kompression, rammer grænserne for filsystemblokkene.
I den nuværende implementering kan Ignite kun arbejde med sparse filer under Linux, derfor kan disk page compression kun aktiveres, når Ignite bruges på dette operativsystem.
Kompressionsalgoritmer, der kan anvendes til disk page compression: ZSTD, LZ4, Snappy. Derudover er der en driftsform (SKIP_GARBAGE), hvor kun det ubrugte plads i siden kasseres uden at anvende kompression på de resterende data, hvilket reducerer CPU-belastningen sammenlignet med de tidligere nævnte algoritmer.
Indflydelse på ydeevnen
Desværre har jeg ikke foretaget målinger af ydeevnen på reelle teststands, da vi ikke planlægger at bruge denne mekanisme i produktionen, men vi kan teoretisk overveje, hvor vi vil tabe, og hvor vi vil vinde.
For at forstå dette må vi huske, hvordan læsning og skrivning af sider udføres, når der tilgås dem:
- Når læseoperationen udføres, søges det først i RAM, hvis søgningen ikke lykkes, indlæses siden i RAM fra disken af den samme tråd, der udfører læsningen.
- Ved udførelsen af skriveoperationer bliver siden i RAM markeret som beskidt, men den fysiske gemming af siden til disk finder ikke sted med det samme i den tråd, der udfører skrivningen. Alle beskidte sider gemmes senere på disken i checkpoints af separate tråde.
Derfor påvirkning på læseoperationer:
- Positiv (disk IO), ved at reducere antallet af læste blokke fra filsystemet.
- Negativ (CPU), på grund af den ekstra belastning, der kræves af operativsystemet for at arbejde med sparse-filer. Det er også muligt, at der her implicit opstår yderligere IO-operationer for at bevare den mere komplekse struktur af en sparse-fil (desværre er jeg ikke bekendt med alle detaljer om, hvordan sparse-filer fungerer).
- Negativ (CPU), på grund af behovet for dekompression af sider.
- Der er ingen indflydelse på skriveoperationer.
- Indflydelse på checkpoint-processen (her er det analogt med læseoperationer):
- Positiv (disk IO), på grund af reduktionen af antallet af skrevne blokke i filsystemet.
- Negativ (CPU, muligvis disk IO), på grund af arbejdet med sparse-filer.
- Negativ (CPU), på grund af behovet for kompression af sider.
Hvilken vej vægtene vil tippe? Det afhænger meget af miljøet, men jeg hælder til, at disk sidekompression sandsynligvis vil føre til en nedgang i ydeevnen på de fleste systemer. Især da tests på andre DBMS'er, der bruger en lignende tilgang med sparse-filer, viser fald i ydeevnen, når kompression er aktiveret.
Hvordan man aktiverer og konfigurerer
Som nævnt ovenfor er den minimale version af Apache Ignite, der understøtter disk page compression: 2.8 og understøttes kun af operativsystemet Linux. Aktivering og konfiguration udføres som følger:
- Modulet ignite-compression skal være i class-path. Som standard findes det i distribueringspakken af Apache Ignite i biblioteket libs/optional og inkluderes ikke i class-path. Du kan blot flytte biblioteket op ét niveau i libs, så det automatisk inkluderes, når du starter via ignite.sh.
- Persistence skal være aktiveret (aktiveres via
DataRegionConfiguration.setPersistenceEnabled(true)). - Størrelsen på siden skal være større end størrelsen på filsystemblokken (kan angives ved hjælp af
DataStorageConfiguration.setPageSize()). - For hver cache, hvis data skal komprimeres, skal der i konfigurationen indstilles en kompressionsmetode og (valgfrit) kompressionsniveau (metoderne
CacheConfiguration.setDiskPageCompression(), CacheConfiguration.setDiskPageCompressionLevel()).
WAL komprimering
Hvordan fungerer det
Hvad er WAL, og hvorfor er det vigtigt? Meget kort: Det er en log, hvor alle begivenheder, der ændrer det sidetilfredsstillende lager, registreres. Det er primært nødvendigt for at muliggøre genopretning i tilfælde af nedbrud. Enhver operation skal, inden den giver kontrol til brugeren, først registrere en begivenhed i WAL, så man efter et nedbrud har mulighed for at spille loggen tilbage og genoprette alle operationer, som brugeren har fået et positivt svar på, selvom disse operationer ikke er blevet reflekteret i det sidetilfredsstillende lager på disken (det blev tidligere nævnt, at den faktiske skrivning til det sidetilfredsstillende lager sker i en proces kaldet "checkpoint" med en vis forsinkelse af separate tråde).
Posterne i WAL opdeles i logiske og fysiske. Logiske er selve nøglerne og værdierne. Fysiske afspejler ændringerne i siderne i det sidetilfredsstillende lager. Hvis logiske poster kan være nyttige i andre tilfælde, er fysiske poster kun nødvendige for genopretning i tilfælde af nedbrud og inkluderer kun poster fra det seneste succesfulde checkpoint. Her vil vi ikke gå ind i detaljerne og forklare, hvorfor det fungerer på denne måde, men de, der er interesseret, kan henvise til den allerede nævnte artikel på Apache Ignite Wiki: .
Der kan ofte være flere fysiske poster pr. logisk post. Det vil sige, at for eksempel en put-operation i cachen berører flere sider i sidetilfredsstillende hukommelse (siden med selve dataene, sider med indekser, sider med frie lister). I nogle syntetiske tests viste det sig, at fysiske poster udgjorde op til 90% af volumet af WAL-filen. Samtidig er de kun nødvendige i meget kort tid (som standardintervallet mellem checkpoints er 3 minutter). Det ville være logisk at fjerne disse data, når de mister deres relevans. Det er netop, hvad mekanismen til WAL-komprimering gør, den fjerner fysiske poster og komprimerer de resterende logiske poster ved hjælp af zip, hvilket resulterer i en betydelig reduktion i filstørrelsen (nogle gange med titusindvis af gange).
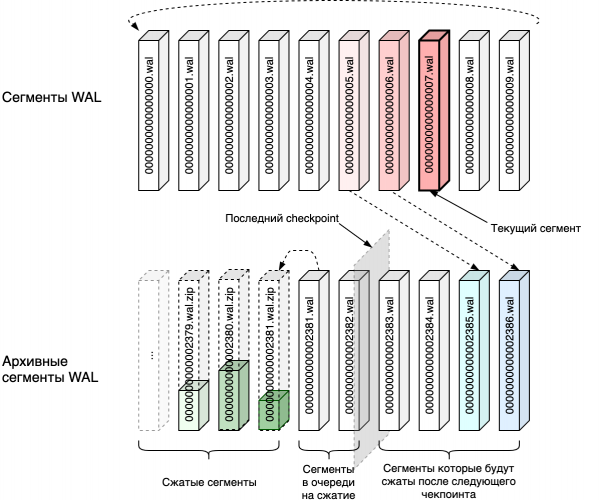
Den fysiske WAL består af flere segmenter (standard 10) af fast størrelse (standard 64 MB), som overskrives cirkulært. Når det nuværende segment er fyldt, tildeles det følgende segment det aktuelle, og det fyldte segment kopieres til arkivet i en separat tråd. WAL-komprimering arbejder allerede med arkiverede segmenter. Desuden sporer den i en separat tråd udførelsen af checkpointet og begynder komprimeringen af de arkiverede segmenter, som ikke længere er nødvendige.
Indflydelse på ydeevnen
Da WAL-komprimering kører i en separat tråd, bør den ikke have nogen direkte indflydelse på de udførte operationer. Men den giver alligevel en ekstra baggrundsbelastning på CPU'en (komprimering) og disken (læsning af hvert WAL-segment fra arkivet og skrivning af komprimerede segmenter), så hvis systemet arbejder på grænsen af kapaciteten, vil det også medføre en nedgradering af ydeevnen.
Hvordan man aktiverer og konfigurerer
WAL-komprimering kan aktiveres ved hjælp af egenskaben WalCompactionEnabled i DataStorageConfiguration (DataStorageConfiguration.setWalCompactionEnabled(true)). Desuden kan graden af komprimering angives med metoden DataStorageConfiguration.setWalCompactionLevel(), hvis standardværdien (BEST_SPEED) ikke er tilfredsstillende.
WAL-side snapshot komprimering
Hvordan fungerer det
Tidligere har vi allerede afklaret, at WAL-poster opdeles i logiske og fysiske. For hver ændring af hver side i sidehukommelsen oprettes en fysisk WAL-post. Fysiske poster opdeles igen i to underkategorier: page snapshot record og delta record. Hver gang vi ændrer noget på en side og ændrer den fra en ren til en besmittet tilstand, gemmes en fuld kopi af denne side i WAL (page snapshot record — snapshots af siden). Selvom vi kun ændrer én byte, vil WAL gemme en post, der er lidt større end størrelsen af siden. Hvis vi derimod ændrer noget på en allerede besmittet side, dannes der en delta record i WAL, der kun reflekterer ændringerne i forhold til den tidligere tilstand af siden, men ikke hele siden. Da nulstillingen af siden fra besmittet til ren udføres under checkpoint-processen, vil næsten alle fysiske poster straks efter begyndelsen af checkpointet kun bestå af snapshots af siderne (da alle sider umiddelbart efter begyndelsen af checkpointet er rene), og efterhånden som vi nærmer os det næste checkpoint, begynder andelen af delta records at stige og nulstilles igen ved begyndelsen af det næste checkpoint. Målinger fra nogle syntetiske tests har vist, at andelen af snapshots af sider i den samlede mængde af fysiske poster når op på 90%.
Idéen om WAL page snapshot-komprimering er at komprimere snapshots af siderne ved hjælp af et allerede eksisterende værktøj til kompression af sider (se disk page compression). I dette tilfælde gemmes WAL-posterne sekventielt i append-only-tilstand, og der er ikke behov for at binde posterne til grænserne for filsystemets blokke. Derfor, i modsætning til mekanismen for disk page compression, har vi slet ikke brug for sparse-filer, hvilket betyder, at denne mekanisme også vil fungere på ikke-Linux OS. Desuden er det ikke længere vigtigt, hvor meget vi har kunnet komprimere siden. Selv hvis vi har frigivet 1 byte, er det allerede et positivt resultat, og vi kan gemme de komprimerede data i WAL, i modsætning til disk page compression, hvor vi kun gemmer den komprimerede side, hvis vi har frigivet mere end 1 blok i filsystemet.
Sider er let komprimerbare data, og deres andel af den samlede WAL-størrelse er meget høj. På denne måde kan vi opnå en betydelig reduktion af filstørrelsen uden at ændre formatet på WAL-filen. Komprimering af de logiske indsigter ville derimod kræve en ændring af formatet og tab af kompatibilitet, for eksempel for eksterne brugere, som kunne være interesseret i logiske optegnelser, samtidig med at det ikke ville medføre en væsentlig reduktion af filens volumen.
Som med disk sidekomprimering kan der til WAL side snapshot-komprimering benyttes komprimeringsalgoritmerne ZSTD, LZ4, Snappy samt tilstanden SKIP_GARBAGE.
Indflydelse på ydeevnen
Som man kan se, påvirker direkte aktivering af WAL side snapshot-komprimering kun de strømme, der skriver data til sidememorien, det vil sige de strømme, der ændrer data i cachen. Læsning fra WAL fysiske optegnelser sker kun én gang, når noden startes efter et nedbrud (og kun i tilfælde af nedbrud under checkpoint-processen).
Dette påvirker de strømme, der ændrer data, på følgende måde: Vi får en negativ effekt (CPU) på grund af behovet for konstant at komprimere siden, før den skrives til disken, og en positiv effekt (disk IO) på grund af reduktionen af de data, der skrives. Derfor er det simpelt; hvis systemets ydeevne er begrænset af CPU'en, får vi en lille degradation, hvis det er diskinput/output – får vi en gevinst.
Indirekte påvirker reduktionen af WAL-størrelsen også (positivt) de strømme, der arkiverer WAL-segmenter, og de strømme, der arbejder med WAL-komprimering.
Virkelige ydeevnetests i vores miljø med syntetiske data har vist en lille stigning (gennemstrømningen er steget med 10%-15%, og latensen er faldet med 10%-15%).
Hvordan man aktiverer og konfigurerer
Minimumsversion af Apache Ignite: 2.8. Aktivering og konfiguration udføres som følger:
- Modulet ignite-compression skal være i class-path. Som standard findes det i distribueringspakken af Apache Ignite i biblioteket libs/optional og inkluderes ikke i class-path. Du kan blot flytte biblioteket op ét niveau i libs, så det automatisk inkluderes, når du starter via ignite.sh.
- Persistence skal være aktiveret (aktiveres via
DataRegionConfiguration.setPersistenceEnabled(true)). - Kompresseringsmetoden skal angives via metoden
DataStorageConfiguration.setWalPageCompression(), som standard er komprimering deaktiveret (tilstand DISABLED). - Valgfrit kan komprimeringsgraden angives via metoden
DataStorageConfiguration.setWalPageCompression(), se de tilladte værdier for hver tilstand i javadoc til metoden.
Konklusion
De diskutere mekanismer til datakomprimering i Apache Ignite kan bruges uafhængigt af hinanden, men enhver kombination er også acceptabel. Forståelsen af deres arbejdsprincipper vil gøre det muligt at afgøre, hvor godt de passer til dine opgaver i dit miljø, og hvad du eventuelt må ofre ved deres brug. Disk sidekomprimering er beregnet til at komprimere det primære lager og kan give en gennemsnitlig kompressionsgrad. WAL side snapshot komprimering vil give en gennemsnitlig kompressionsgrad for allerede eksisterende WAL-filer, og vil sandsynligvis endda øge ydeevnen. WAL komprimering vil ikke have en positiv effekt på ydeevnen, men vil maksimalt reducere størrelsen på WAL-filerne ved at fjerne fysiske poster.
Kilde: habr.com
