

Under den nuværende COVID-19-pandemi er der opstået mange problemer, som hackere gerne har kastet sig over. Fra ansigtsskærme fremstillet med 3D-printere og hjemmelavede stofmasker til erstatning af fuldgyldige mekaniske kunstige åndedrætsapparater – denne strøm af ideer har inspireret og glædet sjælen. Samtidig har der været forsøg på at fremme arbejdet på et andet område: i forskning, der har til formål at bekæmpe selve viruset.
Det ser ud til, at der er det største potentiale for at stoppe den nuværende pandemi og forudse alle efterfølgende med en tilgang, der forsøger at komme til kernen af problemet. Denne tilgang, der falder ind under kategorien "kend din fjende", praktiseres af det beregningsmæssige projekt Folding@Home. Millioner af mennesker har tilmeldt sig projektet og donerer en del af deres processorkraft og GPU'er, hvilket skaber den største [fordelte] supercomputer i historien.
Men hvad bruges alle disse eksaflops egentlig til? Hvorfor er det nødvendigt at kaste sådan beregningskraft på ? Какая тут работает биохимия, зачем вообще белкам нужно укладываться? Вот краткий обзор фолдинга белков: что это, как он происходит и в чём его важность.
For det første, hvad er det vigtigste: hvorfor er proteiner nødvendige?
Proteiner er livsnødvendige strukturer. De giver ikke kun byggemateriale til celler, men fungerer også som enzymkatalysatorer for praktisk talt alle biokemiske reaktioner. Proteiner, hvad enten de er eller , består af lange kæder , der er arrangeret i en specifik sekvens. Proteinernes funktioner bestemmes af, hvilke aminosyrer der er placeret på bestemte steder i proteinet. Hvis et protein for eksempel har brug for at binde sig til en positivt ladet molekyle, skal bindingsstedet være fyldt med negativt ladede aminosyrer.
For at forstå, hvordan proteiner får den struktur, der bestemmer deres funktion, skal vi gennemgå grundlæggende molekylærbiologi og informationsstrømmen i cellen.
Produktion, eller af proteiner begynder med processen . Under transkriptionen deles DNA-dobbeltspiralen, der indeholder den genetiske information fra cellen, delvist op, hvilket giver adgang til DNA's nitrogenbaser for et enzym kaldet . Opgaven for RNA-polymerase er at lave en RNA-kopi, eller transkription, af genet. Denne kopi af genet kaldes (mRNA) er et enkeltstrenget molekyle, der er perfekt til at styre de intracellulære proteinfabrikker, , som er ansvarlige for produktion eller af proteiner.
Ribosomer fungerer som samlingsanordninger – de fanger mRNA-skabelonen og matcher den med andre små RNA-stykker, (tRNA). Hver tRNA har to aktive områder – et afsnit med tre baser kaldet , som skal matche de tilsvarende kodoner på mRNA, og et område til binding af en aminosyre, specifik for denne Under translation forsøger tRNA-molekyler i ribosomet tilfældigt at binde sig med mRNA ved hjælp af antikodoner. Hvis det lykkes, binder tRNA-molekylet sin aminosyre til den forrige og danner endnu et led i kæden af aminosyrer, der er kodet af mRNA.
Denne aminosyresekvens er det første niveau af den strukturelle hierarki af proteinet, og kaldes derfor dens Hele proteinets tredimensionelle struktur og dets funktioner stammer direkte fra den primære struktur og afhænger af de forskellige egenskaber ved hver af aminosyrerne og deres interaktioner imellem. Uden disse kemiske egenskaber og interaktioner af aminosyrer, ville forblive lineære sekvenser uden tredimensionel struktur. Dette kan ses hver gang under madlavning – i denne proces sker der en termisk af proteiners tredimensionelle struktur.
Langdistancebindinger af proteiners dele
Det næste niveau af den tredimensionelle struktur, der går ud over den primære, har fået det snedige navn Det omfatter hydrogenbindinger mellem aminosyrer i relativt tæt afstand. Essensen af disse stabiliserende interaktioner kan opsummeres i to ting: og Alfa-helixen danner et stramt snoet segment af polypeptidet, mens beta-sheet'et er et glat og bredt område. Begge formationer har både strukturelle og funktionelle egenskaber, der afhænger af karakteristikaene af de aminosyrer, der udgør dem. For eksempel, hvis alfa-helixen hovedsageligt består af hydrofile aminosyrer som eller , så den vil sandsynligvis deltage i vandreaktioner.
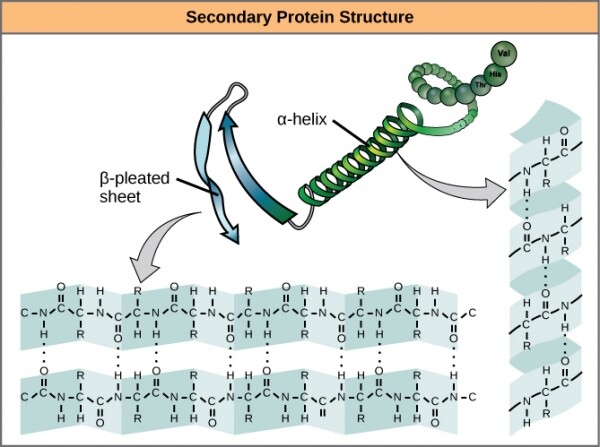
Alfa-spiraler og beta-lister i proteiner. Hydrogenbindinger dannes under proteinudtrykket.
Disse to strukturer og deres kombinationer danner det næste niveau af proteinstruktur — . I modsætning til simple fragmenter af sekundær struktur påvirkes den tertiære struktur hovedsageligt af hydrofobicitet. I centre af de fleste proteiner findes aminosyrer med høj hydrofobicitet, såsom eller , og vand udelukkes derfra på grund af de "fede" naturer af radikalerne. Disse strukturer ses ofte i transmembrane proteiner, der er indlejret i den dobbelte lipidmembran, der omgiver celler. Hydrofobiske områder i proteiner forbliver termodynamisk stabile indeni den fedtholdige del af membranen, mens de hydrofile områder af proteinet udsættes for vandmiljøet på begge sider.
Desuden sikres stabiliteten af de tertiære strukturer ved langdistancebindinger mellem aminosyrerne. Et klassisk eksempel på sådanne bindinger er , der ofte opstår mellem to radikaler af cystein. Hvis du har følt en lugt, der minder om rådne æg i frisørsalonen under en permanent behandling af en kundes hår, var det en delvis denaturering af den tertiære struktur af keratin i håret, der fandt sted ved at reducere disulfidbindingerne ved hjælp af svovlholdige blandinger.
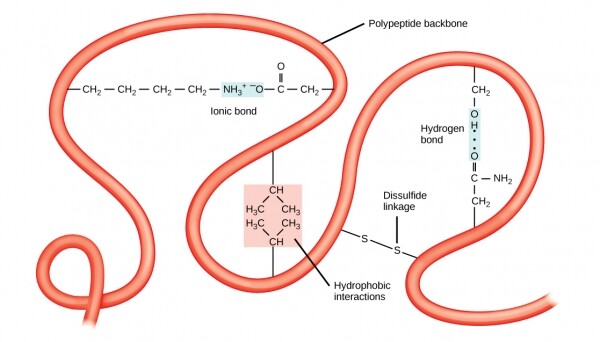
Den tertiære struktur stabiliseres af langdistanceinteraktioner såsom hydrofobicitet eller disulfidbindinger.
Disulfidbindinger kan opstå mellem radikaler i en polypeptidkæde, eller mellem cysteiner fra forskellige fulde kæder. Interaktioner mellem forskellige kæder danner niveau af proteinstruktur. Et glimrende eksempel på kvartærstruktur er i din blod. Hver hæmoglobinmolekyle består af fire identiske globiner, dele af et protein, som hver holdes i en bestemt position inden i polypeptidet af disulfidbroer, og som også er bundet til en hæmmolekyle, der indeholder jern. Alle fire globiner er forbundet af intermolekylære disulfidbroer, og hele molekylet kan samtidig binde sig til flere luftmolekyler, op til fire, og er i stand til at frigive dem efter behov.
Modellering af strukturer i jagten på behandling af sygdom
Polypeptidkæder begynder at folde sig i den endelige form under translation, når den voksende kæde kommer ud af ribosomet – omtrent som et stykke metaltråd med hukommelseseffekt kan antage komplekse former, når det opvarmes. Men som altid i biologi, er tingene ikke så enkle.
I mange celler gennemgår de transkriberede gener alvorlig redigering før translation, hvilket væsentligt ændrer den grundlæggende struktur af proteinet i forhold til den rene nucleotidsekvens af genet. På dette tidspunkt får oversættelsesmekanismerne ofte hjælp fra molekylære assistenter, proteiner der midlertidigt binder sig til den fremadskridende polypeptidkæde og forhindrer den i at tage en hvilken som helst mellemform, som de efterfølgende ikke kan overgå til den endelige form.
Det hele leder op til, at forudsigelsen af den endelige form af et protein ikke er en triviel opgave. I årtier har den eneste metode til at studere proteinernes struktur været fysiske metoder som røntgenkrystallografi. Først i slutningen af 1960'erne begyndte biofysiske kemikere at bygge beregningsmodeller for proteinfoldning, hovedsageligt fokuseret på modellering af sekundær struktur. Disse metoder og deres efterkommere kræver enorme mængder inddata ud over primærstrukturen – for eksempel tabeller over bindingvinkler for aminosyrer, lister over hydrofobicitet, ladede tilstande og endda bevarelse af struktur og funktion over evolutionære tidsskalaer – alt for at gætte, hvordan det endelige protein vil se ud.
De nuværende computermetoder til forudsigelse af sekundær struktur, der blandt andet bruges i Folding@Home-netværket, opererer med en nøjagtighed på omkring 80% – hvilket er ret godt, givet opgavens kompleksitet. Data, der opnås fra forudsigelsesmodeller for proteiner som SARS-CoV-2-spidserproteinet, vil blive sammenlignet med data fra fysisk undersøgelse af virussen. I sidste ende vil det være muligt at opnå den nøjagtige struktur af proteinet og muligvis forstå, hvordan virussen binder sig til receptorer. hos mennesker, der findes i luftvejene, der fører ind i kroppen. Hvis vi kan forstå denne struktur, vil vi sandsynligvis kunne finde lægemidler, der blokerer bindingen og forhindrer infektion.
Forskningen i proteinfoldning ligger i kernen af vores forståelse af et væld af sygdomme og infektioner, at selv når vi gennem Folding@Home-netværket finder ud af, hvordan vi kan vinde over COVID-19, hvis eksplosive vækst vi har observeret for nylig, vil dette netværk ikke forblive inaktivt længe uden arbejde. Det er et forskningsværktøj, der er fremragende til at studere proteinmodeller, der ligger til grund for dusinvis af sygdomme relateret til forkert proteinfoldning – for eksempel Alzheimers sygdom eller en variant af Creutzfeldt-Jakobs sygdom, som ofte fejlagtigt kaldes kogalskab. Og når den næste virus uundgåeligt dukker op, vil vi allerede være klar til igen at starte kampen mod den.
Kilde: habr.com
