

Goddag! Mit navn er Danil Lipovoy, og vores team i Sbertech er begyndt at bruge HBase som lager til operationelle data. Gennem vores undersøgelse er der blevet indsamlet erfaring, som vi ønskede at systematisere og beskrive (vi håber, det vil være nyttigt for mange). Alle de følgende eksperimenter er udført med versioner af HBase 1.2.0-cdh5.14.2 og 2.0.0-cdh6.0.0-beta1.
- Generel Arkitektur
- Skrivning af data til HBASE
- Læsning af data fra HBASE
- Cachelagring af data
- Batchbehandling af data MultiGet/MultiPut
- Strategi for opdeling af tabeller i regioner (splittning)
- Fejltolerance, komprimering og datalokalsitet
- Indstillinger og ydeevne
- Belastningstest
- Konklusioner
1. Generel Arkitektur
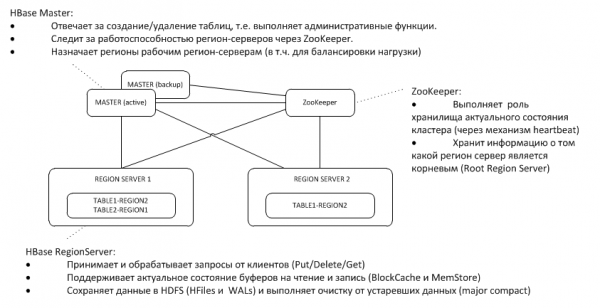
Den backup Master overvåger heartbeat fra den aktive på ZooKeeper og påtager sig masterens funktioner i tilfælde af nedbrud.
2. Skrivning af data til HBASE
Lad os først se på det enkleste tilfælde – skrivning af et nøgle-værdi objekt til en given tabel ved hjælp af put(rowkey). Klienten skal først finde ud af, hvor roden region server (Root Region Server — RRS) er placeret, som opbevarer tabellen hbase:meta. Denne information får han fra ZooKeeper. Derefter henvender han sig til RRS og læser tabellen hbase:meta, hvorfra han udtrækker information om, hvilken RegionServer (RS) der ansvarer for opbevaring af dataene for den angivne rowkey i den ønskede tabel. Af hensyn til videre brug cachelageres meta-tabellen af klienten, og derfor går efterfølgende henvendelser hurtigere, direkte til RS.
Når RS modtager anmodningen, skriver den først denne til WriteAheadLog (WAL), som er nødvendig for at kunne genskabe ved nedbrud. Derefter gemmer den dataene i MemStore. Dette er en buffer i hukommelsen, som indeholder et sorteret sæt af nøgler for denne region. Tabellen kan opdeles i regioner (partitioner), hver af dem indeholder et ikke-overlappende sæt af nøgler. Dette gør det muligt at opnå højere ydeevne ved at placere regionerne på forskellige servere. Men på trods af åbenlyse fordele vil vi se, at dette ikke altid fungerer.
Efter at posten er placeret i MemStore, får klienten et svar om, at posten er gemt succesfuldt. I virkeligheden opbevares den kun i bufferen og vil blive skrevet til disken først efter en vis tidsperiode eller ved at blive fyldt med nye data.
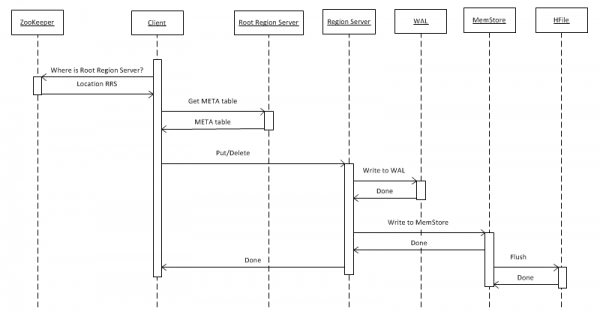
Ved udførelse af operationen «Delete» sker der ikke fysisk sletning af data. De markeres blot som slettede, og selve destruktionen finder sted ved opkald af funktionen major compact, som der står mere om i punkt 7.
Filer i HFile-formatet oplagres i HDFS, og der startes fra tid til anden en minor compact-proces, der blot sammenklemmer små filer til større, uden at slette noget. Over tid bliver dette et problem, der kun viser sig ved læsning af data (det vender vi tilbage til senere).
Udover den ovenfor beskrevne indlæsning er der en langt mere effektiv procedure, som måske er den stærkeste side ved denne database – BulkLoad. Det involverer, at vi selv opretter HFiles og placerer dem på disken, hvilket gør det muligt at skalere fremragende og opnå ganske respektable hastigheder. I bund og grund er begrænsningen ikke HBase, men hardware-mulighederne. Nedenfor er resultaterne af indlæsning på en klynge bestående af 16 RegionServers og 16 NodeManager YARN (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 tråde), HBase version 1.2.0-cdh5.14.2.
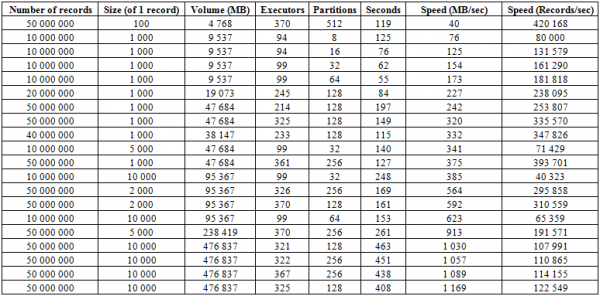
Her kan vi se, at ved at øge antallet af partitioner (regioner) i tabellen samt Spark-udførere, får vi en stigning i indlæsningshastigheden. Hastigheden afhænger også af mængden af data, der skrives. Store blokke giver en stigning målt i MB/sek, mens små giver en stigning i antallet af indsatte poster pr. tidsenhed, alt andet lige.
Man kan også starte indlæsningen i to tabeller samtidigt og opnå en fordobling af hastigheden. Nedenfor ses det, at skrivning af 10 KB blokke samtidigt i to tabeller sker med en hastighed på omkring 600 MB/sek til hver (i alt 1275 MB/sek), hvilket matcher skrivningshastigheden i en enkelt tabel på 623 MB/sek (se nr. 11 ovenfor).
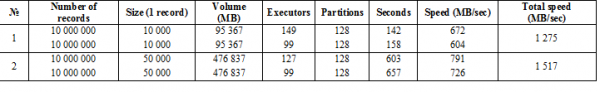
Men den anden kørsel med indskrifter på 50 KB viser, at indlæsningshastigheden kun stiger ubetydeligt, hvilket indikerer, at vi nærmer os de maksimale værdier. Det skal bemærkes, at der ikke praktisk talt skabes belastning på selve HBASE; alt hvad der kræves af den, er først at sende data fra hbase:meta, og efter placeringen af HFiles, at tilbagelægge data fra BlockCache og gemme MemStore-pufferen på disken, hvis den ikke er tom.
3. Læsning af data fra HBASE
Hvis man antager, at alle oplysninger fra hbase:meta allerede er tilgængelige for kunden (se punkt 2), så sendes forespørgslen straks til den RS, hvor den nødvendige nøgle er gemt. Først udføres søgningen i MemCache. Uanset om der er data der eller ej, udføres søgningen også i BlockCache-bufferen og om nødvendigt i HFiles. Hvis dataene findes i filen, placeres de i BlockCache, og ved næste forespørgsel vil de blive returneret hurtigere. Søgningen i HFile sker relativt hurtigt takket være brugen af en Bloom-filter, dvs. ved at læse et lille datavolumen bestemmer den straks, om denne fil indeholder den nødvendige nøgle, og hvis ikke, går den videre til den næste.
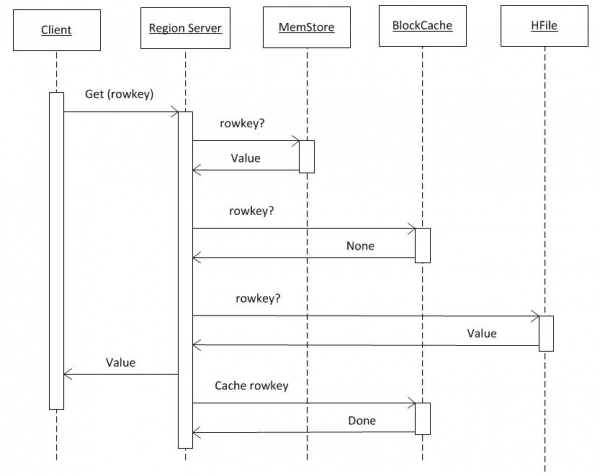
Når RS har modtaget data fra disse tre kilder, danner den et svar. Specifikt kan den straks overføre flere fundne versioner af objektet, hvis klienten har anmodet om versionskontrol.
4. Data caching
MemStore- og BlockCache-bufferne optager op til 80% af den tildelte on-heap hukommelse hos RS (det resterende er reserveret til servicemæssige opgaver hos RS). Hvis den typiske brug er sådan, at processerne skriver og straks læser disse data, giver det mening at reducere BlockCache og øge MemStore, da dataene ved skrivning ikke kommer ind i cache til læsning, så brugen af BlockCache vil ske sjældnere. BlockCache-bufferen består af to dele: LruBlockCache (altid on-heap) og BucketCache (normalt off-heap eller på SSD). BucketCache bør bruges, når der er mange læseanmodninger, og de ikke kan være i LruBlockCache, hvilket fører til aktiv drift af Garbage Collector. Selvom man ikke skal forvente en dramatisk stigning i ydeevnen ved brug af cache til læsning, vil vi komme tilbage til dette i punkt 8.
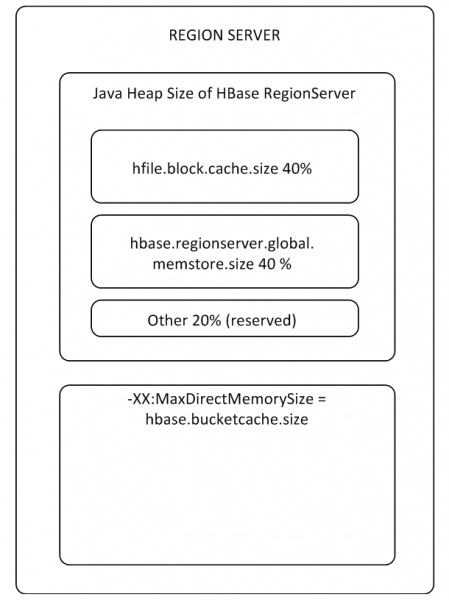
BlockCache er fælles for hele RS, mens MemStore er unik for hver tabel (én for hver Column Family).
siger Teoretisk set, når data skrives, kommer de ikke ind i cache, og faktisk er sådanne parametre CACHE_DATA_ON_WRITE for tabellen og 'Cache DATA on Write' for RS indstillet til false. Men i praksis, hvis man skriver data i MemStore, derefter tømer den til disk (derved rydder op), og så sletter den resulterende fil, så vil en get-anmodning stadig give os dataene. Og selvom man helt deaktiverer BlockCache og fylder tabellen med nye data, og derefter opnår en tømming af MemStore til disk, sletter dem og anmoder fra en anden session, så vil dataene stadig blive hentet fra et eller andet sted. Så HBase opbevarer ikke kun data, men også gådefulde mysterier.
hbase(main):001:0> create 'ns:magic', 'cf'
Oprettet tabel ns:magic
Tog 1.1533 sekunder
hbase(main):002:0> put 'ns:magic', 'key1', 'cf:c', 'try_to_delete_me'
Tog 0.2610 sekunder
hbase(main):003:0> flush 'ns:magic'
Tog 0.6161 sekunder
hdfs dfs -mv /data/hbase/data/ns/magic/* /tmp/trash
hbase(main):002:0> get 'ns:magic', 'key1'
 cf:c      timestamp=1534440690218, value=try_to_delete_me
Indstillingen "Cache DATA on Read" er sat til false. Hvis du har ideer, er du velkommen til at diskutere dette i kommentarerne.
5. Batch behandling af data MultiGet/MultiPut
Behandling af enkeltanmodninger (Get/Put/Delete) er en relativt dyr operation, så de bør kombineres i en List, hvilket kan give en betydelig ydelsesforøgelse. Dette gælder især for skriveoperationer, men ved læsning er der en faldgrube. På grafen nedenfor vises tid til at læse 50.000 poster fra MemStore. Læsningen blev udført i en enkelt tråd, og på den vandrette akse vises antallet af nøgler i anmodningen. Her ses det, at ved at øge til tusind nøgler i én anmodning falder udførelsestiden, dvs. hastigheden øges. Men med den som standard aktiverede MSLAB-tilstand starter der en dramatisk nedgang i ydelsen efter denne tærskel, des mere data der er i posterne, jo længere tid tager det.
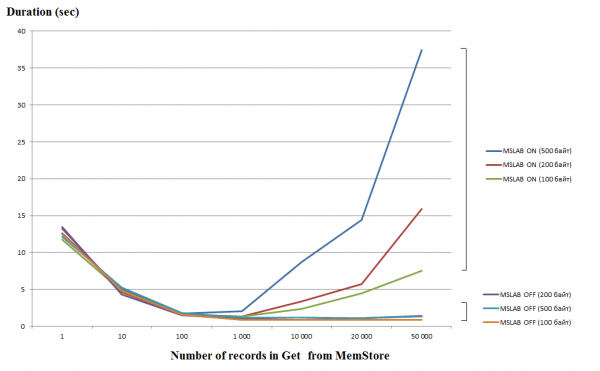
Testene blev udført på en virtuel maskine, 8 kerner, version HBase 2.0.0-cdh6.0.0-beta1.
MSLAB-tilstand er designet til at mindske fragmenteringen af heapen, som opstår på grund af blanding af data fra nye og gamle generationer. Som en løsning på problemet placeres data i relativt små celler (chunk) og behandles i portioner, når MSLAB er aktiveret. Resultatet er, at når mængden i den anmodede datapakke overskrider den tildelte størrelse, falder ydelsen drastisk. På den anden side er det heller ikke ønskeligt at deaktivere denne tilstand, da det fører til pauser på grund af GC i perioder med intensiv databehandling. En god løsning er at øge størrelsen af cellerne, når der skrives aktivt via put samtidig med læsning. Det er værd at bemærke, at problemet ikke opstår, hvis man efter skrivning udfører flush-kommandoen, som skyder MemStore til disken, eller hvis der udføres indlæsning via BulkLoad. I tabellen nedenfor vises, at anmodninger fra MemStore med større data (og samme mængde) fører til nedsat hastighed. Men ved at øge chunksize kan vi bringe behandlingstiden tilbage til det normale.
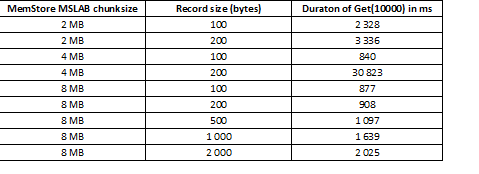
Udover at øge chunksize hjælper det at opdele data efter regioner, dvs. splitting af tabeller. Dette medfører, at færre forespørgsler kommer til hver region, og hvis de placeres i en celle, forbliver responsen god.
6. Strategi for opdeling af tabeller efter regioner (splitting)
Da HBase er et key-value lager, og partitionering udføres efter nøgle, er det ekstremt vigtigt at fordele data jævnt over alle regioner. For eksempel vil partitionering af en sådan tabel i tre dele føre til, at datae bliver delt i tre regioner:
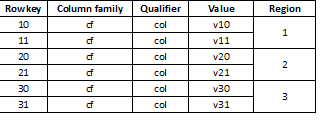
Det kan føre til en skarpe forsinkelse, hvis de data, der senere bliver indlæst, for eksempel har lange værdier, der for det meste begynder med det samme ciffer, for eksempel:
1000001
1000002
…
1100003
Da nøglerne gemmes som en byte-array, vil alle starte ens og høre til den region #1, der gemmer dette nøgleområde. Der er flere opdelingsstrategier:
HexStringSplit – Konverterer nøglen til en streng med hexadecimale koder i området "00000000" => "FFFFFFFF" og fylder til venstre med nuller.
UniformSplit – Konverterer nøglen til en byte-array med hexadecimale koder i området "00" => "FF" og fylder til højre med nuller.
Derudover kan man angive ethvert område eller sæt nøgler til opdeling og indstille automatisk splitning. Dog er en af de mest enkle og effektive metoder UniformSplit og brugen af hash-katstring, for eksempel det højeste byte-par fra kørslen af nøglen gennem CRC32(rowkey) funktionen og selve rowkey:
hash + rowkey
Så vil alle dataene være jævnt fordelt over regioner. Ved læsning bliver de første to bytes blot bortkastet, og den oprindelige nøgle forbliver. Derudover overvåger RS mængden af data og nøgler i regionen, og ved overskridelse af grænserne opdeles den automatisk i dele.
7. Fejltolerance og lokalitet af data
Da hver nøglepakke kun er ansvarlig for én region, er løsningen på problemer relateret til nedbrud af RS eller udfasning at opbevare alle nødvendige data i HDFS. Ved nedbrud registrerer masteren dette gennem manglende heartbeat på ZooKeeper-noden. Den tildeler derefter den dækkede region til en anden RS, og da HFiles gemmes i det distribuerede filsystem, vil den nye ejer læse dem og fortsætte med at betjene dataene. Men da en del af dataene kan være i MemStore og ikke er nået til HFiles, anvendes WAL til at gendanne operationernes historie, som også er gemt i HDFS. Efter at ændringerne er anvendt, er RS i stand til at svare på forespørgsler, men flytningen medfører, at en del data og de processer, der betjener dem, havner på forskellige noder, hvilket resulterer i nedsat lokalitet.
Løsningen på problemet er major compaction – denne procedure flytter filer til de noder, som er ansvarlige for dem (til dem, hvor deres regioner er placeret), hvilket medfører, at belastningen på netværk og diske pludselig stiger under denne procedure. Dog kan adgangen til dataene mærkbart accelereres på længere sigt. Desuden udfører major_compaction en sammenlægning af alle HFiles til én fil inden for regionen og rydder dataene baseret på tabelindstillingerne. For eksempel kan man angive antallet af versioner af et objekt, der skal bevares, eller dets levetid, efter hvilken objektet fysisk fjernes.
Denne procedure kan have en meget positiv indvirkning på HBase's ydeevne. På billedet nedenfor kan man se, hvordan ydeevnen er blevet degraderet som følge af aktiv dataindsamling. Her kan man se, at der i én tabel blev skrevet af 40 tråde, mens 40 tråde læste data samtidig. De skrivende tråde genererer flere og flere HFiles, som bliver læst af de andre tråde. Som et resultat skal der slettes flere og flere data fra hukommelsen, og til sidst begynder GC at arbejde, hvilket i praksis lammer hele processen. Udførelsen af major compaction førte til oprydning af de opståede affald og gendannelse af ydeevnen.
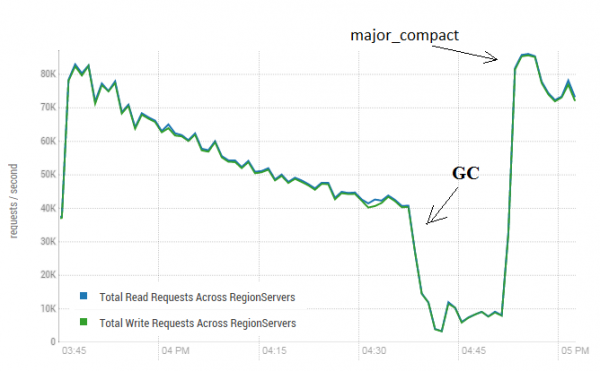
Testen blev udført på 3 DataNode og 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 tråde). Version HBase 1.2.0-cdh5.14.2
Det skal bemærkes, at major compaction blev udført på en "live" tabel, hvor der aktivt blev skrevet og læst data. Der har været påstande på nettet om, at dette kan føre til forkerte svar ved læsning af data. For at teste blev der startet en proces, der genererede nye data og skrev dem til tabellen. Efterfølgende blev der straks læst og tjekket, om den modtagne værdi stemte overens med det, der var skrevet. Under operationen blev major compaction udført omkring 200 gange, og der blev ikke registreret nogen nedbrud. Måske viser problemet sig sjældent og kun under høj belastning, så det er derfor mere sikkert at planmæssigt stoppe skrive- og læseprocesserne og udføre rengøring undgåelse af sådanne GC-dyk.
Desuden påvirker major compaction ikke tilstanden af MemStore; for at nulstille det til disk og komprimere skal der bruges flush (connection.getAdmin().flush(TableName.valueOf(tblName))).
8. Indstillinger og ydeevne
Som allerede nævnt viser HBase den største succes, hvor den ikke har noget at gøre ved udførelsen af BulkLoad. Dette gælder dog for de fleste systemer og mennesker. Men dette værktøj er mere egnet til masseoverførsel af data i store blokke, mens processer, der kræver mange konkurrerende læse- og skriveanmodninger, bruger de førnævnte Get- og Put-kommandoer. For at bestemme de optimale parametre blev der udført tests med forskellige kombinationer af tabelparametre og indstillinger:
- Der blev kørt 10 tråde samtidigt 3 gange i træk (vi kalder dette en trådblok).
- Tiden for alle tråde i blokken blev gennemsnitlig og var det samlede resultat af blokens arbejde.
- Alle tråde arbejdede med den samme tabel.
- Før hver kørsel af trådblokken blev der udført en major compaction.
- Hver blok udførte kun en af de følgende operationer:
— Put
— Get
— Get+Put
- Hver blok udførte 50.000 gentagelser af sin operation.
- Størrelsen på optegnelsen i blokken var 100 byte, 1000 byte eller 10.000 byte (random).
- Blokke blev kørt med varierende antal forespurgte nøgler (enten en nøgle eller 10).
- Blokke blev kørt med forskellige tabelindstillinger. Parametre blev ændret:
— BlockCache = tændt eller slukket
— BlockSize = 65 KB eller 16 KB
— Partitioner = 1, 5 eller 30
— MSLAB = tændt eller slukket
Således ser blokken sådan ud:
a. MSLAB-tilstand blev tændt/slukket.
b. Der blev oprettet en tabel med følgende indstillinger: BlockCache = true/none, BlockSize = 65/16 Kb, partitioner = 1/5/30.
c. GZ-komprimering blev aktiveret.
d. 10 tråde blev kørt samtidig, der udførte 1/10 operationer put/get/get+put i denne tabel med poster på 100/1000/10000 byte, hvilket resulterede i 50.000 kontinuerlige forespørgsler (nøglerne var tilfældige).
e. Punkt d blev gentaget tre gange.
f. Tiden for alle tråde blev gennemsnitligt beregnet.
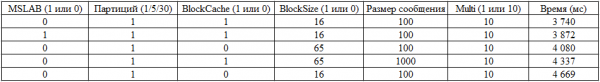
Alle mulige kombinationer blev testet. Det er forudsigeligt, at hastigheden vil falde med større poststørrelse, eller at deaktivering af caching vil føre til langsommere hastigheder. Formålet var imidlertid at forstå graden og betydningen af indflydelsen fra hver parameter, så de indsamlede data blev givet til en lineær regressionsfunktion, der muliggør vurdering af pålideligheden ved hjælp af t-statistik. Nedenfor er resultaterne fra de blokke, der udførte operationer Put. Det samlede antal kombinationer er 2*2*3*2*3 = 144 muligheder + 72, da nogle blev udført to gange. Derfor i alt 216 kørsel:
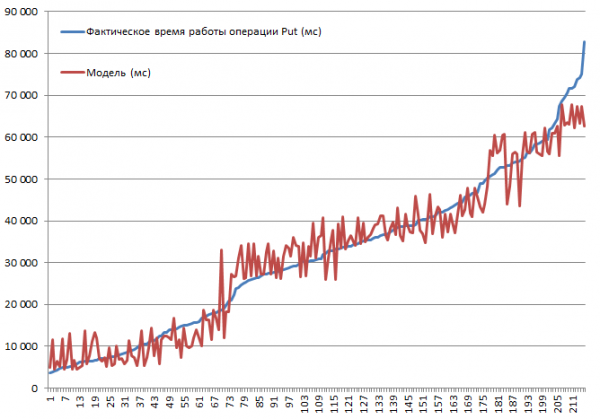
Testen blev udført på et mini-kluster bestående af 3 DataNodes og 4 RS (CPU Xeon E5-2680 v4 @ 2.40GHz * 64 tråde). Version HBase 1.2.0-cdh5.14.2.
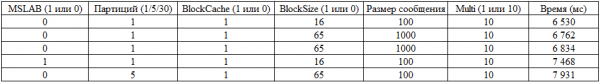
Den højeste indsættelseshastighed på 3,7 sekunder blev opnået med MSLAB tilstand deaktiveret, på en tabel med en partition, med BlockCache aktiveret, BlockSize = 16, optegnelser på 100 byte med 10 pr. pakke.
Den laveste indsættelseshastighed på 82,8 sekunder blev opnået med MSLAB tilstand aktiveret, på en tabel med en partition, med BlockCache aktiveret, BlockSize = 16, optegnelser på 10000 byte med 1 pr. stk.
Lad os nu se på modellen. Vi ser en god modelkvalitet ifølge R2, men det er helt klart, at ekstrapolering her er kontraindiceret. Det reelle systemadfærd ved ændringer i parametre vil ikke være lineært; denne model er ikke til forudsigelser, men til forståelse af, hvad der skete inden for de angivne parametre. For eksempel ser vi her ifølge Student-kriteriet, at parametrene BlockSize og BlockCache ikke har betydning for operationen Put (hvilket generelt er ret forudsigeligt):
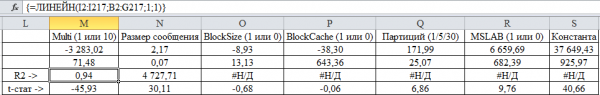
At dette at øge antallet af partitioner fører til en nedsættelse af ydeevnen er noget overraskende (vi har allerede set den positive indflydelse af at øge antallet af partitioner ved BulkLoad), selvom det er forståeligt. For det første skal man i behandlingen danne forespørgsler til 30 regioner i stedet for én, og datamængden er ikke så stor, at det giver en fordel. For det andet bestemmes den samlede arbejdstid af den langsomste RS, og da antallet af DataNode er mindre end antallet af RS, har nogle regioner nul lokalitet. Lad os så se på top fem:
Lad os nu vurdere resultaterne af udførelsen af Get-blokke:
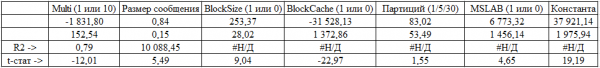
Antallet af partitioner har mistet betydning, hvilket sandsynligvis forklares med, at dataene cachelagres godt, og at cachen til læsning er den mest betydningsfulde (statistisk set) parameter. Det er naturligt, at en stigning i antallet af meddelelser i forespørgslen også er meget nyttig for ydeevnen. De bedste resultater:
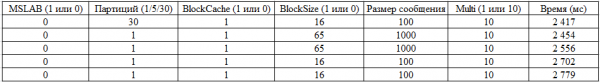
Og lad os endelig se på modellen for blokken, der først udførte get, og derefter put:
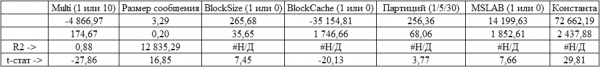
Her er alle parametre betydningsfulde. Og resultaterne af lederne:
9. Belastningstestning
Og lad os endelig køre en nogenlunde anstændig belastning, men det er altid mere interessant, når der er noget at sammenligne med. På DataStax' hjemmeside - den nøgleudvikler af Cassandra, findes der MT for en række NoSQL-lagringssystemer, herunder HBase version 0.98.6-1. Indlæsningen blev udført med 40 tråde, datastørrelsen var 100 bytes, og diskene var SSD. Testresultatet for Read-Modify-Write-operationer viste disse resultater.
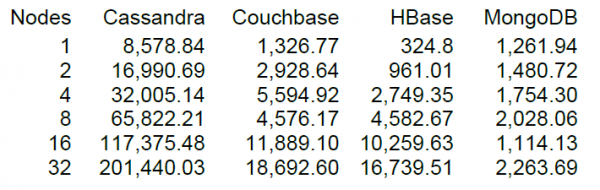
Så vidt jeg forstår, blev læsningen udført i blokke af 100 optegnelser, og for 16 noder viste DataStax-testen for HBase en ydeevne på 10.000 operationer per sekund.
Det er heldigt, at vores klynge også har 16 noder, men det er ikke så "heldigt", at hver har 64 kerner (tråde), mens DataStax-testen kun har 4. På den anden side har de SSD-diske, mens vi har HDD'er og en nyere version af HBase, og CPU-udnyttelsen under belastning steg næsten ikke mærkbart (visuelt med 5-10 procent). Ikke desto mindre vil vi forsøge at starte op med denne konfiguration. Tabelindstillingerne er som standard, og læsninger udføres i intervallet af nøgler fra 0 til 50 millioner tilfældigt (dvs. i princippet nyt hver gang). Tabelen har 50 millioner poster, opdelt i 64 partitioner. Nøglerne er hashet med crc32. Tabelindstillingerne er standard, MSLAB er aktiveret. 40 tråde køres, hver tråd læser et sæt på 100 tilfældige nøgler og skriver straks genererede 100 bytes tilbage til disse nøgler.
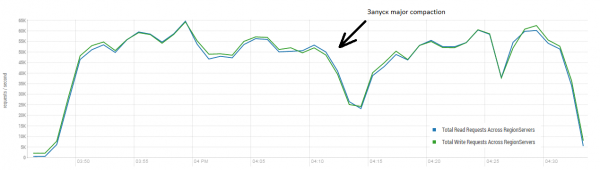
Stand: 16 DataNode og 16 RS (CPU Xeon E5-2680 v4 @ 2,40 GHz * 64 tråde). Version HBase 1.2.0-cdh5.14.2.
Det gennemsnitlige resultat ligger tættere på 40.000 operationer pr. sekund, hvilket er væsentligt bedre end i DataStax-testen. Men af forsøgsgrunde kan betingelserne ændres lidt. Det er ret usandsynligt, at al arbejdet kun vil blive udført med én tabel, samt kun med unikke nøgler. Lad os antage, at der er et 'hot' sætt af nøgler, som genererer hovedbelastningen. Derfor vil vi prøve at skabe belastning med større poster (10 KB), også i portioner på 100, over 4 forskellige tabeller, og begrænse rækken af forespurgte nøgler til 50.000. På grafen nedenfor vises kørsel af 40 tråde, hver tråd læser et sæt på 100 nøgler og skriver straks tilfældige 10 KB tilbage til disse nøgler.
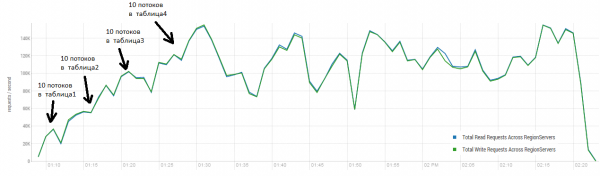
Stand: 16 DataNode og 16 RS (CPU Xeon E5-2680 v4 @ 2,40 GHz * 64 tråde). Version HBase 1.2.0-cdh5.14.2.
Under belastningen blev major compaction kørt flere gange, som vist ovenfor. Uden denne procedure vil ydeevnen gradvist forværres, men der opstår også ekstra belastning under kørslen. Fald i ydeevne skyldes forskellige årsager. Nogle gange afsluttede tråde deres arbejde, og mens de blev genstartet, opstod der en pause; nogle gange skabte eksterne applikationer belastning på klyngen.
At læse og samtidig skrive er et af de mest udfordrende arbejdsscenarier for HBase. Hvis man kun udfører put-anmodninger af lille størrelse, for eksempel på 100 byte, ved at samle dem i batches på 10-50 tusinde, kan man opnå hundredtusind operationer i sekundet, og det samme gælder for læseanmodninger. Det er værd at bemærke, at resultaterne er radikalt bedre end dem, der blev opnået af DataStax, især takket være batchanmodningerne på 50 tusinde.
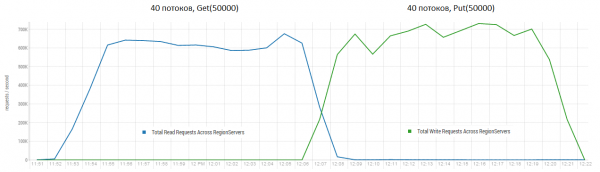
Stand: 16 DataNode og 16 RS (CPU Xeon E5-2680 v4 @ 2,40 GHz * 64 tråde). Version HBase 1.2.0-cdh5.14.2.
10. Konklusioner
Dette system kan konfigureres relativt fleksibelt, men påvirkningen af et stort antal parametre forbliver stadig ukendt. Nogle af dem er blevet testet, men kom ikke med i det endelige sæt af tests. For eksempel viste indledende eksperimenter en uvæsentlig betydning af parameteren DATA_BLOCK_ENCODING, som koder information ved hjælp af værdier fra naboceller, hvad der er helt rimeligt for data genereret tilfældigt. I tilfælde af en stor mængde tilbagevendende objekter kan gevinsten være betydelig. Generelt kan det siges, at HBase fremstår som en ret seriøs og velovervejet database, som kan være ret effektiv ved operationer med store datablokke. Især hvis der er mulighed for at sprede læse- og skriveprocesserne over tid.
Hvis der er noget, du mener ikke er tilstrækkeligt udforsket, er jeg klar til at fortælle mere. Vi opfordrer til at dele din erfaring eller diskutere, hvis du er uenig i noget.
Kilde: habr.com
