

I denne undersøgelse ønskede jeg at se, hvilke præstationsforbedringer der kan opnås ved at bruge ClickHouse som datakilde i stedet for PostgreSQL. Jeg kender de præstationsfordele, jeg får ved at bruge ClickHouse. Vil disse fordele blive bevaret, hvis jeg får adgang til ClickHouse fra PostgreSQL ved hjælp af en ekstern dataskal (FDW)?
De databaser, der bliver undersøgt, er PostgreSQL v11, clickhousedb_fdw og ClickHouse-databasen. I sidste ende vil vi fra PostgreSQL v11 køre forskellige SQL-forespørgsler, der styres gennem vores clickhousedb_fdw til ClickHouse-databasen. Derefter vil vi se, hvordan FDWs præstation sammenlignes med de samme forespørgsler, der køres i nativ PostgreSQL og nativ ClickHouse.
Clickhouse-database
ClickHouse er et open source kolonne-baseret databasesystem, der kan nå præstationer, der er 100-1000 gange hurtigere end traditionelle databasemetoder, i stand til at håndtere over en milliard rækker på mindre end et sekund.
Clickhousedb_fdw
clickhousedb_fdw er en ekstern dataskal til ClickHouse-databasen, eller FDW, som er et open source-projekt fra Percona. .
.
Som du vil se, leverer dette en FDW for ClickHouse, der muliggør SELECT from og INSERT INTO ClickHouse-databasen fra PostgreSQL v11-serveren.
FDW understøtter avancerede funktioner som aggregater og join. Dette øger betydeligt ydeevnen ved at udnytte ressourcerne fra den eksterne server til disse ressourcekrævende operationer.
Benchmark-miljø
- Supermicro-server:
- Intel® Xeon® CPU E5-2683 v3 @ 2.00GHz
- 2 sokler / 28 kerner / 56 tråde
- Hukommelse: 256GB RAM
- Lager: Samsung SM863 1.9TB Enterprise SSD
- Filsystem: ext4/xfs
- OS: Linux smblade01 4.15.0-42-generic #45~16.04.1-Ubuntu
- PostgreSQL: version 11
Benchmark-tests
I stedet for at bruge et maskin-genereret datasæt til denne test, brugte vi data "Performance Over Time, Reported Operator Time" fra 1987 til 2018. Du kan få adgang til dataene .
Databasens størrelse er 85 GB, hvilket sikrer en tabel med 109 kolonner.
Benchmark-forespørgsler
Her er de forespørgsler, jeg brugte til at sammenligne ClickHouse, clickhousedb_fdw og PostgreSQL.
Q#
Forespørgsel indeholder aggregater og group by
Q1
SELECT DayOfWeek, count(*) AS c FROM ontime WHERE Year >= 2000 AND Year <= 2008 GROUP BY DayOfWeek ORDER BY c DESC;
Q2
VÆLG DayOfWeek, count(*) AS c FRA ontime HVOR DepDelay>10 OG ÅR >= 2000 OG ÅR <= 2008 GRUPPERING EFTER DayOfWeek BESTIL c DESC;
Q3
VÆLG Oprindelse, count(*) AS c FRA ontime HVOR DepDelay>10 OG ÅR >= 2000 OG ÅR <= 2008 GRUPPERING EFTER Oprindelse BESTIL c DESC BEGRÆNS 10;
Q4
VÆLG Transportør, count() FRA ontime HVOR DepDelay>10 OG ÅR = 2007 GRUPPERING EFTER Transportør BESTIL count() DESC;
Q5
VÆLG a.Transportør, c, c2, c1000/c2 som c3 FRA ( VÆLG Transportør, count() AS c FRA ontime HVOR DepDelay>10 OG ÅR=2007 GRUPPERING EFTER Transportør ) a INDRE JOIN ( VÆLG Transportør,count(*) AS c2 FRA ontime HVOR ÅR=2007 GRUPPERING EFTER Transportør) b ON a.Transportør=b.Transportør BESTIL c3 DESC;
Q6
VÆLG a.Transportør, c, c2, c1000/c2 som c3 FRA ( VÆLG Transportør, count() AS c FRA ontime HVOR DepDelay>10 OG ÅR >= 2000 OG ÅR = 2000 OG ÅR <= 2008 GRUPPERING EFTER Transportør ) b ON a.Transportør=b.Transportør BESTIL c3 DESC;
Q7
VÆLG Transportør, avg(DepDelay) * 1000 AS c3 FRA ontime HVOR ÅR >= 2000 OG ÅR <= 2008 GRUPPERING EFTER Transportør;
Q8
VÆLG ÅR, avg(DepDelay) FRA ontime GRUPPERING EFTER ÅR;
Q9
VÆLG ÅR, count(*) som c1 FRA ontime GRUPPERING EFTER ÅR;
Q10
VÆLG avg(cnt) FRA (VÆLG ÅR,Måned,count(*) AS cnt FRA ontime HVOR DepDel15=1 GRUPPERING EFTER ÅR,Måned) a;
Q11
VÆLG avg(c1) FRA (VÆLG ÅR,Måned,count(*) som c1 FRA ontime GRUPPERING EFTER ÅR,Måned) a;
Q12
VÆLG Oprindelsesbyens navn, DestCityName, count(*) AS c FRA ontime GRUPPERING EFTER Oprindelsesbyens navn, DestCityName BESTIL c DESC BEGRÆNS 10;
Q13
VÆLG Oprindelsesbyens navn, count(*) AS c FRA ontime GRUPPERING EFTER Oprindelsesbyens navn BESTIL c DESC BEGRÆNS 10;
Spørgning indeholder sammenkædninger
Q14
VÆLG a.ÅR, c1/c2 FRA ( VÆLG ÅR, count()1000 som c1 FRA ontime HVOR DepDelay>10 GRUPPERING EFTER ÅR) a INDRE JOIN (VÆLG ÅR, count(*) som c2 FRA ontime GRUPPERING EFTER ÅR ) b ON a.ÅR=b.ÅR BESTIL a.ÅR;
Q15
VÆLG a.„ÅR”, c1/c2 FRA ( VÆLG „ÅR”, count()1000 som c1 FRA ontime HVOR „DepDelay”>10 GRUPPERING EFTER „ÅR”) a INDRE JOIN (VÆLG „ÅR”, count(*) som c2 FRA ontime GRUPPERING EFTER „ÅR” ) b ON a.„ÅR”=b.„ÅR”;
Tabel-1: Spørgsmål anvendt i benchmark
Spørgninger udført
Her er resultaterne for hver af forespørgslerne ved udførelsen i forskellige databaseindstillinger: PostgreSQL med indekser og uden dem, egen ClickHouse og clickhousedb_fdw. Tiden vises i millisekunder.
Q#
PostgreSQL
PostgreSQL (Indexerede)
ClickHouse
clickhousedb_fdw
Q1
27920
19634
23
57
Q2
35124
17301
50
80
Q3
34046
15618
67
115
Q4
31632
7667
25
37
Q5
47220
8976
27
60
Q6
58233
24368
55
153
Q7
30566
13256
52
91
Q8
38309
60511
112
179
Q9
20674
37979
31
81
Q10
34990
20102
56
148
Q11
30489
51658
37
155
Q12
39357
33742
186
1333
Q13
29912
30709
101
384
Q14
54126
39913
124
1364212
Q15
97258
30211
245
259
Tabel-1: Tiden taget til at udføre de forespørgsler, der blev anvendt i benchmark
Se resultater
Grafen viser tiderne for udførelse af forespørgsler i millisekunder, X-aksen viser forespørgselsnummeret fra tabellerne ovenfor, mens Y-aksen viser udførelsestid i millisekunder. Resultaterne fra ClickHouse og data opnået fra postgres via clickhousedb_fdw vises. Tabellen viser, at der er en enorm forskel mellem PostgreSQL og ClickHouse, men en minimal forskel mellem ClickHouse og clickhousedb_fdw.
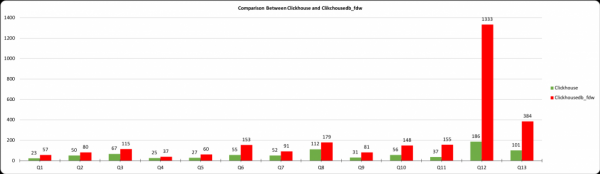
Denne graf viser forskellen mellem ClickhouseDB og clickhousedb_fdw. I de fleste forespørgsler er FDW-omkostningerne ikke så store og knap betydelige, undtagen Q12. Denne forespørgsel inkluderer sammenkædninger og en ORDER BY-klausul. På grund af ORDER BY GRUPPERING/BY og ORDER BY springes ikke til ClickHouse.
I tabel 2 ser vi et spring i tiden for forespørgslerne Q12 og Q13. Jeg gentager, at dette skyldes forespørgslen ORDER BY. For at bekræfte dette har jeg udført forespørgslerne Q-14 og Q-15 med og uden forespørgslen ORDER BY. Uden forespørgslen ORDER BY er sluttiden 259 ms, mens den med forespørgslen ORDER BY er 1364212. For at fejlfinde denne forespørgsel forklarer jeg begge forespørgsler, og her er resultaterne af forklaringen.
Q15: Uden ORDER BY-klausul
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2
     FROM (SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) AS c2 FROM fontime GROUP BY "Year") b ON a."Year"=b."Year";
Q15: Forespørgsel uden ORDER BY-klausul
FORESPOØRGSPLAN
Hash Join  (cost=2250.00..128516.06 rows=50000000 width=12)
Output: fontime."Year", (((count(*) * 1000)) / b.c2)
Inner Unique: true   Hash Cond: (fontime."Year" = b."Year")
->  Foreign Scan  (cost=1.00..-1.00 rows=100000 width=12)
Output: fontime."Year", ((count(*) * 1000))
Relations: Aggregate on (fontime)
Remote SQL: SELECT "Year", (count(*) * 1000) FROM "default".ontime WHERE (("DepDelay" > 10)) GROUP BY "Year"
->  Hash  (cost=999.00..999.00 rows=100000 width=12)
Output: b.c2, b."Year"
->  Subquery Scan on b  (cost=1.00..999.00 rows=100000 width=12)
Output: b.c2, b."Year"
->  Foreign Scan  (cost=1.00..-1.00 rows=100000 width=12)
Output: fontime_1."Year", (count(*))
Relations: Aggregate on (fontime)
Remote SQL: SELECT "Year", count(*) FROM "default".ontime GROUP BY "Year"(16 rows)
Q14: Forespørgsel med ORDER BY-klausul
bm=# EXPLAIN VERBOSE SELECT a."Year", c1/c2 FROM(SELECT "Year", count(*)*1000 AS c1 FROM fontime WHERE "DepDelay" > 10 GROUP BY "Year") a
     INNER JOIN(SELECT "Year", count(*) as c2 FROM fontime GROUP BY "Year") b  ON a."Year"= b."Year"
     ORDER BY a."Year";
Q14: Forespørgselsplan med ORDER BY-klausul
FORESPOØRGSPLAN
Merge Join  (cost=2.00..628498.02 rows=50000000 width=12)
Output: fontime."Year", (((count(*) * 1000)) / (count(*)))
Inner Unique: true   Merge Cond: (fontime."Year" = fontime_1."Year")
->  GroupAggregate  (cost=1.00..499.01 rows=1 width=12)
Output: fontime."Year", (count(*) * 1000)
Group Key: fontime."Year"
->  Foreign Scan on public.fontime  (cost=1.00..-1.00 rows=100000 width=4)
Remote SQL: SELECT "Year" FROM "default".ontime WHERE (("DepDelay" > 10))
            ORDER BY "Year" ASC
->  GroupAggregate  (cost=1.00..499.01 rows=1 width=12)
Output: fontime_1."Year", count(*)
Group Key: fontime_1."Year"
->  Foreign Scan on public.fontime fontime_1  (cost=1.00..-1.00 rows=100000 width=4)

Remote SQL: SELECT "Year" FROM "default".ontime ORDER BY "Year" ASC(16 rows)
Output
Resultaterne af disse eksperimenter viser, at ClickHouse tilbyder virkelig god ydeevne, og clickhousedb_fdw giver fordelene ved ClickHouse-ydeevne fra PostgreSQL. Selvom der er nogle omkostninger forbundet med brugen af clickhousedb_fdw, er de ubetydelige og sammenlignelige med den ydeevne, der opnås ved at køre direkte på databasen ClickHouse. Dette bekræfter også, at fdw i PostgreSQL giver fremragende resultater.
Telegram chat om Clickhouse
Telegram chat om PostgreSQL
Kilde: habr.com
